 AIREITER
GLM-5.3 ist am 14. August 2026 gestartet. Z.ai spricht von 50 % mehr Coding-Leistung gegenüber GLM-5.2 und einer neuen Cybersecurity-Funktion, die im CyberGym-Benchmark 84,5 % erreicht. DeepSeek V4 Pro ist dagegen bereits mit vollständigem API-Zugriff, MIT-lizenzierten Open Weights und einem SWE-Bench-Verified-Ergebnis von 80,6 % auf der Model Card verfügbar (NIST kam unabhängig auf 81 %). Der entscheidende Haken bei GLM-5.3: Eine öffentliche API gibt es noch nicht. Der Zugriff läuft ausschließlich über die verwalteten Angebote von Z.ai – ZCode und den GLM Coding Plan. Genau dieser Unterschied macht aus dem Vergleich weit mehr als nur ein Duell zweier Modelle.
Zwei völlig unterschiedliche Wege zum Modell
DeepSeek V4 Pro ist mit frei verfügbaren Gewichten auf Hugging Face unter MIT-Lizenz gestartet. Dazu kommen eine dokumentierte API auf api-docs.deepseek.com und Hosting-Angebote von Drittanbietern wie SiliconFlow. Das Modell lässt sich selbst hosten, über jeden OpenAI-kompatiblen Client ansprechen oder direkt in Claude Code, Cline und eigene Skripte integrieren.
GLM-5.3 verfolgt den entgegengesetzten Ansatz. Laut Ankündigung von Z.ai ist das Modell ab sofort über den GLM Coding Plan und ZCode, die hauseigene Coding-IDE von Z.ai, verfügbar. API-Zugriff und Open Weights sollen dagegen erst nach „rigorosen Sicherheitsprüfungen“ folgen. Einen Endpunkt wie model: glm-5.3 gibt es also noch nicht, ebenso wenig einen Download bei Hugging Face oder Inference-Angebote von Drittanbietern. Einen Zeitplan hat Z.ai nicht genannt.
Coding-Benchmarks: große Versprechen, unterschiedlich belastbare Belege
GLM-5.3 und DeepSeek V4 Pro sind große chinesische MoE-Modelle, die auf agentisches Coding ausgelegt sind. Bei der Beweislage liegen sie allerdings noch deutlich auseinander.
Z.ai beschreibt GLM-5.3 als nachtrainierte Variante seines 743B-Basismodells. Die „erstklassigen Coding- und agentischen Fähigkeiten“ sollen also vor allem durch das Post-Training entstanden sein, nicht durch eine neue Architektur. Die chinesischsprachige Ankündigung wird konkreter: Rund 50 % mehr Coding-Leistung als GLM-5.2, Platz eins unter den Open Models im Terminal-Bench 3.0 sowie White-Box-Code-Reviews auf Augenhöhe mit Mythos 5. Zum Vergleich: GLM-5.2 erreichte laut den Release Notes von Z.ai im Terminal-Bench 2.1 einen Wert von 81,0 – damals der höchste Wert eines Open-Weight-Modells und nur hinter Claude Opus 4.8 mit 85,0.
Bei DeepSeek V4 Pro gibt es zusätzlich unabhängige Messungen. Die Model Card auf Hugging Face nennt 80,6 % im SWE-Bench Verified und 76,8 bei HumanEval Pass@1. In der CAISI-Evaluierung von NIST wurden im SWE-Bench Verified unabhängig 81 % gemessen. Technisch basiert das Modell auf einer MoE-Architektur mit insgesamt 1,6T Parametern, davon 49B aktiv. Das Kontextfenster umfasst 1M Token, die maximale Ausgabe 384K Token.
| Merkmal | GLM-5.3 | DeepSeek V4 Pro |
|---|---|---|
| Architektur | 743B Basismodell, nachtrainiert | 1,6T gesamt / 49B aktive MoE-Parameter |
| Kontextfenster | Nicht angegeben (GLM-5.2: 1M) | 1M Token |
| Maximale Ausgabe | Nicht angegeben (GLM-5.2: 128K) | 384K Token |
| Coding-Benchmark | Platz 1 unter den Open Models, Terminal-Bench 3.0 (Herstellerangabe) | 80,6 % SWE-Bench Verified (Model Card + NIST) |
| Cybersecurity | 84,5 % im CyberGym; White-Box-Reviews auf Augenhöhe mit Mythos 5 | Keine vergleichbare Positionierung |
| Open Weights | Nach Sicherheitsprüfung versprochen | MIT-Lizenz, bereits verfügbar |
| API | Noch nicht | Verfügbar (offiziell + SiliconFlow) |
Terminal-Bench und SWE-Bench messen unterschiedliche Dinge. Beim Terminal-Bench erledigt ein Agent Aufgaben in der Kommandozeile, während SWE-Bench Verified automatisch erstellte Pull-Request-Patches bewertet. Einen Rang im Terminal-Bench 3.0 direkt mit einem Prozentwert aus SWE-Bench Verified zu vergleichen, wäre daher nicht sinnvoll.
GLM-5.3 bringt außerdem eine Cybersecurity-Komponente mit, die DeepSeek V4 Pro nicht in vergleichbarer Form adressiert. Z.ai bezeichnet das Modell als „bereit für Cyberabwehr“ und nennt eine CyberGym-Leistung von 84,5 %. Diese Werte stammen vom Hersteller und wurden bislang nicht unabhängig bestätigt – sie sind daher eher als Richtungsangabe denn als endgültiges Ergebnis zu verstehen. Z.ai zufolge erzielt GLM-5.3 zudem mit weniger Ausgabetoken bessere Ergebnisse als GLM-5.2. Sollte sich diese Effizienz in unabhängigen Tests bestätigen, könnte das die Kosten pro Aufgabe senken.
Monatsabo oder Tokenabrechnung: Was kostet Coding wirklich?
DeepSeek V4 Pro wird über die offizielle API pro einer Million Token abgerechnet:
| Tokentyp | Offizielle DeepSeek-API |
|---|---|
| Ungecachter Input | $0.435 / M Token |
| Gecachter Input | $0.003625 / M Token |
| Output | $0.87 / M Token |
GLM-5.3 gibt es ausschließlich über das Abonnement des GLM Coding Plan:
| Tarif | Monatlicher Preis | Kontingent |
|---|---|---|
| Lite | $18 | 10.000 Credits/Woche |
| Pro | $80 | 6× Lite-Nutzung |
| Max | $168 | 14× Lite-Nutzung |
Der GLM Coding Plan erklärt nicht, wie viele Token einem „Credit“ entsprechen. Ein direkter Kostenvergleich bleibt deshalb ungenau. DeepSeek rechnet pro Token ab und verlangt kaum feste Bindung, während der GLM Coding Plan unabhängig vom tatsächlichen Volumen eine monatliche Pauschale berechnet.
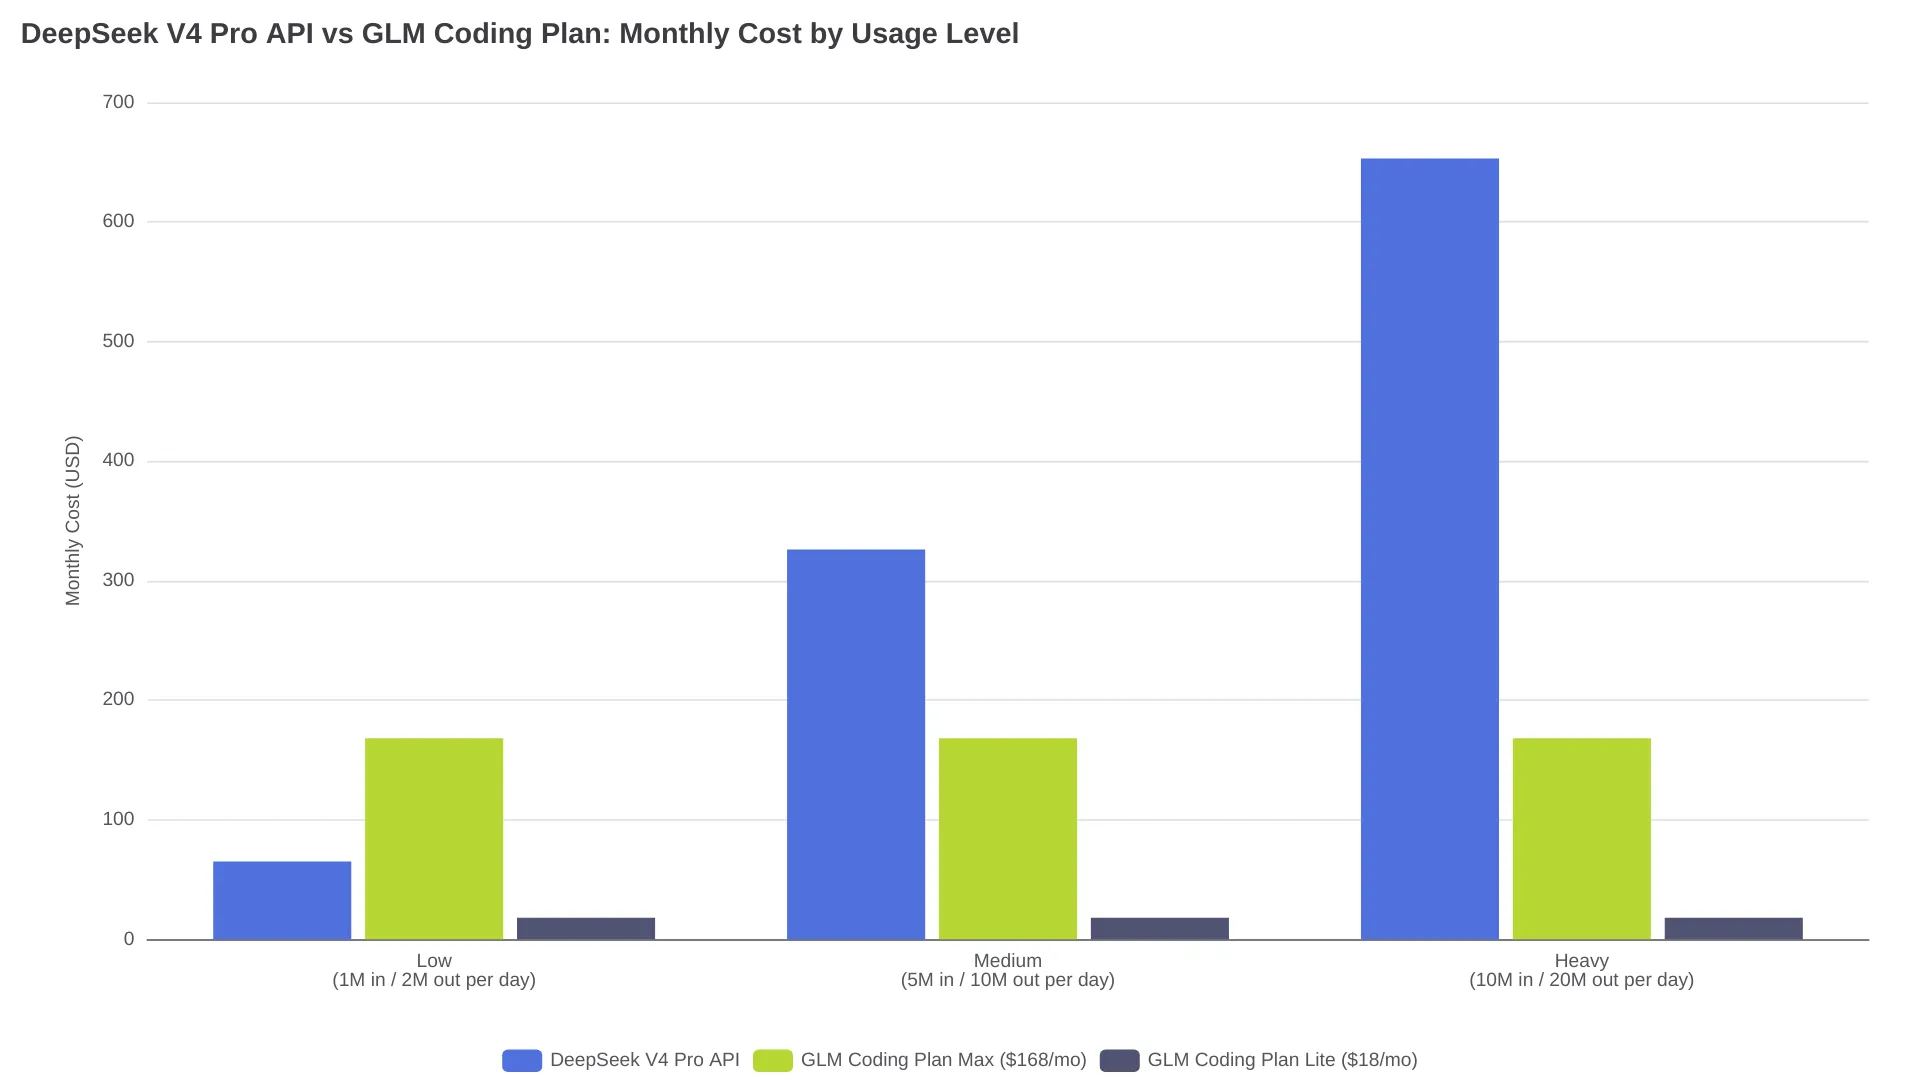
Ein konkretes Beispiel für DeepSeek: Bei 1M ungecachtem Input plus 2M Output-Token pro Tag – also einer moderaten Coding-Session – liegen die API-Kosten bei ungefähr $65 pro Monat. Steigt der Verbrauch auf 5M Input plus 10M Output-Token täglich, wächst die Rechnung auf $326 pro Monat. Gecachter Input für $0.003625/M kann die Kosten bei wiederkehrenden Codebasen deutlich reduzieren. Beim GLM Coding Plan verhindert der Pauschalpreis von $168 im Max-Tarif böse Überraschungen. Ob das Kontingent für dieselbe Arbeitslast reicht, hängt allerdings von der nicht offengelegten Umrechnung von Credits in Token ab.
Was Entwickler auf Reddit über die Modelle berichten
In einem aktuellen Thread auf r/ZaiGLM schrieb ein Nutzer, der beide Modelle ausprobiert hatte:
„Die Aufgabe war mit GLM schneller erledigt, erforderte aber deutlich mehr Anleitung.“
Im selben Thread beschreiben Nutzer Workflows mit mehreren Modellen: GLM fürs Coding und die Navigation durch Repositories, DeepSeek V4 Flash für Code-Reviews. Ein anderer Nutzer merkte an, dass DeepSeek V4 Pro zu diesem Zeitpunkt erst seit ungefähr 24 Stunden verfügbar gewesen sei, und warnte deshalb vor vorschnellen Urteilen. Das sind Einzelberichte aus einem Community-Thread, keine kontrollierten Benchmarks.
Welches Modell passt zu welchem Einsatz?
| Deine Situation | Empfehlung |
|---|---|
| Du brauchst heute API-Zugriff oder eine CI/CD-Integration | DeepSeek V4 Pro – GLM-5.3 hat keine öffentliche API |
| Du möchtest das Modell aus Gründen der Datenhoheit selbst hosten | DeepSeek V4 Pro – MIT-lizenzierte Gewichte sind jetzt auf Hugging Face verfügbar |
| Du programmierst hauptsächlich in einer IDE und möchtest einen verwalteten Assistenten | GLM-5.3 über den GLM Coding Plan oder ZCode |
| Du entwickelst als Einzelperson mit knappem Budget | DeepSeek V4 Pro ist bei geringem Volumen pro Token günstiger; GLM Lite ($18/Monat) begrenzt deine Ausgaben unabhängig vom Verbrauch |
| Du arbeitest an Security-Audits oder der Schwachstellenforschung | GLM-5.3 zuerst testen – 84,5 % im CyberGym sind ein Alleinstellungsmerkmal, aber noch nicht unabhängig bestätigt |
| Agentisches Coding im großen Maßstab mit langen Sessions | GLM Coding Plan Max ($168/Monat pauschal) begrenzt die Kosten; prüfe, ob das Credit-Kontingent für deine Arbeitslast ausreicht |
| Greenfield-Projekt mit wenig bestehendem Code | Beide – beide kommen mit neuem Code zurecht; entscheide nach dem bevorzugten Zugriffsmodell |
Wenn du bereits einen GLM-5.2 Coding Plan nutzt, ist das Upgrade auf GLM-5.3 innerhalb desselben Abos der unkomplizierteste Weg. Du brauchst die API von DeepSeek V4 Pro? Unser Guide zur DeepSeek V4 Pro GA API erklärt die Einrichtung des Endpunkts und die Optimierung der Kosten. Einen breiteren Vergleich inklusive der vorherigen GLM-Generation findest du in unserem Überblick zu GLM-5.2 vs. DeepSeek V4 Pro.
FAQ
Wird es eine öffentliche API für GLM-5.3 geben?
Ja. Z.ai will API-Zugriff und Open Weights nach den Sicherheitsprüfungen schrittweise veröffentlichen. Ein konkretes Datum gibt es noch nicht.
Kann ich eines der beiden Modelle selbst hosten?
DeepSeek V4 Pro: ja. Die MIT-lizenzierten Gewichte liegen auf Hugging Face. Das MoE-Modell mit 1,6T Parametern benötigt unquantisiert (FP16) ungefähr 3,2 TB VRAM beziehungsweise rund 800 GB bei einer 4-Bit-Quantisierung. Dafür ist ein Multi-GPU-Cluster mit H100- oder H200-Karten nötig. GLM-5.3: noch nicht. Open Weights sind nach den Sicherheitsprüfungen versprochen, die Lizenz wurde bisher jedoch nicht bekannt gegeben.
Welches Modell ist bei täglichem, intensivem Coding günstiger?
Das hängt vom Volumen ab. Bei 1M Input- plus 2M Output-Token pro Tag kostet DeepSeek V4 Pro ungefähr $65 pro Monat. Bei 5M Input- plus 10M Output-Token steigt der Betrag auf $326. Der GLM Coding Plan Max für $168 pro Monat ist bei diesem höheren Volumen günstiger als DeepSeek – aber nur, wenn das nicht veröffentlichte Credit-Kontingent für die Arbeitslast ausreicht. Teste beide Modelle mit deinem tatsächlichen Nutzungsprofil, bevor du dich festlegst.
Unterstützt GLM-5.3 Bild- oder Vision-Eingaben?
Nein. Z.ai bündelt Vision-Funktionen in einer separaten GLM-V-Modellreihe (GLM-5V-Turbo, GLM-4.6V, GLM-OCR). GLM-5.3 ist ein Text- und Coding-Modell. DeepSeek V4 Pro arbeitet ebenfalls ausschließlich mit Text.
Am Ende geht es um den Zeitpunkt, nicht um die Fähigkeiten
Auf dem Papier wirkt GLM-5.3 stärker: 50 % mehr Coding-Leistung, der besondere Fokus auf Cybersecurity und eine bessere Tokeneffizienz. Allerdings stammen sämtliche Werte aus einer zum Startzeitpunkt erst wenige Stunden alten Herstellerankündigung. Eine API, Open Weights und unabhängige Benchmark-Ergebnisse fehlen bislang. DeepSeek V4 Pro bietet heute genau das, was GLM-5.3 noch nicht liefern kann: Verfügbarkeit, verifizierte Benchmarks und einsetzbare Gewichte. Nutze DeepSeek dort, wo du jetzt API-Zugriff oder Self-Hosting brauchst, und beobachte die Veröffentlichung der GLM-5.3-API für einen direkten Test mit deiner eigenen Codebasis.