 AIREITER
Die $0.15 für Input sind bei GLM-5.3-Flash nur der Einstieg. Cache-Treffer, Output-Token, verpflichtendes Reasoning und ein Checkpoint mit rund 320B Parametern entscheiden darüber, ob für einen realen Einsatz die API oder die Open-Weight-Variante besser passt.
Das sind die aktuell geltenden Preise
Auf der offiziellen Preisseite von Z.AI ist GLM-5.3-Flash mit $0.15 pro 1 Million Input-Token, $0.03 pro 1 Million gecachter Input-Token und $0.50 pro 1 Million Output-Token gelistet. Zusätzlich gibt es eine befristete Aktion mit 50% Rabatt, die am 9. September 2026 um 24:00 Uhr UTC+8, also Singapur-Zeit, endet.
| GLM-5.3-Flash-Abrechnung | Listenpreis / 1 Mio. Token | Aktionspreis / 1 Mio. Token |
|---|---|---|
| Neuer Input | $0.15 | $0.075 |
| Gecachter Input | $0.03 | $0.015 |
| Output | $0.50 | $0.25 |
| Speicherung gecachter Inputs | Befristet kostenlos | Befristet kostenlos |
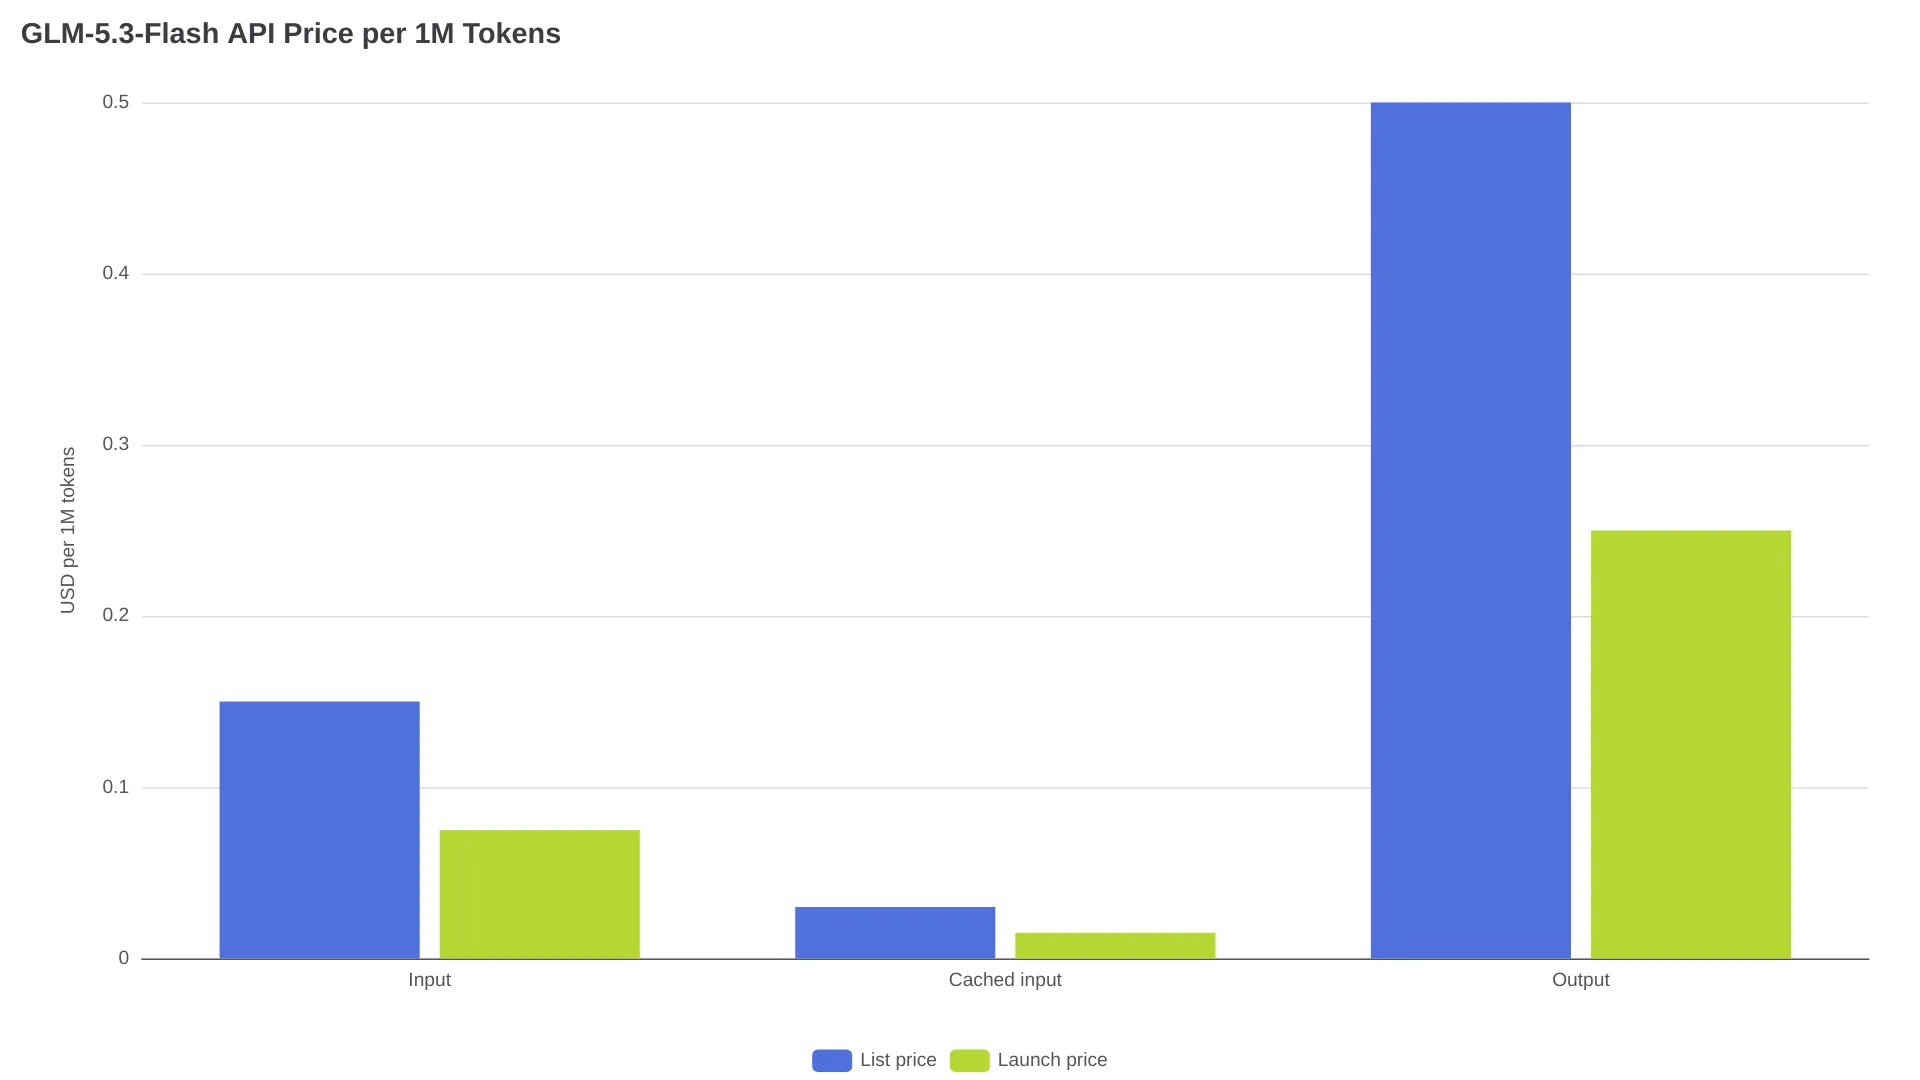
Für die Produktionskalkulation sollte der Preisnachlass als zeitlich begrenzte Aktion gelten, nicht als dauerhafte Basis. In der Launch-Ankündigung bezeichnet Z.AI ox-alpha als frühere Preview-Bezeichnung.
In derselben offiziellen Tabelle steht GLM-5.3 regulär mit $1.40 für Input, $0.26 für gecachten Input und $4.40 für Output je 1 Million Token. Nach Listenpreis ist Flash sowohl beim Input als auch beim Output rund 89% günstiger. Das ist ein reiner Preisvergleich und keine Aussage darüber, dass beide Modelle bei Qualität, Latenz oder Betrieb identisch arbeiten.
API-Zugang statt eines kleinen lokalen Modells
GLM-5.3-Flash ist ein multimodales Open-Weight-Modell unter MIT-Lizenz mit insgesamt 320B Parametern und 18B aktiven Parametern pro Token. Die offizielle Modellkarte auf Hugging Face dokumentiert den öffentlichen Checkpoint zai-org/GLM-5.3-Flash sowie Wege für lokales Serving. Laut Z.AI unterstützt das Modell ein Kontextfenster von 1 Million Token sowie Text-, Bild- und Video-Input.
Die Angabe „18B aktiv“ beschreibt die ausgewählte Expert-Berechnung, nicht den gesamten Speicherbedarf. Vollständige Gewichte, KV-Cache, Runtime-Overhead, multimodale Verarbeitung und Kontextlänge bestimmen weiterhin, ob lokaler Betrieb praktikabel ist.
| Zugangsweg | Was er bietet | Zentrale Einschränkung |
|---|---|---|
| Z.AI API | Gehostete Inferenz, abgerechnet nach Input, gecachtem Input und Output | Account-Limits und Reasoning-Latenz |
| Offizieller Checkpoint | MIT-lizenzierte Gewichte für Self-Hosting oder Anpassungen | Infrastruktur mit viel Speicher, abhängig von Präzision und Quantisierung |
| Quantisierter Community-Build | Kleinere Dateien für einige lokale Runtimes | Build-Qualität, Modalitätsunterstützung, Geschwindigkeit und Kompatibilität variieren |
Niedrige Tokenpreise und niedrige Hosting-Kosten sind zwei verschiedene Aussagen: Bei schwankender Nutzung wird API-Traffic erst bezahlt, wenn er anfällt. Self-Hosting reserviert hingegen Serving-Kapazität, auch in Leerlaufzeiten.
So rechnet die API in realen Workloads ab
Die Kosten von GLM-5.3-Flash ergeben sich aus dem Anteil neuer Inputs, erkannter gecachter Inputs und generiertem Output:
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
Zum Listenpreis kosten 10 Millionen neue Input-Token plus 2 Millionen Output-Token $2.50: $1.50 für den Input und $1.00 für den Output. Während der Aktion kostet dasselbe Volumen $1.25.
| Workload | Berechnung zum Listenpreis | Summe zum Listenpreis | Aktionssumme |
|---|---|---|---|
| 10M neuer Input + 2M Output | $1.50 + $1.00 | $2.50 | $1.25 |
| 2M neuer Input + 8M gecachter Input + 2M Output | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 100K neuer Input + 10K Output | $0.015 + $0.005 | $0.020 | $0.010 |
Der von Artificial Analysis ausgewiesene Mischwert von $0.10 pro Million basiert auf einem definierten Verhältnis von 7:2:1 für Cache-Treffer, Input und Output. Das ist für vergleichbare Workloads nützlich, aber kein allgemeingültiger GLM-5.3-Flash-Tarif.
Der Cache-Vorteil greift nur bei einem tatsächlichen Cache-Treffer. Im Response-Schema für Chat Completions von Z.AI steht dafür usage.prompt_tokens_details.cached_tokens. Für die Produktionsabrechnung sollte dieses Feld protokolliert werden, statt bei ähnlich aussehenden Prompts pauschal von Rabatt auszugehen. Ein Nutzer aus r/opencodeCLI fasste die Ökonomie zum Start so zusammen:
„Es gibt bis zum 9. September 50% Rabatt, und der Kontextverbrauch ist deutlich besser als bei dsv4f ...“ — u/CriteriumA, Reddit-Diskussion
Das Rabattdatum wird durch die Preisliste von Z.AI bestätigt; der Vergleich und die Nutzungserfahrung sind die Einschätzung dieses Kommentators. Stabil wiederkehrender Kontext kann die Cache-Nutzung verbessern, beseitigt aber weder Output-, Retry- und Tool-Kosten noch Account-Limits.
Eine kompakte Vorlage für die Budgetplanung
Die Kalkulation sollte vier getrennte Positionen enthalten: neuer Input, gecachter Input, Output und kostenpflichtige Tools. Z.AI berechnet für Web Search $0.01 pro Nutzung; bei Agents mit wiederholten Suchen können diese Kosten eine reine Token-Schätzung übersteigen.
| Monatliche Nutzungsannahme | Formel zum Listenpreis | Monatliche Kosten |
|---|---|---|
| 100M neuer Input + 20M Output | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 20M neuer Input + 80M gecachter Input + 20M Output | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 Web-Search-Aufrufe | 100 × $0.01 | $1.00 |
Das sind Rechenbeispiele, keine Quoten. Retries und abgebrochene Agent-Läufe sollten separat eingeplant werden. Bei hohem Output-Volumen kann ein realistischer Wert für max_tokens sowie ein niedrigeres reasoning_effort, wo es passt, wichtiger sein als die Optimierung eines kleinen Prompt-Präfixes.
Z.AI API: Einschränkungen vor der Migration prüfen
Als allgemeine Base-URL nutzt die offizielle Z.AI API https://api.z.ai/api/paas/v4/; für Chat Completions lautet der Endpunkt https://api.z.ai/api/paas/v4/chat/completions. Die Authentifizierung erfolgt mit einem Bearer-API-Key. In seiner API-Einführung dokumentiert Z.AI OpenAI-kompatible Client-Muster für Python, Node.js und Java über eine eigene Base-URL.
Die aktuelle Chat-Completion-Referenz nennt GLM-5.3-FLASH bei Thinking und Reasoning, in der gerenderten Model-Enum erscheint glm-5.3-flash jedoch nicht. Die offizielle Preisseite und die Launch-Unterlagen führen die Flash-SKU dagegen auf. Vor einer Umschaltung von Produktionstraffic sollte die exakte gehostete Modell-ID mit einer kleinen Anfrage getestet werden.
| Integrationsdetail | Verifizierte Einschränkung |
|---|---|
| Zu testende gehostete Modell-ID | glm-5.3-flash; Annahme gegen das Live-Schema des Accounts bestätigen |
| Gehosteter Endpunkt | https://api.z.ai/api/paas/v4/chat/completions |
| Authentifizierung | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH nutzt aktiviertes Thinking; die Tiefe wird mit reasoning_effort gesteuert |
| Reasoning-Aufwand | low, high oder max |
Maximales max_tokens | 131,072 in der aktuellen Parameterreferenz |
| Coding Plan | Separater Key, Endpunkte und Creditsystem; kein allgemeines API-Guthaben. Siehe Z.AI-Schnellstart für den Coding Plan |
Z.AI setzt max als Standard für den Reasoning-Aufwand. Der Tokenpreis ändert sich nicht mit dem Effort-Level, aber Reasoning kann Output-Verbrauch und Wartezeit verändern. Für Account-Limits verweist Z.AI auf ein kontospezifisches Rate-Limit-Dashboard; die öffentliche Dokumentation nennt keine universelle numerische Obergrenze für alle API-Accounts.
Open Weights oder gehostete API?
Die offizielle Modellkarte enthält Rezepte für lokales Serving mit Transformers, vLLM, SGLang, TokenSpeed und KTransformers. Daraus lässt sich aber keine praktische Bereitstellung auf Consumer-GPUs ableiten.
Die gehostete API eignet sich für unregelmäßigen Traffic oder wenn keine Inferenz-Hardware mit viel Speicher verfügbar ist. Verteiltes oder lokales Serving ist eine Überlegung wert, wenn die Auslastung dauerhaft hoch ist oder die Kontrolle über den Umgang mit Daten den operativen Aufwand rechtfertigt. Ein Text-Build mit reduzierter Präzision bildet das offizielle multimodale Setup möglicherweise nicht nach.
Ab wann sich Self-Hosting rechnen kann
Eine Schätzung von GetDeploying veranschlagt für ein 4-Bit-Deployment rund 192 GB GPU-Speicher, etwa 384 GB für 8-Bit und 768 GB für BF16. Für eine kontinuierlich betriebene MI300X-Konfiguration zu $2.90 pro Stunde werden rund $2,088 pro Monat geschätzt. Bei einem Input-zu-Output-Verhältnis von 5:1 liegt die API-/Self-Hosting-Parität demnach bei ungefähr 14 Millionen Token pro Stunde.
Das sind Schätzungen eines Drittanbieters, keine Hardware-Garantien von Z.AI. Die 192-GB-Konfiguration mit 4 Bit wird als knapp eingestuft; KV-Cache, Runtime-Overhead, multimodale Verarbeitung, Batching und Leerlaufzeit können den Break-even verschieben. Vor einer Entscheidung für lokale Inferenz sollten Infrastrukturkosten pro Stunde, Auslastung, effektive Token pro Stunde, Cache-Trefferquote und Kosten pro erledigter Aufgabe verglichen werden.
GLM-5.3-Flash oder GLM-5.3: Wo die Grenze verläuft
Flash und das Standardmodell GLM-5.3 haben unterschiedliche Preislisten und Einsatzpositionen.
| Frage | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Listenpreis Input | $0.15 / 1M | $1.40 / 1M |
| Listenpreis gecachter Input | $0.03 / 1M | $0.26 / 1M |
| Listenpreis Output | $0.50 / 1M | $4.40 / 1M |
| Befristete Aktion | 50% Rabatt bis 9. September 2026 UTC+8 | Keine entsprechende Flash-Aktion ausgewiesen |
| Open-Weight-Checkpoint | Offizieller MIT-Checkpoint gelistet | Separater Modelleintrag; keine identischen Gewichte unterstellen |
| Multimodale Positionierung | Nativ multimodal; Bild- und Video-Input von Z.AI beschrieben | Abdeckung des Standardmodells GLM-5.3 separat bewerten |
| Lokale Bereitstellung | Großer Checkpoint und Serving mit viel Speicher erforderlich | Eigene Modell- und Deployment-Dokumentation verwenden |
Flash sollte die erste Wahl sein, wenn Tokenkosten, multimodaler Input oder ein Open-Weight-Weg zählen und die Anwendung verpflichtendes Reasoning sowie Anbietergrenzen tolerieren kann. Das Standardmodell GLM-5.3 ist erst dann sinnvoll, wenn Messungen zeigen, dass sein höherer Preis einen für die Anwendung relevanten Unterschied bei Fähigkeiten oder Zuverlässigkeit bringt.
FAQ
Was kostet die GLM-5.3-Flash API aktuell?
Die offiziellen Listenpreise liegen bei $0.15 für Input, $0.03 für gecachten Input und $0.50 für Output pro 1M Token. Die Tabelle oben enthält die vorübergehenden Preise mit 50% Rabatt.
Gilt für gecachten Input der Tarif von $0.03?
Ja, sofern Z.AI die Token als gecacht erkennt. Die Speicherung gecachter Inputs ist separat als befristet kostenlos gelistet. Speicherstatus und Abrechnung für Cache-Treffer sollten daher nicht zusammengeworfen werden.
Ist GLM-5.3-Flash Open Source?
Die präzise Bezeichnung lautet: ein Open-Weight-Checkpoint unter MIT-Lizenz. Die Lizenz erlaubt eine breite Nutzung, doch das Modell mit insgesamt 320B Parametern benötigt weiterhin erheblichen Speicher, kompatible Software und Serving-Kapazität.
Kann ich GLM-5.3-Flash auf einem normalen Laptop ausführen?
Nicht als praktikables Deployment in voller Präzision. Selbst Drittanbieter-Schätzungen für 4 Bit liegen bei rund 192 GB GPU-Speicher, und 18B aktive Parameter beseitigen weder Speicher- noch Runtime-Kosten des vollständigen Checkpoints.
Ist GLM-5.3-Flash schneller als GLM-5.3?
„Flash“ ist als Positionierung bei Kosten und aktiver Rechenleistung belegt, nicht als universelle Latenzgarantie. Artificial Analysis berichtet in seinem gemessenen Setup über Z.AI von 48.7 Output-Token pro Sekunde und 42.57 Sekunden bis zum ersten Antwort-Token. Reasoning-Zeit und Workload-Struktur können die gefühlte Antwortzeit dominieren.
Bietet der Coding Plan dasselbe API-Guthaben?
Nein. Der Z.AI-Schnellstart für den Coding Plan dokumentiert einen separaten Coding-Plan-Key, eigene Endpunkte und einen Zugriff, der auf offiziell unterstützte Tools und Produkte begrenzt ist. Ein Coding-Plan-Abo lässt sich nicht direkt in ein öffentliches API-Budget in Dollar pro Token umrechnen.
Bei unregelmäßigem Traffic und noch nicht bezahlter Hardware ist die API der risikoärmere Weg. Lokales Serving ist eine andere wirtschaftliche Entscheidung, die von dauerhafter Auslastung, verfügbarem Speicher und Anforderungen an die Datenkontrolle abhängt.