 AIREITER
Für den normalen Entwickleralltag ist Gemini 4 Argon weiterhin die bessere Wahl. Gemini 4 Carbon lohnt den zusätzlichen Aufwand erst bei Aufgaben, die über Nacht laufen dürfen: Refactorings mit mehreren Agenten, Dokumentaufbauten aus 200 Ansichten oder Schleifen vom Exploit bis zum Patch. Auch Google positioniert Gemini 4 Argon als ideale Wahl für die meisten Softwareentwicklungs- und Wissensaufgaben; Carbon übernimmt die besonders harten Fälle, verbraucht dabei aber mehr Tokens.
Gemini 4 Carbon ist ein Frontier-Reasoning-Modell auf Basis von Gemini 4 Argon. Google kündigte Carbon am 28. Oktober 2026 an und stellte es am 10. November 2026 allgemein bereit. Laut DeepMind Model Card reicht der Wissensstand bis März 2026. Das Modell verarbeitet bis zu 1 Million kombinierte Input- und Output-Tokens, nimmt Text, Dokumente, Bilder, Audio und Video entgegen und gibt Text aus.
Wer Carbon derzeit nutzen kann
Der Zugang zu Gemini 4 Carbon hängt vom Kanal ab – und für Privatnutzer ist er am stärksten eingeschränkt. Entwickler erhalten das Modell über die kostenpflichtige Gemini-API-Stufe in Google AI Studio, außerdem über Android Studio und Gemini for Business. Für Verbraucher ist Carbon in der Gemini-App, im AI Mode der Suche und in Google Antigravity ausschließlich mit Google AI Ultra verfügbar. Wissenschaftler können sechs Monate kostenlosen Zugang zur höchsten Nutzungsstufe von Antigravity beantragen; verifizierte Defender bewerben sich über das Fairwind Program.
Google-AI-Pro-Abonnenten erhalten Carbon nicht auf den Consumer-Oberflächen. Diese Einschränkung wurde in Launch-Threads bei r/GeminiAI mehrfach thematisiert.
"Available for ULTRA. Argon for pro is gone in two prompts." — u/Nodayssoff auf r/GeminiAI
Die verlinkten Launch-Unterlagen nennen weder feste Consumer-Quoten noch einen Termin für die Pro-Stufe oder eine länderübergreifend identische Verfügbarkeit. In den verlinkten Nutzerberichten waren Fünf-Stunden- und Wochenkontingente nach wenigen Prompts aufgebraucht; Schlüssel funktionierten auf einer Oberfläche, wurden aber in Antigravity gesperrt – siehe Zugangs-Thread und Quoten-Thread. Hinzu kamen am ersten Tag Fehler mit An internal error has occurred. Ultra sollte daher als Testzugang für Carbon kalkuliert werden, nicht als unbegrenzter Zugriff.
Carbon und Argon im Direktvergleich
Gemini 4 Carbon und Gemini 4 Argon haben dieselben Listenpreise und dieselbe Kontextgröße. Die Unterschiede liegen bei Fähigkeiten, Latenz und Tokenhunger.
| Merkmal | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| Basis | Basiert auf Argon, mit mehr Reasoning für schwierige Aufgaben mit langem Horizont | Frontier-Basismodell, Standard für routinemäßige Entwicklung |
| GA | 10. November 2026 | 13. Oktober 2026 laut ToolColumn-Vergleich |
| API-Modell-ID | Beim Aufruf in AI Studio prüfen; Launch-Beiträge nennen keine separate stabile ID | gemini-4-argon laut ToolColumn-Vergleich |
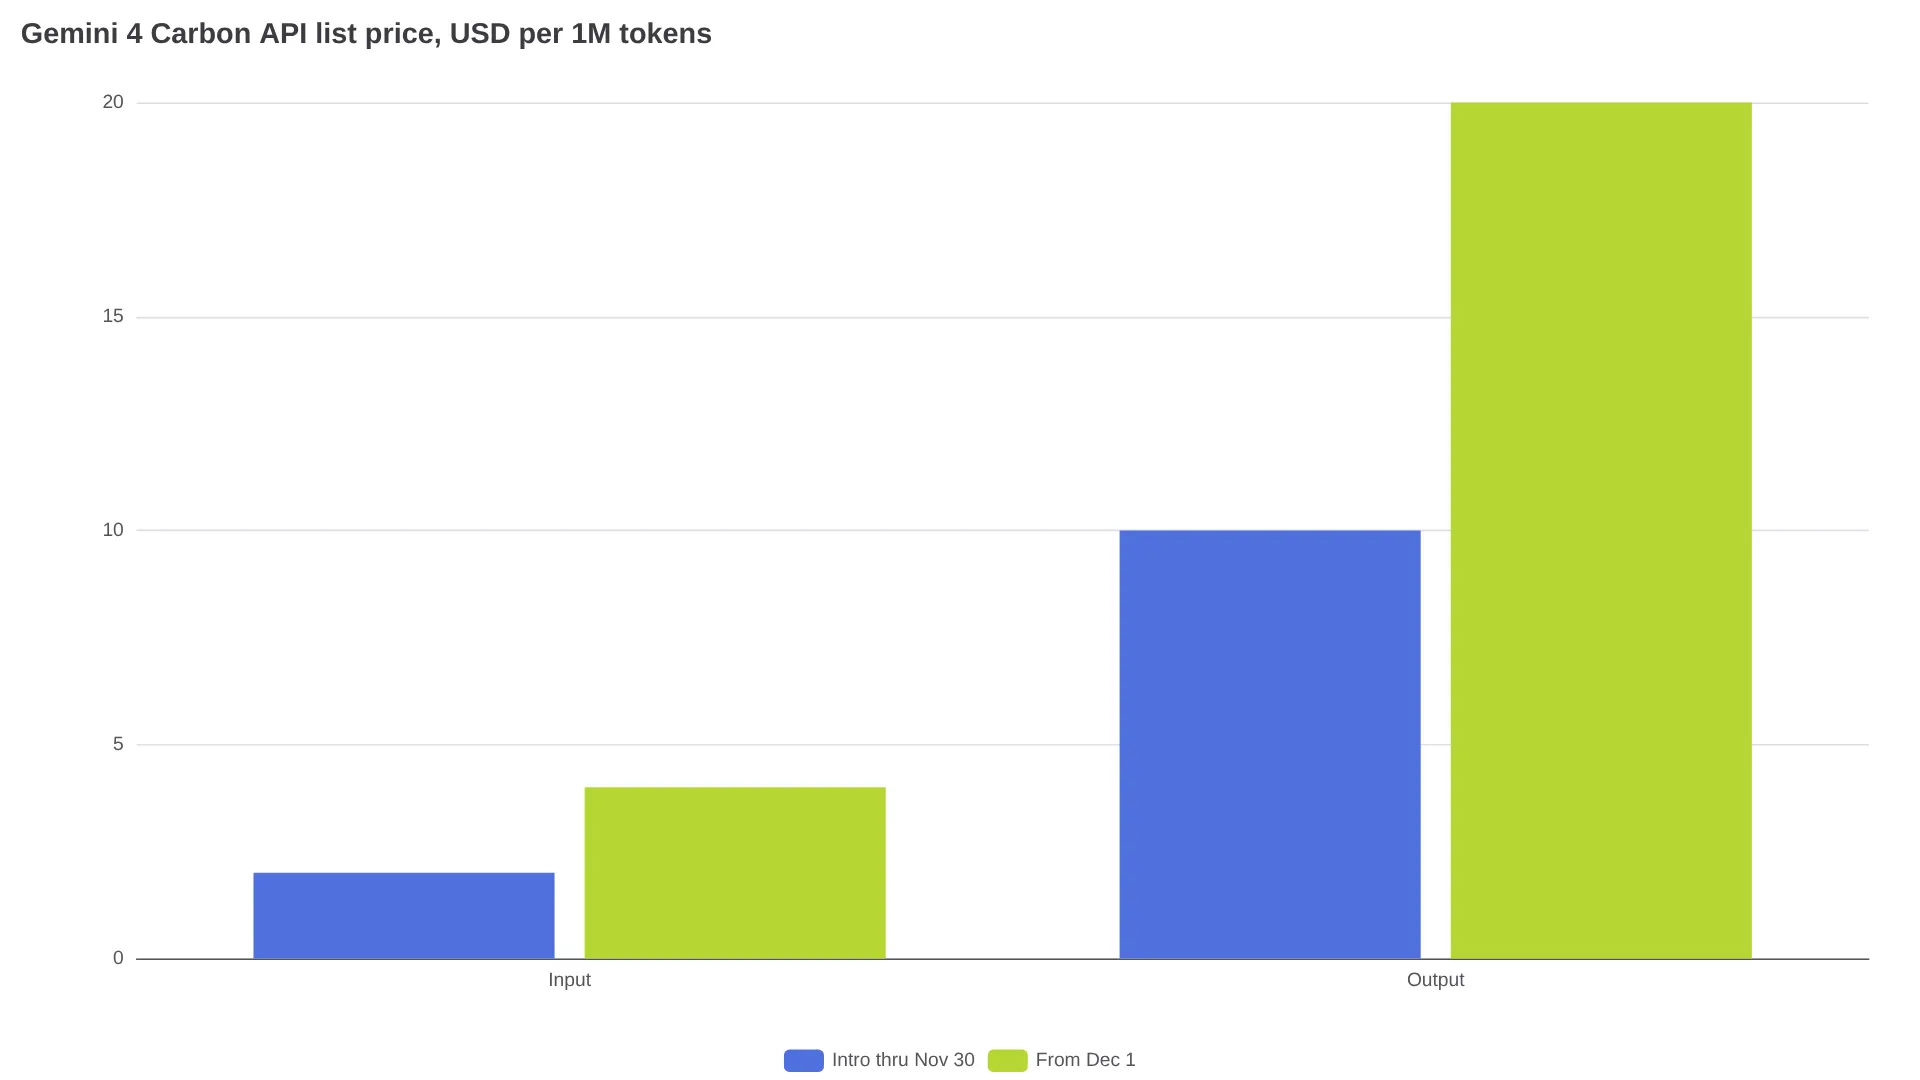
| API-Listenpreis, Einführung bis 30. November 2026 | 2 $ Input / 10 $ Output je 1 Mio. Tokens, 0,10 $ gecachter Input | 2 $ Input / 10 $ Output je 1 Mio. Tokens, 0,10 $ gecachter Input |
| API-Listenpreis ab 1. Dezember 2026 | 4 $ Input / 20 $ Output je 1 Mio. Tokens | 4 $ Input / 20 $ Output je 1 Mio. Tokens |
| Kontext | Bis zu 1 Mio. kombinierte Input- und Output-Tokens | 1.048.576 Tokens laut ToolColumn-Vergleich |
| Eingabemodalitäten | Text, Dokumente, Bilder, Audio, Video | Text, Bilder laut Artificial Analysis |
| Artificial Analysis Intelligence Index v5.0.1 | 60 | 50 |
| Gewichtete Kosten je Index-Aufgabe | 7,76 $ | 9,95 $ |
| Ausgabegeschwindigkeit | 82 Tok./s | 68 Tok./s |
| Zeit bis zum ersten Antwort-Token | 67,54 s | 40,02 s |
| Thinking-Stufen | Konfigurierbar, höhere Stufen verbrauchen mehr Tokens | Niedrig / Mittel / Hoch, standardmäßig Mittel laut ToolColumn-Vergleich |
Die Preise stammen aus Googles Verfügbarkeitsankündigung; Geschwindigkeit, Latenz, Kosten pro Aufgabe und Modalitätsunterschiede liefert Artificial Analysis Carbon vs Argon. Gecachter Input kostet 95 % weniger als der Listenpreis, also 0,10 $ je 1 Mio. Tokens zu Einführungspreisen.
Gleicher Listenpreis heißt nicht gleiche Workload-Kosten. Artificial Analysis beziffert Carbon mit 7,76 $ pro gewichteter Intelligence-Index-Aufgabe, gegenüber 9,95 $ für Argon – obwohl Carbon im Schnitt rund 7.000 Output-Tokens mehr pro Aufgabe erzeugt. Carbon erledigt gewichtete Aufgaben in 24,9 Minuten statt 28,6 Minuten, benötigt aber 67,54 Sekunden bis zum ersten Antwort-Token gegenüber 40,02 Sekunden bei Argon. Carbon arbeitet auf Dauer stärker, antwortet anfangs jedoch langsamer.
Wo Carbon klar vorn liegt – und wo nicht
Google führt 17 Evaluierungen auf; ausgewählte Zeilen für Carbon und Argon stehen unten. Gemini 4 Carbon schlägt Gemini 4 Argon in allen 17 Zeilen und führt das Feld aus fünf Modellen in 15 davon an. Die zwei Ausnahmen sind relevant: GPT-6 Astra liegt bei FrontierSWE 2 mit 65,5 % vor Carbons 61,2 %, während Claude Opus 5.5 OSWorld-2.1 offline mit 87,2 % gegenüber 81,5 % für Carbon anführt.
| Arbeitslast | Benchmark | Carbon | Argon | Abstand |
|---|---|---|---|---|
| Agentisches Coding | SWE-sweep | 9,6 % | 4,3 % | +5,3 Prozentpunkte |
| Agentisches Coding | Terminal-Bench 4.0 | 65,2 % | 57,1 % | +8,1 Prozentpunkte |
| Agentisches Coding | FrontierSWE 2 | 61,2 % | 55,0 % | +6,2 Prozentpunkte, weiterhin hinter Astra |
| Computernutzung | Agents' Last Exam v1.1 | 77,4 % | 69,0 % | +8,4 Prozentpunkte |
| Computernutzung | OSWorld-2.1 offline | 81,5 % | 74,7 % | +6,8 Prozentpunkte, weiterhin hinter Opus 5.5 |
| Wissensarbeit | AutomationBench, Zapier | 53,9 % | 51,3 % | +2,6 Prozentpunkte |
| Wissensarbeit | Vending-Bench 2 balance | 16.484 $ | 13.718 $ | +2.766 $ simuliertes Guthaben |
| Langer Kontext | GraphWalks 256K-1M BFS F1 | 96,2 % | 84,2 % | +12,0 Prozentpunkte |
| Wissenschaft | Terminal-Bench-Science 0.1 | 64,8 % | 52,9 % | +11,9 Prozentpunkte |
| Wissenschaft | RiemannBench | 80,0 % | 76,0 % | +4,0 Prozentpunkte |
| Cyber | ExploitGym | 54,8 % | 42,0 % | +12,8 Prozentpunkte |
| Cyber | SEC-bench Pro | 88,2 % | 83,4 % | +4,8 Prozentpunkte |
| Cyber | CWE-bench | 71,0 % | 68,0 % | +3,0 Prozentpunkte |
Alle Zeilen stammen aus der Tabelle der DeepMind Model Card vom Oktober 2026. Die Cyber-Zeilen beziehen sich auf Fairwind-Zugang ohne Schutzmechanismen, nicht auf das Standardverhalten des Produkts. Dieselbe Model Card ergänzt Chartography (72,5 % vs. 71,6 %), Vals Index (70,4 % vs. 69,2 %), AA Index v5.0 (59 vs. 50) und Blueprint-Bench 2 similarity (58,6 % vs. 54,4 %) – damit sind alle 17 komplett.
- Besonders harte technische Aufgaben: Die größten Carbon-Vorsprünge zeigen sich bei Exploit-Validierung, Graph-Retrieval mit 256K bis 1M Tokens, Terminal-Wissenschaft und mehrstufigem Terminal-Coding.
- Routinemäßige Wissensarbeit: Bei Diagrammlesen, allgemeinen Evaluierungen und Büroautomatisierung schrumpfen die Abstände auf 1 bis 3 Punkte.
- Aufrichtigkeit und Sicherheit: Google berichtet im Beitrag zur Carbon-Einführung von bestandenen Agentic-Honesty-Tests bei 92 % von 375 Aufgaben gegenüber 70 % für Argon sowie von 0,0 % erfolgreichen indirekten Prompt-Injections gegenüber 0,7 % für Argon; unbelegte Behauptungen seien etwa halbiert worden.
Bei Artificial Analysis liegt Carbon in allen neun Komponenten des Intelligence Index vorne, besonders beim physikalischen Reasoning und Open-Repo-Engineering wie FrontierCode 2.0 mit 40,6 % gegenüber 25,7 % für Argon. Googles Verfügbarkeitsbeitrag beansprucht zusätzlich Platz 1 bei CursorBench 4.0, Perplexity WANDR und Zapier AutomationBench – bei mehr als doppelt so niedrigen Kosten je Aufgabe wie das nächstbeste externe Modell.
Welche Aufgaben zu Carbon gehören – und welche bei Argon bleiben
Gemini 4 Carbon passt zu Aufgaben, bei denen sich Prüf- und Korrekturschleifen auszahlen: etwa zu zehn Iterationen über Nacht für Three.js-Neubauten aus mehr als 200 PDF-Zeichnungsansichten oder zu Multi-Agent-/swarm-Physikprojekten, die Googles Verfügbarkeitsbeitrag dokumentiert. Der folgende Community-Build zeigt das Muster in kleinerem Maßstab.
"Touching grass with Gemini 4 Carbon. Made this grass meadow from scratch in CUDA and C++ with no game engine or 3D library. 52k blades and wildflowers, and I ended up synthesizing the wind sound in C++ too so the same gusts [drive the audio]." — @GlitterPixely auf X
Routineaufgaben bleiben bei Gemini 4 Argon. Der kleinste gemessene Carbon-Vorsprung zeigt sich beim Diagrammlesen und bei Büroautomatisierung. Einzeldatei-Änderungen, übliches CRUD und Tabellen mit festem Schema sollten daher auf Argon starten – auch, weil es schneller das erste Token liefert und Carbon mehr Tokens verbraucht. Hohes Thinking verschlingt bei kurzen Storytelling-Aufgaben rasch Tokens: Ein OpenRouter-Bericht nennt bei High rund 6.000 Thinking-Tokens für eine Geschichte mit 4.000 Zeichen.
Praktisch empfiehlt sich: Neue Agenten zunächst auf Argon Medium starten, um Prompts, Quoten und Tool-Berechtigungen zu validieren. Zu Carbon wandert nur der problematische lange Schwanz: paketübergreifende Migrationen, Ursachenanalysen über mehrere Subsysteme, Dokumentsätze mit mehr als 100K Tokens samt Zeichnungen und Tabellen sowie Fortify-artige Schleifen aus Scan, Triage und Behebung. Für Letztere berichtet Googles Verfügbarkeitsbeitrag intern von 100 % Scan-Recall und 95 % Triage-Präzision. In /swarm übernimmt Carbon die Rollen Architektur, Koordination und adversarial Verifier; leichtere Modelle bearbeiten parallele Workspaces. Wirft ein Carbon-Run wiederholt interne Fehler, zunächst in einer frischen Sitzung erneut versuchen, statt das Thinking hochzudrehen: Die Threads vom ersten Tag berichten Fehler ohne eindeutige Ursache.
Carbon ab dem 1. Dezember budgetieren
Wenn sich die API-Listenpreise am 1. Dezember verdoppeln, ist aggressives Input-Caching mit 95 % Rabatt auf den Listenpreis der wichtigste Hebel, um Repositories, Zeichnungen und Tool-Ausgaben wiederzuverwenden.
Die Kalkulation sollte nicht allein auf Listenpreisen beruhen. Carbon erzeugt pro gemessener Aufgabe mehr Output-Tokens. Ein Monat mit 50M Input und 5M Output verdoppelt sich daher zu Listenpreisen bei beiden Modellen von 150 $ zur Einführung auf 300 $ danach – noch ohne Carbons zusätzliches Thinking. Dennoch weist Artificial Analysis für Carbon niedrigere gewichtete Kosten pro abgeschlossener Intelligence-Index-Aufgabe aus, weil weniger Wiederholungen und ein schnellerer dauerhafter Durchsatz das Tokenvolumen ausgleichen. Die Regel lautet: High für Exploit-Ketten und Terminal-Wissenschaft, wo Carbon 8 bis 13 Punkte führt; Medium oder Low für Dokumente und UI-Politur, wo der Vorsprung 1 bis 3 Punkte beträgt.
Eine detailliertere Einzelpostenrechnung bietet der Gemini 4 Carbon API pricing review der Website.
FAQ zu Gemini 4 Carbon
Bekommt Google AI Pro irgendwann Carbon?
Die verlinkten Materialien nennen keinen Termin für Pro. Bei Argon bleiben und Ultra als kurzfristigen Carbon-Testzugang betrachten.
Welche Thinking-Stufe bestimmt die Rechnung?
Medium validiert Prompts; High ist für Exploit-Ketten und Terminal-Wissenschaft mit Abständen von mehr als 8 Punkten gedacht.
Teilen sich Carbon und Argon ein Quotenkontingent?
Eine belastbare Dokumentation zu einer gemeinsamen Quote gibt es nicht. Die aktuellen Kontolimits je Oberfläche prüfen; die Angabe von 1M beschreibt Kontextkapazität, keine Nutzungsquote.
Die Entscheidung auf einen Blick
| Wenn die Arbeit so aussieht | Empfehlung | Warum |
|---|---|---|
| Diese Woche liefern, Routinecode und Dokumente | Argon Medium | 1 bis 3 Punkte Abstand, schnelleres erstes Token, geringerer Verbrauch |
| Mehrtägige Migration, Repository mit mehr als 100K Tokens plus Zeichnungen | Carbon, danach auf Medium zurück, sobald alles grün ist | +8 bis 12 Punkte bei Terminal und langem Kontext |
| Open-Source-Schwachstellen scannen, triagieren und patchen | Carbon über Fairwind/API | +12,8 Punkte bei ExploitGym laut Model Card; Secure-Code-Rate mehr als doppelt so hoch wie bei Argon |
| Finanz- und Rechtsdokument-Agenten mit Diagrammen | Zuerst Argon, Carbon bei strittigen Zahlen | Carbon laut Verfügbarkeitsbeitrag auf Platz 2 bei Multimodal Knowledge Agent und mit sechsmal niedrigeren Aufgabenkosten als der Spitzenreiter, aber Argon liegt bei AutomationBench nahe dran |
| Ultra-Abonnent mit engem Wochenkontingent | Argon täglich, Carbon für einen schwierigen Run | Einige Nutzer berichten, dass Carbon Kontingente in wenigen Prompts aufbraucht |
Carbon ist ein Spezialist, den man für die schwierige Aufgabe bucht, kein Modell für die Standardeinstellung. Argon trägt die tägliche Warteschlange; Carbon rechtfertigt seinen Dezember-Listenpreis erst dann, wenn Prüfschleifen und die Tiefe vom Exploit bis zum Patch über das Ergebnis entscheiden.