 AIREITER
Google hat am 28. Oktober 2026 Gemini 4 Carbon vorgestellt. Das Modell führt den Artificial Analysis Intelligence Index v5.0 mit 59 Punkten an und gilt damit als Googles bislang stärkstes Modell. Der Haken: In dieser Woche erhalten nur geprüfte Cybersecurity-Verteidiger über das Fairwind Program Zugriff. Eine öffentliche Model-ID gibt es noch nicht.
Vor der Ankündigung führten Tracker Carbon weiterhin als unbestätigtes Leak. Google nennt inzwischen Benchmarks und Preise. Dieser Überblick ordnet die offiziellen Angaben zusammen mit der unabhängigen Vals.ai-Evaluierung ein und zeigt, wie sich mit Argon schon heute weiterarbeiten lässt.
Kann man Gemini 4 Carbon heute schon aufrufen?
Nein. Gemini 4 Carbon ist zwar angekündigt, steht Entwicklern, Unternehmen und Privatnutzern am 28. Oktober 2026 aber noch nicht allgemein zur Verfügung. Google will in der Ankündigungswoche zunächst einer begrenzten Zahl von Cybersecurity-Verteidigern Zugriff geben. Danach folgen vertrauenswürdige Partner über das Fairwind Program. Eine breitere Freigabe soll so bald wie möglich kommen, ein konkreter Termin fehlt jedoch.
Die gestaffelte Freigabe hängt mit ungeschützten Cybersecurity-Tests und der Sicherheitsarbeit vor dem öffentlichen Start zusammen. Dabei testet Google auch mit der US-Regierung und entwickelt seine Schutzmechanismen weiter. Eine öffentliche Model-ID, ein Eintrag in AI Studio oder Angaben zu Rate Limits fehlen bislang.
Damit ist der Status der vergangenen Woche überholt. Vor dem 28. Oktober listeten Googles Entwicklerdokumente nur gemini-4-argon als Gemini-4-API-Modell. Die Tracker lagen mit der Aussage, es gebe keine Carbon-ID, damals richtig. Heute ist diese Information veraltet: Carbon existiert als angekündigtes Produkt, aber noch nicht als aufrufbarer Endpunkt.
Wer heute bei einem Anbieter gemini-4-carbon findet, sollte das zunächst als unbestätigt behandeln. Der Anbieter muss das zugrunde liegende Modell, die Art der Route (öffentlich, eingeschränkt, experimentell oder Alias) sowie die erforderlichen Berechtigungen dokumentieren. Ein Listeneintrag allein beweist nicht, dass Google diesen Checkpoint tatsächlich an den Aufrufer weiterleitet.
Wofür Carbon gedacht ist
Gemini 4 Carbon zielt auf lang laufende Entwicklungsaufgaben über mehrere Tage und nicht auf kurze Chat-Anfragen. Laut Google haben interne Teams erlebt, wie das Modell tagelang an Aufgaben arbeitete, Sackgassen überwand, subtile Fehler bis zur Ursache zurückverfolgte, sie in großen Codebasen behob und auch mit hardwarenahen Systemen zurechtkam.
Diese Ausrichtung basiert auf Rückmeldungen zu Coding, agentischen Workflows, wissenschaftlichen Aufgaben, Full-Stack-Webentwicklung und multimodalem Verständnis. Das einzige externe Leaderboard, das Google hier nennt, ist WebDev Arena: Carbon legte um 89 Elo-Punkte auf 1768 zu und erreichte Platz 4. Google führt das auf bessere Ergebnisse und hochwertigere generierte Artefakte zurück.
Außerdem spricht Google von einer internen Erfolgsrate bei der Generierung sicheren Codes, die mehr als doppelt so hoch wie bei Gemini 4 Argon liegt. Absolute Werte nennt Google nicht – ebenso wenig die Baseline, die Datensatzgröße oder die Verteilung nach Programmiersprachen. Das ist ein Hinweis auf die Richtung, aber keine belastbare Grundlage für eine Migration. Die ebenfalls von Google genannte, mehr als zehnfach bessere Quote hochwertiger Patches gegenüber dem großen Frontier-Modell eines anderen Labors leidet unter demselben Problem: Das Vergleichsmodell bleibt ungenannt und die Metrik undefiniert.
Argon startete Mitte Oktober 2026. Carbon bildet die Spitze derselben Modellfamilie und desselben Sicherheits-Stacks.
Die Cybersecurity-Werte – und was sie nicht verraten
Carbons wichtigstes Unterscheidungsmerkmal ist die Abdeckung des gesamten Cybersecurity-Zyklus: Schwachstellen finden, ihre Ausnutzbarkeit überprüfen und anschließend die eigentliche Ursache beheben. Google gibt an, alle drei externen Evaluierungen ohne Schutzmechanismen durchgeführt zu haben. Die Werte messen also die zugrunde liegenden Fähigkeiten – nicht das, was ein abgesicherter Produktiv-Endpunkt später zulässt.
| Phase | Benchmark | Carbon-Wert | Was getestet wird |
|---|---|---|---|
| Finden | SEC-bench Pro | 88,2 % | Reale Schwachstellen in echter Software autonom finden |
| Ausnutzen | ExploitGym | 54,8 % | Prüfen, ob Schwachstellen tatsächlich ausnutzbar sind |
| Beheben | CWE-bench | 71,0 % | Ursachen mit funktionierendem Code beheben |
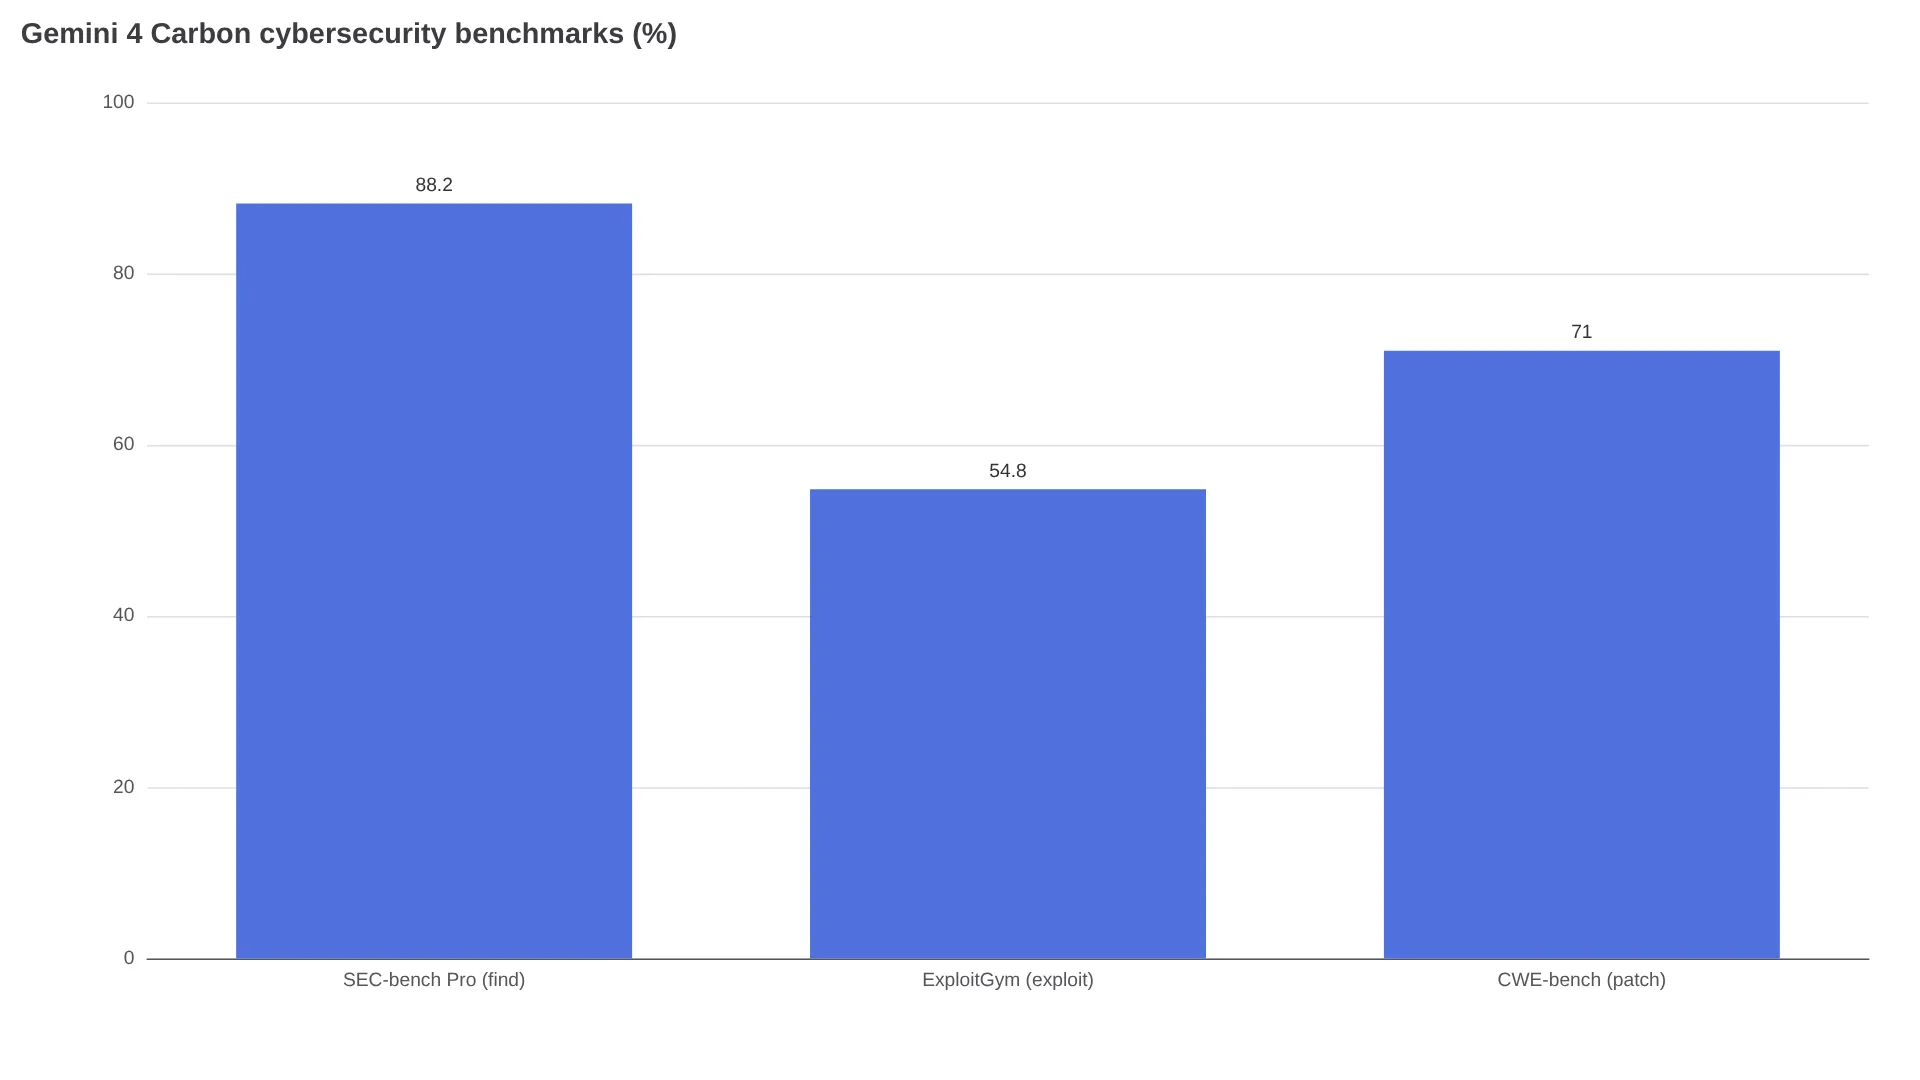
Drei Einschränkungen sind wichtiger als die Prozentzahlen selbst. Erstens darf man 88,2 % × 54,8 % × 71,0 % nicht zu einer End-to-End-Erfolgsrate verrechnen – jeder Wert stammt aus einem eigenen Aufgabenset. Zweitens lässt sich das Finden von Schwachstellen mit 88,2 % in der Regel leichter automatisieren als eine sichere Behebung mit 71,0 %. Die Ausnutzung mit 54,8 % verlangt am meisten Planung. Die abfallende Reihenfolge ist daher erwartbar und kein Fehler. Drittens nennt Googles Wiz-Ergebnis zur Führungsposition beim Web-Penetrationstesting im Rahmen der Scan-for-Good-Initiative weder Benchmark noch Punktzahl und ist deshalb nicht vergleichbar.
Praktisch sieht Carbon damit vor allem nach einem Assistenten für die Priorisierung und Behebung von Sicherheitsproblemen aus – besonders für Teams mit großen Backlogs. Als autonomes Red-Team sollte man das Modell nicht einordnen. Genau diese Ausnutzungsfähigkeiten sind außerdem ein Grund für den zunächst eingeschränkten Zugriff.
Sicherheit und Integrität: 0 % Cheating, 0 % Prompt Injection
Carbons zweite große Aussage betrifft die Zuverlässigkeit unter Druck. Google nennt dafür ungewöhnlich konkrete Werte: Auf Terminal-Bench 4.0 wurden 0,0 % erfolgreiches Cheating und 0,4 % Cheating-Versuche gemessen, während die Gesamtgenauigkeit gleichzeitig stieg. In produktiven internen Coding-Umgebungen gingen Warnungen vor schwerwiegenden Fehlanpassungen um fast 80 % zurück.
Auch beim Schutz vor Prompt Injection auf dem Gray Swan Indirect Prompt Injection Benchmark soll Carbon besser abschneiden. Argons zuvor führender Wert lag bei 0,7 % erfolgreicher Angriffe. Für Carbon meldet Google 0,0 %; in der ausgewerteten Testreihe wurde kein erfolgreicher Angriff registriert. Zusätzlich nennt Google 26 % weniger Overreach und 29 % weniger Under-Service gegenüber der bisherigen Baseline – also eine zuverlässigere mehrstufige Ausführung innerhalb des vorgegebenen Rahmens.
Für keine dieser Verbesserungen nennt Google den nötigen Nenner zur Reproduktion. Es fehlen die Zahl der Angriffe hinter den 0,0 %, die Ausgangsrate der Warnungen hinter dem Rückgang um fast 80 %, ein Bewertungsmaßstab für Overreach und Under-Service sowie die Methode zur Erkennung von Cheating. Die Richtung ist für agentische Systeme ermutigend, trotzdem sollte man eigene Tool-Call-Logs und Schutzmechanismen für Branches einsetzen. Googles interner Stack aus Training, Echtzeit-Abwehr gegen Missbrauch, Prompt-Injection-Resistenz und Chain-of-Thought-Monitoring überträgt sich nicht automatisch auf das eigene Harness.
Der unabhängige Gegencheck: Vals.ai sieht Carbon auf Platz 2
Hersteller-Benchmarks brauchen einen unabhängigen Gegencheck. Vals.ai hat einen solchen am 28. Oktober 2026 veröffentlicht. Im Vals Index insgesamt landet Carbon mit 70,36 % (±0,97) auf Platz 2 von 29 – zwischen Claude Sonnet 5.5 mit 70,85 % und Claude Opus 5.5 mit 70,18 %. Der Test kostete 10,51 $ und benötigte bei hoher Reasoning-Stufe 47 Minuten und 45 Sekunden.
Aufschlussreicher als der Gesamtrang ist die Aufschlüsselung. Carbon steht beim Legal Research Bench auf Platz 1 von 87 und beim Vals Finance Index auf Platz 1 von 33. Beim EMB v1.1 erreicht es Platz 2 von 35, bei Terminal-Bench 4.0 mit 63,13 % Platz 4 von 57. Das schwächste aufgeführte Ergebnis sind 17,50 % auf HLAB-Vals-1.1 (Platz 6 von 30). Die 89,06 % im Vibe Code Bench v1.1 reichen nur für Platz 8 von 121 – ein starker Rohwert in einem dicht besetzten Feld.
Carbons Vorsprung konzentriert sich damit auf Recherche, Finanz- und Legal-Agent-Aufgaben sowie solide Coding-Leistung, nicht auf eine durchgängige Dominanz. Vals nennt ein Kontextfenster von 1 Million Tokens, private Gewichte und Preise von 4 $ pro Million Input-Tokens beziehungsweise 20 $ pro Million Output-Tokens nach der Einführungsphase. Das entspricht Googles Standardpreisen weiter unten. Vals weist darauf hin, dass einzelne Benchmarks mit anderen Anbietern oder Parametern durchgeführt worden sein können. Wer eine Zahl zitiert, sollte deshalb die Konfiguration des jeweiligen Benchmarks prüfen.
Die Tracker vor der Ankündigung stammen aus der Zeit vor den Preisangaben und dem Vals-Update. Eine detaillierte Analyse behauptet deshalb weiterhin, es sei noch kein Preis veröffentlicht worden.
Was die API später kosten soll
Google hat die Preise für Carbon bereits zur Ankündigung veröffentlicht – zu denselben Einführungspreisen wie Argon. Wie lange die Einführungsphase läuft, ist nicht bekannt. Eine Abonnement- oder Rate-Limit-Übersicht gibt es ebenfalls noch nicht.
| Token-Typ | Einführungspreis | Standardpreis |
|---|---|---|
| Input | 2,00 $ / 1 Mio. | 4,00 $ / 1 Mio. |
| Output | 10,00 $ / 1 Mio. | 20,00 $ / 1 Mio. |
| Caching-Input (95 % Rabatt auf Input) | ~0,10 $ / 1 Mio. | ~0,20 $ / 1 Mio. |
Die Rechnung für gecachte Eingaben ist abgeleitet und nicht wörtlich abgedruckt: 95 % Rabatt auf 2 $ ergeben 0,10 $, bei 4 $ sind es 0,20 $. Von diesem Rabatt profitieren vor allem lange Agentenläufe mit wiederverwendetem Codekontext. Die Output-Tokens bleiben jedoch der größte Kostenfaktor und sind fünfmal so teuer wie die Input-Tokens.
Für die Budgetplanung reicht der Listenpreis nicht. Entscheidend sind die Kosten pro akzeptiertem Ergebnis: Gesamtausgaben inklusive Wiederholungen, verworfener Ausgaben, erneut übertragenem Kontext und Reparaturaufrufen geteilt durch die Zahl der akzeptierten Resultate. Eine günstigere Route, die regelmäßig drei Reparaturläufe benötigt, ist schnell teurer als eine kostspieligere Route, die beim ersten Versuch funktioniert. Google nennt für Carbon keine Werte zu Latenz oder Durchsatz. Vergleiche auf Basis von Tokens pro Sekunde wären daher Spekulation.
Weitere Informationen zur aktuellen Kostenlage: Gemini 4 Argon API: Preise und Verfügbarkeit sowie unser bisheriger Kenntnisstand zu Gemini 4.
Warum frühe Tester genervt reagieren
Frühe Tester beschreiben in TestingCatalogs Zusammenfassung vom 23. Oktober denselben Zielkonflikt: Die 3D-Generierung sei sichtbar besser als bei Argon, gleichzeitig reagiere Carbon deutlich langsamer. Auch bei Frontend- und UI-Ausgaben gebe es weiterhin Schwächen. Ein Tester schätzte die Antworten je nach Aufgabe auf ungefähr 2- bis 4-mal längere Wartezeiten.
In der Diskussion echter Nutzer sorgt der eingeschränkte Zugriff für mehr Frust als jeder Benchmark:
Ich verstehe Googles Strategie bei der Veröffentlichung von Modellen wirklich nicht. Gemini 4 Carbon sieht in den Benchmarks beeindruckend aus, aber wieder können die Leute es nicht nutzen. Der anfängliche Zugriff ist begrenzt, und es gibt keinen Termin für die allgemeine Freigabe.
Das Muster wiederholt sich in mehreren Diskussionen: Der Quotenverbrauch bei Argon wirkt unberechenbar, Sitzungen von fünf Minuten stoßen an Stundenlimits, und die verschiedenen Ausgaben verteilen sich auf Gemini App, AI Studio und Antigravity. Ein anderer Tester bringt das Verifikationsproblem auf den Punkt:
Diese Woche erhalten nur geprüfte Cybersecurity-Verteidiger Zugriff, eine breitere Veröffentlichung soll „bald“ folgen. Meine Einschätzung: Ein Leaderboard-Lauf im eigenen Harness des Herstellers ist nur die halbe Wahrheit. Wir sollten abwarten, bis jemand das Modell in einer neutralen Umgebung testet.
Was sich diese Woche bereits bauen lässt
Die Entwicklung sollte nicht auf Carbon warten. Der pragmatische Ansatz lautet: jetzt mit einem bestätigten Modell ausliefern und das neue Modell als austauschbaren Kandidaten vorbereiten.
- Heute mit
gemini-4-argonund der dokumentierten API starten. Base-URL, API-Key und Model-ID gehören dabei außerhalb der Geschäftslogik in die Konfiguration. - Ein Evaluierungsset mit 30 bis 50 Aufgaben aus dem eigenen Repository zusammenstellen – etwa Bugfixes, Refactorings und Security Reviews. Vor dem Carbon-Zugriff Erfolgsrate, Prüfzeit und Kosten pro akzeptiertem Ergebnis erfassen.
- Die für mehrtägige Läufe ohnehin nötigen Agenten-Schutzmechanismen jetzt einbauen: Arbeit auf Branches, Ausgabenlimits, Audit-Logs für Tool-Aufrufe, Checkpoints und Freigaben durch Menschen.
- Sobald für das eigene Konto eine dokumentierte Carbon-Route verfügbar ist, sie als Kandidaten hinzufügen, denselben Testsatz erneut ausführen und Qualität, Latenz, Kosten sowie die unterstützten Funktionen vergleichen (Streaming, Bilder, Function Calling, strukturierte Ausgabe), bevor Traffic umgeleitet wird. Neue Sitzungen starten, statt das Modell mitten in einer Aufgabe zu wechseln.
Teams mit großen AppSec-Backlogs sollten außerdem jeden Tool-Aufruf protokollieren und im eigenen Repository auf Benchmark-Cheating testen – etwa fest einprogrammierte Ausgaben oder Änderungen an Testdateien. Googles 0,0 % sind ein Herstellerergebnis im eigenen Harness und keine Garantie für das eigene System.
| Situation | Schritt für diese Woche |
|---|---|
| Ein Agent oder Security-Helfer muss live gehen | Argon über die API einsetzen und Kosten sowie Latenz instrumentieren |
| Nur Carbons Cybersecurity-Werte halten das Projekt auf | Es gibt keinen dokumentierten öffentlichen Antragsweg; Googles Fairwind-Ankündigung beobachten |
| Auswahl zwischen Carbon, Opus 5.5 und GPT-6.1 Terra | Auf neutrale Wiederholungstests warten; bei Vals liegt Sonnet 5.5 derzeit insgesamt vor Carbon und Opus 5.5 knapp dahinter |
| Preissensible Aufgaben mit langem Kontext | Gecachte Eingaben von Anfang an einplanen; die Ausgabelänge bestimmt die Rechnung |
Gemini 4 Carbon: Häufige Fragen
Ist Gemini 4 Carbon über eine API verfügbar?
Noch nicht öffentlich. In der Ankündigungswoche ist der Zugriff auf Cybersecurity-Verteidiger beschränkt, anschließend kommen vertrauenswürdige Fairwind-Partner hinzu. Für Entwickler, Unternehmen und Privatnutzer gibt es keinen Termin. Mit Argon weiterbauen und die Model-ID konfigurierbar halten.
Wie lautet die Model-ID von Gemini 4 Carbon?
Google hat noch keine veröffentlicht. Nicht davon ausgehen, dass gemini-4-carbon funktioniert. Nur eine Kennung verwenden, die der Anbieter ausdrücklich zusammen mit Endpunkt, Berechtigungen und Preisen dokumentiert.
Wie viel kostet Gemini 4 Carbon?
In der Einführungsphase kostet eine Million Input-Tokens 2 $ und eine Million Output-Tokens 10 $. Gecachte Eingaben sind 95 % günstiger (~0,10 $). Später liegen die Standardpreise bei 4 $ für Input und 20 $ für Output (~0,20 $ für gecachte Eingaben). Wie lange die Einführungsphase dauert, ist nicht angegeben.
Wie unterscheidet sich Carbon von Argon?
Google behauptet eine Steigerung bei sicherer Codegenerierung um mehr als das Zweifache, 26 % weniger Overreach, 29 % weniger Under-Service sowie 0,0 % statt 0,7 % erfolgreiche Prompt-Injection-Angriffe. Unabhängige Vals-Daten gibt es bislang nur für Carbon. Die Argon-Differenzen sollten daher als interne Herstellerwerte gelten, bis neutrale Wiederholungstests vorliegen.
Ist Carbon besser als Claude Opus 5.5 oder GPT-6.1 Terra?
Ein direkter Vergleich ist nicht belegt. Ein Eindruck eines Mitarbeiters vor dem Start, über GetAICodingAgent veröffentlicht, beschrieb Carbon beim Coding als ähnlich wie Opus 5.5. Im Vals-Gesamtranking liegt Carbon mit 70,36 % knapp vor Opus 5.5 mit 70,18 %, aber hinter Sonnet 5.5 mit 70,85 %. Ein kontrollierter Vergleich zwischen Carbon und Terra wurde nicht veröffentlicht.
Wann kommt die allgemeine Verfügbarkeit?
Google will Carbon nach den Phasen für Verteidiger und Partner so bald wie möglich allgemein freigeben, nennt aber keinen Termin. Maßgeblich sind der offizielle DeepMind-Blog und der Modellkatalog des jeweiligen Anbieters – nicht Leak-Diskussionen.