 AIREITER
Ein Café-Menü mit vier Preisen klingt nach einer einfachen Aufgabe – bis das Modell einen davon verändert. MOSS Image gibt solche Texte erstaunlich zuverlässig wieder, gemessen an seiner Größe. Dafür muss man dem Modell Struktur liefern und die Ergebnisse anschließend wie ein Designer sorgfältig prüfen.
Genau diesen Kompromiss habe ich in diesem Test untersucht: ein Text-zu-Bild-Modell mit Apache-2.0-Lizenz und 5B Parametern, das Prompts mit bis zu 4.096 Tokens sowie optionale JSON-Bounding-Boxen für Texte und Objekte akzeptiert. Das OpenMOSS-Team hat es am 16. Oktober 2026 mit Base- und SFT-Checkpoints veröffentlicht; eine gehostete API auf der MOSI-Plattform folgte am 20. Oktober. Wer Poster, Menüs, Etiketten oder Infografiken mit exakt vorgegebenem Text erstellt, sollte MOSS Image ausprobieren. Für konsistente Figuren oder Fotobearbeitung bleibt ein geschlossenes Modell die bessere Wahl.
Der erste Eindruck: Texte bleiben erstaunlich oft korrekt, das Design nicht immer
MOSS Image überzeugt vor allem bei langen, exakt vorgegebenen Texten – nicht bei allgemeiner Ästhetik. Im hauseigenen LongLongTextBench erreicht das Modell laut Anbieter insgesamt 96,3 Mean-6 bei der Textabdeckung. Bei langen englischen Texten sind es 97,1, bei langen chinesischen 92,4. Grundlage sind 240 Aufgaben mit durchschnittlich etwa 1.340 Zeichen. Zum Vergleich: GPT Image 2 kommt auf 99,0, Nano Banana Pro auf 96,6. Die Zahlen stammen aus einem vom Anbieter selbst entwickelten und durchgeführten Benchmark – sie sind also eher eine zu überprüfende Herstellerangabe als ein Leistungsversprechen.
Die zweite relevante Kennzahl betrifft die Layouttreue. Der in diesem Test ausführlich behandelte technische Bericht nennt für den 7Bench-Test zur Befolgung von Box-Vorgaben 0,88 mIoU und 0,70 Layout AUC. Damit liegt MOSS Image ungefähr doppelt so hoch wie Ideogram 4 mit 0,44 und 0,20 und deutlich über GPT Image 2 mit 0,30 und 0,16. In der RealLayoutArena – 61 blind bewerteten Aufgaben aus den Bereichen Poster, Infografiken und UIs – erreicht das vollständige MOSS-System mit Prompt-Verbesserung 1.698,70 Elo. Es landet damit hinter GPT Image 2 mit 1.844,35. Der reine Backbone steht hingegen an erster Stelle, wenn alle Generatoren denselben verbesserten Prompt erhalten. Auch hier gilt: Die Ergebnisse stammen vom Anbieter und müssen noch unabhängig bestätigt werden.
Ein kleiner kontrollierter Vergleich macht den Unterschied greifbar. Das Team hinter mossimage.run hat MOSS Image SFT und FLUX.1 dev pro Prompt einmal auf derselben 1024x1024-Leinwand und mit denselben Seeds ausgeführt. Es wurde nichts aussortiert; auch Fehlschläge blieben im Datensatz. Die Latenz der gehosteten MOSI-Version habe ich für diesen Test nicht erneut gemessen. Die Tabelle fasst die ersten Ergebnisse des Teams über fal-Endpunkte zusammen, während ich die MOSI-API anhand der Dokumentation und ihres aktuellen kostenlosen Abrechnungszeitraums bewerte:
| Test | Vorgabe im Prompt | Erster Output von MOSS Image SFT | Erster Output von FLUX.1 dev |
|---|---|---|---|
| Café-Menü | MORNING MENU sowie Espresso 3.50, Flat White 4.20, Butter Croissant 3.80 und Avocado Toast 8.50 rechtsbündig | Alle vier Einträge und Preise wie vorgegeben | Layout klar, aber aus 3.80 wurde 3.60 |
| Honigetikett | WILDFLOWER HONEY, Raw & Unfiltered, Net Wt. 12 oz (340 g) entlang der Etikettkurve | Alle drei Zeilen wie vorgegeben | Überschrift und Gewicht korrekt, die mittlere Zeile wurde zu Raw & Unfilterelrd |
| Zweisprachiges Poster | 周末市集 / WEEKEND MARKET, Sat 10:00–18:00, Riverside Park, Free entry / 免费入场 | Chinesische und englische Angaben wie vorgegeben | Starke Komposition, aber unleserliches Chinesisch und 10.00–178.00 |
Für MOSS kamen 50 Schritte und CFG 3 zum Einsatz, für FLUX 28 Schritte und Guidance 3,5. Verwendet wurden fal-ai/moss-image und fal-ai/flux/dev. Drei Beispiele reichen nicht für einen Gesamtsieger, wie auch die Vergleichsseite festhält. Sie zeigen aber den entscheidenden Schwachpunkt: Ein überzeugend aussehendes Bild mit einem veränderten Preis oder einer falschen Uhrzeit ist problematischer als ein offensichtlich misslungenes Ergebnis.
„MOSS Image hat das strukturierte Layout und englische Texte für ein 5B-Modell gut umgesetzt. Nicht jedes kleine Detail war perfekt, aber der Workflow fühlte sich endlich kontrollierbar an.“ — @Olaemmy1200 in einem Video zum vollständigen Poster-Workflow
Was die API tatsächlich liefert: ein kleiner Generator mit großem Textverständnis
MOSS Image ist ein einschichtiger Diffusion Transformer mit 42 Layern, der von Grund auf trainiert wurde. Die 5B Parameter entfallen allein auf den Generator. Unterstützt wird er von einem eingefrorenen Qwen3.5-9B-Textencoder für die Prompt-Verarbeitung und einer FLUX.2-Small-Decoder-VAE für die Bildausgabe. Diese Aufteilung erklärt sowohl die Stärken als auch den Hardwarebedarf: Das gute Verständnis langer zweisprachiger Texte kommt vom 9B-Encoder und nicht vom 5B-Denoiser.
Der praktische Vorteil liegt im Kontextfenster. Natürliche Sprache, Tag-Sequenzen und JSON-Layout teilen sich bis zu 4.096 Tokens. Damit lässt sich jede Zeile eines Posters beschreiben, statt sie in einer kurzen Bildunterschrift zusammenzufassen. In der MOSI-Dokumentation wird das gehostete Limit als langer Text mit bis zu 4.000 Zeichen angegeben. Texterzeugung, Negativ-Prompts und Layout-Generierung werden unterstützt. Empfohlen sind Ausgaben im Bereich von 1–2 Megapixeln; die Auflösung lässt sich von 512x512 bis 2K skalieren und muss durch 16 teilbar sein.
Für das Ergebnis sind zwei Checkpoints entscheidend:
- MOSS-Image-SFT basiert auf Base und wurde anschließend per Supervised Fine-Tuning mit kuratierten Daten verfeinert. Das OpenMOSS-Team empfiehlt ihn für die direkte Bildgenerierung, da Textgruppen sauberer und Layouts aufgeräumter ausfallen. Die gehostete API verwendet standardmäßig
moss-image-sft-1.0; für reproduzierbare Ergebnisse gibt es den festgepinnten Snapshotmoss-image-sft-1.0-2026-10-09. - MOSS-Image-Base verzichtet auf Post-Training und CFG-Destillation, um das ursprüngliche Trainingssignal zu erhalten. Der offizielle Leitfaden empfiehlt diesen Checkpoint für Fine-Tuning und rät dazu, den Textencoder einzufrieren. Base ist die richtige Wahl für ein LoRA-Training oder eine andere Stil-Verteilung – nicht, wenn heute noch ein fertiges Poster entstehen soll.
Sowohl die Gewichte als auch der enthaltene Inferenzcode stehen laut Hugging-Face-Model-Card und offizieller Projektseite unter der Apache License 2.0. Kommerzielle Nutzung und Fine-Tuning sind damit erlaubt. Die Lizenz klärt allerdings nicht automatisch die Rechte an jeder Figur, jedem Logo oder jeder dargestellten Person in einer Kampagne. Für kommerzielle Projekte sollten Lizenzdatei und exakte Revision mitgeführt werden. Der Code liegt im OpenMOSS-GitHub-Repository.
Warum sich der Aufwand mit JSON-Layouts lohnt
Natürliche Sprache funktioniert weiterhin, doch für Designer ist die Layout-Syntax der eigentliche Grund, MOSS Image zu testen. Ein strukturierter Prompt beschreibt zunächst die gesamte Szene. Anschließend erhalten einzelne Text- oder Objektelemente eigene Beschreibungen und Boxen. Diese Boxen steuern die Generierung, sind aber weder Vektorebenen noch eine Garantie für pixelgenaue Platzierung.
Die Koordinatenkonvention sorgt beim ersten Versuch fast zwangsläufig für Verwirrung. Bei bbox_coord_space: "abs_centralized" und bbox_format: "yxyx" wird jede Box als [y_min, x_min, y_max, x_max] in Pixeln relativ zur Bildmitte angegeben. Bei einem 1024x1024-Bild reicht jede Achse von -512 bis +512. Herkömmliche Koordinaten mit Ursprung oben links oder ein Community-Layout im Bereich 0–1000 lassen sich nicht ohne Umrechnung in dieses Schema übernehmen.
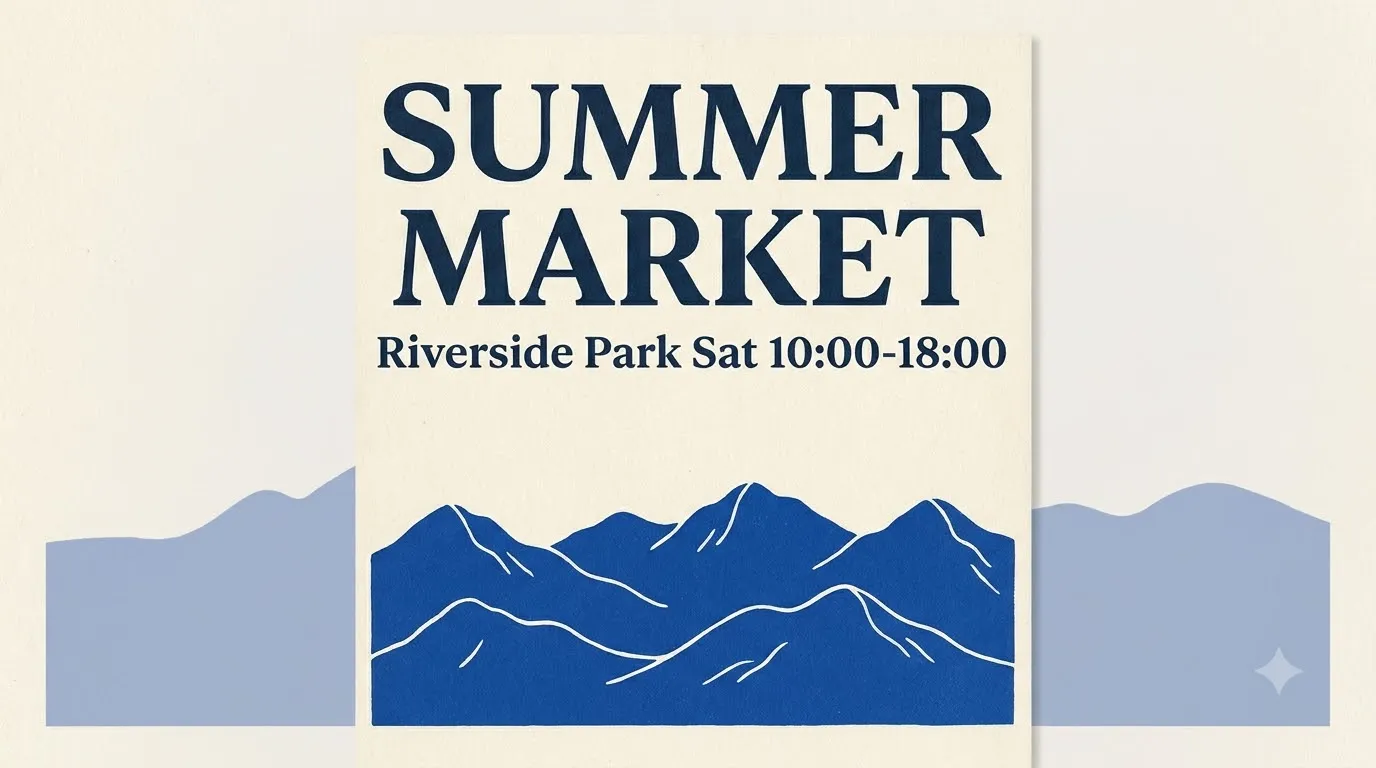
Ein minimales Beispiel – Überschrift oben, Illustration darunter – sieht so aus:
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Bei einer Infografik mit 20 Elementen schreibt niemand diese Boxen von Hand. Der bislang praktikabelste Workflow: Ein multimodales LLM erzeugt aus einem Briefing oder einer Skizze den JSON-Entwurf, anschließend werden die Koordinaten korrigiert. Der japanische Tester @chimolog7 brachte es auf den Punkt: Das BBox-Format sei für Menschen zu kompliziert, deshalb ließ er es von Opus erzeugen. Bei der Darstellung japanischer Texte stellte er anschließend kaum 1 % wahrgenommene Tippfehler fest, während Krea 2 weiterhin häufig Wörter falsch schrieb (Beitrag).
Der zweite wichtige Kniff ist die kontrollierte Neugenerierung. Da MOSS Image ausschließlich Text-zu-Bild beherrscht und keine Referenzbilder akzeptiert, kann man kein Foto per img2img übernehmen. Man kann jedoch den Text oder die Position einer einzelnen Box ändern, denselben Seed beibehalten und neu generieren. Das restliche Layout bleibt dabei weitgehend erhalten. User @li9292 demonstrierte das an einem Titelblatt für einen Wochenbericht mit Tausenden chinesischen Zeichen und 20 Boxen: Eine einzelne Box wurde bei identischem Seed geändert, während der übrige Aufbau stabil blieb (Beitrag). Für Arbeiten mit exakt vorgegebenem Text ist diese Schleife aus Einzelbox, gleichem Seed und erneuter Generierung wichtiger als jedes Stil-Preset.
Unser Test der besten Bildmodelle für Texterzeugung im Jahr 2026 liefert zusätzlichen Kontext und zeigt, warum eine Layout-first-Option in dieser Kategorie sinnvoll ist.
API-Aufruf und die tatsächlichen Kosten des Gratisangebots
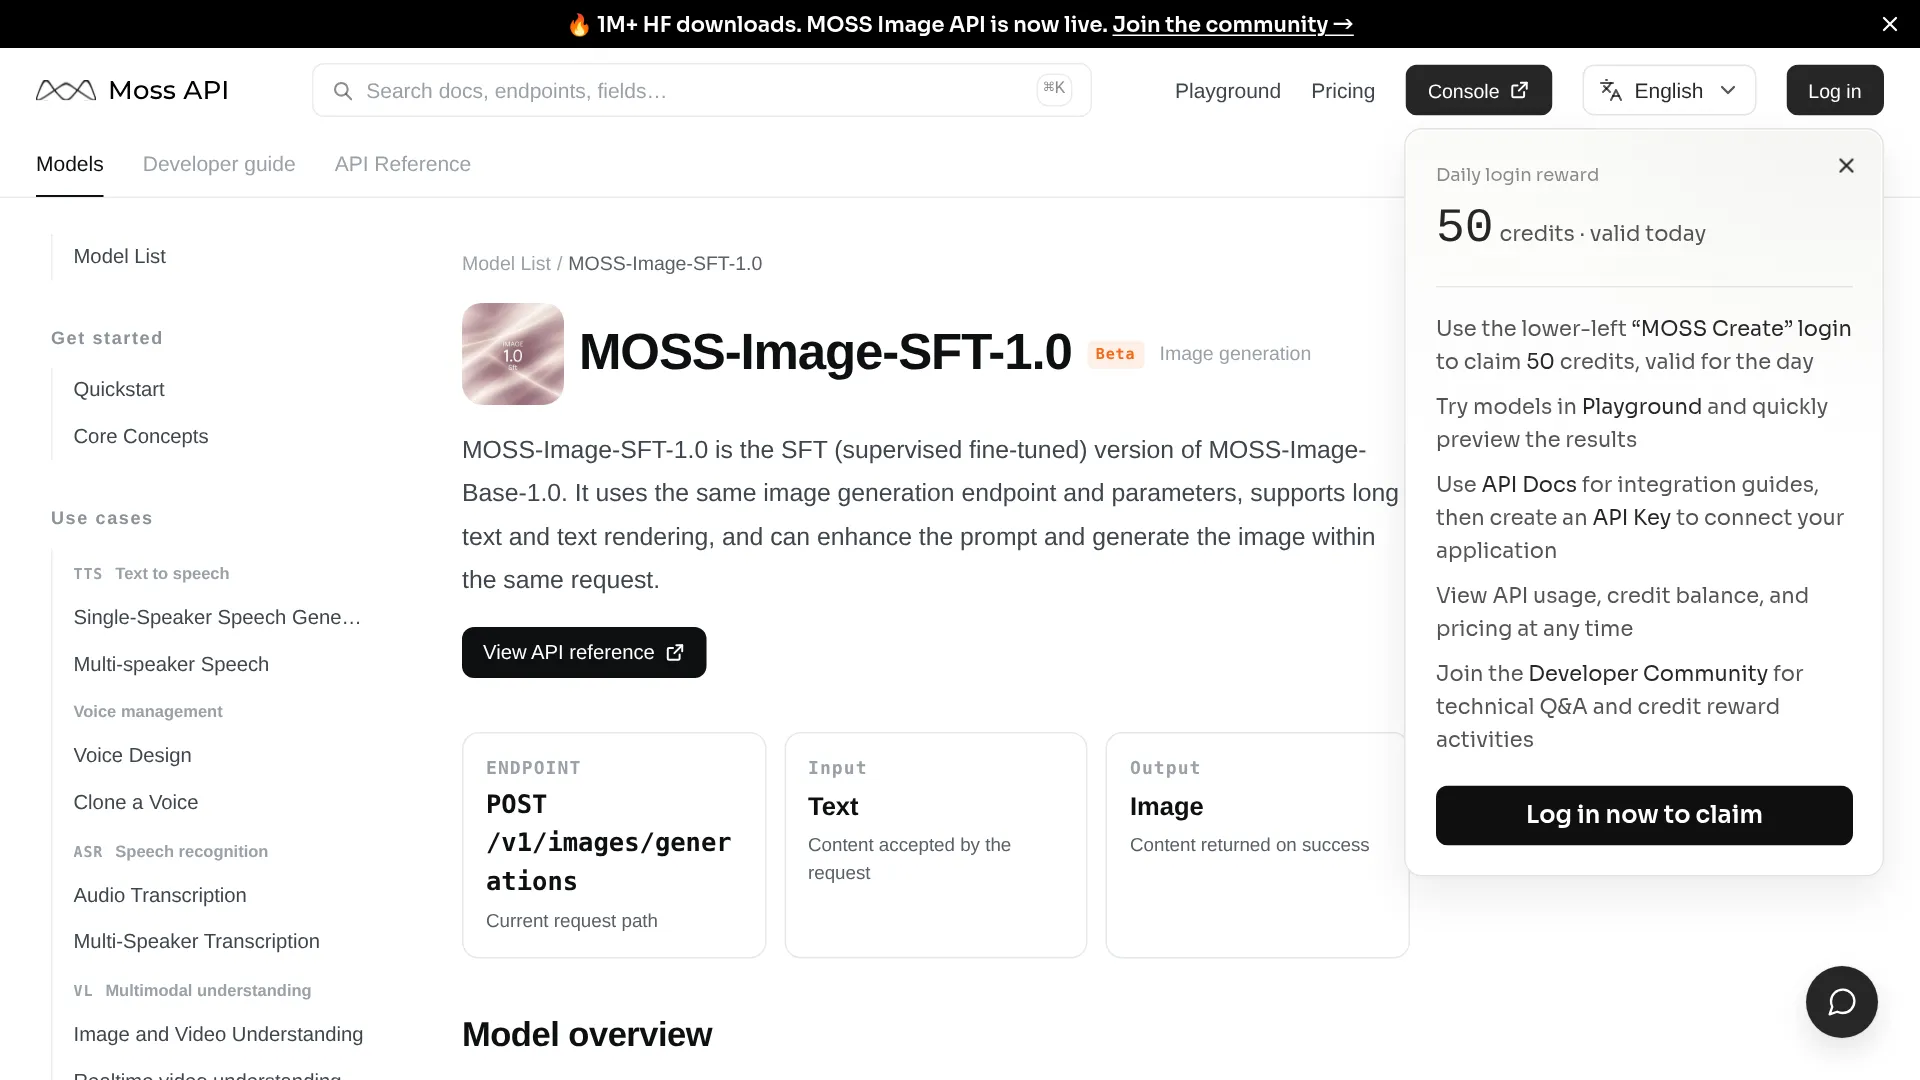
Der gehostete Zugang läuft über einen einzelnen Endpunkt. In der MOSI-API-Dokumentation ist für moss-image-sft-1.0 der Aufruf POST /v1/images/generations vorgesehen. Als Eingabe wird nur Text akzeptiert, als Ausgabe nur ein Bild: kein Bildinput, kein Audio oder Video, kein Streaming und keine asynchrone Task-API. Die Prompt-Verbesserung ist integriert, aber standardmäßig deaktiviert. Aktiviert wird sie mit prompt_enhance: true; die Version des Enhancers wird serverseitig gewählt.
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
Wenn einzelne Elemente exakt positioniert werden sollen, wird der vollständige JSON-Layout-String als prompt übergeben. Die kurze natürliche Sprachform aus dem Beispiel ist dagegen der einfachste direkt kopierbare API-Aufruf.
Zum Zeitpunkt der Prüfung wurde die Abrechnung mit Free for a limited time und 0 credits angegeben; für die Zeit danach verweist MOSI auf die vollständige Preisliste. Auch der Base-vs.-SFT-Leitfaden beschreibt diese Lücke: Das Playground-Angebot ist seit dem 20. Oktober live, ein dauerhafter Preis pro Bild wurde jedoch nicht veröffentlicht. Für die Planung heißt das: Das kostenlose Zeitfenster eignet sich zum Prototyping, danach müssen Anbieterpreise und die Zahl verworfener Ergebnisse einkalkuliert werden.
Lokale Inferenz verursacht zwar keine Kosten pro Bild, bringt aber eine deutliche Hardwarerechnung mit sich. Die am 20. Oktober geprüfte Comfy-Org-Dateiliste kommt vor Umgebung und Cache auf rund 29,72 GB BF16-Gewichte: etwa 10,16 GB für den Backbone, 19,31 GB für den Textencoder und 0,25 GB für die kleine VAE. INT8 ConvRot halbiert den Platzbedarf des Transformers ungefähr – Backbone etwa 5,41 GB, Encoder 9,75 GB. Für den Encoder gibt es außerdem eine W4A8-GPTQ-Variante mit rund 7,34 GB.
| Setup | Download | Praxis-Hinweis |
|---|---|---|
| Vollständiges BF16 | 29,72 GB Gewichte plus Arbeitsspeicher | Selbst mit 32 GB ohne Offloading knapp; System-RAM und Prompt-Länge spielen eine Rolle |
| INT8-quantisiert | Klasse um ~15 GB plus Offloading | Dokumentierter 12-GB-Weg bei etwa 1 MP, ein Bild pro Batch (Spitzenwert etwa 9,7 GB im hier zitierten Community-Test); für Karten mit 8–12 GB der sinnvollste Einstieg |
| Community-DMD mit 8 Schritten / 4 Schritte | Adapter plus passender Workflow | Etwa 24 Sekunden gegenüber etwa 137 Sekunden im selben 1-MP-Bericht mit RTX 3060, allerdings verloren frühe Adapter an Nuancen – zuerst die 50-Schritte-Basis etablieren |
Die offizielle Sampling-Baseline nutzt Euler, 50 Schritte, CFG 3,0, Shift 5,0 und Skip-Layer-Guidance auf Layer 22 bei 1024x1024. Die native ComfyUI-Unterstützung wurde am 16. Oktober zusammengeführt (Ankündigung). ComfyUI sollte aktualisiert werden; anschließend sucht man in den Vorlagen nach MOSS-Image und verwendet den passenden Base- oder SFT-Workflow mit den Comfy-Org-Dateien. Ein Plugin-Graph sollte nicht mit einem nativen Loader kombiniert werden.
Wer die Kosten verschiedener Anbieter vergleichen möchte, findet in unserer Übersicht zur günstigsten Bildgenerierungs-API einen brauchbaren Ausgangspunkt für die Rechnung aus GPU-Zeit und verworfenen Ergebnissen.
Wo geschlossene Modelle weiterhin überlegen sind
Die Grenzen des Systems sind klar dokumentiert und sollten berücksichtigt werden, bevor man ein Projekt darauf aufbaut. Die veröffentlichte Version kann ausschließlich Text-zu-Bild. Bildbearbeitung und Referenzbilder fehlen; referenzbasierte Generierung ist als zukünftige Funktion vorgesehen. Wer ein hochgeladenes Foto erhalten oder eine Figur über mehrere Aufnahmen hinweg identisch halten muss, greift besser zu einem auf Bearbeitung ausgelegten Modell wie Qwen Image 2.1 für die Produktion.
Menschen und Geschmacksfragen bilden die zweite große Lücke. Mit 5B Parametern wirken Gesichter teilweise beliebig, Proportionen verändern sich und Hände zeigen die bekannten Fehler.
„Auch mit Proportionen von Figuren kommt es nicht gut zurecht. Und bei den typischen Problemen mit Händen ist es ebenfalls nicht besonders stark.“ — @SlipperyGem
Die zitierten Praxistests sprechen dafür, vor der Veröffentlichung dieselbe Checkliste durchzugehen: Kurze Prompts, benannte Figuren, Künstler-Tags und exakte Vorgaben bleiben inkonsistent, kleine Schrift braucht eine manuelle Korrektur und Sprachen außerhalb des Englisch-/Chinesisch-Benchmarks müssen gesondert geprüft werden. Die offizielle Konfiguration mit 50 Schritten ist auf schwächerer Hardware schwergewichtig; schnelle Adapter tauschen Beleuchtungsnuancen und die Befolgung von Vorgaben gegen Tempo. Für jedes behaltene Ergebnis sollten Checkpoint, Encoder, VAE, Präzision, Prompt, Seed und die Zeit einschließlich Encoding dokumentiert werden.
Auch beim Blick auf die Hardware bestätigt sich dieses Bild. Lucebox maß auf einer Radeon AI PRO R9700 mit eigenen Kernels bei 8 Schritten und CFG 1 für 1024x1024-Bilder 2,7 Sekunden. Das war im End-to-End-Vergleich 1,8-mal schneller als ComfyUI auf einer DGX Spark bei denselben Einstellungen. Die eigene Sichtprüfung zeigte allerdings bei CFG 1 vier von acht deformierte Ergebnisse, bei CFG 2,5 dagegen nur eines von acht – dafür dauerte die Generierung 5,2 Sekunden. Schneller bedeutet also nicht automatisch besser nutzbar.
MOSS Image API: Häufige Fragen
Darf MOSS Image kommerziell genutzt werden?
Gewichte und enthaltener Code stehen unter Apache 2.0. Damit sind kommerzielle Nutzung und Fine-Tuning ohne Lizenzgebühr erlaubt. Gehostete Endpunkte legen ihre eigenen Preise und Inhaltsregeln fest; für Drittanbieter-Quantisierungen und LoRAs gelten jeweils deren eigene Bedingungen.
Base oder SFT – welchen Checkpoint sollte die API verwenden?
Die gehostete API verwendet SFT (moss-image-sft-1.0), also den vom Team für die Generierung empfohlenen, feinabgestimmten Checkpoint. Für Poster und Informationsgrafiken ist SFT die richtige Wahl. Base eignet sich für Fine-Tuning und das Training eines LoRA.
Läuft MOSS Image mit 12 GB VRAM?
Ein dokumentiertes 12-GB-Setup funktioniert mit einem quantisierten Workflow und CPU-Offloading bei etwa 1 MP sowie einem Bild pro Batch.
Kann MOSS Image Fotos bearbeiten oder eine Figur exakt beibehalten?
Nein. Der veröffentlichte Backbone verarbeitet keine Referenzbilder. Ein wiederverwendeter Seed mit verändertem JSON ermöglicht eine kontrollierte Neugenerierung, erhält aber weder ein hochgeladenes Foto noch garantiert er die Identität einer Figur.
Für wen sich MOSS Image als Nächstes lohnt
| Aufgabe | MOSS Image nutzen, wenn | Etwas anderes nutzen, wenn |
|---|---|---|
| Poster, Menü, Folie oder UI-Mockup mit exakt vorgegebenem Text | Lange zweisprachige Texte und die Platzierung per Box wichtiger sind als fotorealistische Menschen | Nur einzeilige Slogans gefragt sind – ein geschlossenes Modell lässt sich schneller prompten |
| E-Commerce- oder Redaktions-Pipeline | Ein LLM-zu-JSON-Schritt und eine Korrekturschleife möglich sind und Apache-2.0-Gewichte selbst gehostet oder feinabgestimmt werden sollen | Heute schon img2img, Inpainting oder referenzgesperrte Figuren benötigt werden |
| Lokaler Workflow mit begrenztem Budget | 12 GB plus Quantisierung ausreichen oder das kostenlose MOSI-Zeitfenster für den Prototyp genügt | Garantierter Durchsatz, Streaming oder asynchrone Tasks notwendig sind – die gehostete API bietet derzeit nichts davon |
Für textlastige Designs mit exakt beschreibbarem Layout ist MOSS Image eines der wenigen offenen Modelle, bei denen das Constraint-System selbst zum Produkt wird. Sobald jedoch ein Gesicht über mehrere Bilder hinweg dasselbe bleiben muss, sollte man MOSS Image als Typografie-Engine neben einem geschlossenen Bildmodell einsetzen – nicht als dessen Ersatz.