 AIREITER
Mit Gemini 3.7 Flash bringt Google am 13. August 2026 sein bislang stärkstes Flash-Modell für Coding-Agenten und mehrstufige Tool-Aufrufe an den Start. Besonders auffällig ist der DeepSWE-v1.1-Wert von 65.3 % – nach 49.0 % bei 3.6 Flash. Zum Einführungspreis kostet das Modell $0.75 pro Million Input-Token und $3.75 pro Million Output-Token, also exakt halb so viel wie 3.6 Flash zum regulären Tarif. Der Haken: Berichten zufolge verdoppeln sich die Preise im Januar 2027 auf $1.50/$7.50. Für eine Bewertung zum günstigeren Preis bleiben damit rund vier Monate.
API-Preise: Einführungstarif von $0.75/$3.75 gilt nur bis Ende 2026
Gemini 3.7 Flash startet laut Launch-Ankündigung von Google DeepMind, die durch Community-Berichte und indexierte Suchergebnisse bestätigt wurde, mit $0.75 je Million Input-Token und $3.75 je Million Output-Token. Zum Vergleich: Gemini 3.6 Flash kostet regulär $1.50/M Input und $7.50/M Output (AgentPedia). Der Einführungstarif von 3.7 Flash entspricht damit dem Batch/Flex-Preis von 3.6 Flash, gilt aber bei Standarddurchsatz.
In Community-Berichten findet sich ein entscheidendes Detail im Kleingedruckten: Der Einführungspreis läuft bis zum 31. Dezember 2026. Danach sollen $1.50/M Input und $7.50/M Output fällig werden. Ein Reddit-Nutzer wies darauf hin, dass „the displayed pricing fine print causes the price to double after four months“ (r/GeminiAI).
| Preisstufe | Input ($/M Token) | Output ($/M Token) | Hinweise |
|---|---|---|---|
| 3.7 Flash Einführungspreis (Aug.–Dez. 2026) | $0.75 | $3.75 | Aus der Community berichtet; Verdopplung im Jan. 2027 |
| 3.7 Flash Standard (ab Jan. 2027) | $1.50 | $7.50 | Entspricht dem regulären Preis von 3.6 Flash |
| 3.6 Flash Standard | $1.50 | $7.50 | Aktuelle GA-Preise |
| 3.6 Flash Batch/Flex | $0.75 | $3.75 | Tarif mit geringerem Durchsatz |
| 3.5 Flash-Lite Standard | $0.30 | $2.50 | Günstigste Gemini-Flash-Stufe |
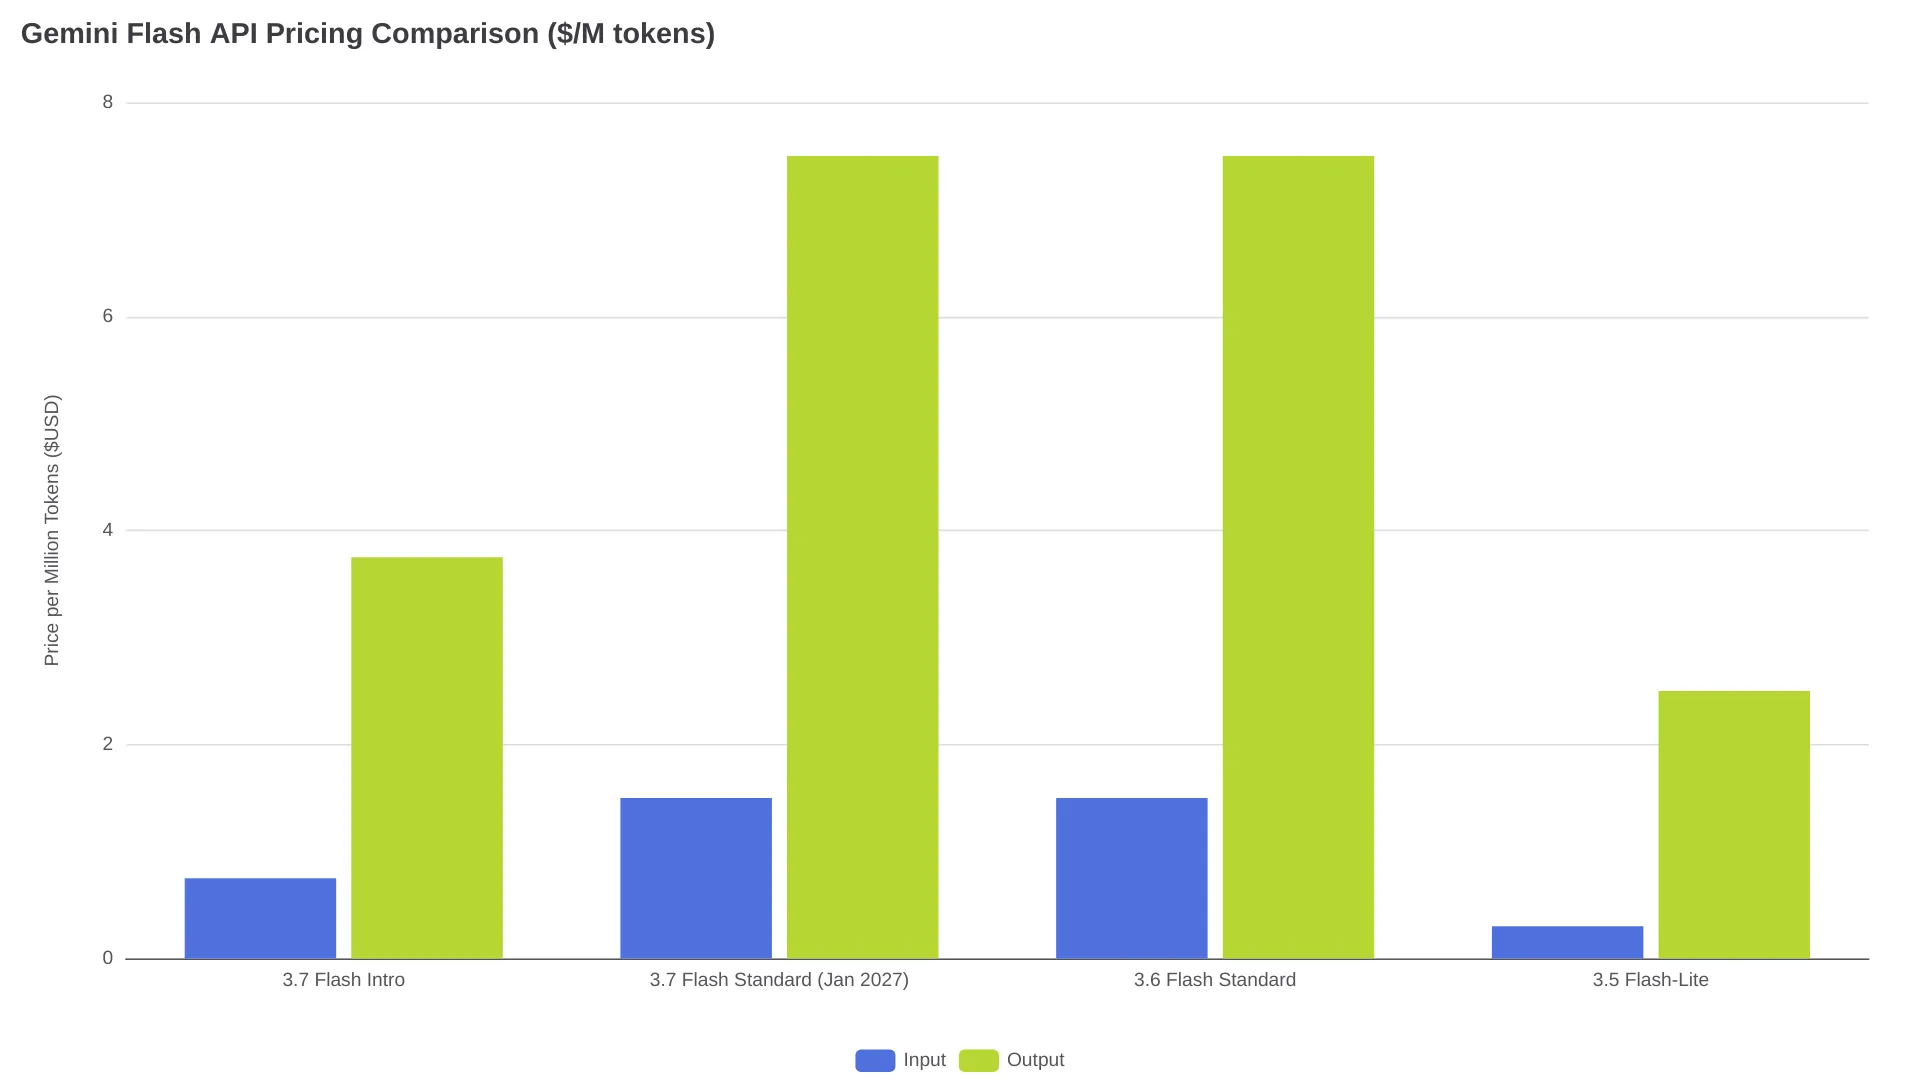
Thinking-Token werden über den Output-Preis abgerechnet. Context Caching kostet auf Basis der veröffentlichten 3.6-Flash-Preise laut AgentPedia zusätzlich $0.15/M Token im Standardtarif. Für Google Search Grounding und Maps Grounding fallen separate Gebühren an. Beim Kontext bleibt es beim 1M-Token-Fenster und maximal 64K Output-Token von 3.6 Flash; bestehende API-Aufrufe brechen daher nicht wegen geänderter Kontextlimits.
Benchmarks: Wo 3.7 Flash zulegt
Die von Google veröffentlichten Benchmarks zeigen die größten Fortschritte bei Software Engineering, Programmierung und Dokumentverarbeitung. Die folgenden Werte stammen aus Googles Launch-Ankündigung, die am 13. August 2026 über Community-Posts verbreitet wurde.
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Differenz |
|---|---|---|---|
| DeepSWE v1.1 | 65.3% | 49.0% | +16.3 Punkte |
| FrontierCode 1.1 Main | 43.6% | 34.4% | +9.2 Punkte |
| WebDev Arena (Elo) | 1,588 | 1,538 | +50 Elo |
| GDP.pdf Document Processing | 34.0% | 22.0% | +12.0 Punkte |
| AutomationBench | 30.4% | ~17% | +13 Punkte |
| Long-Context Retrieval | 97% | — | — |
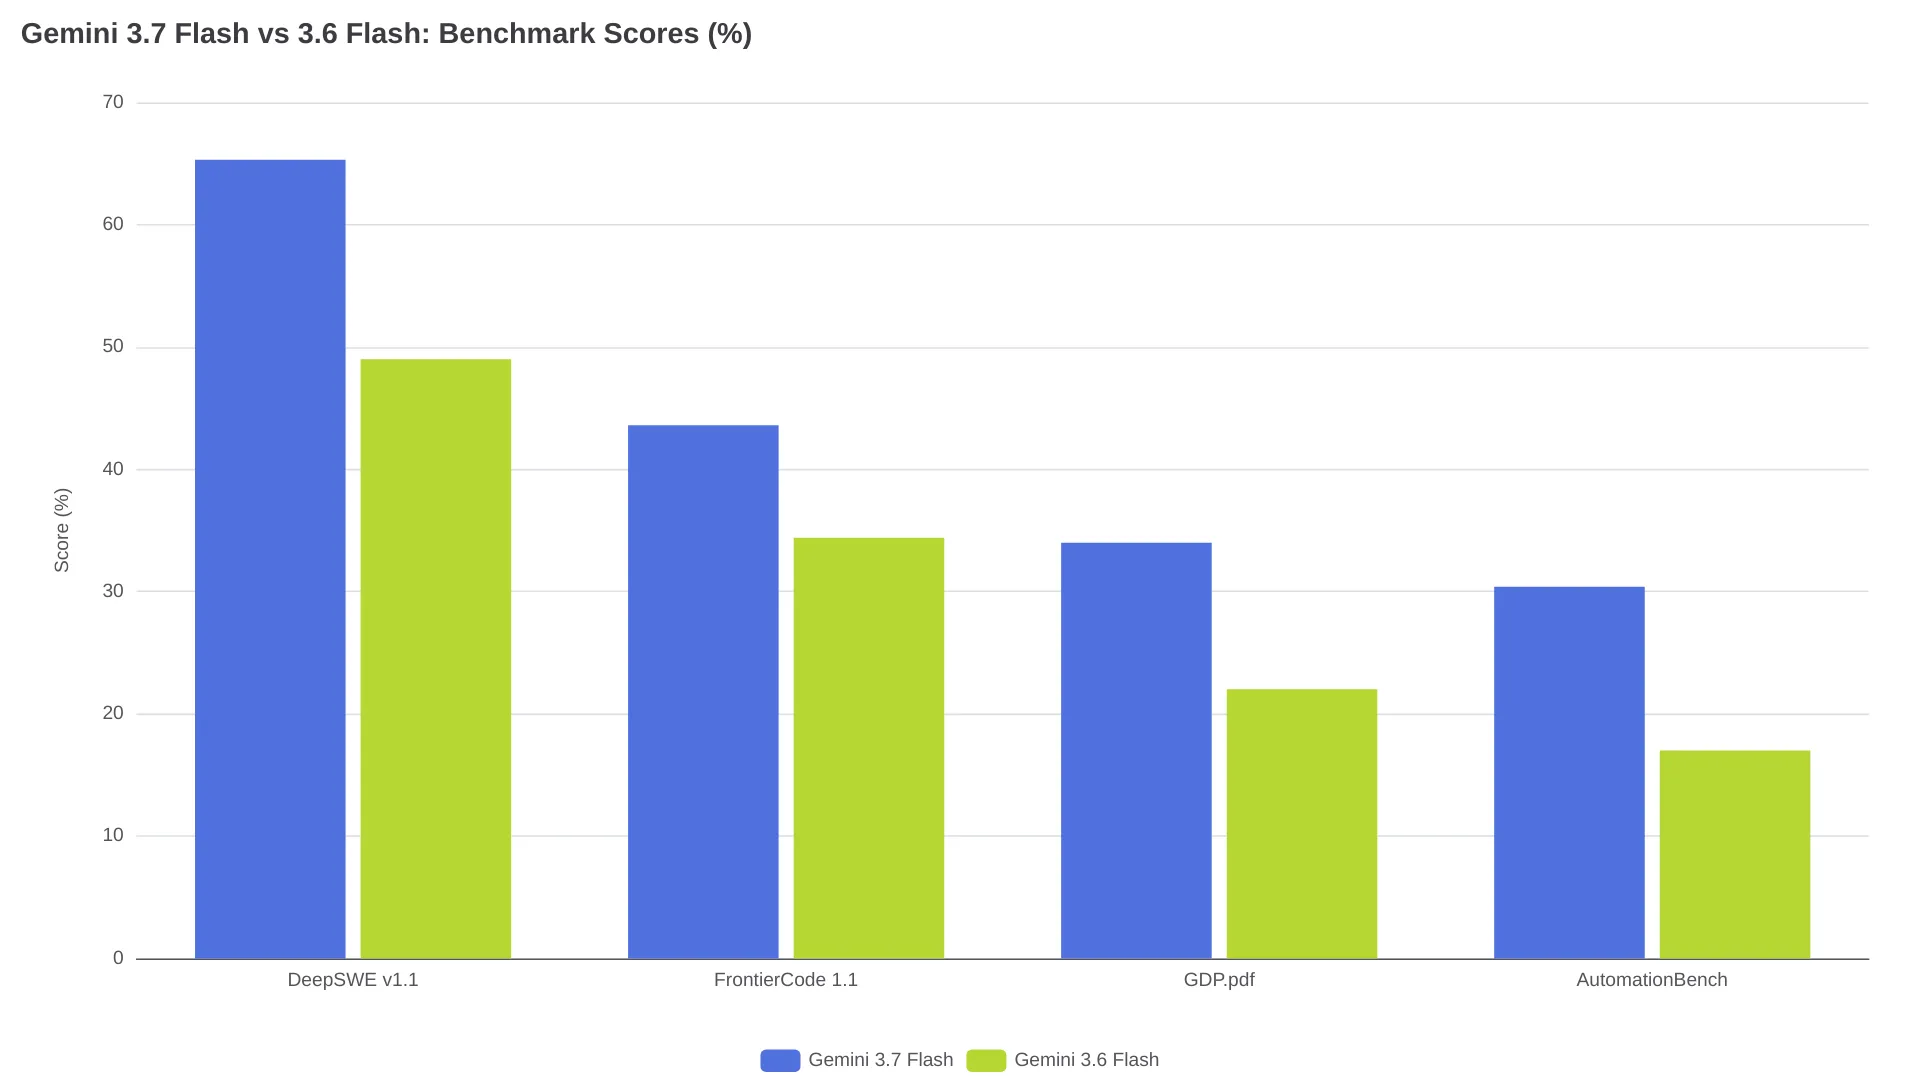
Das herausragende Ergebnis ist der Sprung bei DeepSWE von 49 % auf 65.3 % – ein relativer Zuwachs von 33 %. DeepSWE prüft Software Engineering auf Repository-Ebene: Änderungen über mehrere Dateien, Testausführung und Navigation im Codebestand. Ob die Werte in der Praxis standhalten, wird auf Reddit allerdings kontrovers diskutiert. Ein Nutzer schrieb: „Assume benchmaxxed until proven otherwise“ (r/GeminiAI). Andere merkten an, dass 3.6 Flash im Vergleich mit high Thinking lief, während einige Konkurrenzmodelle medium nutzten – was die Ergebnisse aufblähen kann. Der Long-Context-Retrieval-Wert von 97 % weckte dagegen echtes Interesse, insbesondere für Coding-Workflows, in denen relevanter Code in großen Codebasen gefunden werden muss.
Kosten im Vergleich zu Coding-Modellen der Konkurrenz
Auf Reddit verglichen frühe Nutzer das Preis-Leistungs-Verhältnis von 3.7 Flash direkt mit günstigeren Alternativen. Das Bild ist nicht eindeutig: 3.7 Flash erzielt gute Ergebnisse, kostet pro Aufgabe aber deutlich mehr als preiswerte Coding-Modelle.
Ein Kommentator im Benchmark-Thread schätzte anhand der Artificial-Analysis-Kosten pro Aufgabe, dass Gemini 3.7 Flash rund 8x mehr als GPT-5.6 Luna kostet – obwohl Luna bei den Benchmarks fast identische Werte erreiche. Ein weiterer Nutzer schrieb, Gemini 3.7 Flash sei früher etwa 13x teurer als DeepSeek V4 Flash gewesen, wobei DeepSeek seine Preise inzwischen angehoben habe. Derselbe Kommentator formulierte es unverblümt: Für „nearly the same“ Ergebnisse koste Gemini 3.7 Flash gegenüber Luna „more than 300% extra“ (r/GeminiAI).
Das Gegenargument: Luna halluziniert Berichten zufolge häufiger, und das Reasoning von DeepSeek V4 Flash „makes many mistakes“. Die Belege dafür sind allerdings anekdotisch.
Lob erhält 3.7 Flash vor allem für die Geschwindigkeit. Nutzer berichten von Antworten meist innerhalb von 3 bis 6 Sekunden. Die längste beobachtete Antwort – ein Test für kreatives Schreiben – dauerte rund eine Minute. Mehrere Kommentatoren bezeichneten das Modell als „blazingly fast“.
Technische Daten, Verfügbarkeit und API-Zugang
Nach Angaben aus Community-Diskussionen und der 3.6-Flash-Dokumentation übernimmt Gemini 3.7 Flash dieselben Kontextlimits und denselben Funktionsumfang wie 3.6 Flash.
| Spezifikation | Wert |
|---|---|
| Kontextfenster | 1,048,576 Token (1M) |
| Maximaler Output | 65,536 Token (64K) |
| Thinking-Stufen | Low, Medium, High |
| Modalitäten | Text, Bilder, Video, Audio, PDF (Input); Text (Output) |
| Knowledge Cutoff | März 2026 (3.6 Flash; Cutoff für 3.7 Flash unbestätigt) |
| Preis für gecachten Input | $0.15/M Token (Standard, von 3.6 Flash abgeleitet) |
Hier ist das Modell verfügbar:
- Gemini API / Google AI Studio — Zugang für Entwickler
- Gemini app — Rollout für Endnutzer
- Gemini Spark — verfügbar für Abonnenten von Google AI Pro und Google AI Ultra
- Vertex AI — soll voraussichtlich dem Verfügbarkeitsmuster von 3.6 Flash folgen
Die erwartete API-Modell-ID lautet, entsprechend Googles Namensschema bei 3.6 Flash, gemini-3.7-flash. Vor dem Deployment sollte der exakte String in der Google AI for Developers documentation geprüft und fest hinterlegt werden, statt sich auf Aliasse wie gemini-flash-latest zu verlassen.
Lohnt sich der Umstieg von 3.6 Flash?
Entscheidend sind der konkrete Workload und die Bedeutung der Preiserhöhung im Januar 2027 für das eigene Budget.
Umsteigen, wenn die Anwendung Coding-Agenten, mehrstufige Tool-Use-Ketten oder dokumentenintensive Verarbeitung nutzt. Der DeepSWE-Sprung von 49 % auf 65.3 % ist groß genug, um die Zahl erfolgreicher Agenten-Durchläufe beim ersten Versuch zu verändern. Gleichzeitig lässt sich zum halbierten Einführungspreis günstiger evaluieren. Teams, die bereits 3.6 Flash einsetzen, können die Modell-ID per Feature Flag austauschen, ohne Annahmen zum Kontextfenster neu schreiben zu müssen.
Abwarten, wenn es um Klassifizierung, Routing oder Extraktion mit hohem Volumen geht und Flash-Lite die Aufgabe bereits für $0.30/$2.50 erledigt. Der Input-Preis von 3.7 Flash liegt selbst im Einführungszeitraum noch beim 2.5-Fachen von Flash-Lite; die Verdopplung im Januar vergrößert diesen Abstand weiter.
Mit der Preisänderung kalkulieren. Ab Januar 2027 sollte das Budget mit $1.50/$7.50 rechnen, nicht mit dem aktuellen Einführungspreis. Wenn die Unit Economics nur bei $0.75/$3.75 aufgehen, wird das Modell in vier Monaten 2x teurer.
FAQ
Bleibt der Preis von $0.75/$3.75 für Gemini 3.7 Flash dauerhaft?
Nein. Community-Berichten zufolge handelt es sich um einen Einführungstarif, der bis zum 31. Dezember 2026 gilt. Ab Januar 2027 verdoppeln sich die Preise Berichten zufolge auf $1.50/M Input und $7.50/M Output – entsprechend den regulären Tarifen von 3.6 Flash.
Ist Gemini 3.7 Flash auf Vertex AI verfügbar?
Die Verfügbarkeit auf Vertex AI war zum Launch noch nicht unabhängig bestätigt. Gemini 3.6 Flash war bei GA über Vertex AI verfügbar, daher wird erwartet, dass 3.7 Flash diesem Muster folgt. Die aktuelle Modellliste lässt sich in der Google Cloud Console prüfen.
Wie schlägt sich 3.7 Flash gegen Gemini 3.1 Pro?
Reddit-Nutzer berichten, dass 3.7 Flash bei bestimmten Agenten- und Coding-Benchmarks mit Pro-Modellen mithalten oder sie übertreffen kann, insbesondere bei agentischer Dokumentenanalyse. Für reine Coding-Agent-Loops bietet 3.7 Flash zum Einführungspreis das bessere Preis-Leistungs-Verhältnis; für komplexes Reasoning und Planung bleibt Pro die stärkere Wahl.
Werden Thinking-Token separat abgerechnet?
Nein. Thinking-Token werden zum regulären Output-Preis als Output-Token berechnet ($3.75/M während des Einführungszeitraums). high Thinking erhöht die Output-Kosten entsprechend. Für Workloads mit hohem Volumen, bei denen zusätzliches Reasoning nicht nötig ist, eignen sich daher medium oder low.