 AIREITER
Gemini 3.5 Flash erzeugt 2,6-mal so viele Output-Token pro Sekunde wie Gemini 3.1 Pro, kostet pro Token 25% weniger und liegt auch im Intelligence Index von Artificial Analysis vorne (50 gegenüber 46). Dennoch hat Gemini 3.1 Pro bei ARC-AGI-2 mit 77,1% gegenüber 72,1% einen Vorsprung von 5 Punkten. Und sobald der Kontext 128k Token überschreitet, fällt Flash bei der Langkontext-Retrieval-Leistung von 84,9% auf 77,3% zurück. Welches Modell besser passt, entscheidet daher die Aufgabe: Flash ist auf Durchsatz und geringe Latenzen bei Tool-Aufrufen ausgelegt, Pro auf tiefes mehrstufiges Schlussfolgern. Zusammengefasste Benchmark-Werte verwischen diesen Unterschied oft in einer einzigen Zahl.
Benchmarks im Vergleich: Wo welches Modell vorne liegt
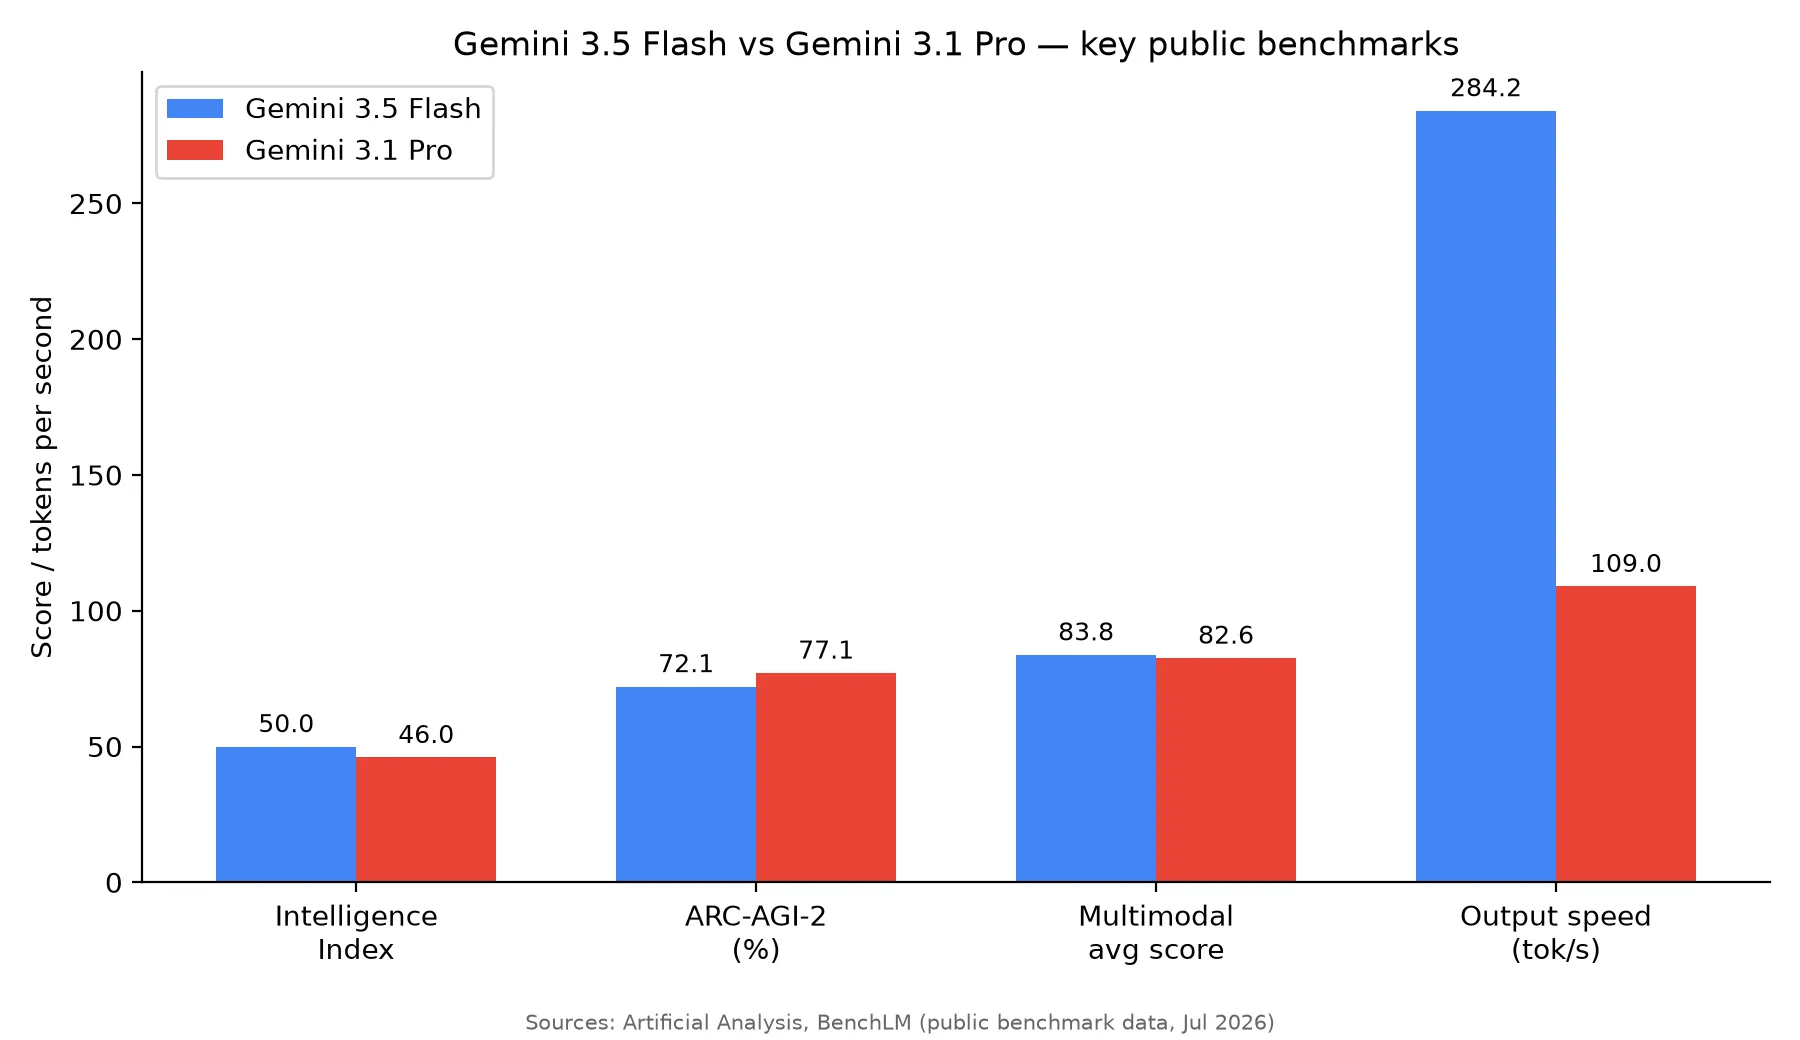
| Messwert | Gemini 3.5 Flash | Gemini 3.1 Pro | Sieger |
|---|---|---|---|
| Intelligence Index (Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2, abstraktes Schlussfolgern (BenchLM) | 72.1% | 77.1% | Pro |
| MRCR v2 bei 128k Kontext (nxcode) | 77.3% (gegenüber 84.9% bei kürzerem Kontext) | bei derselben Länge nicht öffentlich berichtet | Unzureichende Datenlage |
| Durchschnittlicher Multimodal-Score (BenchLM) | 83.8 | 82.6 | Flash |
| Output-Geschwindigkeit (BenchLM) | 284.2 tok/s | 109 tok/s | Flash (2.6x) |
| GDPval-AA Elo, Agent-Aufgaben aus der Praxis (apiyi) | 1656 | 1314 | Flash |
Bei Messwerten für Durchsatz und allgemeine Aufgabenbearbeitung liegt Flash vorn. Pro hat dagegen einen klar dokumentierten Vorsprung bei der Schlussfolgerungstiefe in ARC-AGI-2. Für Retrieval in langen Kontexten ist bei Flash zwar ein Einbruch jenseits von 128k Token belegt, ein vergleichbarer Pro-Wert ist jedoch nicht öffentlich verfügbar. Das Ergebnis bleibt also offen und ist kein dokumentierter Sieg für Pro. Für die Modellwahl ist diese Aufteilung nach Aufgabentyp ohnehin aussagekräftiger als ein einzelner aggregierter Wert wie der Intelligence Index.
Ein methodischer Vorbehalt aus BenchLMs eigenem Vergleich: Von rund 34 Benchmarks, für die beide Modelle veröffentlichte Ergebnisse haben, sind nur 3 Kategorien direkt vergleichbar. Pro weist exklusive Resultate bei 14 Benchmarks auf, Flash bei 17; zudem sind die Einstellungen für das Thinking-Budget nicht immer identisch. Die Tabelle zeigt daher verlässliche Tendenzen. Die Abstände bei ARC-AGI-2 und MRCR v2 sind groß genug, um ihnen Gewicht zu geben. Ein Unterschied von 1 bis 2 Punkten in einer gemeinsamen Metrik sollte dagegen nicht als entscheidend gelten.
Wo Flash an Grenzen stößt
Mit 5 Punkten ist der Abstand bei ARC-AGI-2 die größte Differenz in einer Einzelkategorie, die BenchLM zwischen beiden Modellen festgestellt hat. ARC-AGI-2 wurde gezielt so entwickelt, dass bloßes Wiedererkennen von Mustern nicht ausreicht. Deshalb ist ein Vorsprung von 5 Punkten dort ein stärkeres Signal für Schlussfolgerungstiefe als ein ähnlich großer Abstand in einem konventionelleren Benchmark. Das MRCR-v2-Ergebnis von nxcode liefert einen zweiten Hinweis in dieselbe Richtung: Die eigene Retrieval-Genauigkeit von Flash sinkt mit wachsendem Kontext bis zu 128k Token von 84,9% auf 77,3%. Für Pro gibt es bei derselben Länge keinen veröffentlichten Wert. Das ist also keine dokumentierte direkte Niederlage von Flash gegen Pro, aber eine nachgewiesene Schwäche von Flash, die in Pros Benchmark-Tabelle nicht sichtbar wird.
Anekdotischer Hinweis, kein Benchmark-Beleg: In einem Reddit-Thread in r/GeminiAI zur Frage, welches Modell Nutzer für schwierige Aufgaben bevorzugen, beschrieben Kommentierende Flash als besser als Pro „in allem außer Long Context und abstract reasoning“. Das sind einige wenige Meinungen, keine Daten. Interessant ist lediglich, dass sie genau die beiden Ausnahmen nennen, die auch in den Benchmarks auftauchen. Das ist ein schwacher Plausibilitätscheck, aber kein Beweis.
Preise und Caching: Was der Einsatz tatsächlich kostet
Die Basispreise relativieren den Preisvorteil auf den ersten Blick:
- Gemini 3.5 Flash: $1.50 / Million Input-Token, $9 / Million Output-Token
- Gemini 3.1 Pro: $2 / Million Input-Token, $12 / Million Output-Token
Auf dem Papier entspricht das einem Rabatt von 25%, nicht mehr dem 4- bis 8-fachen Abstand, den Flash gegenüber älteren Pro-Modellen hatte. Der größere Hebel liegt beim Caching:
- Cache Writes bei Flash sind kostenlos; gecachter Input kostet $0.15/Million Token
- Cache Writes bei Pro kosten $0.38/Million Token; gecachter Input kostet $0.50/Million Token – mehr als das Dreifache des Flash-Preises für gecachten Input
Bei Workflows, die über mehrere Turns hinweg denselben System-Prompt oder Dokumentkontext erneut senden – etwa Chat-Agenten, Coding-Assistenten mit dauerhaftem Codebase-Kontext oder mehrstufige Support-Bots –, summiert sich dieser Caching-Unterschied schnell. Bei einer einzelnen Anfrage fällt er kaum auf, in einer Agent-Session mit tausend Turns dagegen schon.
Der Abstand bleibt allerdings nicht konstant. Laut der Preisaufschlüsselung von apiyi schrumpft die Differenz zwischen beiden Modellen ab ungefähr 200k Kontext-Token auf 25-50%, weil sich die Token-Ökonomie beider Modelle in dieser Größenordnung annähert. Besteht ein Workload vor allem aus sehr langen Einzelanfragen statt aus kurzen wiederholten Aufrufen, wird das Preisargument für Flash schwächer.
Ein konkretes Beispiel: Ein Support-Bot sendet täglich 1M gecachte Input-Token und erzeugt 500K Output-Token. Bei Flash ergeben sich $0 für den Cache Write plus $0.15 x 1 (gecachter Input) + $9 x 0.5 (Output) = $4.65/Tag. Bei Pro kostet derselbe Workload $0.38 (Cache Write, einmalig) + $0.50 x 1 (gecachter Input) + $12 x 0.5 (Output) = am ersten Tag ungefähr $6.88 und nach dem ersten Write $6.50/Tag. Über einen Monat sind das etwa $140 gegenüber $195 – bevor berücksichtigt wird, ob Pros tieferes Schlussfolgern für einzelne Anfragen tatsächlich nötig ist.
Agent-Loops: Flash ist schneller, aber nicht immer die robustere Wahl
Der Agent-Loop-Benchmark von nxcode ließ beide Modelle einen Agent-Loop mit 8 Schritten ausführen. Flash benötigte für die vollständige Sequenz ungefähr 25 Sekunden, Pro 100 Sekunden – ein Faktor von 4, der sich mit jedem weiteren Schritt verstärkt. Auch bei GDPval-AA, einem Benchmark für wissensintensive Agent-Aufgaben aus der Praxis, liegt Flash mit einem Elo-Wert von 1656 deutlich vor Pro mit 1314. Die Differenz von 342 Punkten ist zugleich die größte im gesamten Benchmark-Tableau.
Der Vorbehalt: Dieser Vorsprung bei Tempo und Score setzt voraus, dass der Agent-Loop sauber durchläuft. Die Unterschiede bei ARC-AGI-2 und MRCR v2 liefern eine plausible Grundlage für die Erwartung, dass Flash auch weniger fehlertolerant reagiert, wenn ein Tool-Aufruf mitten im Loop unerwartete Ergebnisse zurückgibt und der Agent neu planen muss. Das ist eine Schlussfolgerung aus den oben genannten Daten zur Reasoning-Tiefe, keine separat benchmarkte Behauptung. Bei überwachten Agenten, deren Ergebnisse ein Mensch zwischen den Schritten prüft, ist der Geschwindigkeitsvorteil von Flash fast ein kostenloser Gewinn. Läuft ein Agent dagegen viele Schritte ohne menschliche Kontrolle, ist Pros Vorsprung beim Schlussfolgern die sicherere Wahl – zumindest bis für beide Modelle Daten zu Fehlerraten veröffentlicht werden.
Welches Modell für welche Aufgabe?
| Aufgabentyp | Empfohlenes Modell | Begründung |
|---|---|---|
| Alltägliche Coding-Aufgaben (Tests, PR-Review, Übersetzung zwischen Programmiersprachen) | Flash | Geschwindigkeit und Kosten sprechen für Flash; die Schlussfolgerungstiefe ist nicht der Engpass |
| Tiefe Refactorings, Entwicklung neuer Algorithmen | Pro | Der ARC-AGI-2-Abstand zeigt sich direkt bei mehrstufigem logischem Denken |
| Retrieval in langen Dokumenten (Verträge, Forschungskorpora über 128k Token) | Pro | Für Flash ist bei dieser Länge ein MRCR-v2-Rückgang dokumentiert; Pros Wert ist nicht veröffentlicht, aber ohne bekannte Schwachstelle ist es die sicherere Standardwahl |
| Batch-Generierung mit hohem Volumen | Flash | Kostenlose Cache Writes und 2,6x Durchsatz zählen im großen Maßstab am meisten |
| Überwachte Agent-Workflows mit menschlicher Ergebnisprüfung | Flash | Geschwindigkeitsvorteil ohne das Risiko unbeaufsichtigter Fehler |
| Unbeaufsichtigte Agent-Ketten mit hohem Risiko | Pro | Ohne Menschen, die Fehler mitten im Loop abfangen, ist der Vorsprung bei der Reasoning-Tiefe die sicherere Wahl |
| Häufige Multi-Turn-Aufrufe mit wiederverwendetem Kontext | Flash | Gecachter Input kostet ungefähr ein Drittel des Pro-Preises |
Als einfache Standardregel für die meisten Fälle gilt: Anfragen gehen an Flash, sofern nicht eine von drei Bedingungen erfüllt ist – der Kontext überschreitet 128k Token und Retrieval-Genauigkeit ist wichtig, die Aufgabe verlangt abstraktes oder mehrstufiges Schlussfolgern wie neue Algorithmen oder juristische beziehungsweise wissenschaftliche Synthese, oder der Agent läuft unbeaufsichtigt länger als nur einige Schritte. Trifft eine dieser Bedingungen zu, spricht das für Pro. Fehlt jede davon, machen Flashs Geschwindigkeit und Caching-Preise es zur günstigeren Standardoption.
FAQ
Ist Gemini 3.5 Flash besser als 3.1 Pro?
Bei Geschwindigkeit, Kosten und allgemeinen Benchmarks: ja. Beim abstrakten Schlussfolgern in ARC-AGI-2 liegt Gemini 3.1 Pro jedoch weiterhin um 5 Punkte vorn. Beim Retrieval in Langkontexten über 128k Token ist für Flash ein Rückgang dokumentiert, während ein entsprechender Pro-Wert nicht veröffentlicht wurde. Der Vergleich bleibt an dieser Stelle offen, statt einen bestätigten Sieg für Pro zu zeigen. Welches Modell „besser“ ist, hängt von der jeweiligen Aufgabenkategorie ab.
Wie viel günstiger ist Gemini 3.5 Flash als 3.1 Pro?
Bei den Basispreisen für Input und Output etwa 25% ($1.50/$9 gegenüber $2/$12 pro Million Token). Die größeren Einsparungen ergeben sich beim Caching: Cache Writes sind bei Flash kostenlos, und gecachter Input kostet ungefähr ein Drittel des Pro-Tarifs. Besonders relevant ist das für Multi-Turn- oder volumenstarke Workloads.
Eignet sich Gemini 3.5 Flash fürs Programmieren?
Ja, für alltägliche Arbeit wie Testgenerierung, PR-Reviews und die Übersetzung von Code zwischen Programmiersprachen. Bei tiefen Refactorings oder der Entwicklung neuer Algorithmen zeigt sich Pros Vorteil in Benchmarks für abstraktes Schlussfolgern tendenziell auch in der Ausgabequalität.
Kommt Gemini 3.5 Flash gut mit langen Kontexten zurecht?
Bei kürzeren Kontexten ja: Die Retrieval-Genauigkeit in MRCR v2 liegt bei 84.9%. Oberhalb von 128k Token sinkt sie auf 77.3%. Für Aufgaben wie die Prüfung mehrerer Vertragsdokumente ist das ein relevanter Unterschied. Der Wert von Gemini 3.1 Pro bei derselben Länge wurde nicht veröffentlicht. Es handelt sich daher um eine bekannte Einschränkung von Flash, nicht um einen bestätigten Vorteil von Pro.
Fazit
Für die meisten alltäglichen und volumenstarken Aufgaben ist Gemini 3.5 Flash die bessere Standardwahl: Es ist schneller, beim Cache günstiger und in allgemeinen Benchmarks nah genug an Pro, sodass der Kompromiss selten ins Gewicht fällt. Gemini 3.1 Pro rechtfertigt die höheren Kosten bei abstraktem Schlussfolgern und unbeaufsichtigten Agent-Ketten. Bei langen Dokumenten über 128k Token zeigen Flashs eigene Werte eine Schwachstelle, die Pros Werte weder bestätigen noch ausschließen. Wer sich darauf festlegen will, sollte beide Modelle deshalb selbst testen.
Dieser Vergleich basiert auf öffentlichen Benchmark-Daten von Artificial Analysis, BenchLM, nxcode und apiyi, nicht auf eigenen API-Tests. Gemini 3.1 Pro wurde mit einer klar auf Reasoning ausgerichteten Positionierung veröffentlicht, während Flash auf Geschwindigkeit fokussiert ist. Zum Zeitpunkt dieses Artikels ist Gemini 3.5 Pro noch nicht erschienen. Berichte deuten auf einen Release im Juli 2026 hin. Sobald die nächste Pro-Version verfügbar ist, sollten daher sowohl die Modelle als auch dieser Vergleich neu bewertet werden.