 AIREITER
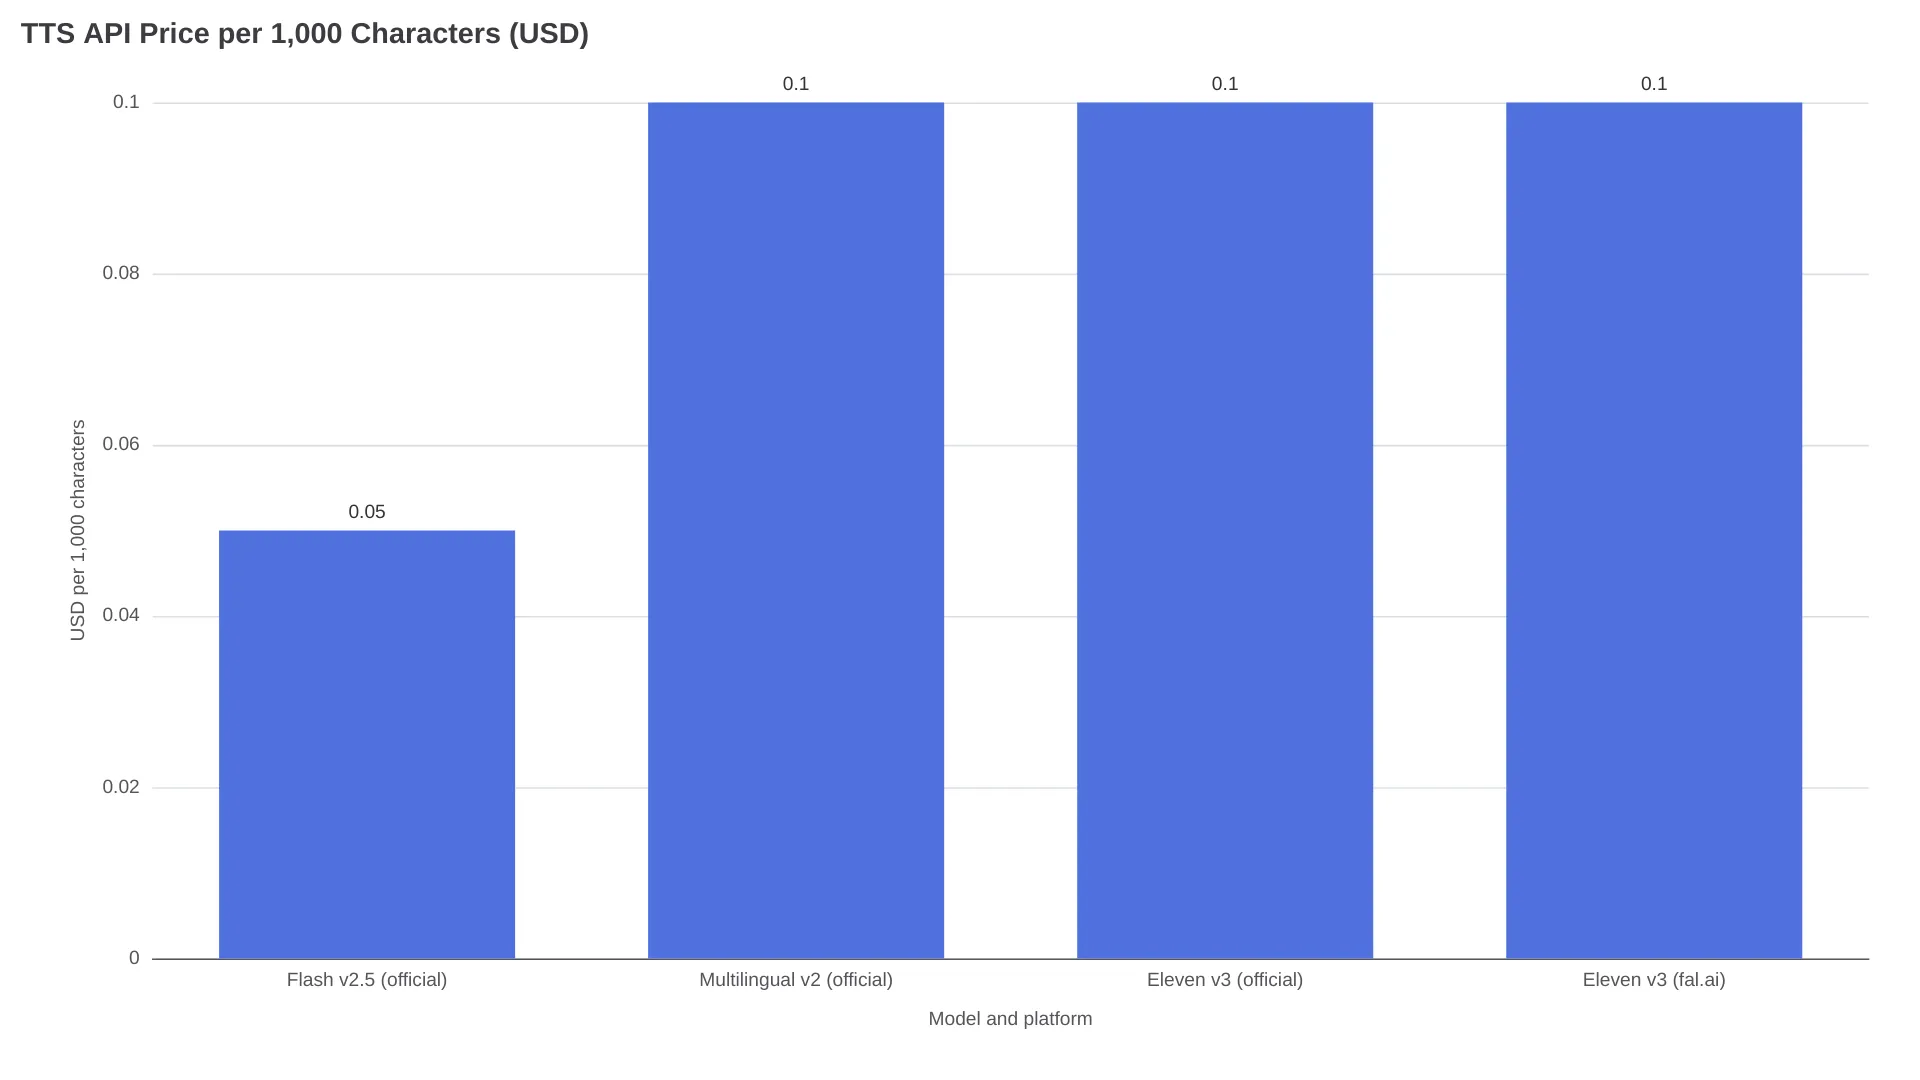
Seit dem 2. Februar 2026 ist Eleven v3 aus der Alpha-Phase heraus. In der ElevenLabs API spricht dein Code das Modell über die ID eleven_v3 an. Bei ElevenLabs und fal.ai kostet die Ausgabe jeweils $0.10 pro 1.000 Zeichen – der reine Stückpreis ist also kein Entscheidungskriterium. Wichtiger sind Abrechnung, Parallelität und der Zugriff auf Stimmen. Der GA-Release hat außerdem einige echte Schwachstellen beseitigt: Laut Ankündigung zur allgemeinen Verfügbarkeit sank die Fehlerquote bei strukturierten Texten in einem Benchmark mit 27 Kategorien und 8 Sprachen von 15.3% auf 4.9%. Für die Integration bleiben zwei harte Eckdaten: maximal 5.000 Zeichen pro Anfrage und ein Modell, das laut Hersteller weiterhin nicht für Echtzeitanwendungen geeignet ist.
Was die ElevenLabs-Eleven-v3-API kann
Die Eleven-v3-API bietet vier Schnittstellen: Sprache erzeugen, Sprache streamen sowie jeweils eigene Endpoints zum Erzeugen und Streamen von Dialogen mit mehreren Sprechern. Das Modell unterstützt mehr als 70 Sprachen und versteht direkt im Text platzierte Audio-Tags für Emotionen und Sprechweise. Seit dem GA-Release ist es zudem stabil genug, dass ElevenLabs es in den eigenen Tests 72% der Zeit gegenüber der Alpha-Version bevorzugte.
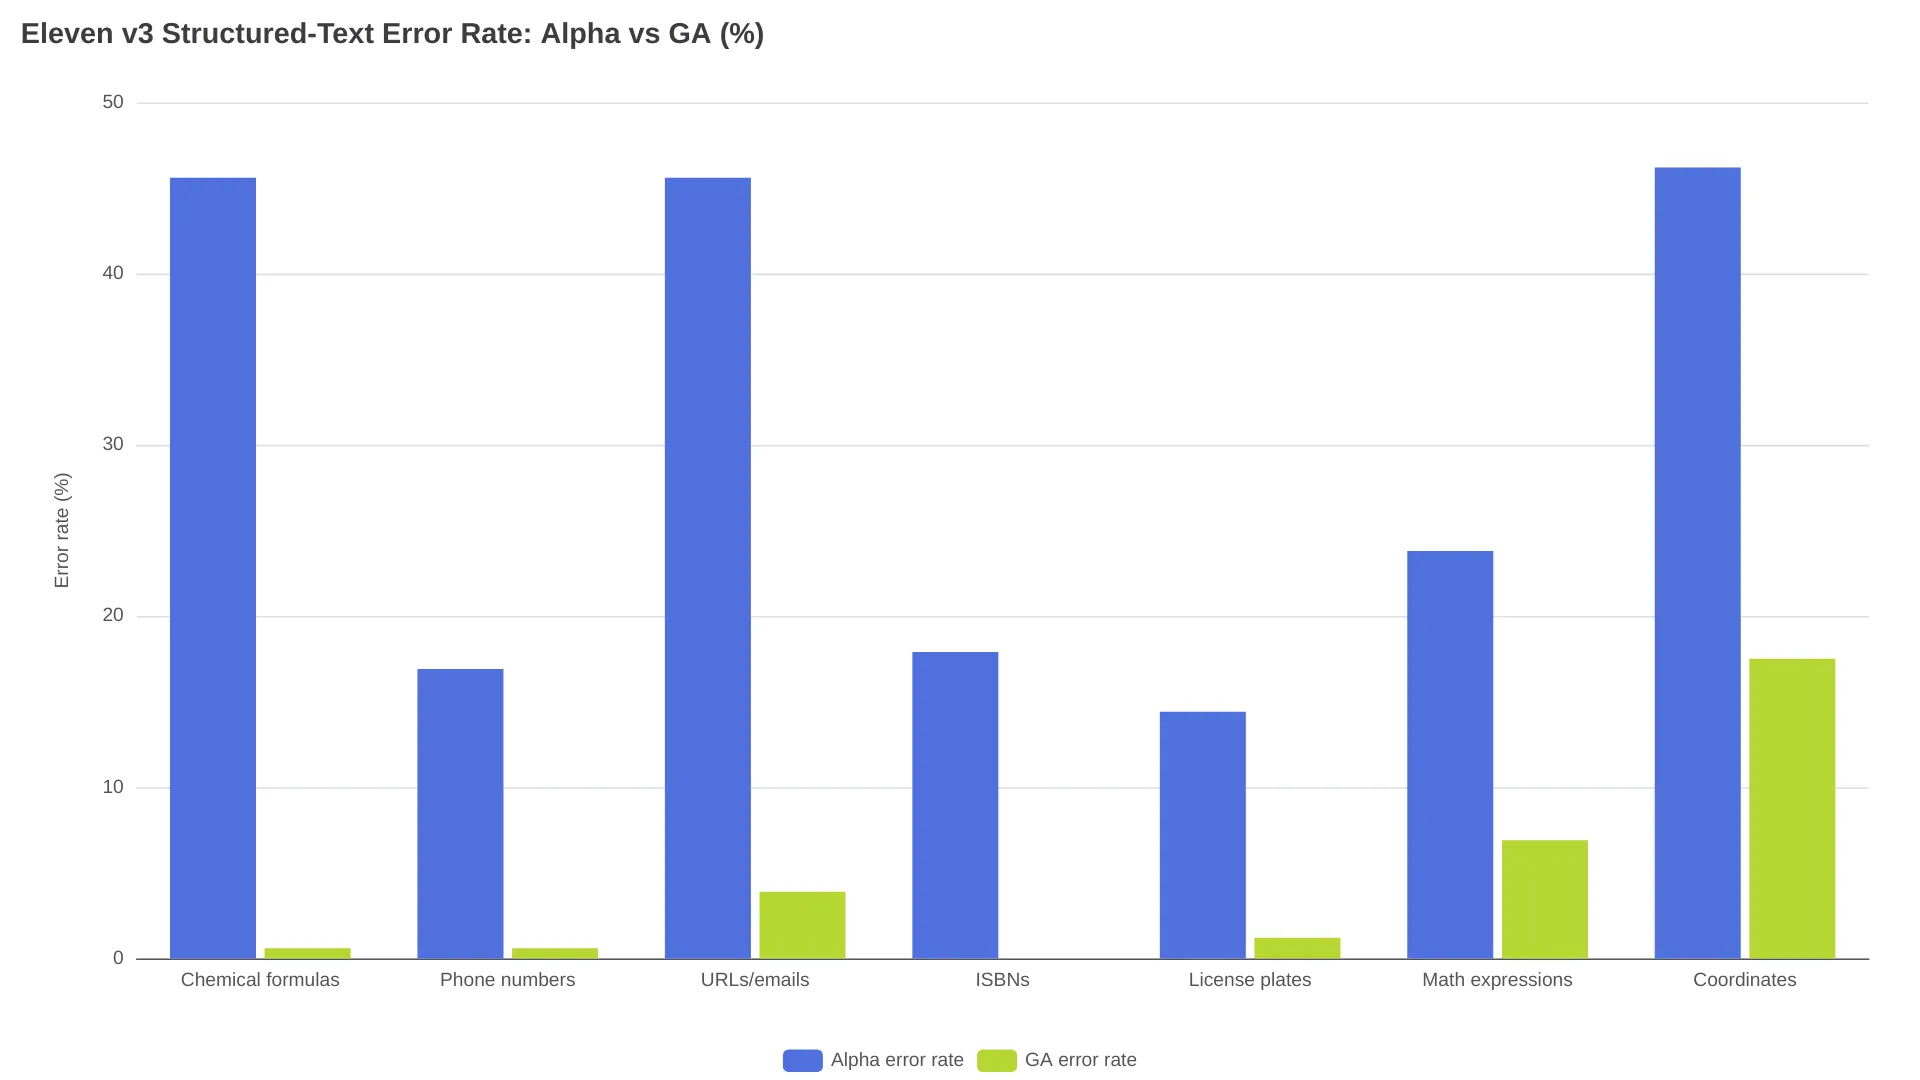
Wer v3 mit strukturierten Inhalten einsetzen will, sollte trotzdem einen Blick auf die einzelnen Benchmark-Kategorien werfen. Bei chemischen Formeln sank die Fehlerquote von 45.6% auf 0.6%, bei Telefonnummern von 16.9% auf 0.6%; ISBNs erreichten eine Fehlerquote von null. Geografische Koordinaten bleiben mit 17.5% problematisch, mathematische Ausdrücke liegen bei 6.9%. Für normale Sprachaufnahmen reicht das, bei koordinatenlastigen Inhalten ist Vorsicht angebracht.
In der folgenden Übersicht ist v3 neben den anderen Modellen von ElevenLabs eingeordnet – entsprechend der offiziellen Modellübersicht:
| Modell | Modell-ID | Sprachen | Max. Zeichen/Anfrage | Angegebene Latenz | Preis / 1.000 Zeichen |
|---|---|---|---|---|---|
| Eleven v3 | eleven_v3 | 70+ | 5,000 (~5 min) | ~250–300 ms (tier) | $0.10 |
| Eleven v3 Conversational | via Text-to-Dialogue WebSocket | 70+ | n/a | ~280 ms | $0.10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10,000 (~10 min) | ~250–300 ms | $0.10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40,000 (~40 min) | ~75 ms | $0.05 |
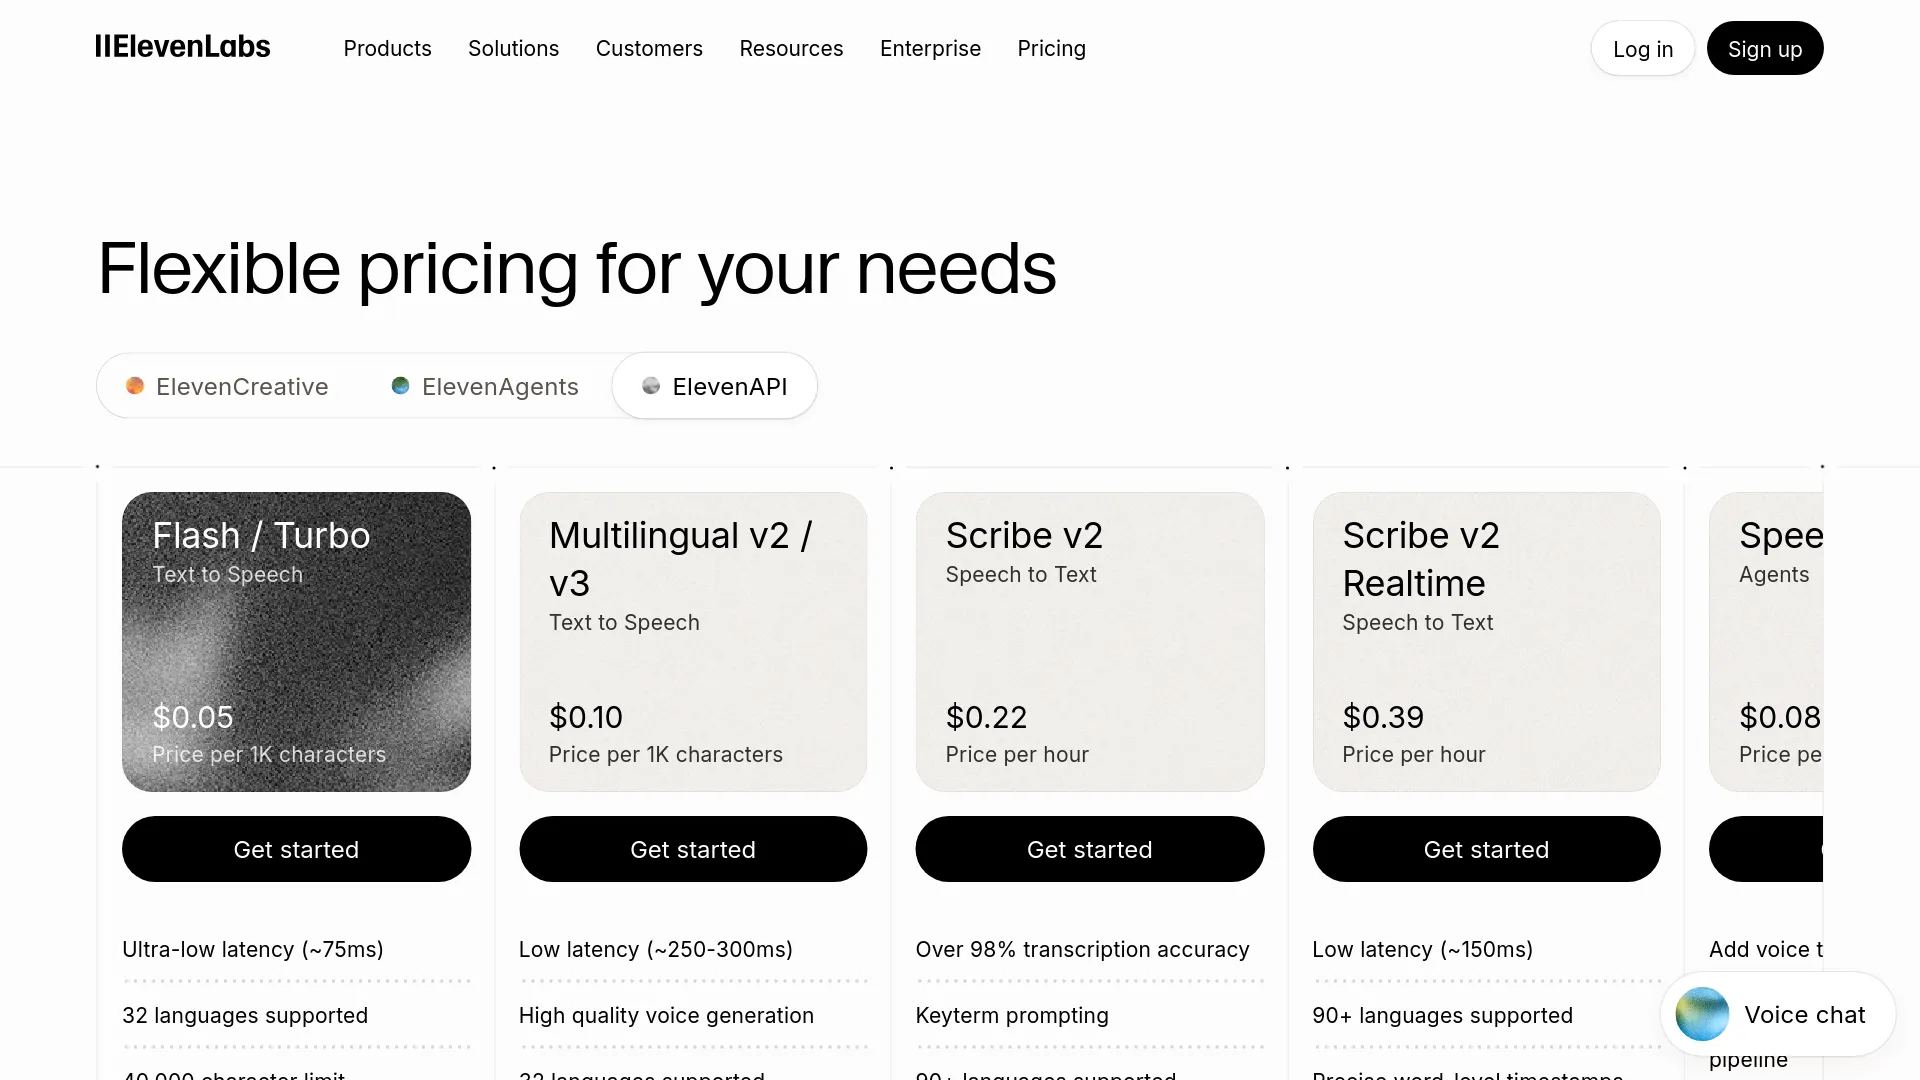
Eine wichtige Unstimmigkeit steckt in der Dokumentation: Auf der Preisseite werden „Multilingual v2/v3“ gemeinsam einer Stufe mit 40.000 Zeichen Limit zugeordnet. Die Modellübersicht nennt für Eleven v3 dagegen 5.000 Zeichen pro Anfrage. Für v3 solltest du mit 5.000 rechnen. Das ist der modellspezifische Wert – Long-Form-Pipelines, die pauschal von 40.000 Zeichen ausgehen, werden scheitern.
Preise im Vergleich: ElevenLabs direkt oder fal.ai?
Der Stückpreis liegt bei beiden Anbietern bei $0.10 pro 1.000 Zeichen. Nur Flash v2.5 ist innerhalb der Modellfamilie mit $0.05/1k günstiger. Die relevanten Unterschiede liegen bei Abrechnung und paralleler Verarbeitung:
| ElevenLabs direkt | fal.ai | |
|---|---|---|
| Stückpreis (Eleven v3) | $0.10 / 1k chars | $0.10 / 1k chars |
| Abrechnung | Abos mit enthaltenen Credits oder nutzungsbasierte Abrechnung | Reine nutzungsbasierte Abrechnung; „keine Sitzlizenzen, keine Abos, keine Mindestabnahme“ |
| Kostenloses Kontingent | 10k Multilingual chars/mo (20k Flash) | Auf der Modellseite nicht angegeben |
| Beispieltarif | Creator $22/mo (first month $11), 220k Multilingual chars | n/a |
| Höchster Tarif | Business $990/mo, 9.9M Multilingual chars | n/a |
| Parallelität | Planabhängig: 2 parallele Multilingual-Anfragen im Free-Tarif, 15–30 bei Scale/Business, individuell bei Enterprise | Serverless-Warteschlange; auf der Modellseite ist kein Kontolimit dokumentiert |
| Wartezeit-Aufschlag | Bei Überschreitung des Limits landen Anfragen in der Warteschlange und verursachen „typischerweise“ rund 50 ms zusätzlich | Queue-API mit Webhooks für Batch-Jobs |
| Optionen (dokumentiertes Schema sowie Nutzerberichte) | Stimme per ID; Stabilität (Nutzer berichten von 3 Positionen bei v3) | Voice, stability, similarity_boost, speed, language_code, apply_text_normalization, seed, timestamps, output_format |
| Startup-Programm | 12 Monate kostenlos, 33M Zeichen, höhere Parallelität | n/a |
Bei ElevenLabs ist die Parallelität an den Tarif gekoppelt. Ein kostenloser API-Key darf beispielsweise nur 2 v3-Anfragen gleichzeitig absetzen – für Batch-Verarbeitung ist das schnell ein Flaschenhals. fal.ai legt sämtliche Jobs in eine Serverless-Warteschlange und bietet Webhook-Callbacks, was genau für solche Batch-Szenarien gedacht ist. Keine der beiden Preisdokumentationen erklärt, ob Leerzeichen oder Audio-Tags in eckigen Klammern als kostenpflichtige Zeichen zählen. Für die Kalkulation solltest du deshalb davon ausgehen.
Wenn du v3 nur gelegentlich brauchst und andere Modelle ohnehin über fal betreibst, findest du die Argumente für diese Plattform in unserem fal.ai-Test.
Audio-Tags: Emotionen direkt im Text steuern
Audio-Tags sind Anweisungen in eckigen Klammern, die direkt im Text stehen. Das Modell spricht sie nicht mit, sondern interpretiert sie als Regieanweisung. Ein Minimalbeispiel von der fal-Modellseite:
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| Kategorie | Funktionierende Beispiele |
|---|---|
| Emotionen | [happy], [sad], [excited], [angry], [sarcastically], [nervous], [happily] |
| Sprechweise | [whispers], [shouting], [shouts], [slowly], [quickly], [softly] |
| Nichtsprachliche Geräusche | [laughs], [chuckles], [sighs], [gasps], [coughs], [gulps], [clears throat], [applause] |
| Akzente | [british accent], [southern accent], [strong canadian accent] |
Die offiziellen Prompting-Dokumente lassen sich dabei auf drei Regeln herunterbrechen: Es gibt keine verbindliche Liste erlaubter Tags. Die Tags sind natürlichsprachliche Regieanweisungen, und ElevenLabs weist selbst darauf hin, dass neben den veröffentlichten Beispielen wahrscheinlich weitere gut funktionierende Varianten existieren – Ausprobieren ist also wichtiger als Auswendiglernen. SSML-Break-Tags werden nicht unterstützt; für Pausen sorgen stattdessen Satzzeichen, Auslassungspunkte und Zeilenumbrüche. Außerdem hängt die Wirkung stark von Stimme und Kontext ab. Genau hier wird es in der Praxis unberechenbar:
„V3 is amazing, certainly the most human sounding“ – „it still feels like a Beta release to me“ – u/ConcertNeat8147, beide Aussagen aus demselben Beitrag, Praxisbericht zu v3 auf r/ElevenLabs
Im selben Thread berichtet u/poundingCode, ein Softwareentwickler mit zwei Jahrzehnten Berufserfahrung, dass emotionale Tags gelegentlich den Akzent der Stimme komplett verändern können. Ein Mitarbeiterkonto von ElevenLabs antwortete, „dass dies alles Dinge sind, an denen wir derzeit arbeiten“.
Die folgenden Workarounds stammen von Nutzern aus demselben Thread und sind Community-Erfahrungen, keine offiziellen Empfehlungen:
- Aufwärmsatz. Stelle einen belanglosen Satz voran, der Tonlage und Stimmung festlegt, und schneide ihn anschließend heraus. Stimmen stabilisieren sich oft erst wenige Sekunden nach Beginn einer Generierung.
- Angehängtes
end.. Setze nach deinem Text einen Zeilenumbruch und das Wort „end.“, damit die letzten Wörter nicht abgeschnitten werden. Entferne die Ergänzung danach aus der Audiodatei. - Sätze mit Auslassungspunkten beenden. Laut Erfahrungsberichten treten abgeschnittene Wortenden seltener auf, wenn ein Satz mit „...“ endet.
- Stabilität maximieren. Die Stabilitätssteuerung von v3 bietet drei Positionen. Die höchste Einstellung reduziert das Abdriften der Stimme am Anfang einer Generierung.
Limits, die deine Integration bestimmen
- Das Limit von 5.000 Zeichen ist der entscheidende Faktor. Eine Anfrage reicht für ungefähr 5 Minuten Audio. Hörbuch- und Long-Form-Pipelines müssen Texte daher in Abschnitte aufteilen – idealerweise an Satz- oder Absatzgrenzen, nicht mitten im Satz. Audio-Tags sollten in dem Abschnitt bleiben, den sie steuern. Multilingual v2 erlaubt 10.000 Zeichen, falls du größere und dafür weniger Anfragen bevorzugst.
- Die offizielle API koppelt Parallelität an den Tarif. Laut Modellübersicht schaffen kostenlose Keys 2 parallele Anfragen der Multilingual-Stufe (4 bei Flash). Scale und Business erlauben 15–30, Enterprise handelt individuelle Limits aus. Anfragen oberhalb des Limits landen in der Warteschlange, was „typischerweise“ etwa 50 ms kostet. ElevenLabs nennt außerdem eine eigene Kapazitätsfaustregel: Ein Parallelitätslimit von 5 unterstützt in einem dialogorientierten Szenario ungefähr 100 gleichzeitige Audioübertragungen. Pro Einzelanfrage ist der Aufschlag gering, bei großen Batches wird Unterdimensionierung jedoch schnell teuer.
- fal dokumentiert überhaupt keine maximale Eingabelänge. Die Eleven-v3-Seite nennt Endpoint, Parameter und Formate, schweigt aber zu Eingabelimit, Aufbewahrungsdauer in der Warteschlange und Wiederholungslogik. Lange Texte lassen sich also einreichen – garantiert ist damit noch nichts.
- Zeitstempel sind plattformabhängig. Das Eingabeschema von fal enthält den booleschen Parameter
timestampsund liefert bei Aktivierung eine Wort-für-Wort-Zuordnung, etwa für Untertitel oder Lippensynchronisation. Die offizielle v3-API liefert bei Dialogausgaben keine Zeitstempel. Entwickler haben diese Lücke öffentlich angesprochen (r/ElevenLabs: „v3 API, no timestamps?“). Für Alignment-Daten ist fal derzeit der dokumentierte Weg.
- Echtzeit ist weiterhin keine Option. ElevenLabs stuft v3 wegen der höheren Latenz und der schwankenden Konsistenz als ungeeignet für Echtzeit- und Dialoganwendungen ein. Vorgesehen sind Flash v2.5 mit etwa 75 ms für Agents oder Eleven v3 Conversational mit etwa 280 ms über WebSocket, wenn Ausdrucksstärke in einem interaktiven Szenario wichtiger ist. Eine Echtzeitvariante von v3 steht auf der Roadmap („we're working on a real-time version“), war zum Zeitpunkt der GA-Ankündigung aber noch nicht veröffentlicht.
- Kommerzielle Nutzung. Während der Alpha fragten Entwickler öffentlich, ob sich v3-Ausgaben kommerziell verwenden lassen. Mit der GA-Ankündigung wurde das Modell auf allen Plattformen geöffnet; fal kennzeichnet seinen Endpoint ausdrücklich als kommerziell nutzbar.
Die erste Anfrage: offizielles SDK und fal-Client
Der offizielle Weg aus dem Quickstart im Original:
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)Bei fal.ai kommt fal-client zusammen mit dem Endpoint fal.run zum Einsatz:
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URLBeide Plattformen warnen ausdrücklich davor, API-Keys in clientseitigem Code auszuliefern. Anfragen sollten deshalb über den eigenen Server laufen. Für Streaming bietet die offizielle API einen Stream-Speech-Endpoint; fal stellt fal.stream sowie eine Queue-API mit Webhooks für Batch-Jobs bereit.
Welchen Endpoint solltest du verwenden?
| Deine Situation | Verwende |
|---|---|
| Du brauchst eigene geklonte Stimmen (PVC/IVC) oder per ID entworfene Stimmen | Offiziell: Benutzerdefinierte Stimmen werden in deinem Workspace per ID referenziert; fal dokumentiert auf seiner Seite nur voreingestellte Sprachnamen |
| Du bezahlst bereits einen ElevenLabs-Tarif mit enthaltenen Credits | Offiziell: Die enthaltenen Zeichen sind ohnehin bezahlt, während jeder fal-Aufruf zusätzliche Kosten verursacht |
| Batch-Jobs für Hörbücher oder Synchronisation, ohne Abo und mit Webhooks nach Abschluss | fal: Die nutzungsbasierte Warteschlange und der Webhook-Ablauf sind genau auf diesen Fall zugeschnitten |
| Ein API-Key für Bild-, Video- und TTS-Modelle in einem gemeinsamen Stack | fal: v3 lässt sich über denselben Client wie deine übrigen fal-Modelle ansprechen |
| Sprach-Agents oder andere Anwendungen mit strengen Latenzanforderungen | Keiner der beiden v3-TTS-Endpoints: Nutze Flash v2.5 (~75 ms) oder Eleven v3 Conversational (~280 ms) |
| Enterprise-Anforderungen (SOC 2, HIPAA BAA, individuelle Rate Limits, IP-Allowlisting) | Offiziell: Die Preisseite nennt diese Funktionen für den Enterprise-Tarif; die fal-Modellseite macht keine Angaben dazu, welche Zertifizierungen für den Endpoint gelten |
FAQ
Wie lautet die Model-ID von Eleven v3?
eleven_v3. Sie wird bei den normalen Text-to-Speech-Endpoints als model_id übergeben. Dialoge mit mehreren Sprechern laufen über die separaten Text-to-Dialogue-Endpoints und nicht über einen Modellparameter.
Unterstützt die Eleven-v3-API Streaming?
Ja. Die offizielle API bietet einen Stream-Speech-Endpoint, der Audio während der Generierung ausliefert. Bei fal übernimmt fal.stream dieselbe Aufgabe für das Modell. Streaming macht v3 allerdings nicht automatisch echtzeittauglich. Laut offizieller Empfehlung sind für Dialoganwendungen weiterhin Flash v2.5 oder Eleven v3 Conversational vorgesehen.
Wie viele Zeichen darf eine Eleven-v3-Anfrage enthalten?
Pro Anfrage sind laut offizieller Modellübersicht 5.000 Zeichen erlaubt – ungefähr 5 Minuten Audio. Die Angabe von 40.000 Zeichen auf der Preisseite bezieht sich auf die Gruppierung der Multilingual-Stufe, nicht speziell auf v3.
Was kostet die Eleven-v3-API?
Auf beiden Wegen $0.10 pro 1.000 Zeichen: $1.00 für eine Geschichte mit 10.000 Zeichen und $100 für ein Hörbuch mit 1M Zeichen. Bei ElevenLabs können Tarif-Credits die Kosten abdecken; Creator kostet beispielsweise $22/mo und enthält 220k Multilingual-Zeichen. fal bietet kein Abo.
Kann ich mit Eleven v3 geklonte Stimmen verwenden?
Über die offizielle API: ja. Professionelle, geklonte und entworfene Stimmen werden per Voice-ID angesprochen. In der Praxis gibt es jedoch Unterschiede bei der Kompatibilität. Nutzer auf r/ElevenLabs berichten, dass bestehende Professional Voice Clones unter v3 teilweise wie andere Sprecher klingen. PVCs, deren Ersteller die V3-Kompatibilität angegeben haben, funktionieren tendenziell zuverlässiger. Fals Schema akzeptiert einen Stimmmennamen oder eine ID, dokumentiert aber nur voreingestellte Stimmen. Private ElevenLabs-Voice-IDs sind dort daher nicht offiziell abgesichert.
Eignet sich Eleven v3 für Sprach-Agents in Echtzeit?
Nein. ElevenLabs nennt Echtzeit- und Dialoganwendungen wegen höherer Latenz und schwankender Konsistenz ausdrücklich als ungeeignet für v3. Verwende stattdessen Flash v2.5 (~75 ms, 32 Sprachen) oder Eleven v3 Conversational (~280 ms, 70+ Sprachen, Steuerung per Audio-Tag).
Warum klingt Eleven v3 über die API anders als auf der Website?
Stimmvorschauen sind kein zuverlässiger Hinweis darauf, wie dein eigener Text klingt. Das wird in den Praxisberichten auf r/ElevenLabs immer wieder kritisiert. Außerdem kann die v3-Ausgabe zwischen einzelnen Generierungen deutlich variieren. Teste jede infrage kommende Stimme deshalb mit einem echten Ausschnitt deines Skripts und der Stabilitätseinstellung, die du später in der Produktion verwenden willst.
Weiterlesen: Qwen Audio 3 TTS API-Leitfaden · Replicate: Preise und Alternativen · fal.ai-Test 2026