 AIREITER
145 Milliarden Parameter auf einem Laptop und dabei 80 Token pro Sekunde: Das verspricht Edge0-145B. Die Gewichte lassen sich herunterladen, doch die praktischen Voraussetzungen sehen eher nach NVIDIA-Desktop mit CUDA 13 und rund 105 GB freiem SSD-Speicher aus.
Dieser Test stellt die Startversprechen von Edge0 den Angaben aus dem Ankündigungsbeitrag, der Modelldokumentation und der Q3_K-Modellkarte sowie ersten Community-Läufen gegenüber. So lässt sich vor dem Download besser entscheiden, ob der lokale Betrieb sinnvoll ist oder eine API die bessere Wahl bleibt.
Was am 12. November veröffentlicht wurde: Gewichte, Engine und Grenzen
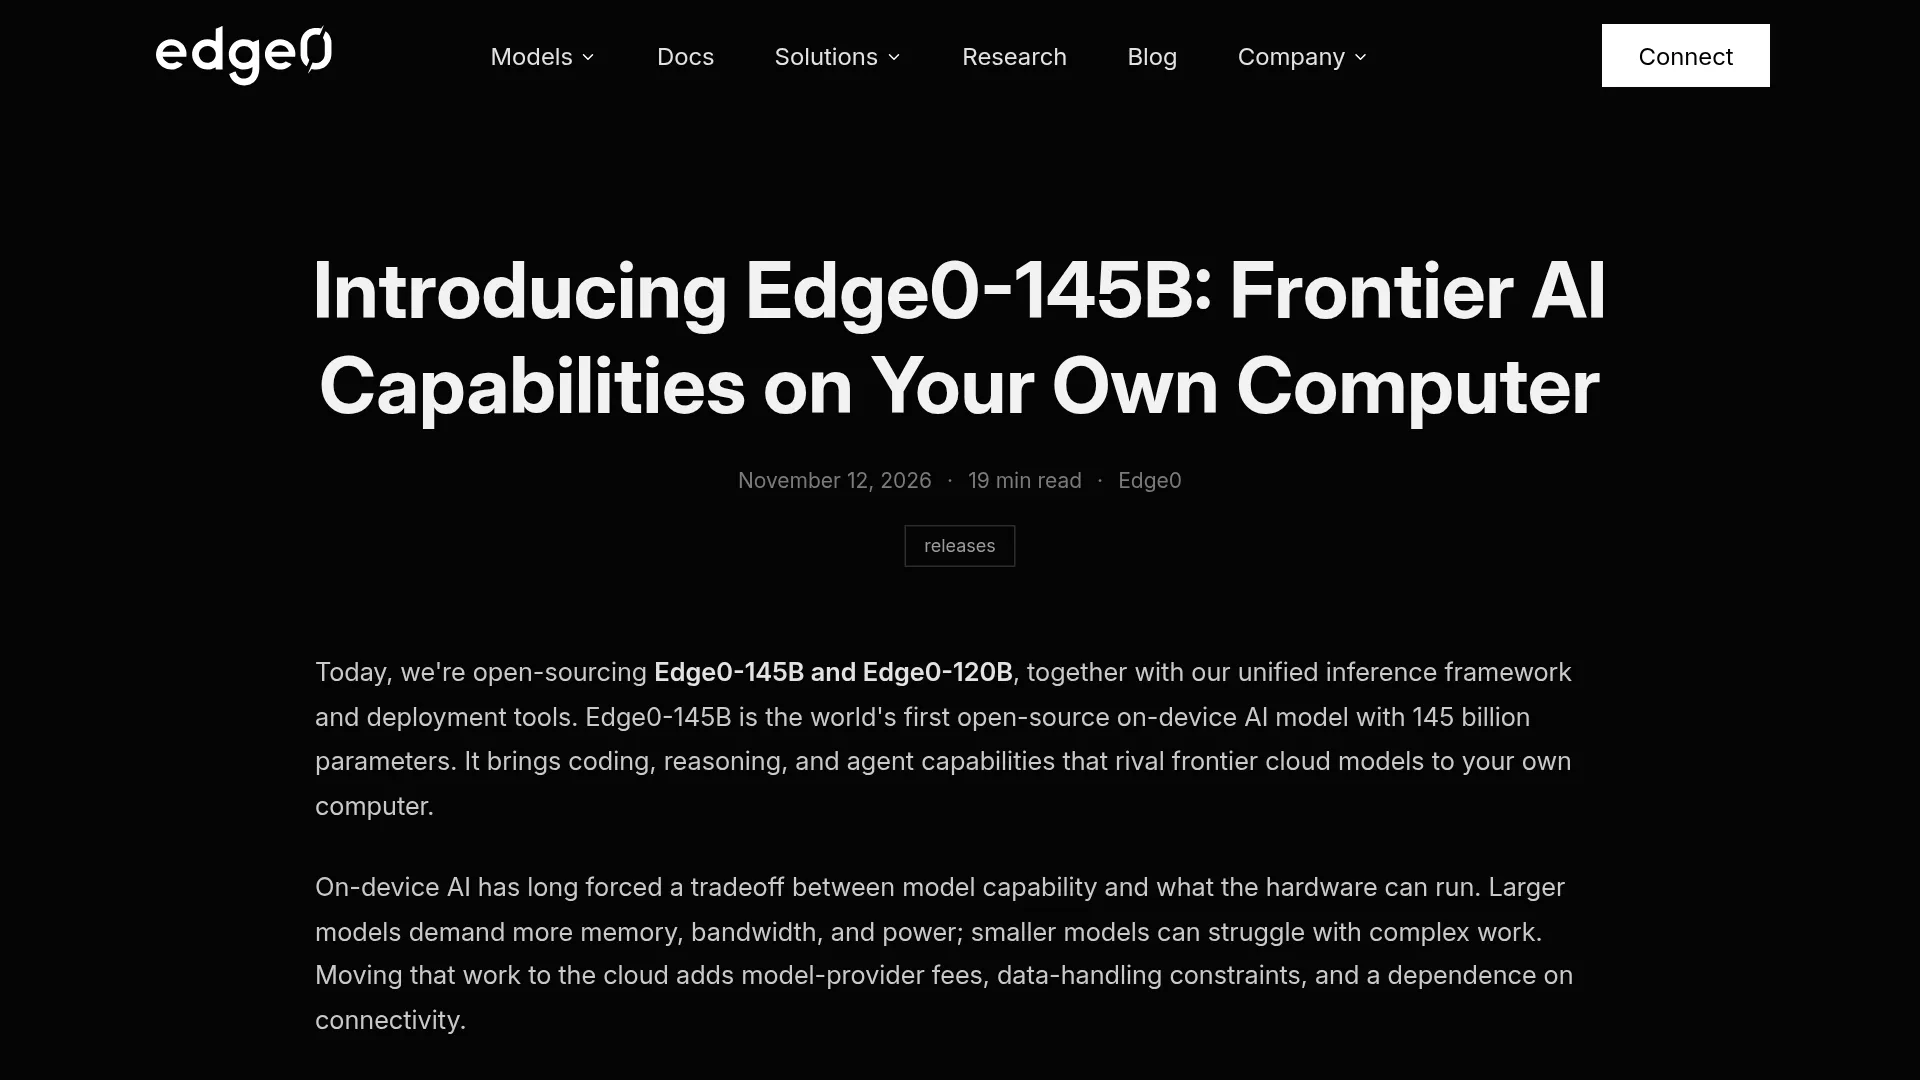
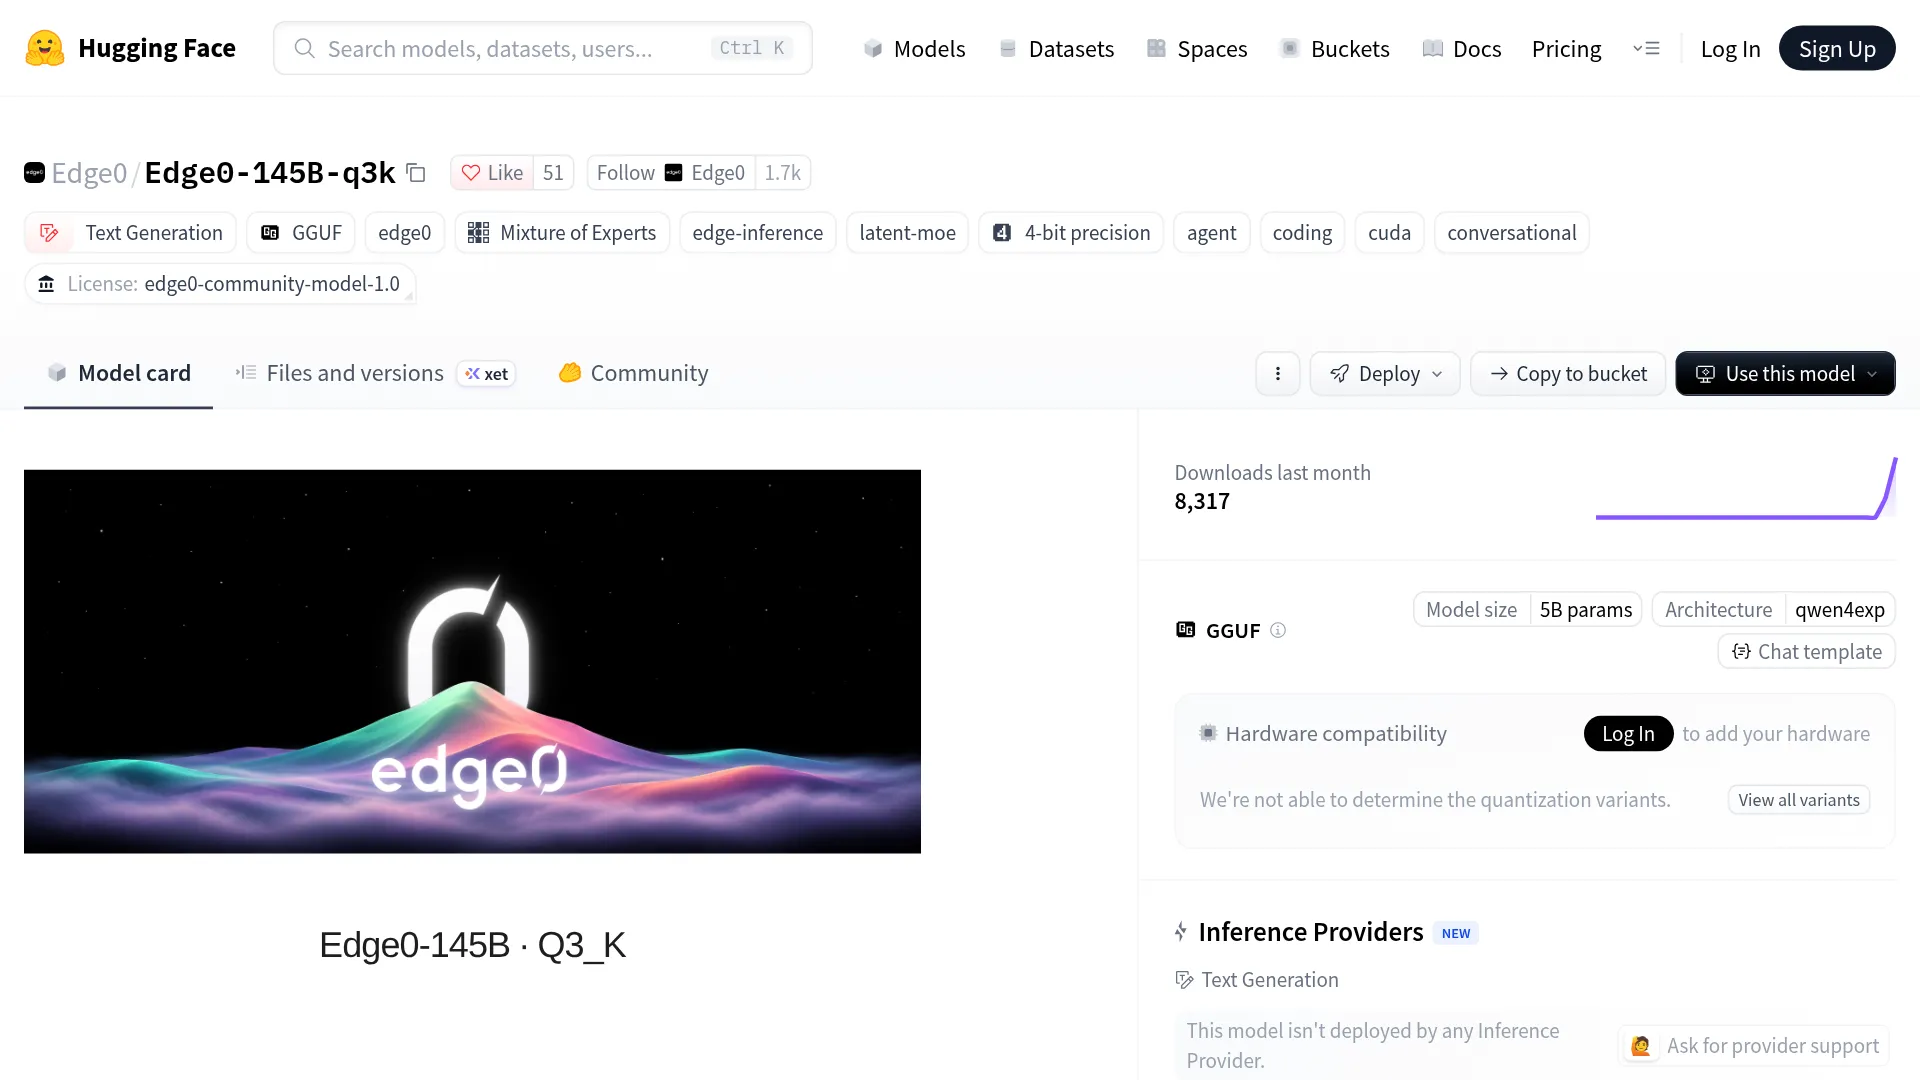
Edge0 hat Edge0-145B und Edge0-120B am 12. November 2026 veröffentlicht. Die Gewichte liegen in Edge0-145B-q3k und Edge0-145B-NVFP4, die Engine edge0-strata im Repository Edge0-AI/Edge0. Edge0-145B ist ein reines Textmodell mit latentem Mixture-of-Experts-Aufbau, 256K Kontext und einer nativen 4-Bit-Trainierung auf Basis von Qwen3.8-Flash-Next. Pro Token werden etwa 10,12 Milliarden Parameter aktiviert. Die 145 Milliarden Gesamtparameter müssen also nicht komplett im VRAM liegen.
Die Gesamtgröße verteilt sich auf rund 84,6 Milliarden Expertenparameter, eine 51,2 Milliarden große PLE-N-Gramm-Tabelle, die per Memory-Mapping von der SSD gelesen wird, einen 1,26 Milliarden Parameter großen Draft-Head für speculative decoding und ein 6 GB großes Skelett. Q3_K bringt 40,81 GiB Gewichte in einem 105,4 GB großen Repository mit, NVFP4 47,79 GiB in insgesamt 112,9 GB. Die gerouteten Experten stecken in einem speziellen experts.bin-Paket und nicht in einem portablen GGUF.
Warum 29 GB nicht wirklich in 29 GB passen
Im Blog ist an einer Stelle von 29 GB Spitzenverbrauch, an anderer von 28 GB die Rede. Dazu kommen Angaben von mehr als 1.100 Token pro Sekunde beim Prefill, mehr als 80 beim Decoding und 120 W Leistungsaufnahme. Die Q3_K-Modellkarte nennt auf einer RTX 5090 D 23,14 GiB VRAM plus 31,28 GiB Host-RAM; bei NVFP4 sind es 23,25 GiB plus 38,27 GiB. Die Expertenbibliothek belegt im RAM rund 40 GB, während etwa 48 GB Vokabular von der SSD gestreamt werden.
Häufig benötigte Experten bleiben im VRAM, weniger häufig verwendete landen im RAM, und die 51,2 GB große PLE-Tabelle wird bei Bedarf von der SSD gelesen. Eng ausgelegt kann der aktive Speicherbedarf an die genannten 29 GB herankommen. Für Download und Streaming braucht es trotzdem das komplette Repository.
| Was die Zahl tatsächlich bedeutet | Größe | Speicherort |
|---|---|---|
| Spitzenverbrauch laut Blog | 28-29GB | Aktiver Speicher, Methodik nicht dokumentiert |
| Q3_K-Repository | 105.4GB | NVMe-SSD, 51.2GB PLE + 40.1GB experts.bin |
| NVFP4-Repository | 112.9GB | NVMe-SSD, 51.2GB PLE + 47.6GB experts.bin |
| Gemessener Q3_K-Speicherbedarf auf der 5090 D | 23.14 GiB VRAM + 31.28 GiB RAM | VRAM und System-RAM während der Inferenz |
| Gemessener NVFP4-Speicherbedarf auf der 5090 D | 23.25 GiB VRAM + 38.27 GiB RAM | VRAM und System-RAM während der Inferenz |
Diese Hardware brauchst du für Edge0-145B
Edge0-145B läuft unter Linux oder Windows mit einer NVIDIA-GPU und CUDA 13 über edge0-infer. Für die veröffentlichten Dateien gibt es keinen Ladeweg über das normale llama.cpp, Ollama oder LM Studio: Dem Skeleton-GGUF fehlen die Gewichte der gerouteten Experten, und Edge0 dokumentiert nur edge0-infer (siehe die Anleitung im Repository). Der Workflow aus dem llama.cpp-v1.0-Guide greift deshalb hier nicht. Im Blog werden macOS und das MacBook Pro als Unterstützung ab dem ersten Tag genannt, die Plattformtabelle führt für 145B und 120B jedoch nur Linux und Windows mit CUDA 13 auf.
Als kleinste getestete Konfiguration nennt Edge0 16 GiB VRAM plus 20 GiB RAM. Damit wurden beim Agent-Decoding mit Q3_K 44,9 Token pro Sekunde erreicht. Empfohlen werden eine NVIDIA-Karte mit 24 GB, 32 GB System-RAM — 48 GB sind komfortabler — sowie 120 GB freier NVMe-Speicher und CUDA 13 mit CMake, Ninja und uv. Build und Server startest du nach der Repository-Anleitung so:
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Unter Windows kannst du stattdessen die Edge0 Chat App v0.2.0 aus den GitHub Releases laden. Bei AMD sind manuelle Anpassungen nötig: u/UghrUghr berichtet in diesem r/LocalLLaMA-Thread von etwa 35 Änderungen an Build und Laufzeit auf einer RX 7900 XTX unter Windows 11. Die CUDA-optimierten Kernel laufen dort über einen langsameren Fallback.
Q3_K oder NVFP4: Welche Datei solltest du laden?
Q3_K ist mit 105,4 GB die Standardvariante und erreicht laut Edge0-Tabelle auf einer 5090 D beim Agent-Decoding 121,2 Token pro Sekunde. NVFP4 ist 112,9 GB groß und zielt auf die Beschleunigung durch Blackwell — auf derselben Karte sind es 98,3. Ohne Blackwell-Hardware solltest du mit Q3_K beginnen.
Wie schnell läuft das Modell auf echter Hardware?
Die folgenden Werte stammen von Edge0 und beziehen sich auf Q3_K mit 16K Prefill, sofern nicht anders angegeben. Die Zeile zum M2 Ultra wurde mit Metal gemessen und belegt keine veröffentlichte macOS-Version.
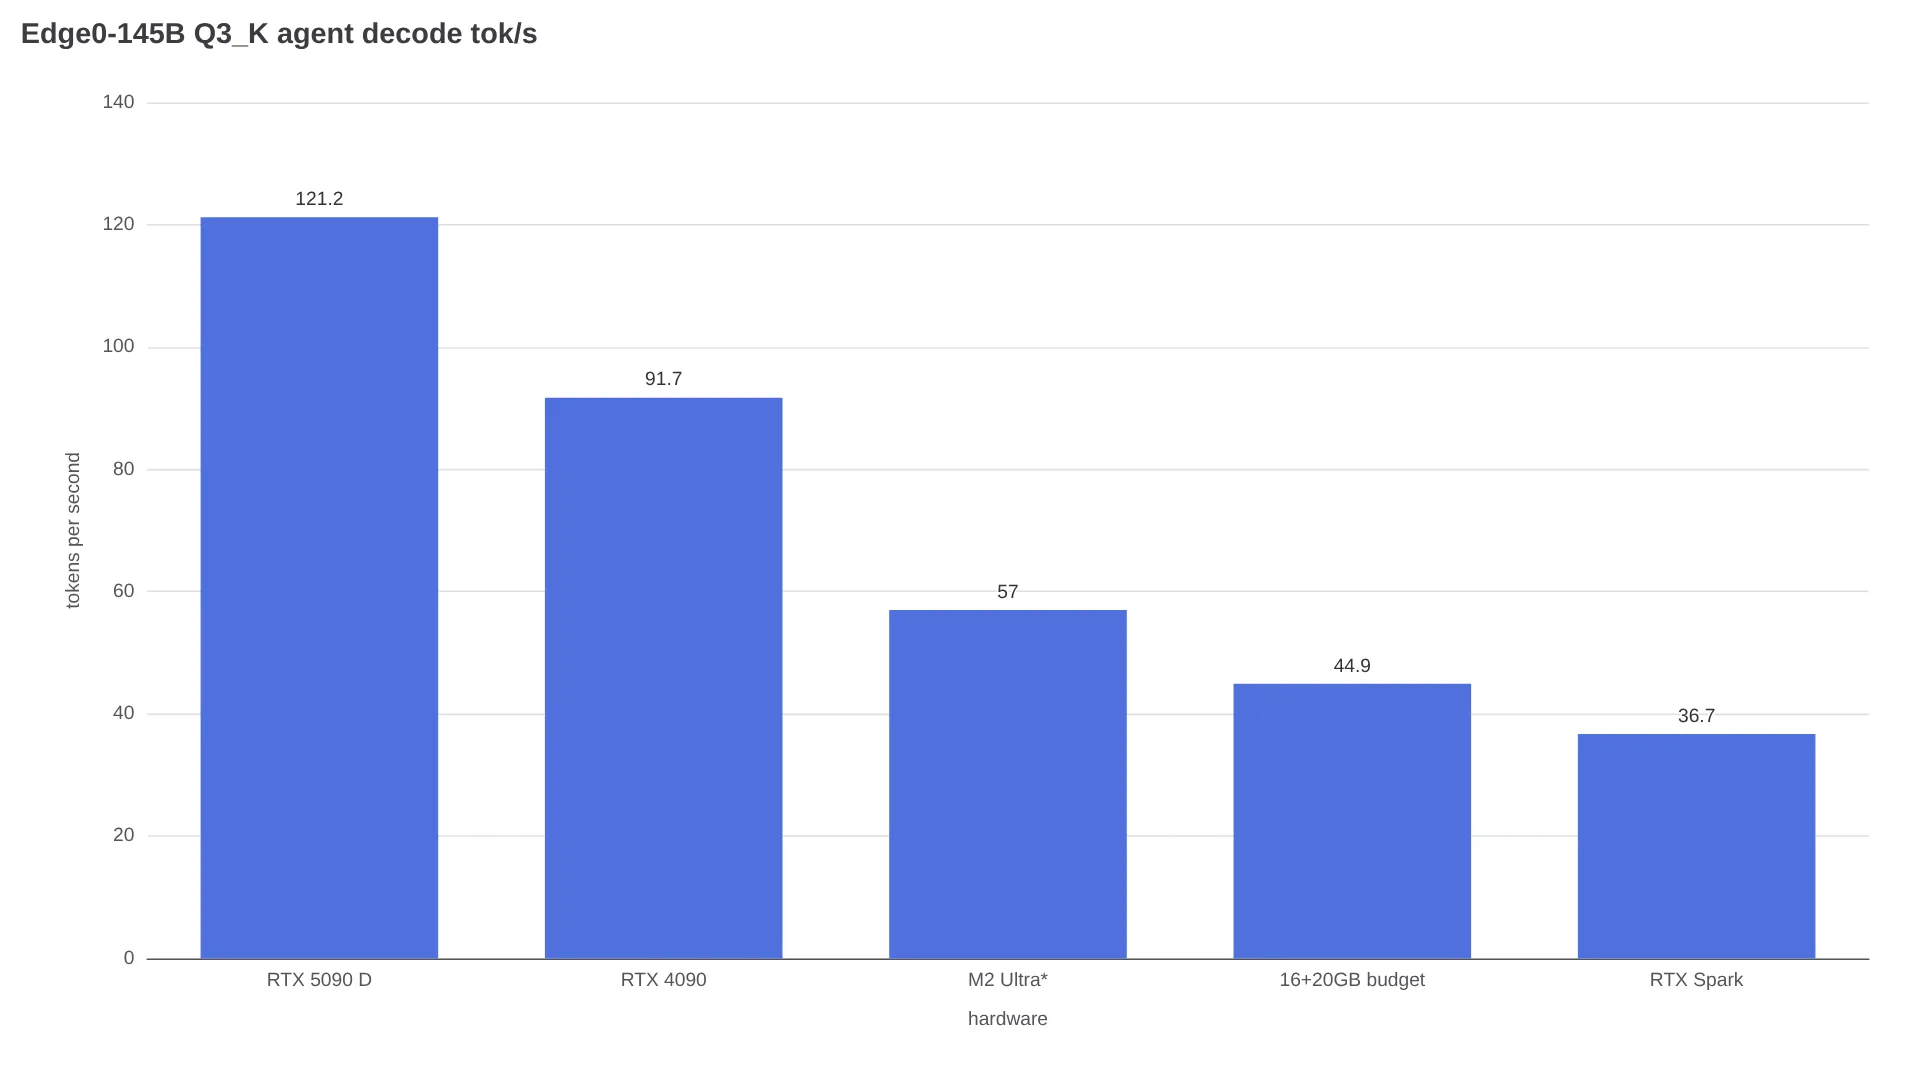
| Hardware | Chat-Decoding | Agent-Decoding | 16K-Prefill |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| 16 GiB VRAM + 20 GiB RAM Budget Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
Ein Nutzer mit RTX 3090 berichtet für Q3_K von 20,1 Sekunden bis zum ersten Token, 1.583 Token pro Sekunde beim Prefill und 56,2 beim Decoding. Das deutet auf ein niedrigeres Tempo als bei den Spitzenkarten hin:
Ich habe es gerade auf meinem 3090-Setup ausprobiert — 20,1 s TTFT, 1583 Token/s Prefill und 56,2 Token/s Decoding für Edge0-145B Q3_K.
— u/LightBrightLeftRight, r/LocalLLM-Thread
Für das oben erwähnte AMD-Setup nennt u/UghrUghr etwa 40 beim Decoding, etwa 54 mit ROUTE_TAIL_SKIP=7 und ROUTE_PRIOR=1.5 sowie etwa 320 bei der Prompt-Verarbeitung. Das sind Einzelmessungen und keine kontrollierten Reproduktionen — ungefähr halb so schnell bis zwei Drittel des Tempos einer 5090 D.
Benchmarks: zwei Siege, vier Einschränkungen
In Edge0s Tabelle stehen interne Läufe für Edge0, Qwen, DeepSeek und Claude neben Drittanbieterwerten für andere Modelle, wie die Modelldokumentation erklärt. Edge0-145B liegt bei den beiden Coding-Agent-Tests vorn, bleibt bei Wissens- und Instruction-Tests aber hinter seinem Qwen-Basismodell. Bis zum 13. November 2026 habe ich keine verlinkte unabhängige Reproduktion gefunden. Außerdem beziehen sich die Werte auf das vollständige Modell und nicht auf die quantisierten Downloads.
| Benchmark | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
In Edge0s eigener Rechnung kommt Edge0-145B auf einen Mittelwert von 72,8, Qwen3.8-Flash-Next auf 71,7 und DeepSeek-V4-Flash auf 70,1. Das 120B-Modell erreicht 68,9. Meine Einschätzung: Bei ähnlich hohen Spitzenverbrauchsangaben für beide Größen ist 145B die bessere Wahl, solange der Speicherplatz nicht knapp ist.
Lizenz: Offene Gewichte sind nicht Open Source
Das Framework steht unter Apache 2.0, die Strata-Basis unter MIT. Die Gewichte unterliegen jedoch der Edge0 Community Model License 1.0; zusätzlich gelten die Qwen-Bedingungen. Private, Forschungs- und interne Geschäftsnutzung sowie die kommerzielle Nutzung der Ausgaben sind erlaubt. Das Modell zu verkaufen oder zu bündeln, einen kostenpflichtigen Dienst zu betreiben oder einen kommerziellen Coding- beziehungsweise Office-Assistenten auszuliefern, erfordert eine separate schriftliche Genehmigung.
Download oder doch lieber eine API?
Der Download lohnt sich, wenn die Verarbeitung aus Hardware- oder Datenschutzgründen lokal bleiben muss und die nötige Ausstattung vorhanden ist. Für einen einmaligen Test solltest du die Preise gehosteter APIs vergleichen, bevor du Hardware kaufst. Wer gehostete Inferenz vergleicht, kann vor der Entscheidung für 105 GB belegten Speicher auch die DeepSeek-V4.1-Flash-API-Seite ansehen.
| Deine Situation | Empfehlung |
|---|---|
| 24GB NVIDIA + 32-48GB RAM + 120GB NVMe, Linux/Windows | Q3_K herunterladen und über edge0-infer bereitstellen |
| Blackwell-Karte, bevorzugt NVFP4 | NVFP4-Version herunterladen |
| Nur Mac, 8-16GB-Laptop oder Bedarf an Ollama/LM Studio | Noch nicht herunterladen; gehostete API verwenden |
| Eine kostenpflichtige API oder einen Assistenten mit den Gewichten anbieten | Auf die schriftliche Lizenzfreigabe warten; API verwenden |
| Die Benchmark-Werte nutzen, ohne sich um den Betrieb zu kümmern | Qwen- oder Frontier-APIs verwenden und nach unabhängigen Reproduktionen erneut prüfen |
Der entscheidende Zielkonflikt liegt zwischen Herkunft und Alltagstauglichkeit: Expert-Streaming senkt die VRAM-Hürde für Modelle mit mehr als 100 Milliarden Parametern. Die Laptop-, macOS- und 29-GB-Darstellung geht dem veröffentlichten Code jedoch voraus, und Edge0s Tabelle nennt keine separaten Qualitätswerte für Q3_K.
FAQ
Läuft Edge0-145B auf einem Laptop?
Nur auf einem leistungsstarken NVIDIA-Laptop mit etwa 24 GB VRAM, mindestens 32 GB RAM und 120 GB NVMe unter Linux oder Windows mit CUDA 13. Ein Ultrabook mit 8 oder 16 GB kann die 145B-Version nicht ausführen. Der Download ist 105,4 GB groß, dazu kommen mehr als 23 GiB VRAM für die aktive Belegung.
Funktioniert Edge0-145B auf dem Mac?
In der Plattformtabelle ist bis zum 13. November 2026 keine unterstützte macOS-Version aufgeführt. Die M2-Ultra-Werte sind ausschließlich Metal-Messungen.
Funktioniert das Modell mit Ollama, llama.cpp oder LM Studio?
Nein. Standard-Builds können die benutzerdefinierten experts.bin-Pakete nicht laden, und dem Skeleton-GGUF fehlen die Gewichte der gerouteten Experten. Verwende edge0-infer serve oder die Windows-Chat-App.
Ist Edge0-145B besser als Qwen3.8-Flash-Next?
In Edge0s Tests liegt Edge0-145B bei DeepSWE mit 64,6 zu 58,7 und bei Terminal-Bench mit 86,52 zu 83,3 vorn. Bei HLE liegt es mit 35,4 zu 35,9 und bei GPQA-Diamond mit 90,4 zu 91,7 hinten. Unabhängige Tests stehen noch aus.
Darf ich Edge0-145B kommerziell nutzen?
Die Ausgaben dürfen kommerziell genutzt werden. Das Modell zu verkaufen, einen kostenpflichtigen Dienst zu betreiben oder einen kommerziellen Coding- beziehungsweise Office-Assistenten auszuliefern, erfordert unter der Community-Lizenz jedoch eine separate schriftliche Genehmigung. Zusätzlich gelten die Qwen-Bedingungen.