 AIREITER
Am 29. Juli 2026 mussten Claude Opus 5 sowie GPT-5.6 Sol, Terra und Luna dieselben vier Aufgaben lösen. Das Ergebnis: 16 Antworten, 16-mal korrekt. Für diese vier kompakten Checks liefert die Genauigkeit also keinen Grund, eines der Modelle vorzuziehen.
Deutlich auseinander liegen sie dennoch bei zwei Punkten, die sich direkt auf die Rechnung auswirken: Opus 5 berechnete 1.642 Output-Token, Sol nur 480. Und sobald ein Request 272.000 Input-Token überschreitet, wechseln GPT-5.6-Requests in eine höhere Preisstufe, während Claude Opus 5 sein komplettes 1M-Kontextfenster zum Einheitspreis abrechnet. Bei 200K Input und 20K Output liegen die beiden Flaggschiffe beim Listenpreis nur 7% auseinander. Mit wachsendem Output und jenseits der 272K-Grenze wird der Abstand größer – entscheidend sind dann Request-Form und Modellverhalten.
Vier Modelle, vier identische Aufgaben
Jedes Modell erhielt für vier Aufgaben denselben User-Prompt; die Ergebnisse ließen sich jeweils mechanisch überprüfen. Es galt, eine fehlerhafte Python-Funktion namens median zu reparieren, Buchstaben in einer festgelegten Zeichenfolge zu zählen, den 7,5-Grad-Winkel einer Uhr um 3:15 zu berechnen und eine absichtlich unübersichtliche JavaScript-Funktion ohne Verhaltensänderung zu refaktorieren. Die Code-Antworten haben wir nicht nur gelesen, sondern gegen Edge Cases ausgeführt.
Alle Modelle bestanden sämtliche Checks. Die Python-Fixes behandelten Listen mit gerader Länge korrekt; alle vier nannten 9 und 7,5, wo 9 und 7,5 die richtigen Antworten waren; und alle Refactorings überstanden einen Verhaltensvergleich einschließlich falsy-Feldern und null-Kategorie-Filtern.
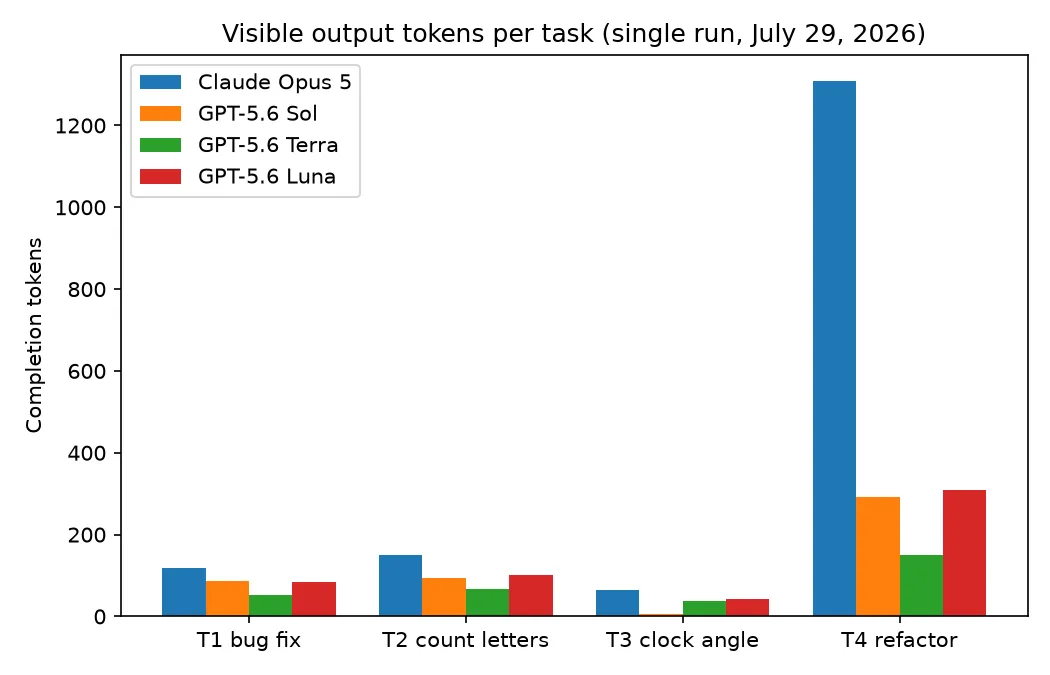
Drei Einschränkungen, bevor diese Zahlen zitiert werden. Es handelt sich um einen Durchlauf pro Modell und Aufgabe – also um einen Smoke-Test, nicht um einen Benchmark. Die Requests liefen über ein Gateway mit eigenem System-Prompt; dadurch schwankten die Input-Token je Request zwischen 35 und 4.415, weshalb wir sie vollständig ausgeklammert haben. Außerdem rechnen beide Anbieter versteckte Reasoning-Token als Output ab. „Output-Token“ meint hier daher das Abrechnungsvolumen, nicht nur den Text, den man tatsächlich liest.
Trotz Gleichstand blieb ein qualitativer Unterschied: Opus 5 lieferte das stärkste Refactoring der vier Modelle. Es machte aus den zwei Schleifen des Originals einen einzigen Durchlauf, zog den Faktor 1,2 in eine benannte Konstante und hinterließ einen Kommentar, der die bewusst beibehaltene lose Gleichheit zur Wahrung des Verhaltens erklärt. Sol, Terra und Luna lieferten ebenfalls korrekte, aber wesentlich wörtlichere Übertragungen mit zwei Schleifen.
Nicht die Korrektheit trennt sie, sondern Token und Zeit
Bei 16 Durchläufen war die Korrektheit identisch. Der praxisnahe Vergleich dreht sich damit um die Kosten jeder Antwort. Opus 5 brauchte für die vier Aufgaben insgesamt 32,4 Sekunden und rechnete 1.642 Completion-Token ab. Sol benötigte 19,7 Sekunden und 480 Token, Terra 11,7 Sekunden und 308, Luna 15,3 Sekunden und 537.
| Einzelner Durchlauf, 29. Juli 2026 | Korrekt | Output-Token | Gesamtzeit | Kosten nur für Output |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1.642 | 32,4s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19,7s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11,7s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15,3s | $0.0032 |
Der Unterschied liegt im Reasoning-Volumen, nicht in der Antwortlänge. Für das Refactoring stellte Opus 5 1.308 Token bei einer finalen Antwort von 492 Bytes in Rechnung; für die Antwort „7.5“ waren es 64 Token, während Sol 7 benötigte. Laut Anthropic-Dokumentation verwendet Opus 5 in der API standardmäßig hohen Aufwand. Ein Teil des Effekts ist somit eine Voreinstellung und keine unveränderliche Modelleigenschaft; gemessen wurde das Standardverhalten, nicht die Untergrenze.
Daten aus der Community zeigen ein ähnliches Bild. Ein Chart-Post in r/Anthropic, bei unserer Prüfung am 29. Juli das erste Google-Ergebnis für diese Suche, sieht beide beim Coding nahezu gleichauf, während Opus länger braucht und deutlich mehr Token verbraucht. Ein Nutzer in r/ClaudeCode formulierte denselben Befund weniger höflich:
GPT 5.6 Sol erledigt einfach, worum du es bittest. Opus 5 schreibt erst „Krieg und Frieden“ in 12 Bänden und erledigt dann, worum du es bittest.
Mit den Aufwandseinstellungen kann sich die Wirtschaftlichkeit allerdings drehen. Ein Hacker-News-Kommentator, der Daten von Artificial Analysis auswertete, kam für Opus 5 bei hohem Aufwand auf rund $1.06 pro Lauf des Intelligence Index, gegenüber $1.04 für Sol auf max. Wenn beide Modelle intensiv nachdenken, liegen sie damit nahezu gleichauf.
Was hinter „GPT-5.6“ steckt: Sol, Terra und Luna
GPT-5.6 bezeichnet nicht ein einzelnes Modell. OpenAI bietet drei SKUs an, und der bloße String gpt-5.6 ist als Alias für gpt-5.6-sol dokumentiert – also für das teuerste der drei Modelle. Wer in der Konfiguration gpt-5.6 einträgt, zahlt den Höchsttarif der Familie. Das sollte vor jedem Kostenvergleich geprüft werden.
OpenAIs Modellreferenz beschreibt Sol als „frontier model for complex professional work“, Terra als Stufe, die „intelligence and cost“ ausbalanciert, und Luna als „optimized for cost-sensitive workloads“. Alle drei verfügen über ein Kontextfenster von 1,05M Token, maximal 128K Output, einen Knowledge Cutoff vom 16. Februar 2026 sowie sechs wählbare Reasoning-Stufen von none bis max.
| Spezifikation, geprüft am 29. Juli 2026 | Claude Opus 5 | GPT-5.6 (alle drei) |
|---|---|---|
| Kontextfenster | 1M Token | 1,05M Token |
| Maximaler Output | 128K (300K via Batch API beta) | 128K |
| Zuverlässiger Knowledge Cutoff | Mai 2026 | 16. Februar 2026 |
| Reasoning-Steuerung | Adaptives Thinking, effort standardmäßig auf high | none / low / medium / high / xhigh / max |
| API-ID | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
Zwei Zeilen dieser Tabelle sind für die Entscheidung besonders relevant. Der Knowledge Cutoff von Opus 5 im Mai 2026 ist drei Monate aktueller als der der gesamten GPT-5.6-Familie – wichtig für alles, was auf Veröffentlichungen aus dem Frühjahr 2026 Bezug nimmt. Zudem unterscheiden sich die Reasoning-Optionen nicht nur in der Anzahl: Bei GPT-5.6 lässt sich das Reasoning mit none komplett abschalten. Opus 5 verwaltet sein Thinking-Budget adaptiv und bietet darüber hinaus Aufwandstufen an.
Preise: Einheitstarif bis 1M gegen die Stufe bei 272K
Beide Anbieter veröffentlichen übersichtliche Preise pro Token. Unterhalb von 272K Input-Token liegen sie eng beieinander: Beide Flaggschiffe kosten $5 pro Million Input-Token, Opus 5 verlangt $25 pro Million Output-Token gegenüber $30 bei Sol, die Preise für gecachten Input sind mit $0.50 identisch, und beide bieten 50% Batch-Rabatt. Zu diesen Tarifen kostet ein Request mit 200K Input und 20K Output bei Opus 5 $1.50 und bei Sol $1.60.
| Pro 1M Token, Listenpreis vom 29. Juli 2026 | Input | Gecachter Input | Output | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
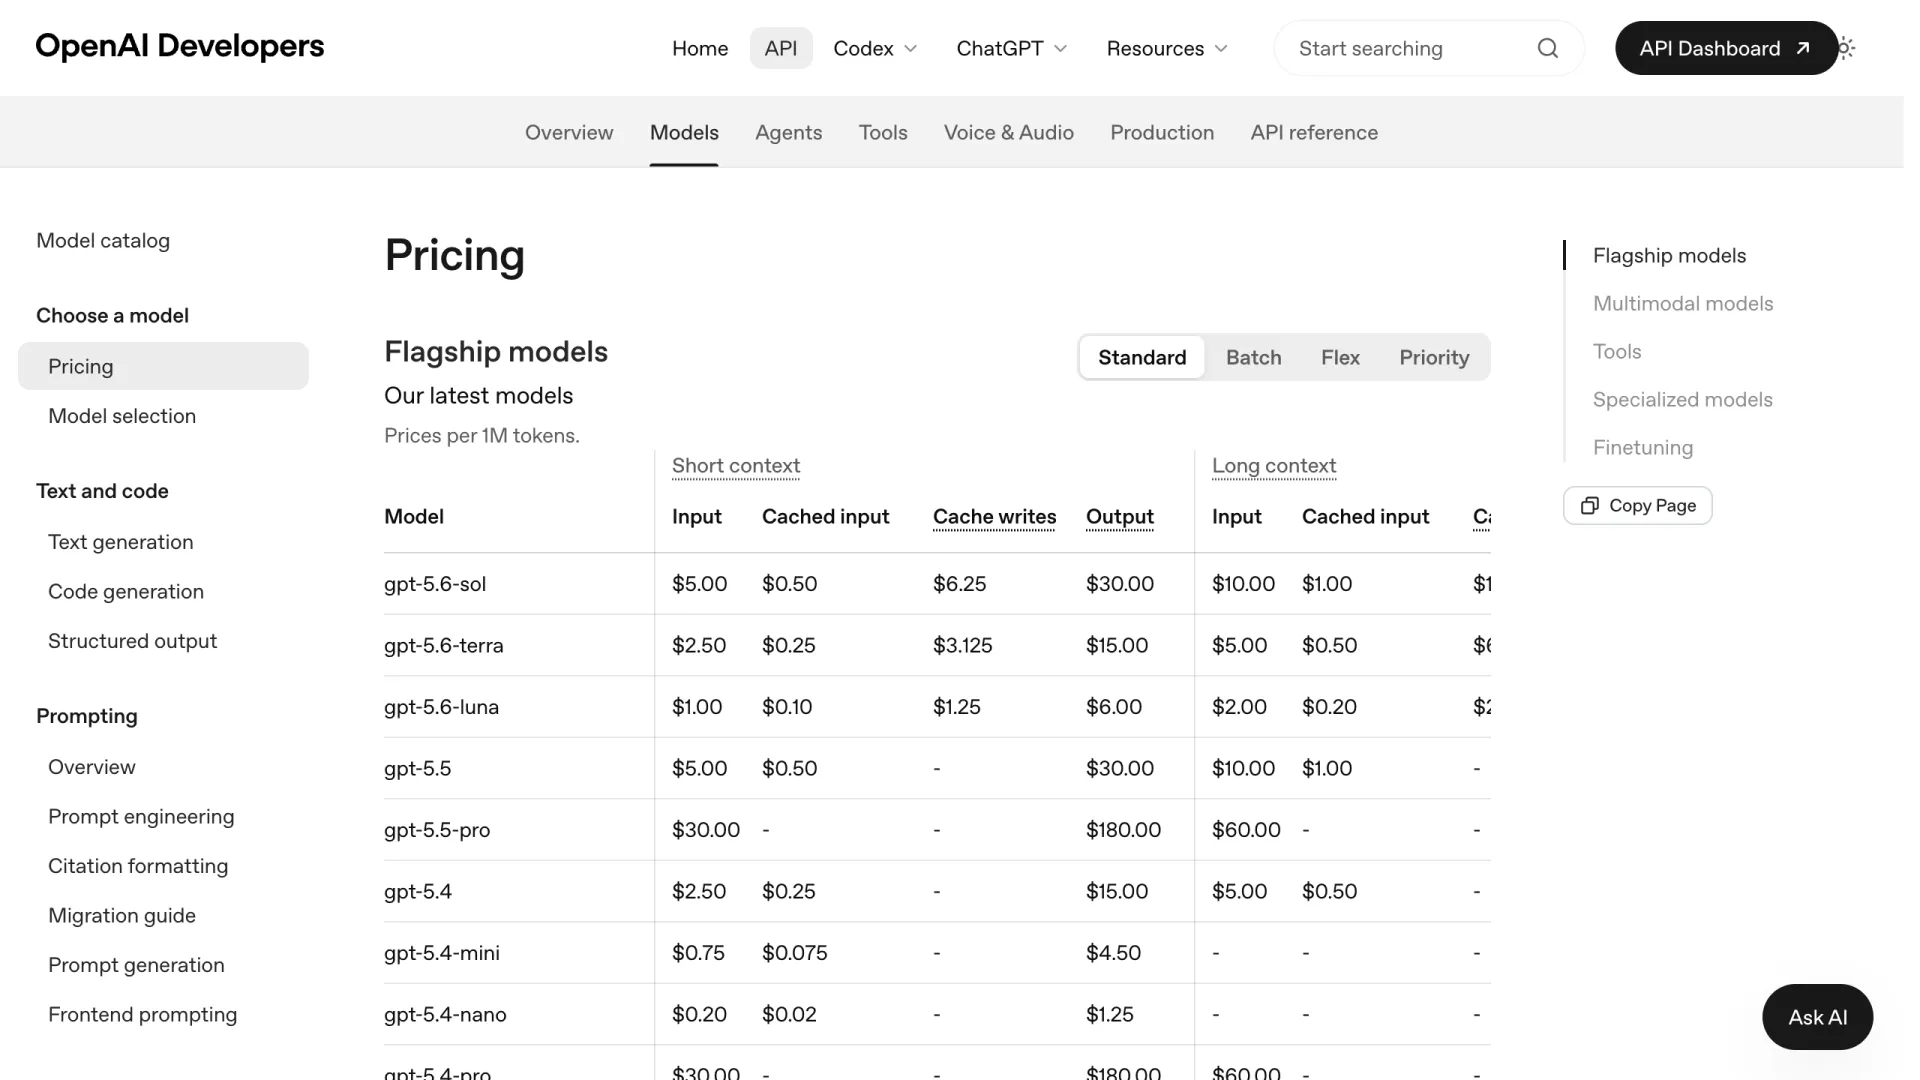
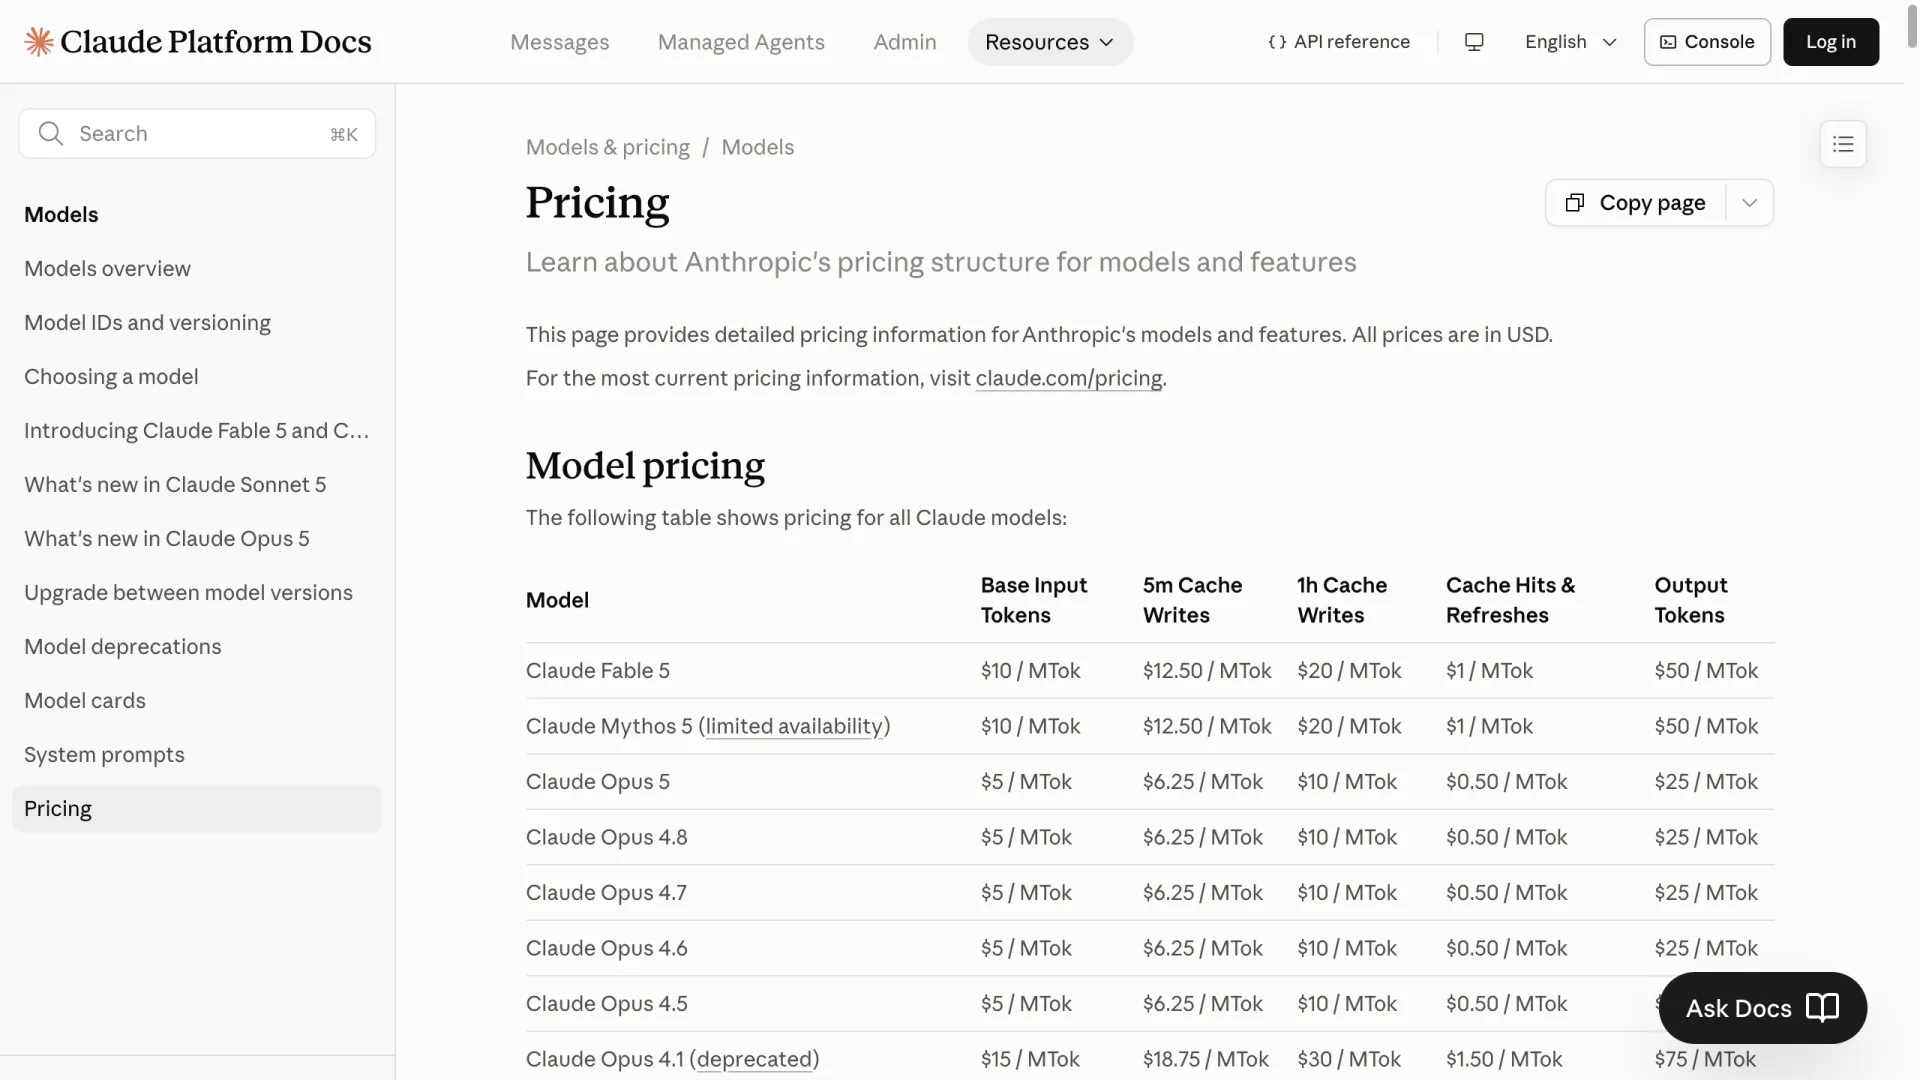
Der strukturelle Unterschied beginnt bei 272K Input-Token. OpenAIs Preisseite trennt für jeden GPT-5.6-Tarif zwischen Short Context und Long Context: Oberhalb von 272K Input verdoppeln sich die Input-Kosten, während sich die Output-Kosten mit dem Faktor 1,5 erhöhen. Sol landet damit bei $10 beziehungsweise $45. Anthropics Preis-Dokumentation beschreibt das Gegenmodell in einem Satz: „A 900k-token request is billed at the same per-token rate as a 9k-token request.“
In Dollar und jeweils mit 20K Output gerechnet: Ein Request mit 300K Input kostet bei Opus 5 $2.00 und bei Sol $3.90. Bei 500K sind es $3.00 gegenüber $5.90, bei 900K $5.00 gegenüber $9.90. Oberhalb der Stufe kostet Opus 5 für dieselbe Request-Form ungefähr die Hälfte von Sol.
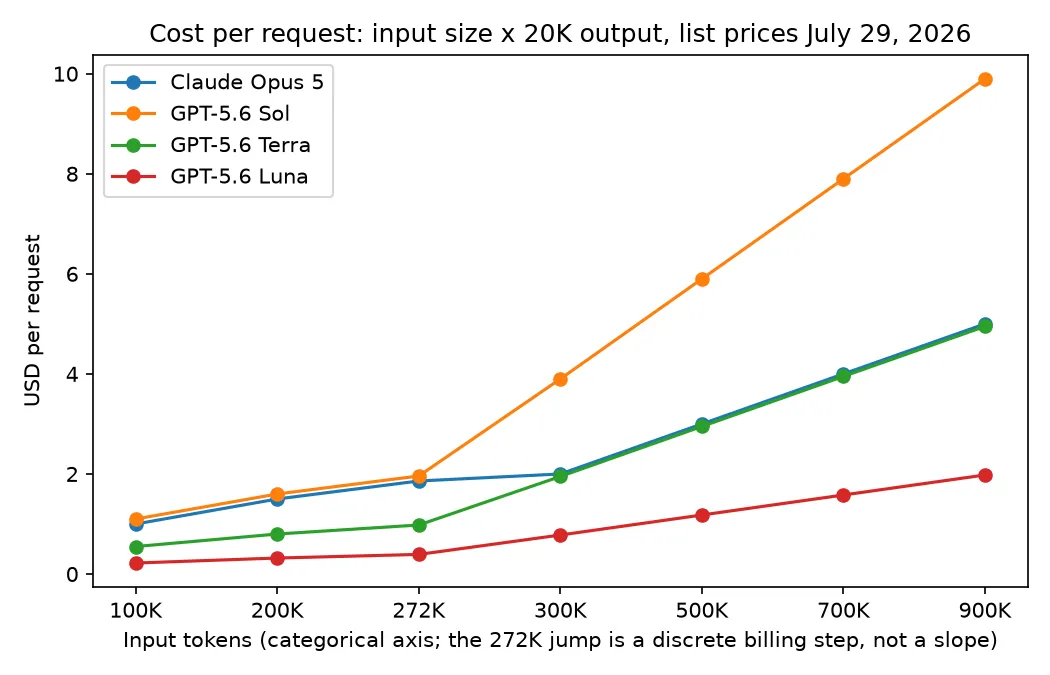
Die Grafik enthält allerdings eine Überraschung, die gegen einen eindeutigen Anthropic-Sieg spricht. Oberhalb von 272K liegt Terras verdoppelter Input-Tarif mit $5 auf dem Niveau von Opus 5, während der Long-Context-Output-Preis von $22.50 den $25 von Opus 5 unterbietet. Bei 20K Output ist Terra dadurch bei 300K, 500K, 700K und 900K Input konstant fünf Cent pro Request günstiger. Die fünf Cent skalieren mit dem Output-Volumen, nicht mit der Input-Größe: Die Differenz beträgt $2.50 pro Million Output-Token.
Drei Fußnoten für die Budgetplanung. Anthropic bietet für Opus 5 im Research Preview einen Fast Mode für $10 Input und $50 Output an; OpenAI verkauft einen Priority-Tier zum Doppelten der Standardpreise, allerdings nur für Short Context. Datenresidenz in den USA erhöht die Kosten bei beiden Anbietern um etwa 10%. Außerdem erzeugt Claudes aktueller Tokenizer laut Anthropics eigener Anmerkung für denselben Text rund 30% mehr Token als Modelle vor 4.7. Die ehrliche Schlussprüfung besteht daher darin, einen repräsentativen Prompt durch beide Tokenizer zu schicken, bevor Preise hochgerechnet werden.
Welches Modell für welchen Workload?
Da die Korrektheit unentschieden ist, entscheiden Request-Form und Arbeitsstil über das Routing. Entwickler in r/ClaudeCode setzen Sol mit hohem Aufwand als Review- und QA-Agent ein, weil es gründlich ist und gut mit einem Browser arbeitet. Andere Nutzer in r/codex routen den Großteil ihrer Arbeit zu den günstigeren GPT-Tiers mit mittlerem Reasoning und berichten dort vom besten Kosten-Nutzen-Verhältnis.
| Request-Form | Empfehlung | Warum |
|---|---|---|
| Unter 272K Input, Agent-Loops mit viel Output | Claude Opus 5 | $25 statt $30 für Output; in unserem Durchlauf das stärkste Refactoring-Urteil |
| Unter 272K, latenzkritisch oder hohes Volumen | GPT-5.6 Terra | Das schnellste und günstigste Modell im Test, das alle Checks bestand |
| Über 272K Input | Claude Opus 5 oder Terra | Sols Long-Context-Tarife verdoppeln sich; Terra bleibt fünf Cent unter Opus 5 |
| Review, QA und browsergestützte Prüfung | GPT-5.6 Sol | Sechs Aufwandstufen zum Feinjustieren der Prüftiefe; mit dem eigenen QA-Set validieren |
| Wegwerf-Klassifikation und Extraktion | GPT-5.6 Luna | $1/$6 und trotzdem alle vier Checks bestanden |
Dass Sol den QA-Platz verdient, sehen nicht alle so: Ein Thread in r/codex bezeichnet Sol als Rückschritt gegenüber GPT-5.5 und schreibt Opus 5 mehr erledigte Aufgaben pro Plan zu. Die Standardwerte lassen sich aber günstig testen: Alle vier Modelle stehen im AIReiter-Katalog bereit (Opus 5, Sol), sodass sich eigene Aufgaben direkt nebeneinander wiederholen lassen.
Die eine Zahl, die aus diesem Vergleich hängen bleiben sollte: 272.000 Input-Token. Darunter entscheiden Verhalten, Latenz und die $5 Differenz beim Output-Tarif. Darüber spricht der Preis gegen Sol für Anthropic – wobei Terra fünf Cent unter Opus 5 bleibt und Luna deutlich günstiger als beide ist.
FAQ
Ist gpt-5.6 dasselbe Modell wie GPT-5.6 Sol?
Ja. OpenAIs Modellreferenz führt den bloßen String gpt-5.6 als Alias auf, der zu gpt-5.6-sol aufgelöst wird. Abgerechnet wird daher zu Sols Preisen: $5 für Input und $30 für Output pro Million Token unterhalb von 272K Input, darüber $10 beziehungsweise $45.
Verlangt Claude Opus 5 für Long-Context-Requests mehr?
Nein. Anthropic rechnet das komplette 1M-Fenster in der regulären API zu Standardtarifen ab und erklärt, dass ein Request mit 900K Token pro Token genauso viel kostet wie einer mit 9K. Nur der optionale Fast Mode ist teurer: $10 für Input und $50 für Output.
Was ist günstiger: Claude Opus 5 oder GPT-5.6?
Das hängt vom Tier ab. Unterhalb von 272K Input ist Opus 5 bei Output um $5 pro Million Token günstiger als Sol; ansonsten sind beide identisch bepreist. Terra und Luna sind deutlich günstiger als beide. Oberhalb von 272K kostet Opus 5 pro Request ungefähr halb so viel wie Sol, während Terra geringfügig günstiger als Opus 5 bleibt.
Ist Claude Opus 5 fürs Coding besser als GPT-5.6?
In unserem Durchlauf vom 29. Juli reparierten, zählten und refaktorierten beide korrekt. Der r/Anthropic-Chart-Post, der am 29. Juli bei Google für diese Suche vorne lag, zeigt sie bei Coding-Scores fast gleichauf. Opus 5 bewies das beste Refactoring-Urteil, rechnete in den Standardsettings aber 3,4-mal so viele Output-Token wie Sol ab. Für Coding ist die Wahl damit vor allem eine Frage von Kosten und gewünschter Ausführlichkeit.
Welche Knowledge Cutoffs haben Opus 5 und GPT-5.6?
Anthropic nennt für Claude Opus 5 einen zuverlässigen Knowledge Cutoff im Mai 2026. Alle drei GPT-5.6-Modelle teilen sich den Cutoff vom 16. Februar 2026, also etwa drei Monate früher.