 AIREITER
想在终端里直接用 Kimi K3 写代码,接入 OpenCode 只需三条命令。它的标价处于 Sonnet 级别:输入和输出每百万 token 分别为 $3/$15;但受益于高比例提示词缓存,OpenCode 的真实会话平均成本仅为 $1.79。
三步把 Kimi K3 接入 OpenCode
OpenCode 是一款开源终端编程 Agent,内置了 Kimi 的认证流程,不需要手动填写 Base URL,也不用修改配置文件。以下步骤基于 OpenCode 1.18.3,并与 Kimi 官方集成文档一致。
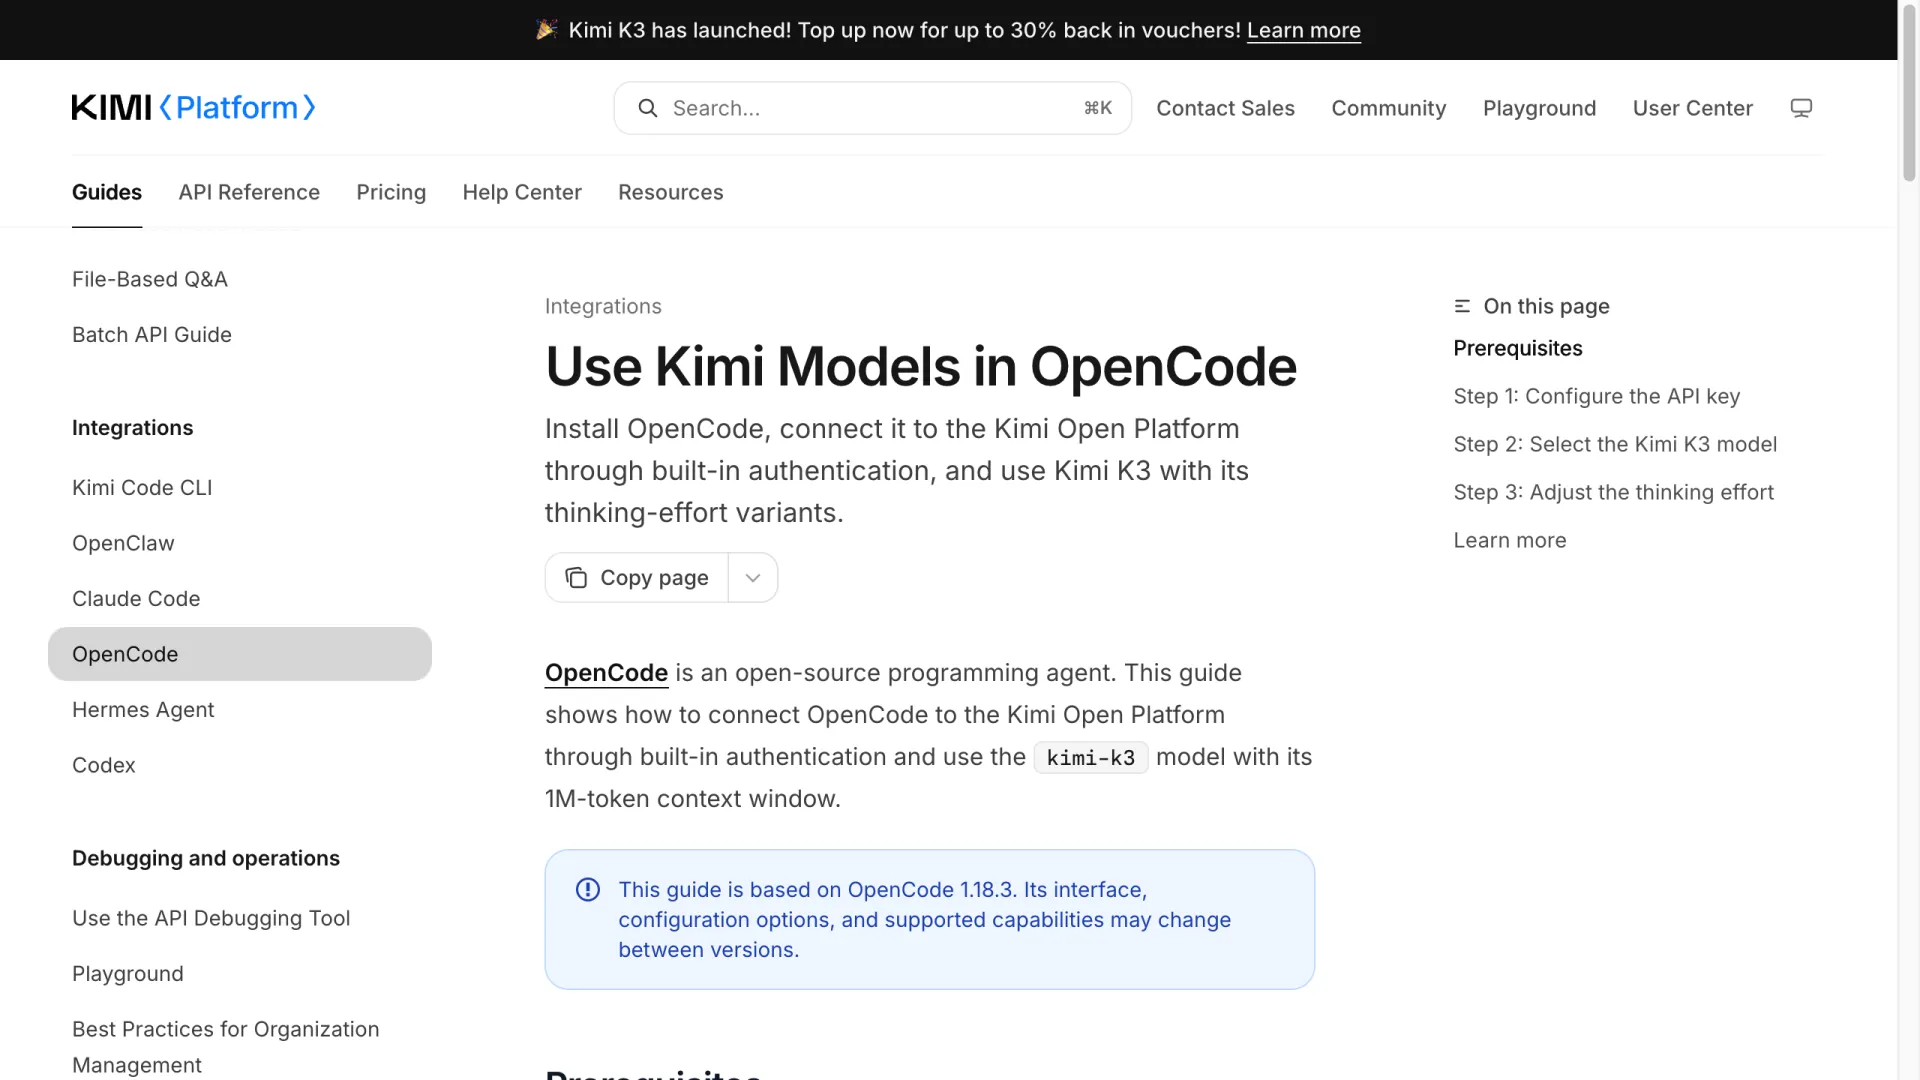
1. 登录并配置 API Key
运行 opencode auth login,在服务商列表中选择 Moonshot AI,再粘贴从 Kimi Open Platform 获取的 Key。这里有两点很容易踩坑:账户必须有实际余额,新用户代金券不能用于 K3;另外,不要把 Key 放进配置文件、截图或 git 仓库。OpenCode 使用自己的凭据系统保存它,正是为了避免这些风险。
2. 切换到 kimi-k3 模型
进入 OpenCode 后运行 /models,选择 kimi-k3。模型会以完整的 100 万 token 上下文窗口载入,单轮输出上限为 13.1 万 token。完成后,状态栏应显示“Kimi K3”和“Moonshot AI”。
3. 调整思考强度
运行 /variants,可以控制 K3 在回答前投入多少推理。默认值为 max,也可改为 high 或 low。正如后文成本部分所示,这是影响账单最明显的一个开关。
Kimi K3 一次真实会话要花多少钱
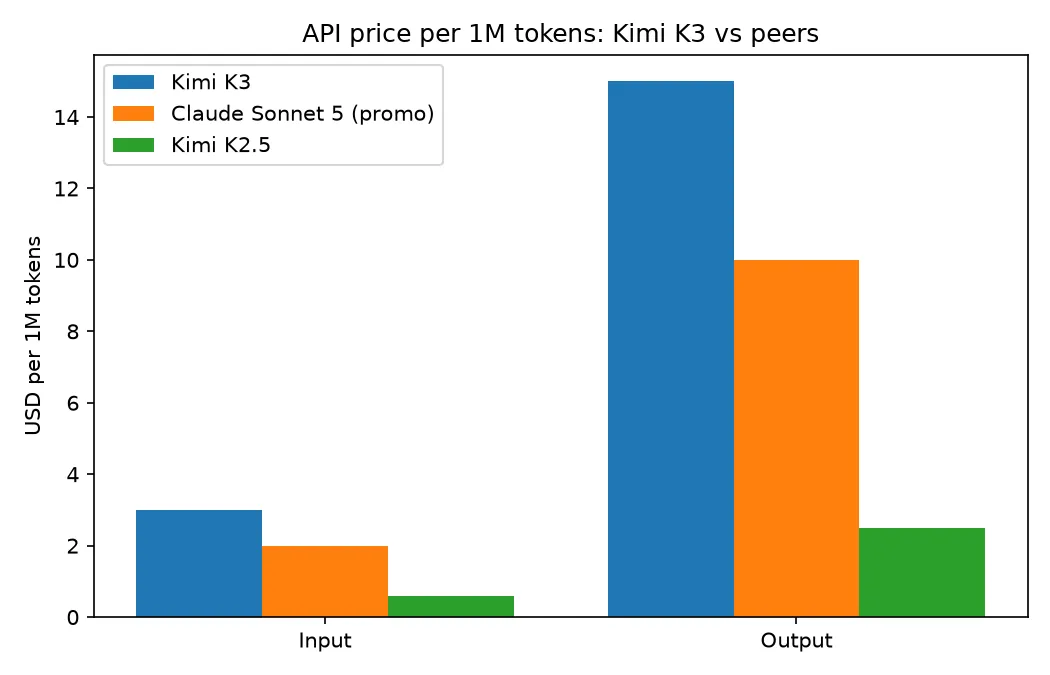
K3 的公开价格是每百万输入 token $3、每百万输出 token $15,高于 Claude Sonnet 5 的 $2/$10 促销价。
但实际使用 K3 的成本低得多,因为大部分 token 都是价格更低的缓存读取。OpenCode 按模型公开的使用数据如下图所示:在 66,379 次已完成会话中,Kimi K3 每次会话平均消耗 290 万 token,平均成本为 $1.79。按实际使用 token 计算,相当于约每百万 token $0.62,远低于 $3 的输入标价。原因在于,93% 的输入 token 命中缓存;缓存命中每百万 token 只需 $0.30,而非 $3.00,折扣达到 90%。Artificial Analysis 给出的混合价格是每百万 $2.31,但它按 70% 缓存率估算;OpenCode 实际达到 93% 的缓存命中率,因此单次会话成本更低。
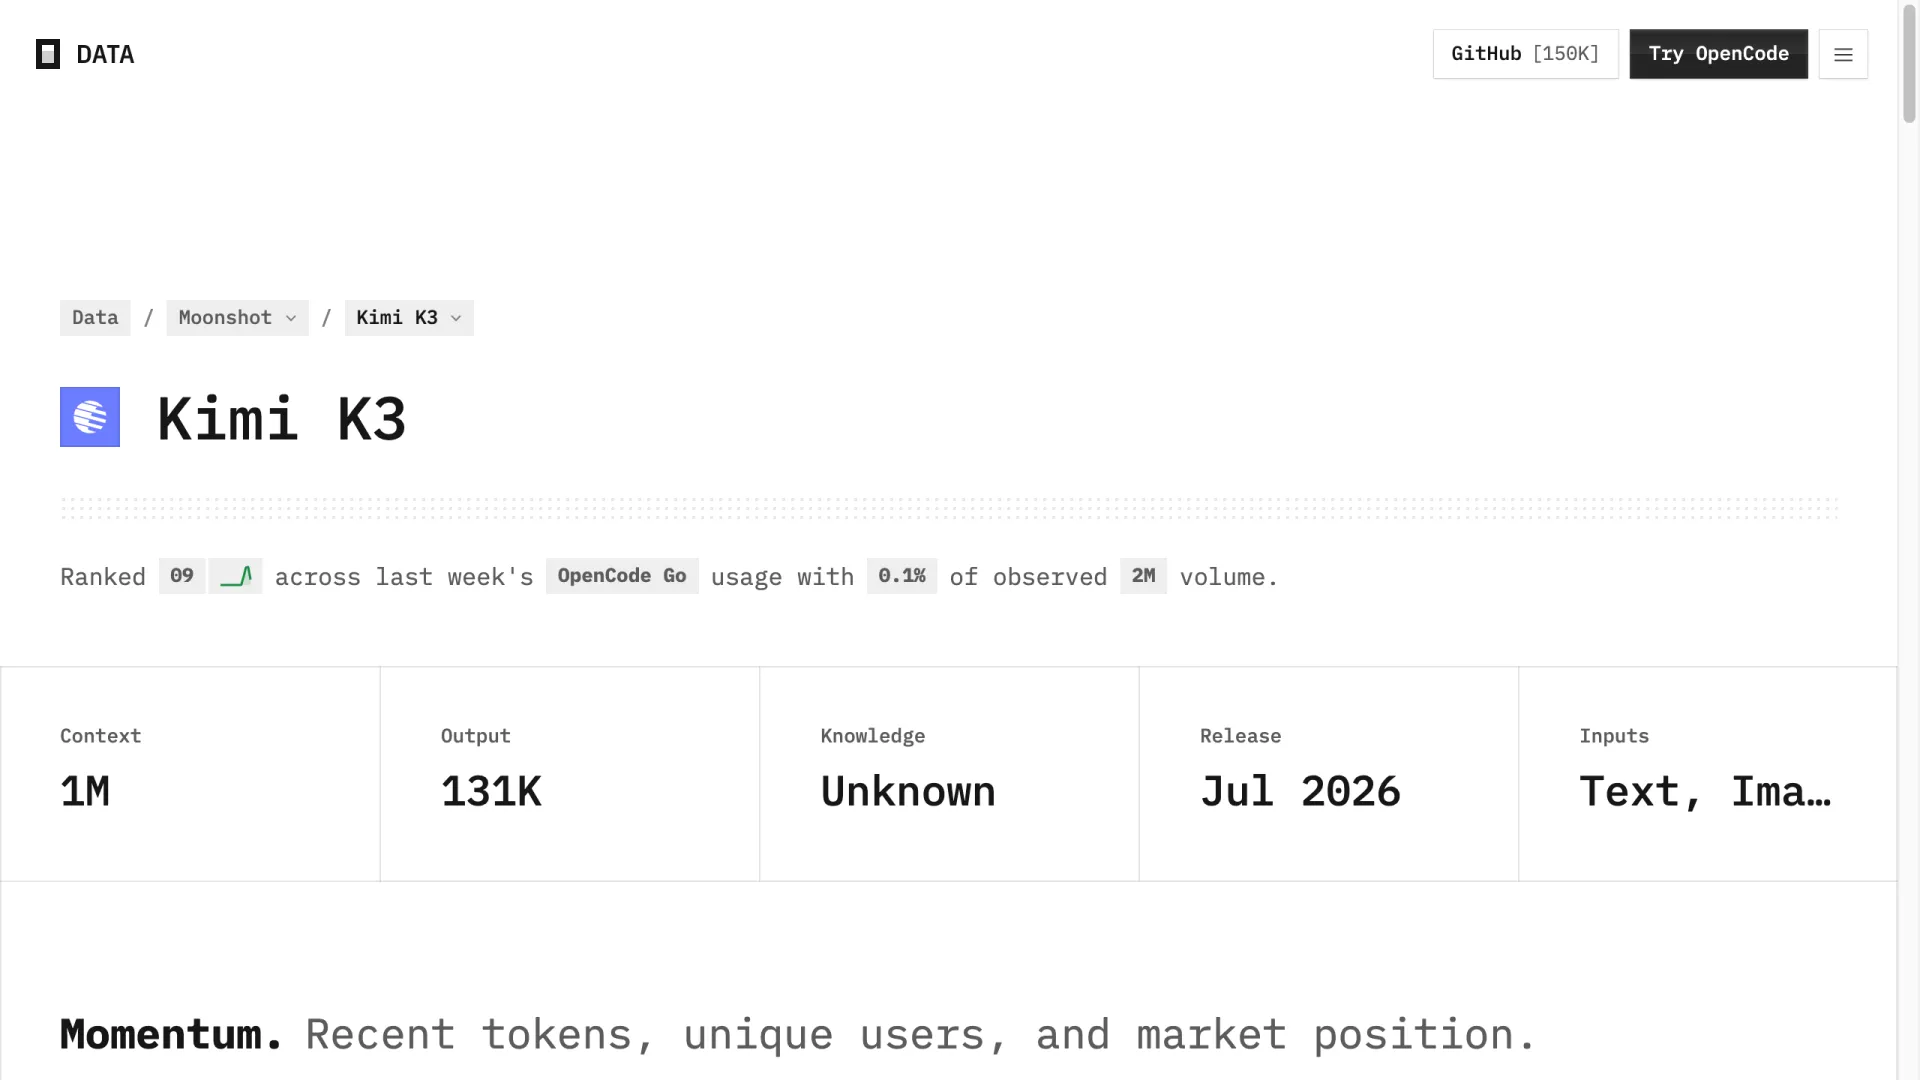
公开定价依然属于 Sonnet 档位;开放权重发布,即截至 2026 年 7 月 27 日提供完整权重,改变的是你可自行托管的方式,而不是通过 API 调用时的价格。各模型每百万 token 的价格对比如下:
按 token 用量计算,K3 在 OpenCode Go 中排名第 9。根据 OpenCode 的增长数据,截至 7 月 20 日的八周内,它的使用量翻了一倍——纸面价格不低,但面对高难度任务,需求依然旺盛。
K3 为什么容易烧 token,怎么控制
用户最常抱怨的往往不是单价,而是 K3 用掉的 token 数量。由于默认采用 max 思考强度,K3 往往会在行动前进行大量推理;面对简单修改时,这部分推理就成了额外开销。2026 年 7 月,一位 OpenCode 用户在 X 上直言:对于轻量模型能更快完成的任务,它可能会“消耗很多 token,却没做成多少事”。
可以从三个方向压住这笔开销:
- 降低 variant。 日常任务可在
/variants中切换为low或high。max更适合架构设计和多文件重构,不值得用于给函数改名。 - 尽量复用缓存。 K3 能把会话成本控制住,关键就在于 93% 的缓存命中率。尽量在同一个长会话中持续工作,不要频繁重新开始;每次重开都会重新发送未缓存的上下文,并按原价计费。
- 精简 Agent 环境。 当 Agent 脚手架过于嘈杂时,K3 更容易过度思考。删减始终加载的指令文件、未使用的 MCP server 和冗长的工具说明,既能减少工具往返调用,也能降低它陷入反复推理的空间。
代价也很明确:在 OpenCode 中,K3 的体感速度会比轻量模型慢,原因正是这部分推理开销。当延迟比推理深度更重要时,建议换用其他模型。
Kimi K3 对比 Kimi K2.7 Code:什么时候便宜的更合适
K3 的价格大约是 Kimi K2.7 Code 的三倍,关键在于这份溢价何时值得付。
为验证较便宜的选择,我在 2026-07-20 通过 API 调用 K2.7 Code,完成一个小任务:编写 Python merge_intervals 函数并分析复杂度。它在 10.7 秒内给出了正确且符合 Python 习惯的代码:先排序,再线性合并,时间复杂度 O(n log n),空间复杂度 O(n);共使用 52 个 prompt token 和 341 个 completion token。对于修 Bug、小函数开发、测试脚手架等日常编程任务,这已经足够覆盖大多数需求,token 账单也只是 K3 的一小部分。
K3 更适合发挥在它真正擅长的场景:用满其 100 万 token 窗口的长上下文任务、棘手的多文件推理,以及轻量模型反复失败的问题。如果你要选的是日常主力模型,而非专攻重任务的模型,K2.7 Code 与 GLM 5.2 的正面对比值得参考。
直连 API、OpenRouter 和订阅:如何降低成本
选择怎样的 K3 调用路径,会同时影响稳定性与成本。
直连 Kimi API。 直接接入 Kimi Open Platform 是最可靠的方案。OpenRouter 上的 K3 由单一提供商承载,负载较高时可能频繁返回 429 限流错误;直连可以避开这个瓶颈。
OpenCode Go 订阅。 月订阅方案价格约为 $10–19,可将 K3 变成一个按固定价格使用的“第二资源池”:当主力模型卡住时再调用它。已有多位用户这样使用——当 Claude 会话在任务中途被打断时,把它当作备选,而不是全职主力。
API 网关。 如果你已经通过一个 Key 路由多个模型,兼容 Anthropic 和 OpenAI 的网关,例如 AIReiter,可以让你以按量付费的方式将 K3 与其他模型一同调用,并保留能够压低单次会话成本的缓存机制。在决定调用路径前,可查看 Kimi K3 定价拆解,对比具体的每 token 成本。
在 OpenCode 里用 Kimi K3 值不值得?
有两类用户需要谨慎决定。如果你运行的是高频、低成本的 Agent 循环,K2.7 Code 或更轻量的模型能以几乎不损失质量的代价节省开支。如果你需要即时响应,K3 的 max 强度推理会显得偏慢,除非你主动降低 variant。
对其他人而言,答案是肯定的。它拥有榜单领先的能力、100 万 token 上下文,三条命令即可配置完成,真实单次会话成本不到 $2;如果你正想摆脱会在任务中途卡住的助手,它也提供了完全可控的选择。
常见问题
在 OpenCode 中使用 Kimi K3 免费吗?
不免费。K3 按量计费,Kimi Open Platform 账户必须有余额;新用户代金券不能用于它。OpenCode 本身免费且开源,你只需支付 K3 的 token 费用。
Kimi K3 每百万 token 多少钱?
公开价格为每百万输入 token $3、每百万输出 token $15。实际支付成本会低得多:缓存命中每百万 token 仅 $0.30,而 OpenCode 的真实会话凭借 93% 的缓存命中率,平均每次只需 $1.79。
Kimi K3 是开源的吗?
它是开放权重模型。Moonshot 将在 2026 年 7 月 27 日前发布完整模型权重,使其成为首个 3 万亿参数级别的开放模型。不过,托管 API 仍然收费。
Kimi K3 的编程能力能和 Claude 相比吗?
在 Arena 的编程排行榜上,K3 目前位居榜首;在 Artificial Analysis Intelligence Index 中得分为 57,在 187 个模型中排名第 4。实际使用中,面对高难度编程任务,它能与前沿闭源模型竞争,公开定价也处于相近水平。
为什么使用 Kimi K3 时会遇到 429 错误?
频繁的 429 通常来自经由 OpenRouter 路由 K3:该平台上的 K3 由单一提供商承载。通过 OpenCode 内置认证直接连接 Kimi Open Platform,可以避开这一限制。