 AIREITER
咖啡店選單上只有四個價格,看似簡單,直到模型把其中一個數字改掉才知道麻煩。MOSS Image 的文字正確率以它的模型規模來說相當出色,但前提是你得提供足夠的結構,並像設計師一樣逐項校稿。
這次評測要驗證的,正是這個取捨:MOSS Image 是採 Apache 2.0 授權、擁有 5B 參數的文字生圖模型,最多接受 4,096 token prompt,也能選用 JSON 邊界框指定文字與物件的位置。OpenMOSS 團隊在 October 16, 2026 發布 Base 與 SFT checkpoint,MOSI 平台的託管 API 則在 October 20 上線。如果你的工作是製作海報、選單、標籤或需要精準文案的資訊圖,它值得測試;但若你要的是角色一致性或相片編輯,仍應選擇封閉模型。
第一輪輸出就定調:文字留得住,畫面美感未必
MOSS Image 真正吸引人的地方是長篇、精確文字,而不是整體美學。官方 LongLongTextBench 測試顯示,整體 Mean-6 文字覆蓋率為 96.3;其中長英文為 97.1、長中文為 92.4,涵蓋 240 個任務,平均每項約 1,340 個字元。相比之下,GPT Image 2 為 99.0,Nano Banana Pro 為 96.6。不過這些數字來自廠商自行設計並執行的 benchmark,應視為待驗證的宣稱,而不是保證。
第二個值得看的數字是版面遵循能力。這篇 技術報告整理列出的 7Bench 邊界框測試結果為 0.88 mIoU 與 0.70 Layout AUC,約為 Ideogram 4 的兩倍;後者分別是 0.44 與 0.20,同一份報告中的 GPT Image 2 則只有 0.30 與 0.16。在 RealLayoutArena 的 61 項盲測任務中,涵蓋海報、資訊圖與 UI,加入 prompt enhancement 的完整 MOSS 系統拿下 1,698.70 Elo,僅次於 GPT Image 2 的 1,844.35;若所有生成器使用相同的增強 prompt,MOSS backbone 本身則排名第一。這些同樣是廠商測試,目前仍等待獨立複驗。
一組小型的控制測試,能更直觀地看出差異。mossimage.run 團隊以相同 prompt、同一個 1024x1024 畫布與相同 seed,分別讓 MOSS Image SFT 和 FLUX.1 dev 各生成一次;沒有挑選結果,失敗案例也保留在測試集裡。本次評測沒有重新測試 MOSI 託管服務的延遲;下表結果來自該團隊透過 fal endpoint 取得的第一次輸出,MOSI API 本身則是根據文件與免費期間的計費狀態進行評估:
| 測試 | Prompt 要求 | MOSS Image SFT 第一次輸出 | FLUX.1 dev 第一次輸出 |
|---|---|---|---|
| 咖啡店選單 | MORNING MENU,以及右側對齊的 Espresso 3.50、Flat White 4.20、Butter Croissant 3.80、Avocado Toast 8.50 | 四個品項與價格全部正確 | 版面清楚,但 3.80 變成了 3.60 |
| 蜂蜜標籤 | WILDFLOWER HONEY、Raw & Unfiltered、Net Wt. 12 oz (340 g),並沿著標籤曲線排列 | 三行文字全部正確 | 標題與重量正確,中間一行變成 Raw & Unfilterelrd |
| 雙語海報 | 周末市集 / WEEKEND MARKET、Sat 10:00–18:00、Riverside Park、Free entry / 免费入场 | 中英文資訊全部正確 | 構圖出色,但中文變成亂碼,10.00–178.00 也被改掉 |
MOSS 使用 50 steps 與 CFG 3,FLUX 則是 28 steps 與 guidance 3.5,兩者分別透過 fal-ai/moss-image 和 fal-ai/flux/dev 執行。正如該頁面所說,三個案例不足以判定誰是贏家;但失敗模式才是重點:一張看起來很像真的圖片,如果價格或時間被改掉,反而比明顯生成失敗更危險。
「以 5B 模型來說,MOSS Image 對結構化版面與英文文字的處理相當好。不是每個小細節都完美,但整個工作流程終於有了可控感。」— @Olaemmy1200,分享完整海報製作流程影片
API 實際提供什麼:小型生成器,搭配大型閱讀器
MOSS Image 是一款從零訓練的單流 diffusion transformer,共有 42 層。5B 這個數字只計算生成器本身,旁邊還有負責讀取 prompt 的 frozen Qwen3.5-9B 文字編碼器,以及將結果轉成像素的 FLUX.2 small-decoder VAE。這種拆分同時解釋了它的優勢與硬體成本:雙語長文理解能力來自 9B 閱讀器,而不是 5B denoiser。
實際使用上,context window 才是它的關鍵優勢。自然語言、tag 序列與 JSON 版面配置共用最多 4,096 token,足以逐行寫出整張海報的內容,不必把文案壓縮成一句短 caption。MOSI API 文件則將託管服務的限制描述為最多 4,000 個字元的長文字,並支援文字呈現、negative prompt 與版面生成。建議輸出尺寸落在 1–2 megapixel,可從 512x512 延伸至 2K,且寬高都必須能被 16 整除。
兩個 checkpoint 會直接影響生成結果:
- MOSS-Image-SFT 是在 Base 上以精選資料進行 supervised fine-tuning 的版本。OpenMOSS 團隊建議直接生成時使用它,因為文字群組更整齊、版面也更乾淨。託管 API 預設提供
moss-image-sft-1.0,另有固定快照moss-image-sft-1.0-2026-10-09可用於重現結果。 - MOSS-Image-Base 略過 post-training 與 CFG distillation,保留原始訓練訊號。官方指南建議要進行 fine-tuning 的使用者選它,並建議凍結文字編碼器。若要訓練 LoRA 或嘗試不同的風格分布,Base 才是合適選擇;如果今天就要做一張海報,則應該用 SFT。
根據 Hugging Face model card 與官方專案頁面,兩個權重與隨附的 inference code 都採 Apache License 2.0。這代表你可以商用與微調,但不代表你為行銷活動生成的每個角色、標誌或人物肖像都已取得相應權利;商業專案應保留授權檔案與確切 revision。程式碼則放在 OpenMOSS GitHub repository。
願意適應流程,理由就在 JSON 版面控制
自然語言當然可以用,但真正讓設計師想測試這個模型的,是它的版面語法。結構化 prompt 先描述整體場景,再為每個文字或物件項目指定獨立 caption 與邊界框。邊界框能引導生成,但不是向量圖層,也無法保證像素級精準。
第一次使用時,最容易踩雷的是座標規則。當 bbox_coord_space: "abs_centralized" 搭配 bbox_format: "yxyx" 使用時,每個框的格式是以畫布中心為基準、以像素表示的 [y_min, x_min, y_max, x_max]。在 1024x1024 圖片中,每個軸的範圍是 -512 到 +512。不要直接把一般左上角原點座標,或社群常見的 0–1000 版面數值貼進這個 schema,必須先轉換。
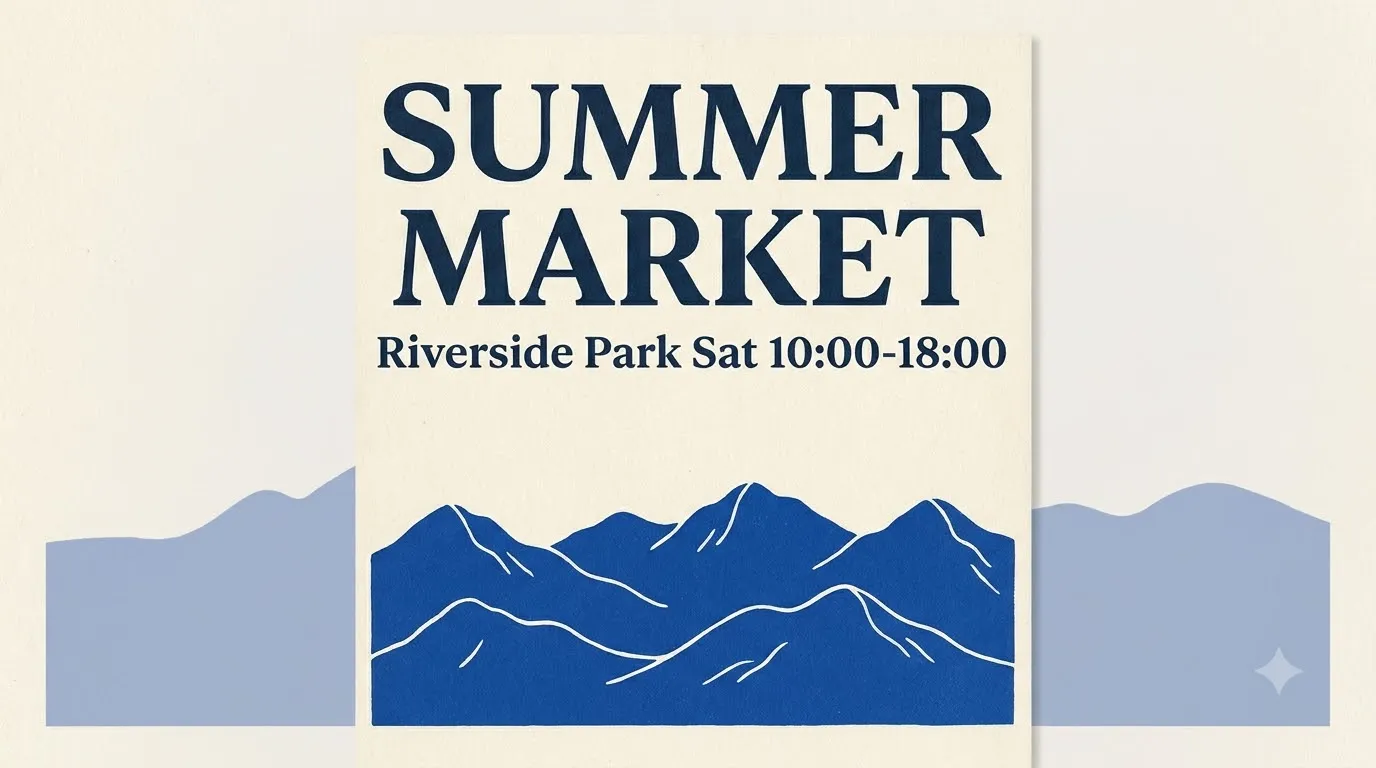
最基本的結構如下:標題在上方,插圖在下方:
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
如果是有 20 個元素的資訊圖,沒有人會想手動輸入這些框。早期使用者採用的實際流程,是先讓具備視覺能力的 LLM 根據 brief 或草圖產生 JSON,再在生成前修正座標。日本測試者 @chimolog7 直言,bbox 格式對人類來說太難,因此他先用 Opus 生成;之後發現日文呈現的主觀錯字率幾乎只有 1%,而 Krea 2 仍經常拼錯(貼文)。
第二個實用技巧是控制式重新生成。由於 MOSS Image 只支援文字生圖,不能輸入參考圖片,所以你無法把照片丟進 img2img 並保留下來。但你可以只修改某一個框的文字或位置,維持相同 seed 後重新生成,其他版面通常能大致維持不變。使用者 @li9292 曾用這個方法製作包含數千個中文字與 20 個框的週報封面,只修改單一框並沿用同一個 seed,其餘版面仍保持原樣(貼文)。對精確文案工作來說,這種「單框修改+相同 seed」的迴圈,比任何風格預設都重要。
如果想了解更廣泛的文字生成背景,我們的 2026 年文字呈現最佳影像模型測試,正好說明了為什麼這個領域需要以版面為優先的選項。
怎麼呼叫,以及免費到底能省多少
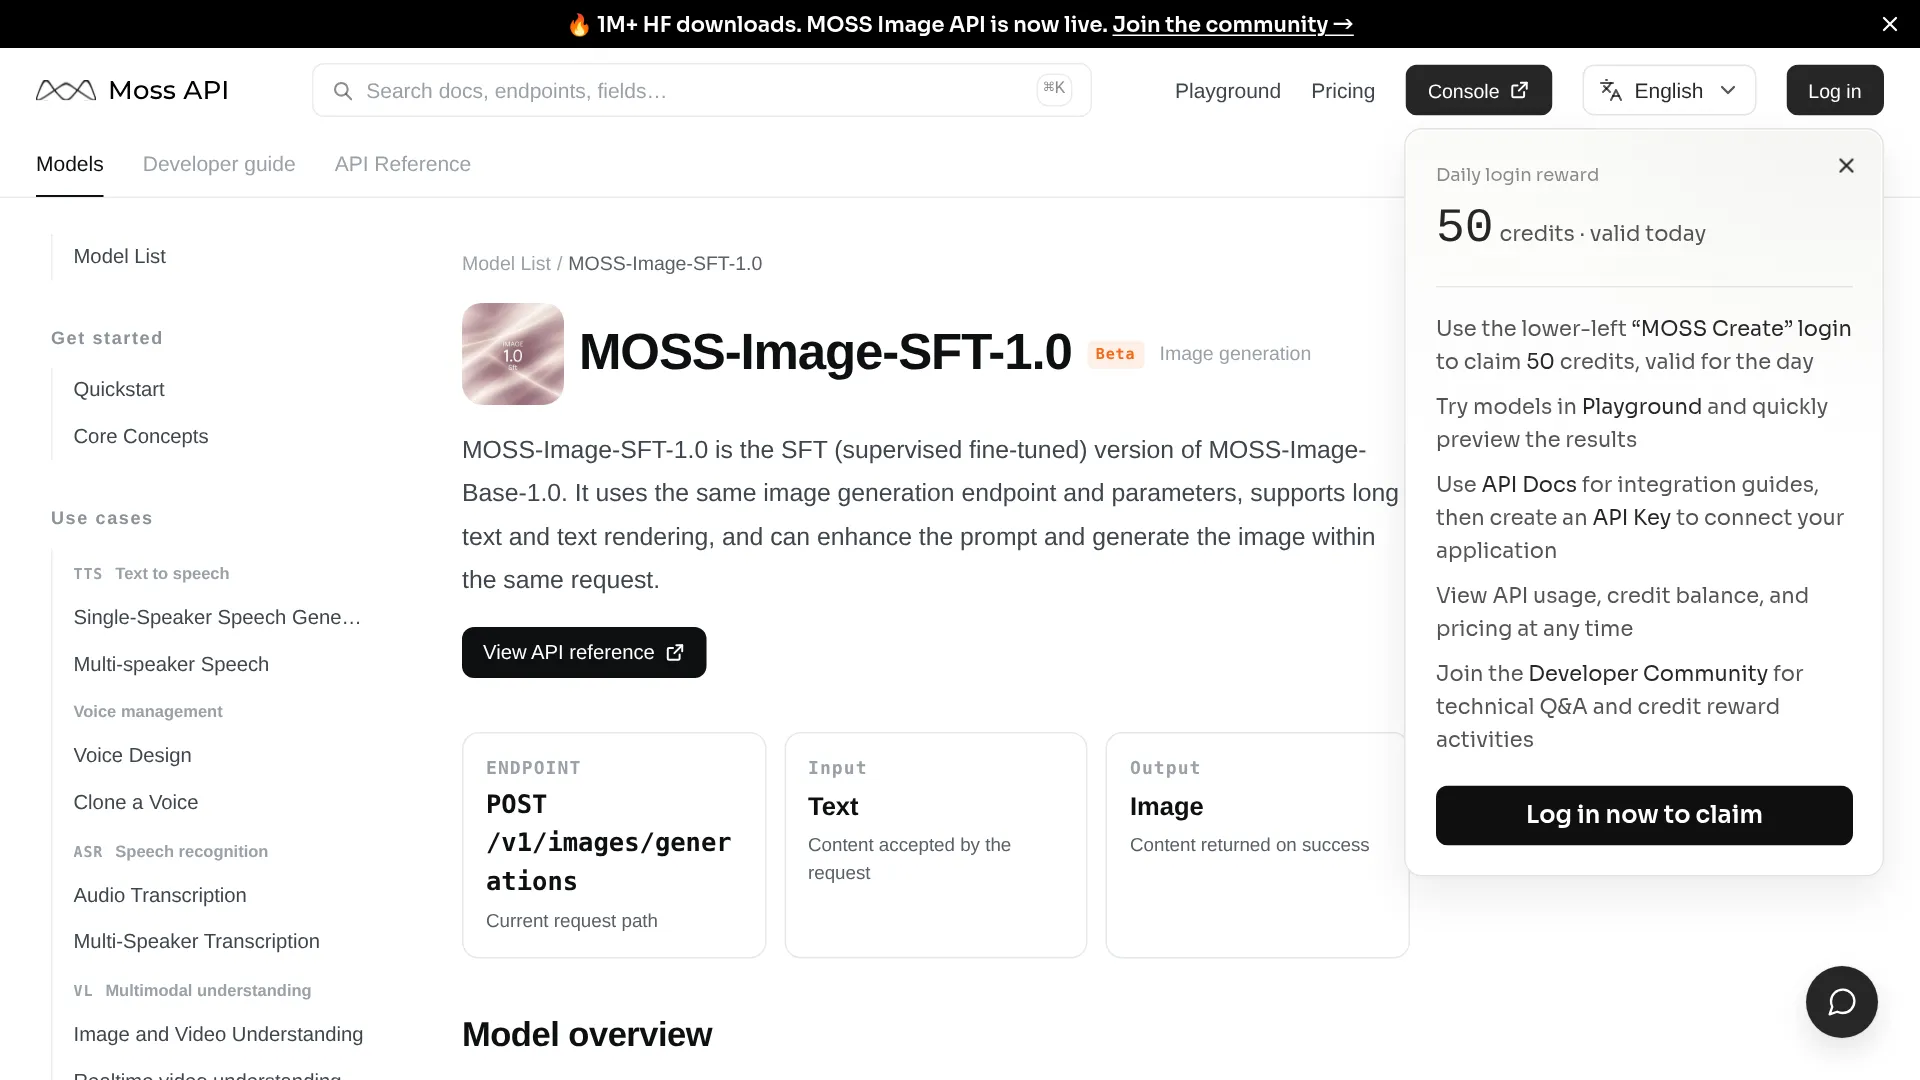
託管服務只有一個 endpoint。MOSI API 文件列出用於 moss-image-sft-1.0 的 POST /v1/images/generations,輸入只有文字,輸出只有圖片;不支援圖片輸入、音訊或影片,也沒有 streaming 或 async task API。Prompt enhancement 已內建但預設關閉,可透過 prompt_enhance: true 啟用,增強器版本則由伺服器端選擇。
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
需要逐框控制時,把完整的 JSON 版面字串放進 prompt;上面的自然語言格式則是最簡單、最適合直接複製使用的呼叫方式。
截至查詢時,計費狀態是 Free for a limited time,價格為 0 credits,並附有完整定價連結供日後查閱。Base 與 SFT 指南也提到相同情況:playground 自 October 20 起上線,但尚未公布長期的單張圖片價格。預算規劃要留有餘地——可以利用免費期間做原型,之後則要把供應商費率與錯字重做率一併算進去。
本機推論雖然沒有每張圖片的費用,但硬體成本很實在。October 20 查閱的 Comfy-Org 檔案列表顯示,光是 BF16 權重就約 29.72 GB,還不包括環境與 cache:backbone 約 10.16 GB、文字編碼器約 19.31 GB、small VAE 約 0.25 GB。INT8 ConvRot 能大致將 transformer 的容量需求砍半,backbone 約 5.41 GB、encoder 約 9.75 GB;另有 W4A8 GPTQ encoder 選項,約需 7.34 GB。
| 配置 | 需要下載的內容 | 實際使用備註 |
|---|---|---|
| 完整 BF16 | 29.72 GB 權重+工作記憶體 | 即使有 32 GB,也很容易在沒有 offload 的情況下卡住;系統 RAM 與 prompt 長度都會影響結果 |
| INT8 量化 | 約 15 GB 等級+offload | 文件記載的 12 GB 路徑可在約 1 MP、每批一張圖片下運作(本文引用的社群測試約 9.7 GB 峰值);8–12 GB 顯示卡可從這裡開始 |
| 社群 8-step DMD / 4-step | Adapter+相應 workflow | 同一份 1 MP RTX 3060 報告中,約 24 秒對比約 137 秒;但早期 adapter 會犧牲細節,應先建立 50-step 基準 |
官方採樣基準是在 1024x1024 下使用 Euler、50 steps、CFG 3.0、shift 5.0,並在第 22 層啟用 skip-layer guidance。原生 ComfyUI 支援已於 October 16 合併(公告在此);更新 ComfyUI 後,在模板中搜尋 MOSS-Image,並使用與 Base 或 SFT 對應的 workflow 及 Comfy-Org 檔案,不要把 plugin graph 與 native loader 混搭。
如果你想更廣泛地估算供應商成本,我們的最便宜影像生成 API整理,能提供 GPU 時間與重做成本的參考基準。
封閉模型仍然勝出的地方
在把作品交給這套工具鏈之前,幾個限制必須先看清楚。這個版本只支援文字生圖,不支援圖片編輯或參考圖片輸入;以參考圖為基礎的生成仍列在未來工作項目中。如果你需要保留上傳的照片,或讓角色在多個鏡頭中維持一致,應改用原生支援編輯的模型,例如用於生產編輯流程的 Qwen Image 2.1。
人物與審美表現是第二個差距。5B 規模下,臉孔可能顯得制式,比例會漂移,手部也會重複常見問題。
「它在人物比例方面也不太行,常見的『手部崩壞』和類似問題也處理得不算好。」— @SlipperyGem
引用的實測也支持在發布前逐項檢查:短 prompt、指定角色、藝術家 tag 與精確限制條件都不夠穩定;小字需要人工校稿,英文與中文 benchmark 以外的語言也必須自行確認。官方 50-step 設定對中階硬體來說負擔不小,而快速 adapter 則以光影細節與遵循限制條件換取速度。每張保留的結果都應記錄 checkpoint、encoder、VAE、precision、prompt、seed,以及包含編碼在內的總耗時。
從硬體角度看,追求速度的本機服務也得到類似結論。Lucebox 測得 Radeon AI PRO R9700 搭配自家 kernel,在 8 steps、CFG 1 下生成 1024x1024 圖片只需 2.7 秒,比相同設定下 DGX Spark 的 ComfyUI 端到端快 1.8 倍;但他們自行目測後發現,CFG 1 的 8 個輸出中有 4 個變形,CFG 2.5 則只有 8 個中的 1 個,代價是耗時增加到 5.2 秒。更快不代表一定更實用。
MOSS Image API 常見問題
MOSS Image 可以免費商用嗎?
權重與隨附程式碼採 Apache 2.0 授權,允許商業使用與微調,不需支付授權費。託管 endpoint 會自行制定價格與內容規範,第三方量化版本或 LoRA 也各自有其授權條款。
Base 與 SFT,API 應該用哪個?
託管 API 提供的是 SFT(moss-image-sft-1.0),也就是團隊建議用於生成的微調 checkpoint。現在要做海報與資訊圖,下載 SFT 即可;如果要進行微調或訓練 LoRA,則下載 Base。
它能在 12 GB VRAM 上運作嗎?
有文件記載的 12 GB 配置可以運作,但需要使用量化 workflow,搭配 CPU offloading,在約 1 MP 與每批一張圖片的條件下執行。
它能編輯照片,或讓角色完全一致嗎?
不能。公開的 backbone 不接受參考圖片作為條件。重新使用 seed 並修改 JSON 指引,可以進行受控重生成,但無法保留上傳的照片,也不能保證角色身份一致。
哪些人現在就該試 MOSS Image
| 你的工作 | 適合使用 MOSS Image 的情況 | 應該改用其他工具的情況 |
|---|---|---|
| 需要精確文案的海報、選單、投影片或 UI mockup | 雙語長文字與逐框版面配置,比寫實人物更重要 | 只有一行標語——封閉模型更容易下 prompt,也更快 |
| 電商或編輯內容 pipeline | 可以加入 LLM 轉 JSON 的步驟與校稿流程,並希望使用能自行託管或微調的 Apache 2.0 權重 | 今天就需要 img2img、inpainting 或鎖定參考角色 |
| 預算有限的本機開發者 | 可以接受 12 GB 加量化,或 MOSI 的免費期間足以支撐你的原型 | 需要保證吞吐量、streaming 或 async task——託管 API 目前都不提供 |
對於需要指定版面的文字密集型設計工作,MOSS Image 是少數真正把限制系統當成核心產品的開源模型。如果工作需要一張臉在不同畫面中始終是同一張臉,請把它當成封閉影像模型旁邊的排版工具,而不是替代品。