 AIREITER
若重視語氣與品牌感,選 Claude Sonnet 5;大量翻譯需求則選 DeepSeek V4 Flash,每 1,000 次任務約只要 $0.10;追求整體速度,GPT-5.6 Terra 是最穩妥的全方位選擇。這是我們在 2026 年 7 月 17 日實測六款模型後的結論。
我們用完全相同的三組翻譯提示詞呼叫各模型 API,直接比對原始輸出。令人意外的不是品質:六款模型都能正確翻譯德文技術內容,其中五款更是在日文對話的主詞省略情境中零失誤。真正拉開差距的是成本:兩款看似便宜的模型,每次請求卻消耗大量推理 token,結果單次翻譯成本比 Claude 高出 8~10 倍,幾乎逼近 DeepL 按字元計費的價格。
到了 2026 年,挑選翻譯用 LLM 的關鍵已不在於「它能不能翻」——它們全都能——而是能否在不悄悄拉高帳單的前提下,符合你的內容類型與處理量。
不同翻譯工作,該選哪一款模型?
| 你的工作負載 | 建議選擇 | 原因 | 實測每 1,000 次任務成本 |
|---|---|---|---|
| 行銷文案、品牌語氣 | Claude Sonnet 5 | 讀起來像以目標語言原生寫成,而非翻譯腔 | ~$1.06 |
| 大量處理:商品資料、文件、字幕 | DeepSeek V4 Flash | 三項測試全數正確,成本遠低於其他選項 | ~$0.10 |
| 混合型工作負載、最低延遲 | GPT-5.6 Terra | 回應時間 3.0~4.3 秒,格式處理最乾淨 | ~$0.88 |
| 術語表強制套用、CAT 工具流程 | DeepL | 內建術語庫與整合功能,是 LLM API 尚未提供的能力 | 每 1M 字元 $27.50 |
以上成本為三項測試的平均值,以輸出 token × 2026 年 7 月官方費率計算,再推估為 1,000 次短篇翻譯;完整測量數據見下表。有一類情境不在本次測試範圍內:即時語音對話。Google 提供專用的 Gemini 3.5 Live Translate 版本,價格為每百萬 token $3.50/$21;本文會提及,但未納入實測。
測試方法與條件
我們在 2026 年 7 月 17 日,以相同文字、每題各執行一次,測試三組提示詞與六款模型:英譯日行銷文案,測試語氣;英譯德 API 文件,測試術語;以及日譯英日常對話,測試主詞省略與上下文理解——這正是 CJK 語言組合的經典失誤點。CJK 指的是中文、日文與韓文,也是機器翻譯品質抱怨特別集中的三種語言。
參測模型包括 GPT-5.6 Terra、Claude Sonnet 5、DeepSeek V4 Flash、DeepSeek V4 Pro、GLM-5.2 與 Kimi K2.6。所有呼叫皆經由同一個 gateway 帳號,以預設設定執行。因此延遲數字可供模型間橫向比較,但實際結果仍會隨所在地區與供應商負載而變動。
以下列出三段原文,方便你自行重跑測試:
EN→JA(行銷):「更快把你的想法化為成果。我們的平台接手繁瑣雜務,讓團隊專注於真正重要的事。」 EN→DE(技術):「若請求超出速率限制,API 會回傳 429 狀態碼。請以指數退避方式重試,並遵守 Retry-After 標頭。冪等鍵可在重試成功時避免重複收費。」 JA→EN(對話):「昨天那件事,你已經跟部長說了?」「不,還沒。我打算看時機再說,但大概會被罵吧。」「最好先去鋪陳一下。我們部長最討厭最後才被告知。」
以下是各模型與各任務的全部測量結果,延遲為實際經過秒數,token 數取自 usage 物件中的輸出 token:
| 模型 | EN→JA | EN→DE | JA→EN | 平均單次任務成本 |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0s / 46 | 4.3s / 67 | 3.2s / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5s / 60 | 4.0s / 146 | 3.5s / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2s / 421 | 4.3s / 371 | 4.7s / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5s / 769 | 18.0s / 989 | 19.6s / 946 | $0.00078 |
| GLM-5.2 | 30.8s / 1,906 | 29.0s / 1,590 | 35.2s / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6s / 2,849 | 48.5s / 2,235 | 23.6s / 2,413 | $0.01000 |
單次任務成本 = 輸出 token × 供應商官方輸出價格。每題輸入約為 60~110 token,即使套用 GPT-5.6 Terra 費率,增加的成本也低於 $0.0003;後文的每百萬字元圖表則已納入輸入成本。所有價格均為 2026 年 7 月 17 日的官方牌價,不是我們帳號實際取得的折扣費率。
三題的抽樣測試無法替 100 種語言組合排名,我們也沒有這樣宣稱。不過,即便是小樣本,仍足以看出持續存在的差異,而這次的差距相當明顯。
測試一:英譯日行銷文案
提示詞要求將這句 SaaS 登陸頁文案自然、禮貌地改寫為日文:「更快把你的想法化為成果。我們的平台接手繁瑣雜務,讓團隊專注於真正重要的事。」
Claude Sonnet 5 寫出的文案是:
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
這就是日本文案寫手會採用的語域:以片假名書寫的「カタチ」以及逗號切分的節奏,都是登陸頁常見的表現手法,不是教科書式文法。GPT-5.6 Terra 與 DeepSeek V4 Pro 緊追在後,也給出乾淨、商務感明確的譯文,例如「アイデアを、より迅速に形に。」
DeepSeek V4 Flash 是六款中最直譯的一款:「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」文法沒有問題,但一看就有翻譯感。若要放上產品頁,建議再由人工潤飾;用於支援文章或內部文件則已相當足夠。
這裡的差異確實存在,但幅度不大:六款模型都能產出可用的日文。只有品牌語氣工作,Claude 每 1,000 次任務多約 $1 的成本才特別值得;本次其他測試中,這個優勢沒有如此關鍵。
測試二:英譯德技術文件
我們翻譯了兩句 API 文件,內容包含速率限制、HTTP 429、指數退避與冪等鍵。六款模型的技術術語全數正確,也都採用了自然的德文文件慣例,例如 Ratenlimit、Statuscode 429、exponentielles Backoff、Idempotenzschlüssel。
唯一看得出的差異是:GPT-5.6 Terra 將 Retry-After 加上程式碼格式,符合真實德文 API 文件排版標頭名稱的方式。這是貼心細節,而不是品質落差。
針對資源充足的歐洲語言之間的一般技術文件,本次樣本沒有任何模型出錯;在這一代模型中,品質差異小到難以觀察。若這就是你的主要工作負載,請依價格與速度選擇,而不是品質。以每百萬 token 輸入 $0.14、輸出 $0.28 計算,DeepSeek V4 Flash 因而成為預設答案。
測試三:主詞省略的日譯英對話
日文經常省略句子主詞,譯者必須從上下文推斷誰做了什麼。本次對話也包含「根回し」(nemawashi),意指在正式決策前私下建立共識,是沒有直接英文對應詞的文化脈絡用語。
六款模型中有五款都處理正確。主詞指涉無誤,nemawashi 也被譯為「lay the groundwork」、「sound him out beforehand」或「give him a heads-up」,都是站得住腳的選擇。Claude 的版本最像母語對話,例如「he's probably gonna chew me out」。
18 份輸出中唯一真正的錯誤來自 DeepSeek V4 Pro。它將建議下一步做法的「先に根回ししといたほうがいい」,譯成了「You should've laid the groundwork first」——這成了對已錯失行動的過去式遺憾。只差幾個字,意思卻剛好相反;同事說的是前一句,而你聽成後一句,接下來的行動就會不同。
一次執行出現一個時態錯誤,只是一筆資料,不足以為模型下定論;我們在 DeepSeek V4 Flash vs Pro comparison 中,會更深入比較兩個 DeepSeek 版本。但這也是很好的提醒:流暢與忠實是兩回事。這句英文讀起來完全自然,意思卻錯了。合約、醫療內容,或任何誤讀時態會造成金錢損失的內容,無論選哪款模型,都應編列人工審校。
token 消耗陷阱:為何牌價表會誤導人
這是會改變採購決策的發現。以每百萬輸出 token 計算,GLM-5.2 為 $4.40、Kimi K2.6 為 $4.00,連 Claude Sonnet 5 每百萬 token $10 的一半都不到;但換算成實際完成一次翻譯的成本,兩者卻高出 8~10 倍。
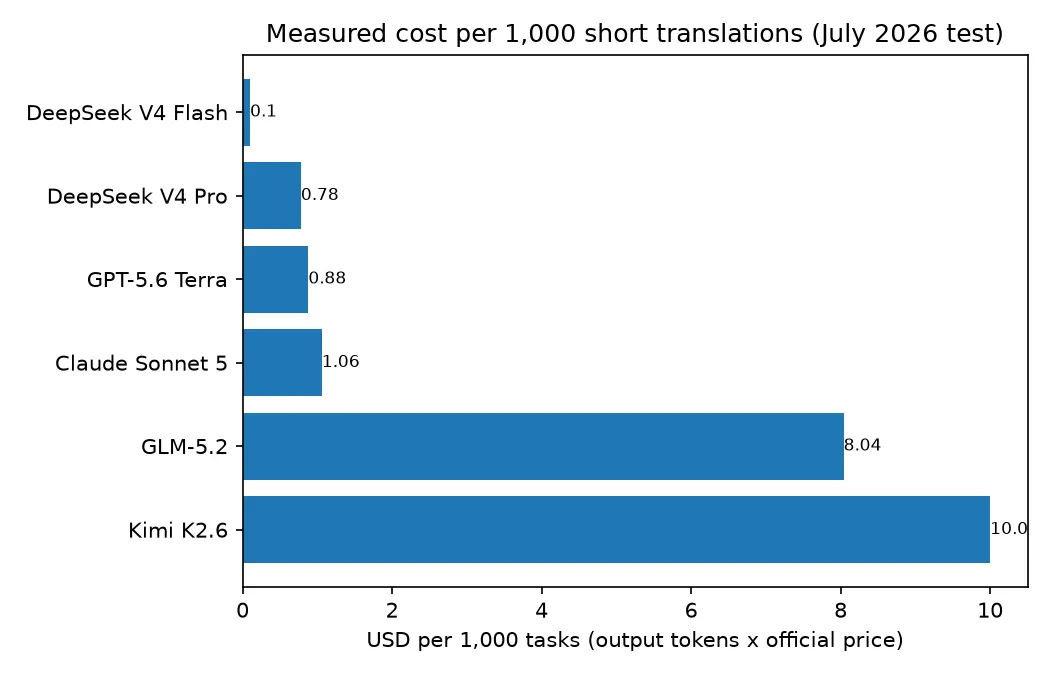
原因在於這兩款模型都會在回答前執行可見的推理鏈,而推理 token 也會按輸出 token 計費。翻譯一句行銷文案時,Kimi K2.6 輸出了 2,849 個 token,GLM-5.2 輸出 1,906 個 token,但最終譯文其實只有 40~60 個 token。Claude Sonnet 5 在同一任務花了 60 個 token;GPT-5.6 Terra 則是 46 個。
延遲也呈現相同模式。GPT-5.6 Terra 與 Claude Sonnet 5 在三項任務中皆於 3~4 秒內回覆;DeepSeek V4 Flash 需時 4~5 秒,DeepSeek V4 Pro 為 16~20 秒,而 GLM-5.2 與 Kimi K2.6 每次請求介於 20 至 48 秒。
這帶來兩條實務原則。第一,翻譯這類短篇、高量任務,應以實測的單次任務成本比較模型,而非牌價;跑 20 次請求後查看 usage 欄位即可。第二,翻譯時請關閉或降低推理強度:DeepSeek 將思考與非思考端點分開,GLM 與 Kimi 則在請求主體中提供思考參數。三項測試裡,推理鏈沒有帶來任何可觀察到的輸出品質提升。
大量翻譯時,成本會差多少?
將實測 token 消耗放大到 100 萬個英文字元的來源文本,約等於 250,000 個 token,成本差距會更加驚人:
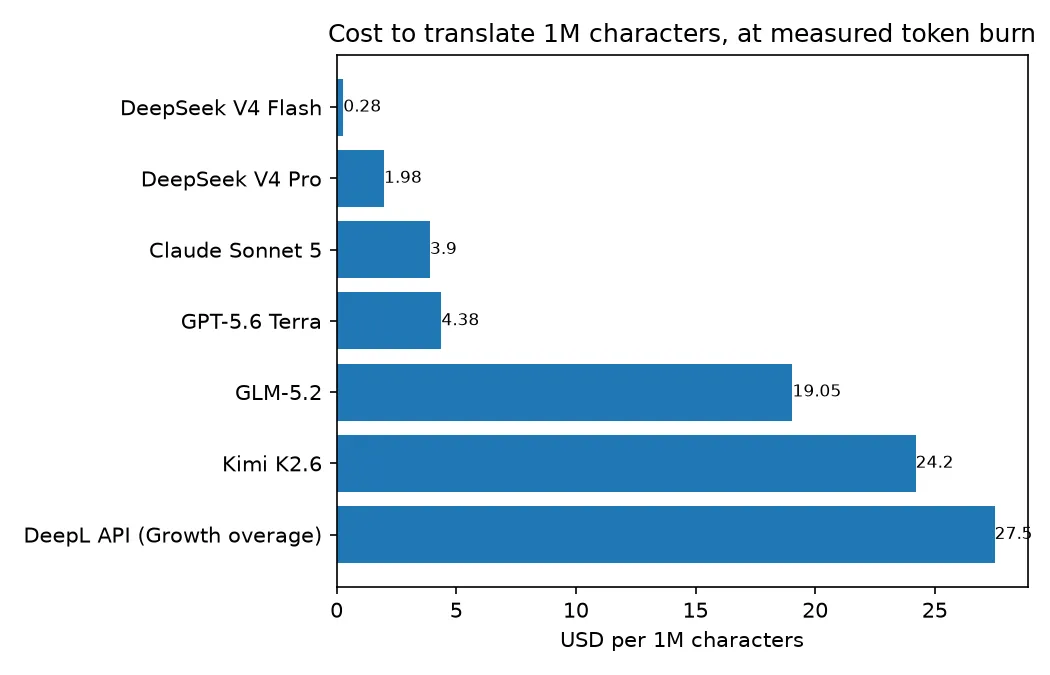
DeepSeek V4 Flash 翻譯相當於一本完整小說的文字量,約只需 $0.28。相同內容量若走 DeepL API,在 Growth 方案超額費率下需 $27.50,差距達 98 倍。這與廣泛流傳於 r/LocalLLaMA、題為 "LLMs are 800x cheaper for translation than DeepL" 的分析方向一致;該文使用規模更小的自架模型,因此得出更大的倍數。
也請注意圖表最上方:若看實測 token 消耗,重推理的開放權重模型幾乎快追上 DeepL 的成本。沒有 token 測量,單位價格根本不能當作成本估算。
以下三項定價資訊值得在導入前先掌握,均已於 2026 年 7 月 17 日確認:
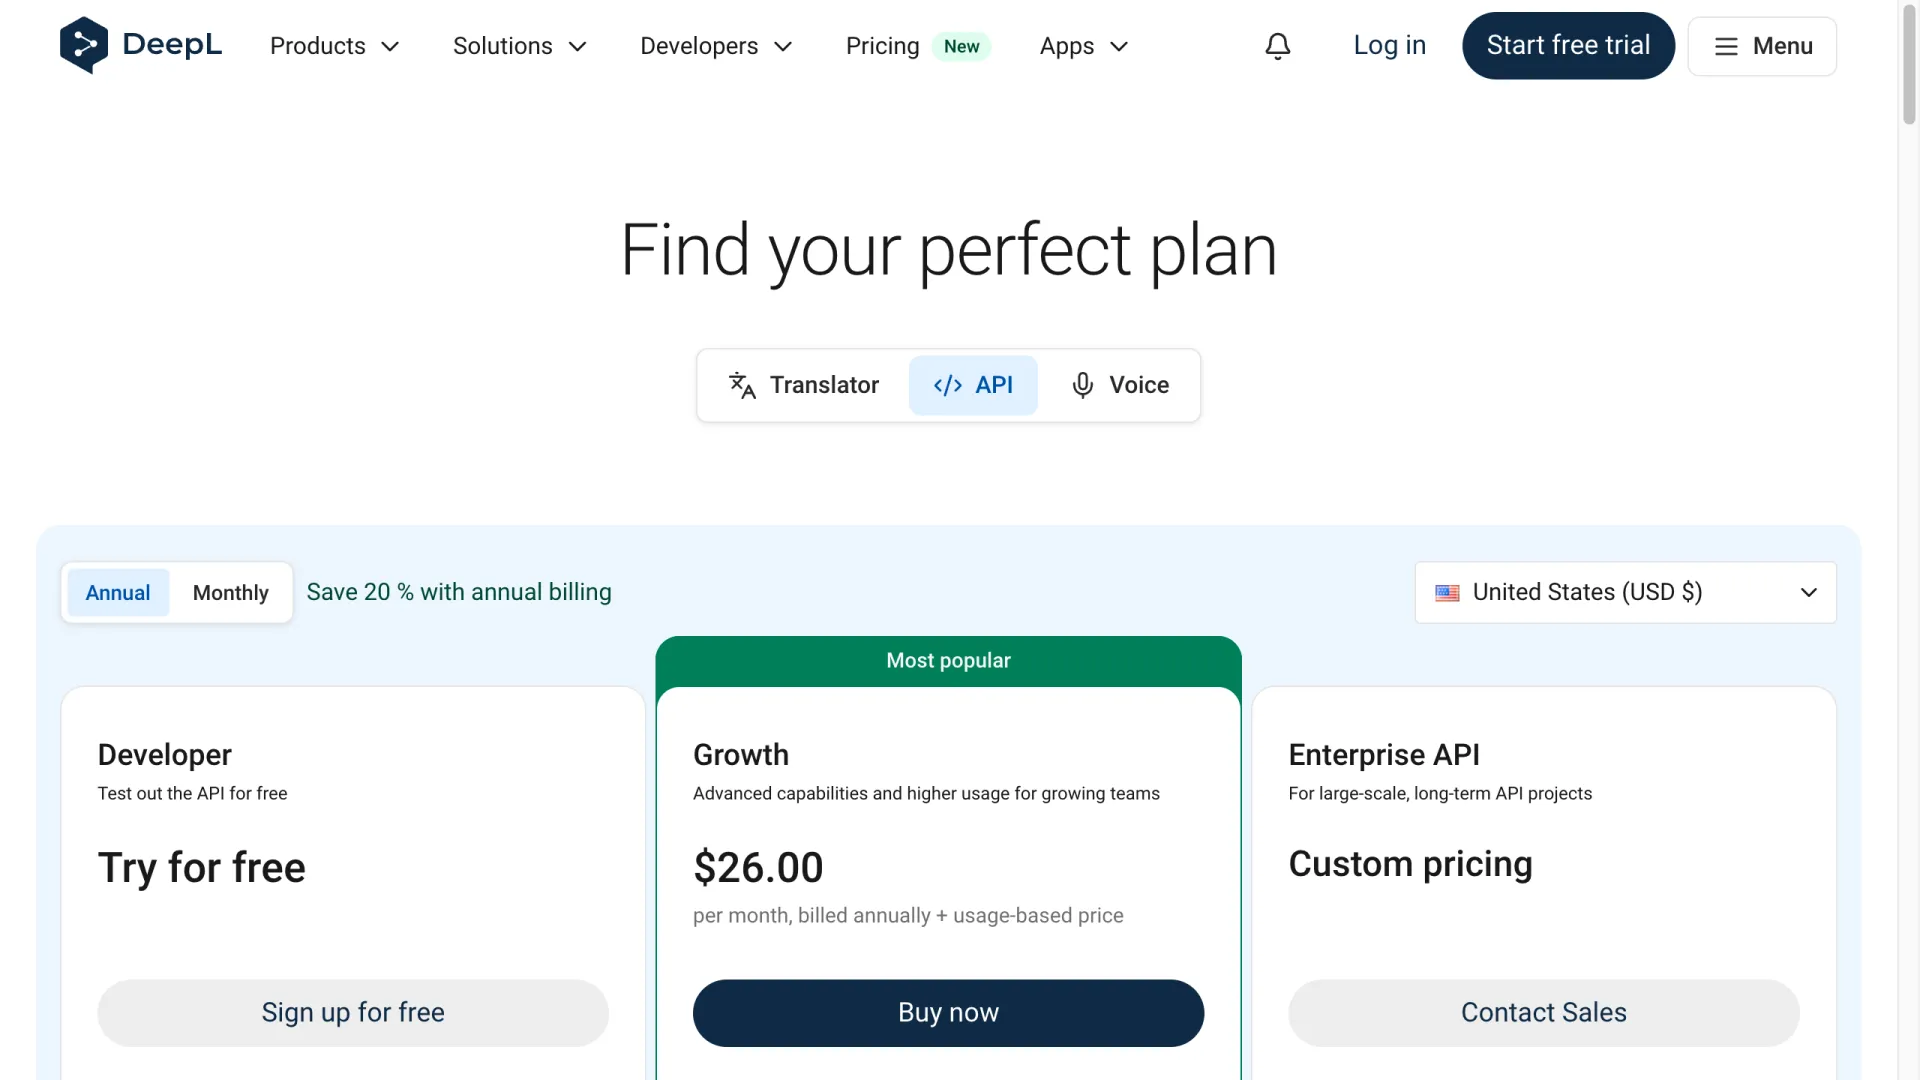
- DeepL 的免費方案改了。 API Developer 方案現在提供一次性的 1,000,000 字元額度,不再是你仍會在舊版文件與論壇回答中看到的每月 500,000 字元額度。Growth 方案每月 $26,按年計費,內含每年 12M 字元;超出後每增加 100 萬字元收費 $27.50。
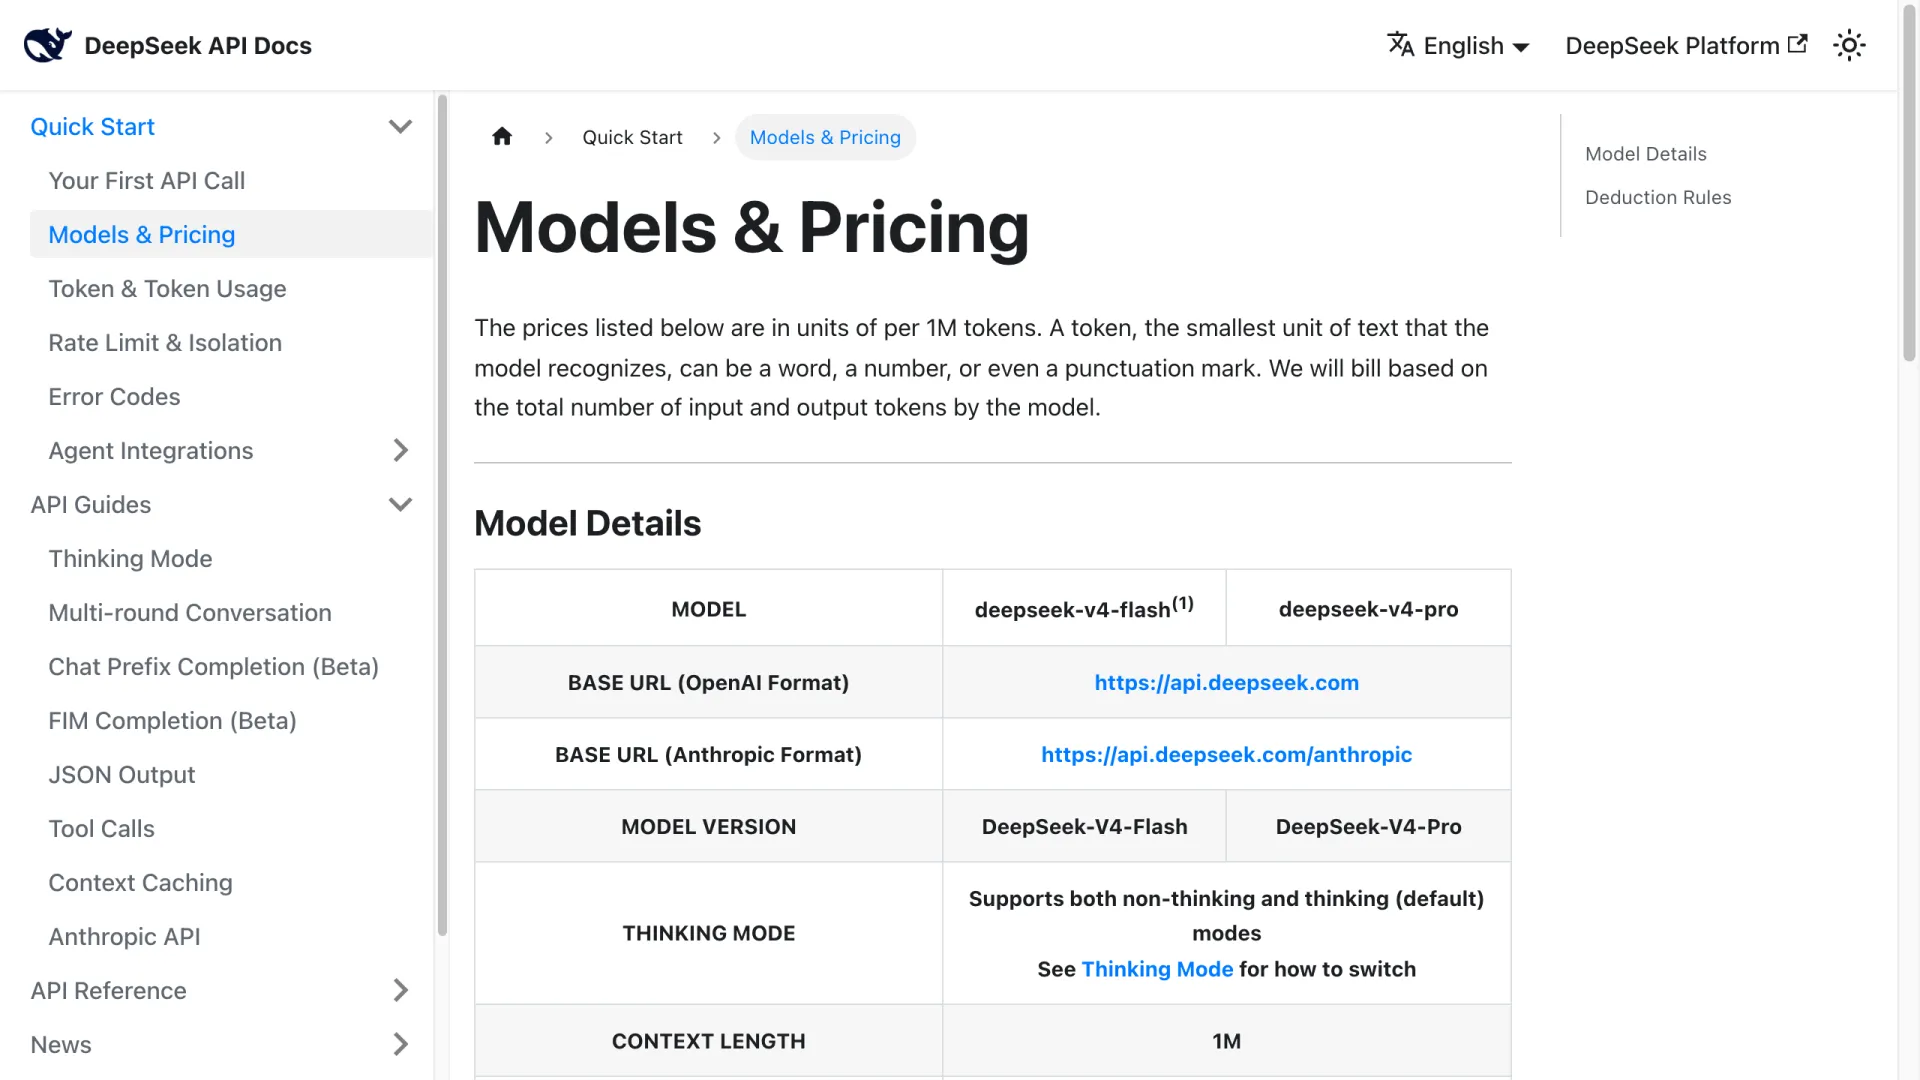
- DeepSeek 的計費遠低於其他家。V4 Flash 每百萬 token 輸入 $0.14、輸出 $0.28,快取命中時的輸入價格更降至 $0.0028。舊的 deepseek-chat 模型名稱將於 2026 年 7 月 24 日退役。
- Claude Sonnet 5 目前採上市優惠價。2026 年 8 月 31 日前,每百萬 token 為輸入 $2、輸出 $10,之後調整為 $3/$15。它的新 tokenizer 對相同文字也會產生約多 30% 的 token,而我們的成本計算已納入這點。若規畫使用到 9 月以後,兩項因素都必須納入預算。
- Batch API 可將帳單減半。OpenAI、Anthropic 與 Google 都為非同步批次處理提供約 50% 折扣。翻譯工作通常不太在意延遲,這幾乎是白拿的優惠:採用批次價格後,GPT-5.6 Terra 每百萬字元約為 $2.19,Claude Sonnet 5 約為 $1.95。
哪些情況 DeepL 或 Google Translate 仍更適合?
按字元成本來看,LLM 明顯占優;但有三種需求,答案仍偏向傳統翻譯服務:
- 強制套用術語。DeepL 提供術語表與術語庫,可保證同一術語每次都譯成相同結果。LLM 只能透過提示詞要求並自行驗證,這是機率性的行為,不是強制機制。
- CAT 工具與工作流程整合。如果你的翻譯記憶儲存在 CAT(電腦輔助翻譯)工具中,DeepL 的連接器可以直接整合。
- 大規模次秒級延遲。傳統神經機器翻譯引擎的回應通常快於通用 LLM;若是內嵌於 UI 的即時翻譯,這很重要。
即時語音則不適合交給傳統 NMT 或聊天型 LLM。Google 為專用的 Gemini 3.5 Live Translate 版本定價每百萬 token $3.50/$21,另有按音訊分鐘計費的費率;我們已在 Gemini 3.5 Live Translate breakdown 中說明。
罕見語言與低資源語言的情況,支援範圍比品質排名更優先:在比較其他任何項目之前,先確認你的語言組合是否受到支援。DeepL 支援約 30 種語言;大型 LLM 可處理超過一百種,但越接近長尾語言,品質下降越明顯。
開源與本機部署選項
GLM-5.2 與 Kimi K 系列都公開了開放權重,因此若自行部署,上述 token 消耗問題可被解決:你能控制取樣設定,並完全關閉推理鏈。
若要用單張 GPU 在本機翻譯,Qwen3-30B-A3B 是 r/LocalLLaMA threads on local translation models 中一再被推薦、適合歐洲語言譯為英文的選擇。隨著語言組合愈冷門,社群通常會建議改用更大的模型。選擇本機模型的主要理由,多半是隱私,例如合約或尚未發布的產品,以及零邊際成本,而非品質;同一批討論串中,託管的前沿模型仍被認為翻得更好。
另一個值得關注的新選項是:Kimi K3 本週以開放權重形式推出,託管價格為每百萬 token $3/$15。我們測試的是 K2.6,因為 K3 API 存取權當時仍在逐步開放;若 K3 延續 K 系列高 token 消耗的特性,同樣必須注意實測成本這項前提。
自己重做一次比較
要重現本文的比較,約 20 次 API 呼叫就夠了:從你的內容挑兩句話,送到每個候選模型,再從每份回應的 usage 物件讀取實際 token 數。這次 18 次請求的總成本不到 $0.15。
麻煩的地方在於,你得管理來自五個供應商的六把 API key。我們透過單一 AIReiter 帳號執行全部六款模型;它在一個相容 Anthropic 的端點後方轉售主流模型 API 存取權,Claude 系列 key 的價格約為牌價五分之一。也就是一把 key,所有上述模型使用相同的 wire format。
如果你的翻譯量確實很大,花一小時以自己的內容抽測,會勝過任何排名,包括這篇文章。各模型的品質已經十分接近,最終決策應由你的語言組合、語氣要求與實測 token 消耗來決定。
常見問題
ChatGPT 和 Gemini,哪個更適合翻譯?
在我們的測試中,GPT-5.6 Terra 在三項任務都很快、正確,且格式乾淨。我們沒有將 Gemini 納入正面對決,因為它不在使用的 gateway 中;不過其公開定價具有競爭力,3.5 Flash 為每百萬 token $1.50/$9,且它是唯一提供專用即時語音翻譯模型的供應商。
目前最準確的 AI 翻譯工具是什麼?
對於高資源語言組合,前沿模型之間的準確度差異很小;我們測試的六款模型都能零錯誤翻譯德文技術內容。差異主要集中在語氣,例如 Claude 在日文行銷文案表現最佳,以及主詞省略與時態等邊緣情境;DeepSeek V4 Pro 便出現了本次樣本唯一的實質錯誤。
最適合翻譯的開源 LLM 是哪一款?
GLM-5.2 與 Kimi K2.6 都公開了權重,且在本次測試中翻譯正確;自行託管可關閉令其 API 單次任務成本偏高的推理鏈。若使用消費級硬體,Qwen3-30B-A3B 是常見的社群推薦。
LLM 能取代人工譯者嗎?
內部文件、支援內容與大量商品文字:大致可以,視模型而定,按字元計費約為 DeepL 的 1~16%,DeepSeek V4 Flash 約 1%、Claude Sonnet 5 約 14%、GPT-5.6 Terra 約 16%。但合約、醫療文本與品牌行銷活動,測試三的時態錯誤就是最好的警訊。流暢的輸出仍可能顛倒原意,因此在誤讀代價高的地方,仍要保留人工審核。
2026 年 DeepL 還值得用嗎?
有三種情況值得:需要強制術語表、CAT 工具整合,以及次秒級延遲。除此之外,按字元計算的成本很難合理化;也請注意,免費方案現在是一次性的 1M 字元額度,不再是每月提供。