 AIREITER
Bulut faturası olmadan, yerelde çalışan bir Mac mini 38,5 saniyelik sesi 2,81 saniyede üretti. Zyphra'nın 9 Kasım 2026'da yayımladığı ZONOS3-Mini için öne çıkan iddia bu. Toplamda 800 milyon parametreli mixture-of-experts TTS modelinde her adımda yalnızca yaklaşık 100 milyon parametre aktif kalıyor. Ancak ilk kullanıcıların tekrar tekrar vurguladığı önemli bir nokta var: Demo güçlü donanımda ve İngilizce yapıldı. Kendi metniniz, diliniz ve GPU'nuz, bu performansa ne kadar yaklaşabileceğinizi belirleyecek.
ZONOS3-Mini nedir, nasıl çalıştırılır?
Zyphra imzalı ZONOS3-Mini, zero-shot ses klonlama yapabilen bir TTS modeli. Kısa bir referans kayıt ve metin verdiğinizde o sesle konuşabiliyor; isterseniz 27 hazır sesten birini seçip yaş, aksan ve ses dokusunu da değiştirebiliyorsunuz. Model ağırlıkları Apache 2.0, çalışma zamanı kodu ise MIT lisanslı. Bu nedenle yerelde ve ticari projelerde yeniden kullanıma izin veriliyor. Yalnızca sahibi olduğunuz ya da kullanmak için izin aldığınız sesleri klonlamalısınız.
Teknik tarafta model, 64 uzmanlı ve top-2 yönlendirmeli seyrek bir MoE mimarisi kullanıyor. 11 katman, Gated DeltaNet ile global attention'ın 3:1 karışımından oluşuyor. Yeni Zyphra Audio Codec 1 (ZAC-1), ZONOS2'deki 86 Hz DAC yerine saniyede 15 kareyle çalışıyor. Zyphra'ya göre bu değişiklik, saniyedeki konuşma token sayısını 774'ten 150'ye indiriyor ve eşleştirilmiş veri koşullarında DAC'e kıyasla yaklaşık 10 kat daha düşük kelime hata oranı sağlıyor.
Temel teknik özellikler şöyle: 44,1 kHz çıktı, 10 dakikaya kadar üretim, ham klon referanslarında en fazla 60 saniye ve embedding tabanlı klon referanslarında en fazla 120 saniye. Model, 112 NVIDIA H100 GPU üzerinde 2,5 gün eğitilmiş.
Çalıştırmak için beş seçenek var:
- Kurulum gerektirmeyen, WebGPU tabanlı tarayıcı playground'u
- CPU, CUDA, Metal veya Vulkan üzerinde çalışan native C++/ggml sürümü
- Apple MLX sunucusu
- NVIDIA sunucularında SGLang veya vLLM
- OpenAI uyumlu
/v1/audio/speechendpoint'i üzerinden,zyphra/zonos3-minimodeliyle sunulan Zyphra barındırmalı API
Üreticinin gecikme verileri, Pixel 9 tarayıcısında ilk sese kadar 570 ms'nin altında, M3 MacBook Air'de ise 150 ms'nin altında süre gösteriyor. SGLang ile tek H100 üzerinde medyan değer 57–80 ms; tepe aktarım hızı ise saniyede 457 ses saniyesine çıkabiliyor. Telefon ve dizüstü rakamlarını en iyi senaryo olarak değerlendirin. Zyphra'nın kendi tanıtım zincirinde aynı cihazlar için daha temkinli biçimde 800 ms'nin altı ve 450 ms'nin altı deniyordu. Bu yüzden herhangi bir söz vermeden önce kendi donanımınızda test yapın.
Tanıtım materyallerinde açıkta kalan iki nokta var. Teknik yazı toplam parametre sayısını 800M olarak verirken model sayfasında 886M yazıyor. Ayrıca yüklenen referans sesleri için filigranlama, kötüye kullanım önlemleri veya veri saklama politikası hakkında hiçbir açıklama bulunmuyor.
Kurulumdan önce tarayıcıda deneyin
Tarayıcı playground'u, WebGPU aracılığıyla çıkarımı kendi GPU'nuzda gerçekleştiriyor; sunucu ya da kurulum gerektirmiyor. Pek öne çıkarılmayan tarafı ise ilk ziyaret: ilk test kullanıcılarından biri, üretim başlamadan önce sayfanın yaklaşık 920 MB model ve codec indirdiğini bildirdi. Ardından dosyalar tarayıcı önbelleğine alınıyor.
Playground'u ücretsiz ilk deneme alanınız olarak kullanın. Klonlama ve span düzeyindeki kontrolleri deneyin, ardından en zayıf hedef cihazınızdaki gecikmeyi karşılaştırın. WebGPU davranışı tarayıcıya, sürücüye ve GPU'ya göre değişebiliyor.
"Küçük bir model tarayıcıda çalıştı diye her seferinde ‘bulut TTS öldü’ diye sevinmeyin! Tarayıcılar ve sürücüler arasındaki WebGPU uyumluluğu tuzaklarla dolu! İngilizce bir demonun iyi görünmesi, üretimdeki metninizin sorunsuz çalışacağı anlamına gelmez!" — @GKev1n, yalnızca demo verisine dayanarak barındırmalı TTS'i değiştirmemek gerektiğini söyleyen gerçek kullanıcı
Kullanıcılarınız eski telefonlar, entegre grafik birimleri veya Chromium dışı tarayıcılar kullanıyorsa Pixel 9 sonucunu test etmeden genellemeyin.
Transkriptsiz klonlama ve kelime düzeyinde yönlendirme
- Zero-shot klonlama: Transkript gerektirmeden en fazla 60 saniyelik referans ses kullanır. En doğal sonuç için ham kayıt modunu tercih edebilir veya daha sonra yeniden şekillendirebileceğiniz, tekrar kullanılabilir bir konuşmacı embedding'i oluşturabilirsiniz.
- Ses tasarımı: Yaş hedefleri, maskülen-feminen sunum ayarı, Amerikan, Britanya ve Avustralya aksanı yönlendirmesi; soft, raspy, bright ve deep gibi birbiriyle birleştirilebilen doku ayarları sunar.
- Konuşma biçimini yönlendirme: Hız, duygu, projeksiyon, canlılık, uyarılma ve fısıltı; kelime aralıklarına kadar kontrol edilebilir. Örneğin yalnızca "I didn't say" bölümünü fısıldatırken cümlenin kalanını nötr bırakabilirsiniz.
- Üretim sonrası düzenleme: VoiceCraft tarzı bir model, ses ve ayarları koruyarak üretimden sonra kelimeleri değiştirir. Böylece yanlış okunan bir isim için tüm sesi yeniden üretmeniz gerekmez.
Zyphra'nın kendi uyarısı burada da geçerli: Duygu ve konuşma biçimi değerleri garanti değil, hedef niteliğinde. Hız ayarı ses yüksekliğini ve perdeyi değiştirebilir; canlılık ayarı da perdeyi ve süreyi etkileyebilir.
Yayımlanmış donanım testleri: hız, VRAM ve Windows'taki iki tuzak
| Kurulum | Ölçülen sonuç | Kaynak |
|---|---|---|
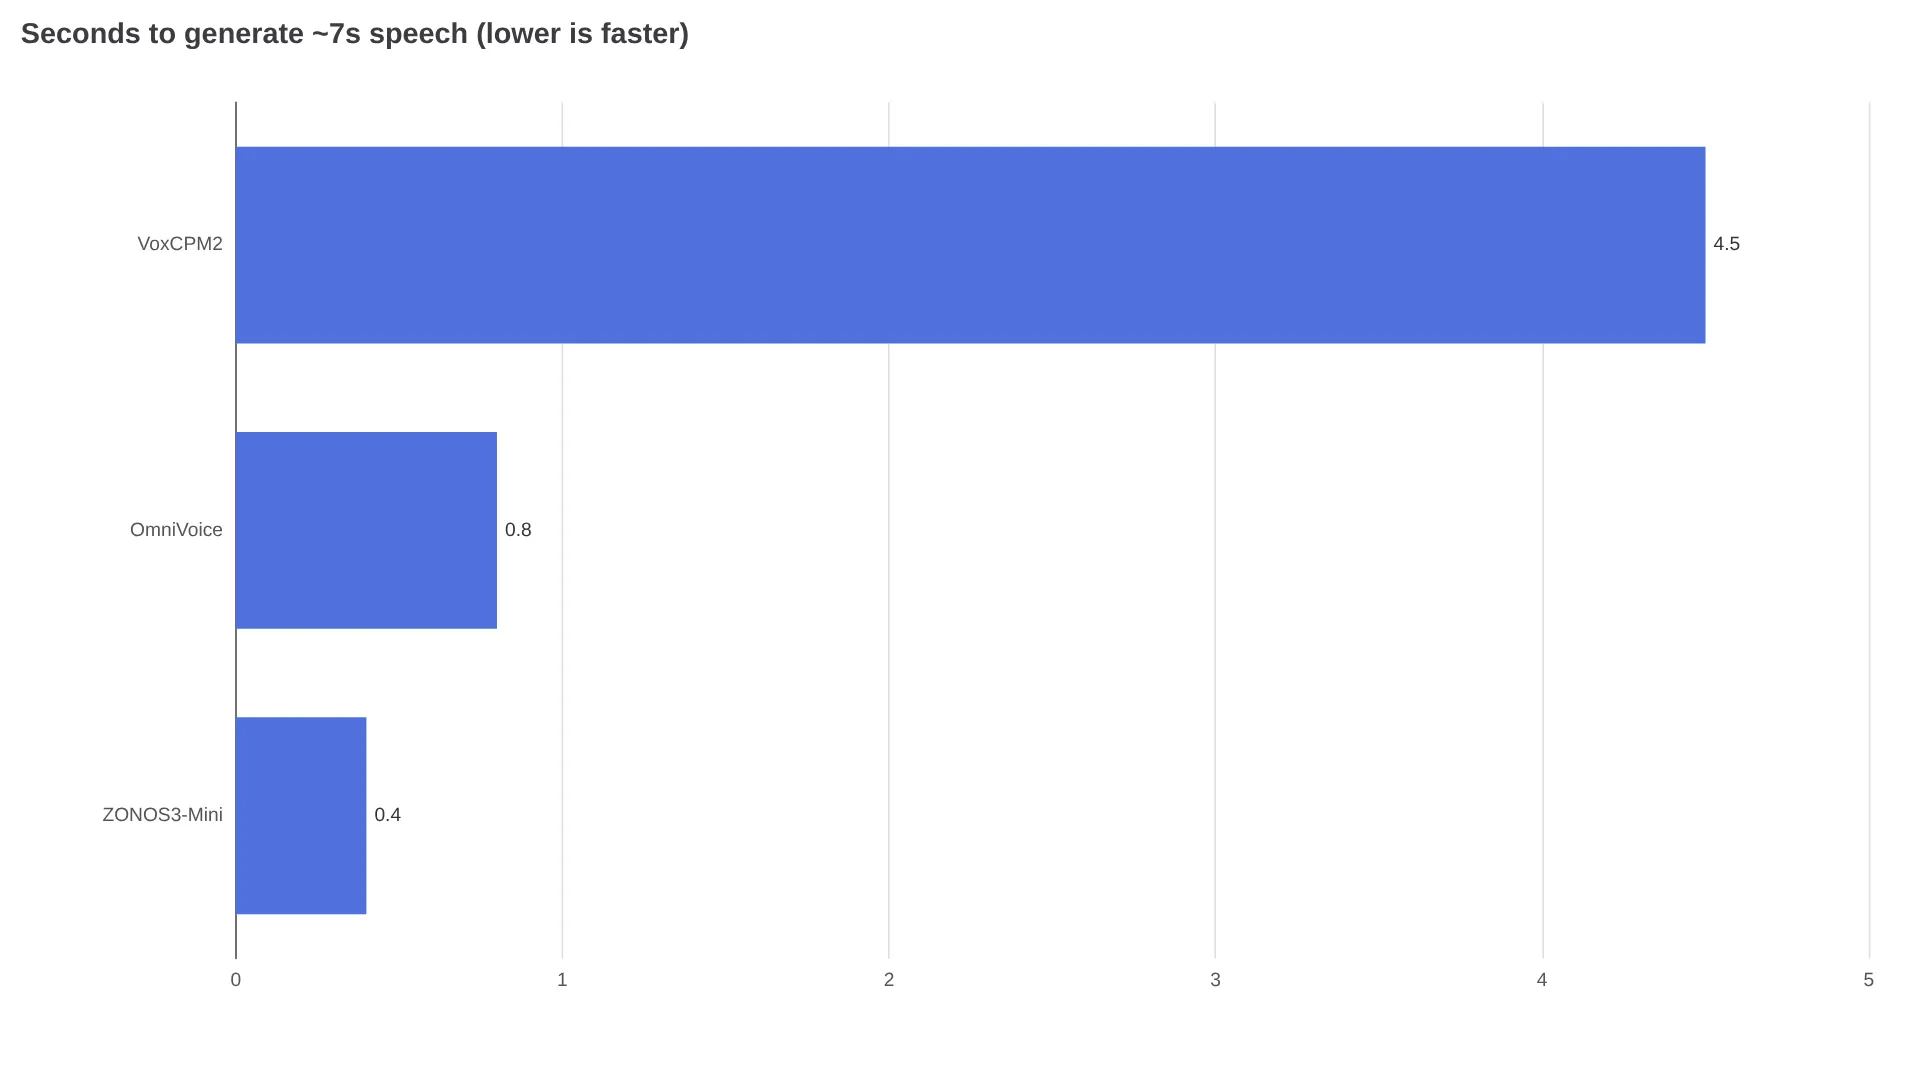
| RTX 5080, quantize ggml (0,66 GB omurga + 0,45 GB decoder) | Yaklaşık 7,1 saniyelik Japonca konuşma 0,40 saniyede; toplam 2,4 GB VRAM — 0,056 gerçek zaman faktörü, yani gerçek zamandan yaklaşık 18 kat hızlı | VRAM16 benchmark |
| Aynı sistem: 31 saniyelik pasaj; yalnızca CPU ile 7,2 saniyelik klip | GPU'da 2,5 GB kullanımla 1,50 saniye; CPU hesaplama için 1,45 saniye harcadı (başlangıçtan bitişe 2,38 saniye) | VRAM16 benchmark |
| 64 GB M5 Pro Mac mini, MLX sunucusu | 38,5 saniyelik ses 2,81 saniyede; ilk sese kadar 75–100 ms; ilk klonlamada yaklaşık 16 GB tepe bellek kullanımı | @pratikg |
GPU sonucu, aynı benchmark'ta daha önce ölçülen OmniVoice'tan yaklaşık iki kat hızlı ve VoxCPM2 için ölçülen 0,63x değerinin de çok önünde.
Tam boyutlu 2,2 GB decoder kullanıldığında bellek tüketimi 4,2 GB'a çıktı; ancak test eden kişi duyulabilir kalite farkı konusunda kesin bir yargıya varamadı. Whisper large-v3 ile alınan transkriptler hedeflenen Japonca ve İngilizce metinle eşleşti. Bu, anlaşılabilirliği kanıtlıyor; doğallığı veya referans sese benzerliği değil.
En hızlı yerel kullanım raporu, MLX sunucusuyla 64 GB M5 Pro Mac mini kullanan bir Apple Silicon testçisinden geldi:
"BENCHMARKED: ... gerçek zamandan 13,7 KATA kadar hızlı çalışıyor. Bu, 64 GB M5 Pro Mac mini'imde, tamamen yerelde ve MLX sunucusuyla elde edildi: hazır seslerde ilk sese kadar yaklaşık 75-100 ms (TTFA). 38,5 saniyelik ses klibini 2,81 saniyede üretti. 11-13 saniyelik bir ses klibinden yeni bir sesi klonladı; bu ses yaklaşık 1,3 saniye sonra konuşmaya başladı. ... WER %0-4. Yalnızca birkaç GB bellek kullandı (ilk ses klonlamada yaklaşık 16 GB tepe)." — @pratikg, veri seti ve notlarını yayımlayan gerçek kullanıcı
Bu sonuçtaki önemli ayrıntıyı kaçırmayın: İlk klonlama sırasında bellek kullanımı yaklaşık 16 GB'a ulaştı, önbelleğe alınan klonlar ise hazır sesler kadar hızlı çalıştı. Çok sayıda konuşmacıyı toplu klonlamayı planlıyorsanız sabit kullanım yerine bu tepe değeri hesaba katın.
Windows'ta kaynaktan derleme yapanlar, VRAM16 testçisinin yamalarla belgelediği iki sorunla karşılaştı. Microsoft derleyicisi, GCC ve Clang'in kabul ettiği, üyesi de head adını taşıyan bir struct'ı reddetti. Bu nedenle sağlanan yeniden adlandırma yamasıyla yalnızca zonos3-cli, zonos3-server ve spk-encoder-cli derlenmeli. Ayrıca Japonca Windows, CLI metnini UTF-8 yerine CP932 olarak geçiriyor; program komut satırını GetCommandLineW üzerinden yeniden okumadıkça bozuk ses çıktısı oluşuyor. zonos3-server için JSON isteklerinin zaten UTF-8 olması gerekiyor, fakat bu doğrulanmadı.
Pratik kurulum önerisi: C:\zonos3 gibi boşluk veya ASCII dışı karakter içermeyen bir yol kullanın. C++ araçlarıyla birlikte Visual Studio 2022, Git ve FFmpeg kurun. Temiz bir CUDA kurulumu yaklaşık beş dakika sürüyor; varsayılan ağırlıklar yaklaşık 1,2 GB, yerel CUDA ise yaklaşık 2 GB alan istiyor (kurulum notları).
Barındırmalı API maliyeti: 1 milyon UTF-8 byte için 10 dolar ne demek?
Barındırmalı seçenek, https://api.zyphracloud.com/api/v1/audio/speech adresinde OpenAI uyumlu bir konuşma endpoint'i sunuyor. İsteklerde zyphra/zonos3-mini modeli ve bearer olarak ZYPHRA_API_KEY kullanılıyor. Aşağıdaki örnek, bulut API'siyle aynı istek yapısını kullanan yerel bir SGLang-Omni sunucusunu başlatır (SGLang cookbook). Asıl avantaj bu ortak yapı: Önce localhost'ta prototip oluşturup ardından temel URL'yi Zyphra Cloud ile değiştirebilirsiniz.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
Fiyatlandırma karaktere ya da ses dakikasına göre değil, byte üzerinden yapılıyor: 1 milyon UTF-8 byte başına $10.00. Pakette 1 eşzamanlı istek, günde 100 üretim, sınırsız giriş karakteri ve yukarıdaki 60/120 saniyelik klon sınırları yer alıyor. Düz İngilizcede karakter başına kabaca bir byte varsayımıyla ve konuşulan dakika başına yaklaşık 800–900 karakter kabul edilirse, $10 karşılığında yaklaşık 1.100–1.250 dakika elde ediliyor; dakika başına bir sentin altında. CJK metinlerinde ise her karakter yaklaşık üç byte tuttuğu için hesap daha pahalı: Karakter başına yaklaşık 3 kat maliyet oluşuyor. Çince, Japonca veya Korece girdilerde dakika maliyetini görmek için kendi metinlerinizle hesap yapın.
Yerel veya tarayıcı tabanlı çıkarımın, donanım maliyetinden sonra marjinal maliyeti neredeyse sıfır. Barındırmalı katman prototipleme ve ani yük artışları için uygun olsa da 1 eşzamanlı istek ve günde 100 üretim sınırıyla üretim ölçeğini taşıyamaz. Yüksek aktarım hızı isteyen ekipler, $10 rakamını genellemek yerine self-hosted SGLang veya vLLM kurulumunun maliyetini hesaplamalı.
ElevenLabs, Fish, Qwen ve “#1” rozeti karşısında durumu
Zyphra'nın sayfalarında ZONOS3-Mini; Fish Audio, Qwen, Cartesia, ElevenLabs ve OmniVoice ile üç farklı metin üzerinden karşılaştırılıyor: Dramatik bir fragman monoloğu, tutarlılığı ölçen uzun ve komik bir "straight to jail" pasajı ve sohbet/podcast tarzı bir pasaj. Ayrıca gecikme ile aktarım hızını karşılaştıran bir Pareto grafiği bulunuyor. Bu örnekleri kendiniz dinleyin. Sayfalarda oynatıcılar mevcut, fakat yazılı bir kazanan yok; rakip model sürümleri, seed değerleri ve eşleştirilmiş ayarlar da belirtilmiyor.
Sayısal sıralamaya da aynı mesafeyle yaklaşmak gerekiyor. Zyphra'nın ZTTS2-Eval değerlendirmesi, 35 temiz dil ve gerçek dünya verisinden 20 dili kapsayan, set-dil-metrik bazında 420 öğeden oluşuyor. Capability Index'te ZONOS3-Mini, açık modeller arasında Fish S2 Pro ve MOSS TTS v1.5'in önünde birinci sırada. Ancak bu, üreticinin kendi tasarladığı yeni bir testle kendi modelini değerlendirmesi anlamına geliyor. Yöntem açık olsa da bu incelemenin yayımlandığı sırada bağımsız bir yeniden üretim bulunamadı; kapalı model karşılaştırmaları da ortak bir puan olmadan yalnızca ses örneklerinden ibaret.
Zyphra, dil bazında skor veya bağımsız dinleme testi galibiyetleri yayımlamadığı için Mandarin ton doğruluğu, Japonca pitch accent, çok sesli karakterler ve uzun metinlerde duygu aktarımı henüz kanıtlanmış değil. Karar vermeden önce bunları test edin. Dürüst değerlendirme şu: ZONOS3-Mini verimlilik ve dağıtım esnekliğinde öne çıkıyor, kalite liderliği ise henüz doğrulanmış değil.
Kimler şimdi geçiş yapmalı?
| Ekip | Karar | Neden |
|---|---|---|
| Çevrimdışı, cihaz üzerinde veya gizliliğe duyarlı projeler (oyunlar, okuyucular, kiosklar) | Hemen test edin | Apache 2.0, 1,2 GB varsayılan indirme, 2,4 GB VRAM, CPU'da çalışabilme, dakika başına ücret yok |
| Çok sayıda sese ihtiyaç duyan sesli kitap veya NPC pipeline'ı | Pilot uygulama yapın | Kelime düzeyinde yönlendirme ve üretim sonrası düzenleme yeniden üretim maliyetini düşürüyor; ancak her konuşmacı için klonlama benzerliğini doğrulayın |
| İngilizce dışı, özellikle Çince üretim | Kendi değerlendirmenizi bekleyin | Üreticinin dil bazında skoru yok; çok sesli karakterleri ve tonları test edene kadar kelime hata oranı ve prozodi iddiaları İngilizce ağırlıklı kabul edilmeli |
| Yüksek eşzamanlılıklı barındırmalı TTS | Self-host edin veya mevcut çözümde kalın | Bulut katmanı 1 eşzamanlı istek ve günde 100 üretimle sınırlı; asıl üretim yolu SGLang/vLLM |
| Filigranlama veya denetim kaydı gerektiren ekipler | Bekleyin | Yayın materyalleri referans kayıtlar için filigranlama veya saklama politikası tanımlamıyor |
Test sırası şu olmalı: Önce tarayıcı playground'u, ardından en zayıf cihazdaki yerel kurulum, son olarak barındırmalı API. Donanımınız 2,4 GB VRAM ve WebGPU eşiğini geçiyorsa, diliniz de kör dinleme testinden başarıyla çıkıyorsa geçiş yapın. Aksi durumda kapalı API'nizi kullanmaya devam edin ve bağımsız çok dilli benchmark'lar yayımlandıktan sonra yeniden değerlendirin.
Sık sorulan sorular
ZONOS3-Mini ne kadar VRAM istiyor?
Test edilen RTX 5080 kurulumunda toplam yaklaşık 2,4–2,5 GB gerekiyor. Tam decoder ile bu değer 4,2 GB'a çıkıyor; Mac'te ilk klonlama sırasında yaklaşık 16 GB'lık tepe kullanım görüldü.
Tarayıcıda veya CPU'da çalışabilir mi?
Evet. WebGPU sürümünde ilk ziyaret için yaklaşık 920 MB indirme gerekiyor. Yayımlanan tek CPU testinde, başlangıç süresi dahil sentez gerçek zamanın yaklaşık üçte biri kadar sürdü.
Ses klonlama kalitesi nasıl?
Transkript olmadan, en fazla 60 saniyelik kayıtla zero-shot klonlama yapabiliyor. Bağımsız bir test %0–4 kelime hata oranı bildirdi; ancak konuşmacı bazında benzerlik için kendi dinleme testinizi yapmanız gerekiyor.
Ticari kullanıma uygun mu?
Ağırlıklar Apache 2.0, kod ise MIT lisanslı. Ancak klonlanan her ses için hak sahibi olmanız veya izin almanız şart.
API endpoint'i ve maliyeti nedir?
Model zyphra/zonos3-mini ile OpenAI uyumlu POST https://api.zyphracloud.com/api/v1/audio/speech endpoint'i kullanılıyor. Ücret 1 milyon UTF-8 byte başına $10; sınırlar 1 eşzamanlı istek ve günde 100 üretim.
İlgili okumalar: En İyi Text-to-Speech API, En İyi Voice Cloning API 2026, Kokoro 82M TTS Yerel Kurulum Rehberi