 AIREITER
Baidu'nun modelle birlikte sunduğu yapılandırma dosyasında max_position_embeddings değeri 32.768 ile sınırlandırılmış. Dağıtım planı yapmadan önce bilinmesi gereken en kritik ayrıntı da bu: Unlimited OCR, sayfa sayfa çalışan OCR akışını tek bir ileri geçişe dönüştürüyor; ancak bunun için belgenin 32K token bütçesine sığması ve taramaların makul derecede temiz olması gerekiyor. Modelin adındaki “sınırsız” ifadesi tam da burada gerçek anlamını yitiriyor.
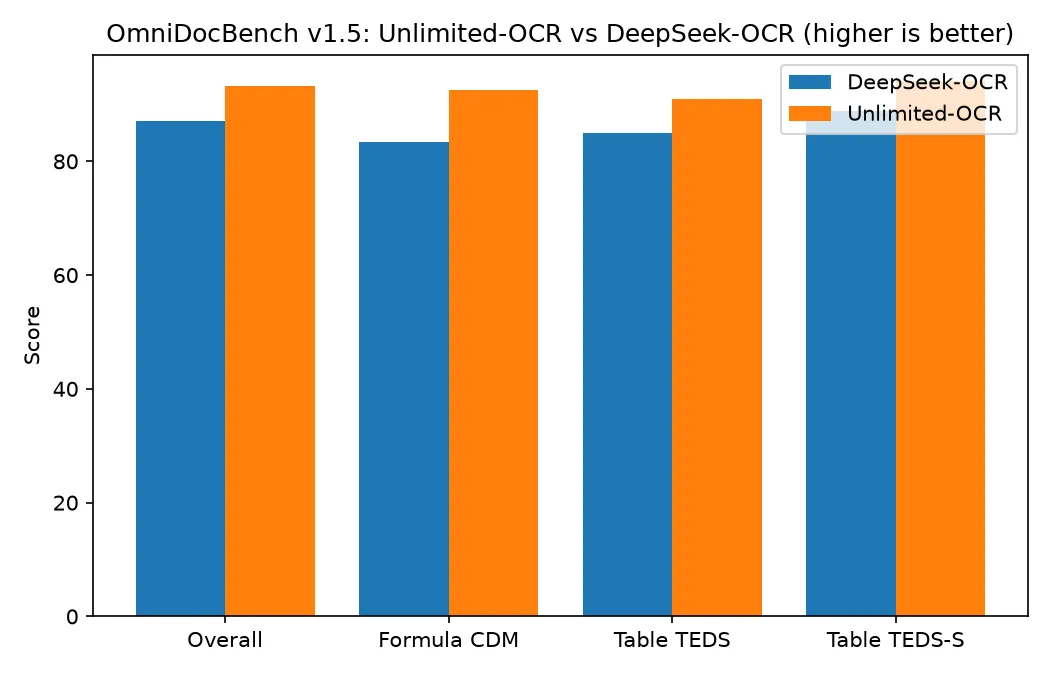
Yine de bu çekince, sürümün genel gücünü gölgelememeli. Ağırlıklar MIT lisanslı, safetensors meta verisi BF16'da 3.336.106.240 parametre gösteriyor ve model, temel aldığı DeepSeek-OCR'ın 87.01'lik sonucuna karşı OmniDocBench v1.5'te toplam 93.23 puan elde ediyor. Hugging Face üzerindeki indirme sayısı 2026-07-29 itibarıyla geride kalan 30 günde 2.694.935'e ulaşmış; beğeni sayısı ise 3.389.
“Sınırsız” ifadesinin geçerli olmadığı nokta
Çok sayfalı işleme yolunda her sayfa 1024×1024 çözünürlükte kodlanıyor ve 16 kat sıkıştırılarak yaklaşık 256 görsel tokene indirgeniyor. Dolayısıyla kod yazmaya başlamadan önce sayfa bütçesini hesaplamak mümkün.
| Tek geçişteki sayfa sayısı | Görsel tokenlar (prefill) | Çıktı için kalan token | Sayfa başına bütçe |
|---|---|---|---|
| 10 | ~2.560 | ~30.200 | ~3.020 |
| 20 | ~5.120 | ~27.600 | ~1.380 |
| 40 | ~10.240 | ~22.500 | ~560 |
Bir sunum dosyası ya da seyrek düzenlenmiş bir sözleşme, 40 sayfaya rahatça sığar. Buna karşılık yoğun, iki sütunlu bir gazete sayfası tek başına 560 markdown tokenını aşabilir; bu tür girdilerde pratik üst sınır 40 sayfanın epey altına iner. Makale bunu açıkça söylüyor: Sonlu bağlam uzunluğunda ayrıştırma gerçekten sınırsız olamaz, çünkü prefill maliyeti sayfa sayısıyla birlikte büyümeye devam eder. Baidu'nun yol haritasında 128K bağlamlı bir sürüm ve sayfa parçalarını ihtiyaç anında getiren bir “prefill pool” bulunuyor. İsmin anlattığı şey sınırsız sayfa değil, önbellek boyutuna göre sınırsız çözümleme uzunluğu.
R-SWA neyi değiştiriyor, neyi değiştirmiyor?
DeepSeek-OCR'a kıyasla iki temel değişiklik var. SAM-ViT-B ile CLIP-L ardışıklığından oluşan DeepEncoder görsel yığını korunmuş ve eğitim sırasında dondurulmuş. Buna karşılık kod çözücüdeki tüm dikkat katmanları Reference Sliding Window Attention ile değiştirilmiş. Bu yapıda üretilen her token, tüm referans tokenlarına — görsel tokenlar ve istem — bakabiliyor; çıktı tarafında ise yalnızca son 128 tokene dikkat uyguluyor. config.json bunu doğruluyor: sliding_window_size: 128, 12 decoder katmanı, 64 yönlendirilmiş uzman ve token başına etkin 6 uzman.
İyileşme tek bir alana sıkışmıyor; uzun üretim boyunca daha iyi korunan sayfa bileşenlerine yayılıyor. OmniDocBench v1.5'te formül CDM skoru 83.37'den 92.61'e, tablo TEDS ise 84.97'den 90.93'e çıkıyor. Okuma sırası düzenleme mesafesi de 0.086'dan 0.045'e, yani yaklaşık yarıya iniyor. Kodlayıcı yeniden eğitilmediği için bu farklar daha güçlü bir görsel yığından değil, decoder tarafındaki değişiklikten kaynaklanıyor.
Bunun bir başka sonucu da şu: Kodlayıcının zorlandığı şeylerde yeni model de zorlanmaya devam ediyor. Daha uzun üretim, solmuş bir faks üzerindeki karakter tanımayı iyileştirmiyor.
Hız avantajı uzun çıktılarda ortaya çıkıyor
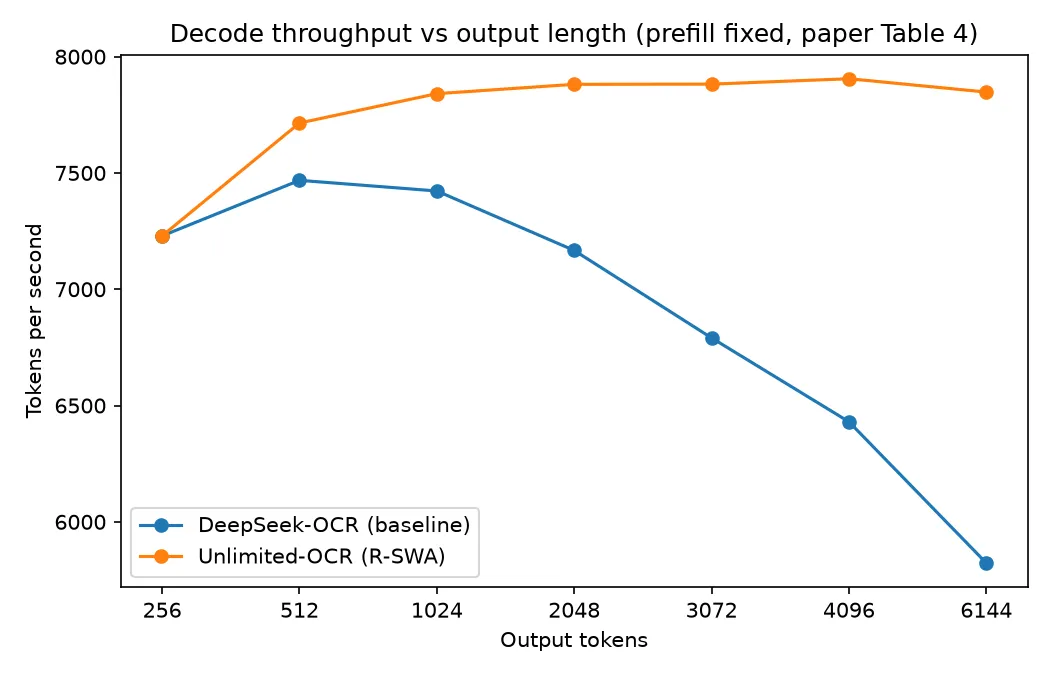
256 çıktı tokenında iki model neredeyse aynı seviyede: saniyede 7.229,52'ye karşı 7.229,32 token. Üretim uzadıkça fark açılıyor. 6.144 çıktı tokenında temel model 5.822,87 token/saniyeye gerilerken Unlimited OCR 7.847,71'de kalıyor; bu da yaklaşık %35 daha yüksek hız anlamına geliyor.
512 eşzamanlılıkta, temel modda yapılan tam OmniDocBench çalışmasında avantaj %12,7'ye geriliyor: saniyede 4.951'e karşı 5.580 token. Çünkü toplu işleme, adım başına dikkat maliyetinin önemli bölümünü zaten gizliyor. Yüksek eşzamanlılıkla tek sayfalık fatura işleme senaryosunda R-SWA neredeyse hiç fark yaratmıyor.
Doğruluk 40 sayfaya kadar korunuyor, sonra bozuluyor
Makale, tek geçişteki sayfa sayısına göre düzenleme mesafesini raporluyor ve eğri düz seyretmiyor.
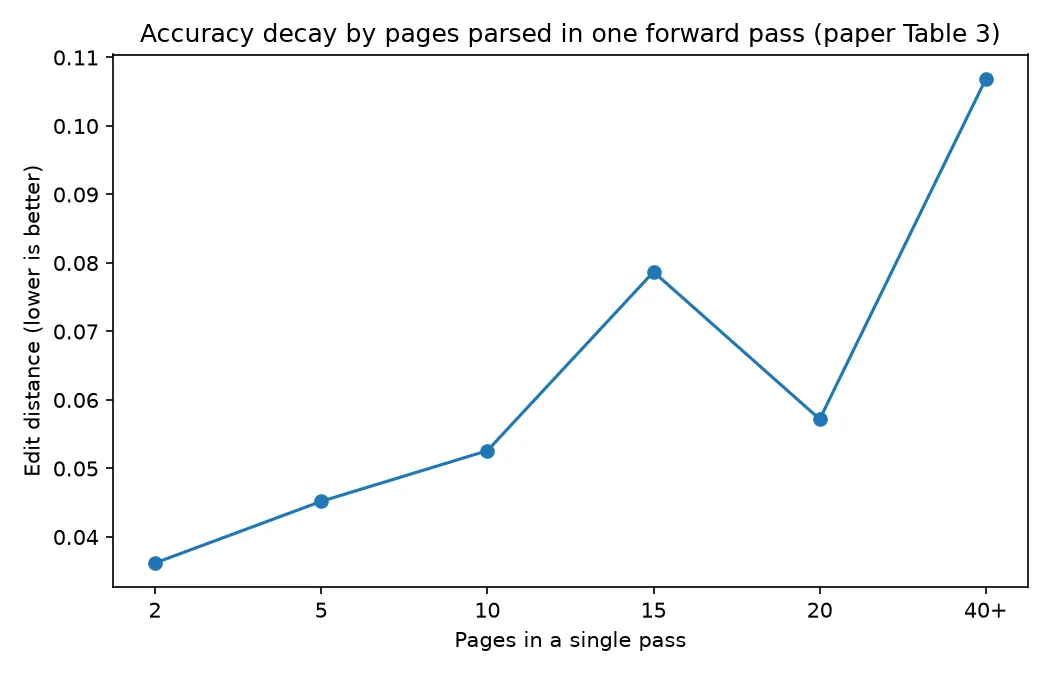
İki sayfada sonuç 0.0362. On sayfada 0.0526'ya çıkıyor. 40 veya daha fazla sayfada 0.1069'a ulaşıyor; Distinct-35 ise yaklaşık %99,9'dan %96,90'a düşüyor. Bu da çıktıda tekrarlayan n-gram'ların görülmeye başladığı anlamına geliyor. 15 sayfalık ölçümün 0.0787 ile 20 sayfalık 0.0572 sonucundan kötü olması nedeniyle, eğriyi sayfa başına garanti olarak değil genel bir eğilim olarak değerlendirmek gerekiyor. Baidu, tekrar hatalarını çoğunlukla dikkat kaymasına değil, 1024×1024 temel çözünürlükte küçük metinlerin yetersiz kalmasına bağlıyor. Bu açıklama mantıklı: Çok sayfalı ve PDF girdileri, tek görsellerin yararlanabildiği yüksek ayrıntılı kırpma modunu kullanamıyor.
“8 GB yeter” iddiasının arkasındaki VRAM hesabı
vLLM yönergesi, BF16 çıkarımı için 8 GB veya üzeri tek bir GPU'nun yeterli olduğunu belirtiyor. Ancak topluluk raporları bunu desteklemiyor ve modelin kendi yapılandırması aradaki farkı açıklıyor.
Tek safetensors dosyasının boyutu 6.673 GB. Önbellek tarafını config.json içindeki dört alan belirliyor: num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128 ve use_mla: false. Sorgu ile anahtar/değer başlıklarının eşit olması, GQA veya MQA paylaşımıyla bölünmeyen düz MHA kullanıldığı anlamına geliyor. Token başına önbellek bu nedenle 2 (K ve V) × 12 katman × 10 başlık × 128 boyut × 2 bayt = 61.440 bayt, yani 60 KiB. Ortaya üç rakam çıkıyor:
- Tam 32K prefill: 32.768 × 60 KiB = 1.875 GiB önbellek
sliding_window_size: 128ile sınırlı R-SWA çözümleme tarafı: sabit 7.5 MiB- R-SWA olmadan, 6.144 çıktı tokenındaki aynı decoder: doğrusal büyüyen 360 MiB
Bunlar tepe bellek tahsisi değil, teorik önbellek boyutları. Görsel kodlayıcı aktivasyonları, ayırıcı parçalanması ve motorun önceden ayırdığı önbellek blokları buna ekleniyor. Ağırlıklar ile uzun bir prefill'in 8 GB'lık kartı neden zorladığı da buradan anlaşılıyor. 16 GB RTX 4070 Ti Super üzerinde yapılan yerel bir SGLang çalıştırması yaklaşık 12 GB kullanım bildirdi. Bu, hesabı kanıtlamasa da onunla tutarlı bir sonuç. 8 GB'ı 40 sayfalık kullanım için teknik özellik olarak değil, kısa tek sayfalı işler için alt sınır olarak görmek gerek.
Bu rakamlar R-SWA'nın kazancını da doğru yere oturtuyor: Bu model boyutunda çözümleme önbelleğini sınırlamak gigabaytlar değil, yüzlerce megabayt tasarruf sağlıyor. Pratikte görülen asıl kazanım, büyümeyi bırakan adım başı dikkat maliyeti; işlem hacmi eğrisinin ölçtüğü de bu.
Resmî API yok: model pratikte nasıl çalıştırılıyor?
Hugging Face model sayfasında “This model isn't deployed by any Inference Provider.” ifadesi yer alıyor. Birinci taraf bir uç nokta ya da Baidu'nun barındırdığı bir fiyatlandırma sayfası yok. Modeli kendiniz sunmak için üç seçenek bulunuyor: trust_remote_code ile Transformers, SGLang veya henüz mimarisi kararlı pip paketinde bulunmadığından özel vllm/vllm-openai:unlimited-ocr konteyneri üzerinden vLLM 0.25.0 ya da daha yenisini gerektiren vLLM yönergesi.
Çıktı alıp alamayacağınızı dört ayar belirliyor:
- n-gram logits işlemcisini (
NGramPerReqLogitsProcessor) kaydedin. Bu olmadan uzun belgeler<|det|>koordinat tokenlarında döngüye giriyor. - Tek görseller için
ngram_size: 35ilewindow_size: 128; çok sayfalı veya PDF girdileri içinsewindow_size: 1024kullanın. - Metin içeriğini,
<image>Multi page parsing.örneğindeki gibi, doğrudan<image>tokenıyla başlatın. Modelle birlikte bir sohbet şablonu gelmiyor. skip_special_tokens: Falseparametresini iletin. Varsayılanı korumak boş dizeler döndürüyor.
Ham üretimler grounding işaretlemesi taşıyor. Temiz markdown elde etmek için <|ref|> içindeki metni koruyup <|det|> sınırlayıcı kutularını atmak gerekiyor. Sayfa sınırları da yerel olarak üretilmiyor; denetim kaydı için bu sınırlara ihtiyacınız varsa istemde sayfa etiketleri isteyin.
Yönergedeki, çalıştığı doğrulanmış sunucu ve istek şu şekilde:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Hopper kartlarda unlimited-ocr-cu129 image etiketini kullanın. Ayrıca tek istekte birden fazla görselin kırpmasız temel moda döndüğünü unutmayın; bu senaryoda window_size: 1024 gerekiyor.
1.000 sayfa maliyeti: kendi sunucun mu, yönetilen API mi?
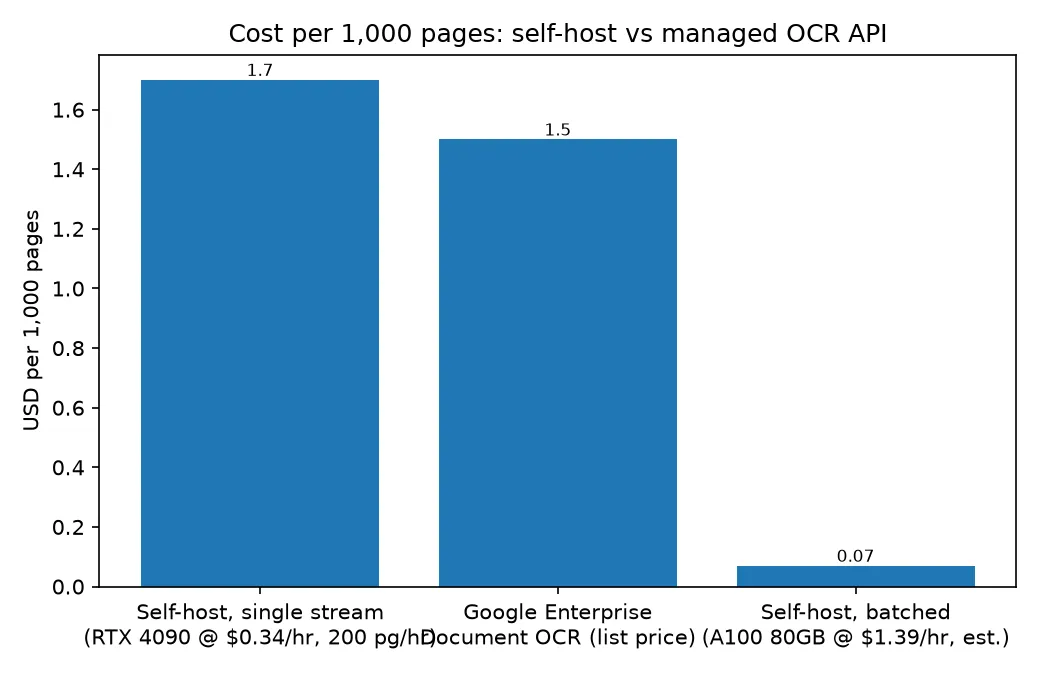
Açık ağırlıklar ücretsizdir; onları çalıştırmak değil. Yayımlanmış az sayıdaki uygulamalı işlem hacmi verisinden biri, Hacker News başlığında yer alan bir uygulayıcıdan geliyor: RTX 4090 üzerinde Transformers aracılığıyla Japonca dilbilgisi PDF'sinin saatte yaklaşık 200 sayfasını dönüştürmüş. Bunu, RTX 4090 için RunPod Community tarifesindeki saatlik $0.34 kira bedeliyle karşılaştırın.
| Seçenek | 1.000 sayfa başına maliyet |
|---|---|
| Kendi sunucunda, tek akış (4090, $0.34/saat; 200 sayfa/saat) | ~$1.70 |
| Google Enterprise Document OCR, ayda 1K ila 5M sayfa | $1.50 (liste fiyatı) |
| Google Layout Parser, aynı sayfa adedi | $10.00 (liste fiyatı) |
| Kendi sunucunda, doygun toplu işleme alt sınırı (A100 80GB, $1.39/saat; modellenmiş) | ~$0.07 |
Liste fiyatları 2026-07-29 itibarıyla geçerli. Google'da aylık ilk 1.000 sayfa ücretsiz; 5 milyon sayfanın üzerindeyse fiyat $0.60'a düşüyor. Son satır ölçüm değil, modellenmiş bir alt sınır ve çıktı uzunluğuna göre değişiyor: Makaledeki 512 yönlü eşzamanlılık altında saniyede 5.580 token verisinde, sayfa başına 700 çıktı tokenı yaklaşık saatte 28.700 sayfa ($0.05 / 1.000), 1.000 token yaklaşık 20.000 sayfa ($0.07), yoğun bir 2.000 tokenlık sayfa ise yaklaşık 10.000 sayfa ($0.14) veriyor. Bu işlem hacmi Baidu'nun kendi değerlendirme kümesinde ölçüldü, kiralık bir A100'de değil; dolayısıyla bu satır bir kıyaslama hızını kiralama fiyatıyla birleştiriyor. Boşta tutulan kapasite, başarısız sayfalardaki yeniden denemeler, ön işleme ve depolama eklendiğinde gerçek dağıtımların maliyeti bu üç değerin de üzerine çıkar.
Tüketici sınıfı kartta tek akışlı dağıtım, Google'ın yönetilen OCR hizmetiyle yaklaşık aynı maliyete geliyor. Bu nedenle kendi sunucunda çalıştırmanın avantajı lisans değil; eşzamanlılık ve veri yerleşimi. Üstelik ayrıştırma işin yalnızca yarısı: Bu markdown'u alanlara dönüştürmek için hâlâ uzun bağlamlı bir metin modeline çağrı yapmak gerekiyor. Bu da ister kendi yığınınızda ister GPT-5.6 API gibi bir hizmette çalışsın, sayfa başı değil token başı faturalandırmaya geri dönmek demek.
Nerelerde hata yapıyor?
Kullanıcıların bildirdiği hata türleri, dondurulmuş bir kodlayıcıdan beklenecek türden. Aynı 4070 Ti Super çalıştırmasında makbuzlar, el yazıları ve karmaşık taramalarda bozuk çıktı, kaçırılmış bölgeler ve yapı kayması görülürken temiz basılı sayfalar düzgün işlenmiş. Hacker News başlığındaki uygulayıcılar, uyumluluk çalışmalarında önem taşıyan VLM-OCR hata sınıfını da tarif ediyor: Yabancı kelimelerin sessizce İngilizceye çevrilmesi ve el yazısıyla yazılmış bir ismin daha olası görülen yazıma “düzeltilmesi”. Bunların ikisi de tekil gözlem; ölçülmüş hata oranları olarak değil, test edilmesi gereken durumlar olarak ele alınmalı.
Konumlandırma açısından da dikkatli olmak gerek. Unlimited OCR, doğruluk tablolarının zirvesinde değil. Toplulaştırılmış OmniDocBench listelerinde PaddleOCR-VL-1.6, v1.6'da 93.92'ye karşı 96.33'te bulunuyor; bu değer satıcı tarafından bildirilmiş. Model olmOCR-Bench'te ise henüz hiç yer almadı. Rekabet ettiği eksen sayfa başına doğruluk değil.
Çalıştırmaya değer mi?
Mevcut hattınız sayfaları tek tek işleyip metni sonradan birleştiriyorsa, belgeleriniz dijital doğumlu ya da temiz taranmışsa ve sayfa sonlarında bölünen tablolar gibi sayfalar arası yapılar mevcut çıktınızı bozuyorsa iyi bir aday.
Her gün binlerce tek sayfalık fatura işliyorsanız, el yazısı veya fotoğrafı çekilmiş makbuzlar girdilerin kayda değer kısmını oluşturuyorsa ya da bugün GPU ve konteyner etiketi yerine bir SLA ile denetim kaydına ihtiyacınız varsa uygun bir seçenek değil. Sayfa başına çalışan hatlar daha iyi toplu işlenir ve daha düşük maliyetlidir.
Her durumda, karar vermeden önce test edin. Uygulanabilir bir asgari test seti şöyle olabilir: Kendi veri kümenizden, uzunluğa göre 1 ila 5 sayfa, 6 ila 20 sayfa ve 20 veya üzeri sayfa olarak; girdi kalitesine göre de dijital doğumlu, temiz tarama ve fotoğraflanmış olarak ayrılmış 50 belge. Bunların 10'u için elle yazılmış gerçek referans metin hazırlayın. Ardından karakter hata oranını, okuma sırası düzenleme mesafesini ve tablo TEDS'i ortalamaya sıkıştırmadan ayrı ayrı ölçün; kiralamayı planladığınız GPU üzerinde sayfa başına gerçek süreyi kaydedin. Aynı 50 dosyada mevcut çözümünüzle karşılaştırın ve eşiği, aşağı akıştaki adımın gerçekten koptuğu noktaya göre belirleyin. Alan çıkarımında bu, çoğu zaman ham CER'den çok tablo yapısıdır. Ayarlamaların sonucu ne kadar değiştirebileceğine referans olarak, kurumsal ölçekte PDF hacmi işleyen bir ekip, çıkarım katmanını Rust ile yeniden yazdıktan sonra %0.94 karakter hata oranı bildirdi.
Sık sorulan sorular
Unlimited OCR ücretsiz mi?
Ağırlıklar MIT lisanslı ve ticari kullanım dahil olmak üzere Hugging Face ya da GitHub üzerinden ücretsiz indirilebiliyor. Çıkarım ücretsiz değil: Toplu işlemeyi ne kadar iyi yaptığınıza bağlı olarak 1.000 sayfa için yaklaşık $0.07 ila $1.70 ve buna ek olarak mühendislik zamanı bütçelemeniz gerekiyor.
Unlimited OCR için resmî bir API var mı?
Hayır. Model sayfasında herhangi bir Inference Provider dağıtımı görünmüyor. Bu nedenle bulduğunuz her uç nokta açık ağırlıkları sunan üçüncü taraf bir hizmettir; fiyatlandırma ve hız limitleri Baidu'nun değil, o sağlayıcının kurallarına bağlıdır.
Unlimited OCR şu anda en iyi OCR modeli mi?
Doğruluk tablolarına göre değil: PaddleOCR-VL-1.6, OmniDocBench'te Baidu'nun v1.6'daki 93.92 sonucuna karşı 96.33 bildiriyor ve modelin henüz olmOCR-Bench kaydı yok. Bu nedenle farklı benchmark'lardaki tutarlılığı kanıtlanmış değil. Ölçülmüş üstünlüğü, 0.1069 düzenleme mesafesiyle 40 sayfayı tek geçişte işleyebilmesi.
Unlimited OCR'ı Ollama'da çalıştırabilir miyim?
Resmî kart yalnızca Transformers, vLLM ve SGLang'i belgeliyor; özel mimari trust_remote_code gerektiriyor. Hugging Face üzerinde topluluk tarafından hazırlanmış quantization sürümleri mevcut, ancak kendi dosyalarınızda referans yöntemle çıktısını karşılaştırana kadar herhangi bir Ollama derlemesini doğrulanmamış kabul edin.