 AIREITER
Alibaba'nın ModelScope'u 25 Ağustos 2026'da Qwen3.8-Flash-Next için bir geri sayım sayfası yayınladı. Ortada, ait olduğu ürün ailesi henüz piyasaya çıkmadan yeni mimariyi deneyime açan bir model var. Yazı hazırlandığı sırada ağırlıkların 26 Ağustos saat 23:00 UTC+8'de yayınlanması bekleniyordu. Amaç, Qwen4 gelmeden önce açık kaynak çıkarım ekosistemine kernel, quantization ve sunucu desteği geliştirmek için zaman kazandırmak.
Qwen3.8-Flash-Next tam olarak nedir, ne değildir?
Qwen3.8-Flash-Next, yaklaşan Qwen4 ailesi için tasarlanan mimariyi temel alan çok modlu bir Mixture-of-Experts (MoE) modeli. Ancak Qwen4'ün kendisi değil. Yeni attention mekanizmalarını, katman yapısını ve seyreklik düzenlerini ortaya koyan çalışan bir teknoloji gösterimi olarak düşünmek daha doğru. Böylece çıkarım framework'leri, tam Qwen4 lansmanı öncesinde gerekli desteği ekleyebilecek.
Qwen ekibinin Hugging Face sayfasında model, "Upcoming release" ve "A Preview of the Qwen4 Architecture" ifadeleriyle listeleniyor. ModelScope geri sayım sayfasındaki slogan ise "Onward to the Next-Gen — Lightning-Fast." Her iki kanal da resmi Qwen kanalı olduğu için yayın doğrulanmış durumda; yalnızca yazı hazırlanırken süreç henüz tamamlanmamıştı.
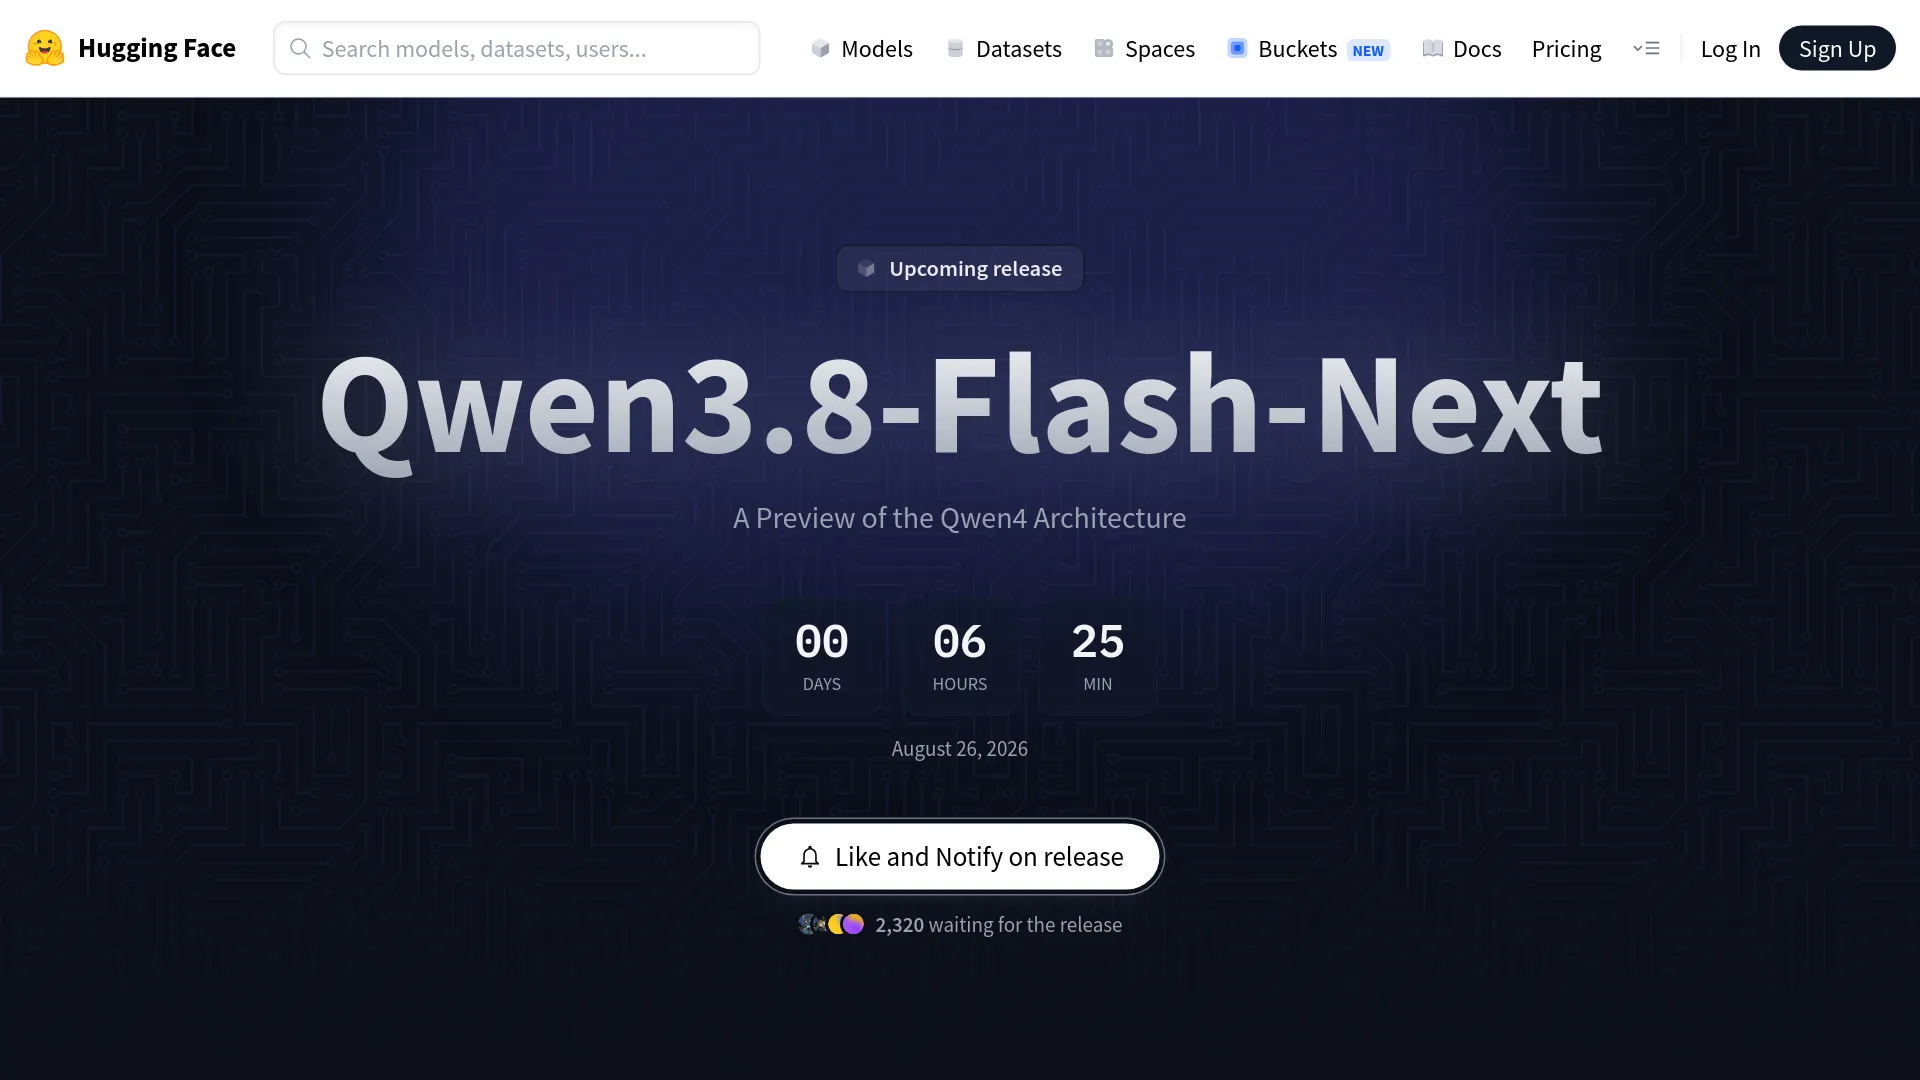
Resmi kanallarla doğrulanan bilgilerle toplulukta konuşulan ancak henüz kesinleşmeyen noktalar şöyle:
| Resmi kanallarla doğrulananlar | Henüz doğrulanmayanlar |
|---|---|
| ModelScope ve Hugging Face üzerinden açık ağırlık yayını | Kesin parametre sayıları (125B/6B/51B) |
| Çok modlu yapı (görüntü + metin) | Lisans (önceki örneklere bakılırsa muhtemelen Apache 2.0) |
| GDN hibrit mimarisi ve Qwen Sparse Attention | Herhangi bir benchmark sonucu |
FP8 sürümü (Qwen/Qwen3.8-Flash-Next-FP8) | API fiyatlandırması veya erişilebilirlik |
| Qwen4 için mimari önizleme | Bağlam uzunluğu (yerel olarak 256K, genişletilebilir olarak 1M olduğu öne sürülüyor) |
Herkesin tekrarladığı toplam 125B, token başına 6B aktif ve 51B n-gram embedding değerleri, ModelScope kartında kısa süreliğine görüldükten sonra Qwen ekibi tarafından kırpılan bir bölümden alındı. Birden fazla bağımsız gözlemci tarafından paylaşılmış ve birbiriyle tutarlı olsalar da kalıcı resmi dokümantasyon sayılmazlar. SaaSCity kurucusu ghosty durumu şöyle özetledi:
"Anyone posting a benchmark chart for this model today made it up."
Çıkarım framework'lerinin çalışma şeklini değiştiren mimari
Üç mimari bileşen, Qwen3.8-Flash-Next'i mevcut Qwen modellerinden belirgin biçimde ayırıyor. Bu özelliklerin her biri yalnızca bir yapılandırma değişikliği değil, çıkarım framework'leri için yeni kernel kodu gerektiriyor.
GDN katmanları: sabit boyutlu tekrarlayan durumla uzun bağlamda daha düşük bellek kullanımı
Gated Delta Network (GDN), katmanların çoğunda standart attention mekanizmasının yerini alıyor. Standart Transformer attention, dizi uzunluğu arttıkça büyüyen bir KV cache tutarken GDN sabit boyutlu tekrarlayan bir durum kullanıyor. GDN katmanlarında bellek kullanımı bağlam uzunluğundan bağımsız kalıyor ve hesaplama karesel değil doğrusal ölçekte büyüyor. Hibrit mimarideki full-attention katmanları ise hassas geri getirme işlemleri için KV cache kullanmaya devam ediyor.
Pratik sonuç açık: uzun bağlamlı işler çok daha ucuza çalışabilir. 100K token'a yayılan bir konuşma için 100K tokenlık KV cache belleği gerekmiyor. ModelScope kartının kısa süreliğine görünen içeriği üzerinde yapılan topluluk analizlerine göre Qwen3.8 mimarisinde 69 GDN katmanına karşılık 23 full-attention katmanı bulunuyor; yani oran yaklaşık 3:1. Full-attention katmanları küresel geri getirme kalitesini korurken, dizi işlemenin büyük bölümünü GDN katmanları üstleniyor.
Bu yaklaşım Qwen için tamamen yeni değil. Qwen3-Next, Eylül 2025'te toplam 80B ve aktif 3B parametreyle Gated DeltaNet'i tanıtmıştı. Qwen3.5/3.6/3.7 ailesinin de benzer bir hibrit yapıyı koruduğu bildiriliyor. Flash-Next'in yeniliği, bu mimarinin 125B toplam parametre ölçeğine taşınması ve aşağıdaki iki bileşenin eklenmesi.
QSA: Seyrek attention var, ama nasıl çalıştığı henüz belirsiz
Qwen Sparse Attention (QSA), kartta adı geçen ancak açıklanmayan özelliklerden biri. Toplulukta kabul gören görüş, bunun yoğun attention yerine seyrek bir düzen kullandığı yönünde: Her token, dizideki tüm token'lara değil yalnızca bir alt kümeye bakıyor. QSA'nın öğrenilmiş seyreklik mi, blok seyreklik mi, kayan pencere mi yoksa bunların bir kombinasyonu mu kullandığı bilinmiyor. Teknik rapor yayınlandığında QSA'nın küçük bir iyileştirme mi yoksa gerçekten yeni bir attention ilkesi mi olduğu anlaşılacak.
51B'lik n-gram tablosu: Taslak model olmadan speculative decoding
En sıra dışı özellik, 51B parametreli bir n-gram embedding tablosu. Toplulukta öne çıkan çalışma hipotezine göre bu tablo, hızlı bir token arama mekanizması görevi görüyor; başka bir deyişle speculative decoding için entegre edilmiş bir taslak model gibi çalışıyor. Normalde sonraki birkaç token'ı tahmin etmek için ayrı bir küçük model çalıştırılır ve sonuç ana model tarafından doğrulanır. Buradaysa n-gram tablosu, sonraki token adaylarını doğrudan ve düşük maliyetle sağlayabilir.
Belirsizlikler önemli: Tablo VRAM'de mi tutulmalı, yoksa memory mapping ile çalışabilir mi? Quantization sonrasında davranışı nasıl değişecek? 125B değerine dahil mi, yoksa bunun dışında mı? Teknik rapor veya ilk topluluk benchmark'ları bu soruları yanıtlayana kadar 51B değerini sabit bir maliyet değil, dağıtım planlamasında dikkate alınacak değişken olarak değerlendirmek gerekiyor.
Flash-Next, Qwen aile ağacında nereye oturuyor?
Flash-Next, doğrusal bir sonraki adım olmaktan çok paralel bir hat olarak konumlanıyor:
| Model | Yayın tarihi | Toplam parametre | Aktif parametre | Rolü |
|---|---|---|---|---|
| Qwen3-Next | Eyl 2025 | 80B | 3B | İlk GDN mimarisi testi |
| Qwen3.8-27B | Ağu 2026 | 27B (dense) | 27B | Orta sınıf, yoğun yapılı iş modeli |
| Qwen3.8-Max | Ağu 2026 | ~2.4T | ~95B | Amiral gemisi, açık ağırlıklı model |
| Qwen3.8-Flash-Next | 26 Ağu 2026 | ~125B | ~6B | Qwen4 için mimari önizleme |
| Qwen4 | TBD (aylar içinde) | Bilinmiyor | Bilinmiyor | Tam yeni nesil aile |
Topluluğun kullandığı pratik hesap şu: sqrt(125B x 6B) = 27B. Bu yaklaşım geçerliyse Flash-Next, kalite açısından kabaca 27B'lik yoğun bir modele yaklaşırken çıkarım hesaplama maliyeti 6B'lik bir modele daha yakın olabilir. Beer And Code'dan Lucas Souza'nın da belirttiği gibi bu bir kestirme kural, teorem değil. Yönlendirme kalitesi, veri kalitesi ve n-gram tablosunun katkısı henüz ölçülmüş değil.
Birden fazla topluluk analizinde "benchmark değil, platform hamlesi" olarak tanımlanan strateji, llama.cpp, vLLM ve SGLang gibi çıkarım framework'lerinin Qwen4 çıkmadan önce kernel desteği eklemesini sağlamak. Unsloth da sıfırıncı gün desteği üzerinde çalıştığını duyurdu.
Gerçekten çalıştırabilir misiniz? Donanım tablosu
| Format | Yaklaşık ağırlık belleği |
|---|---|
| BF16 / FP16 | ~250 GB |
| FP8 | ~125 GB |
| Q4 / 4-bit | ~65–70 GB |
Bu değerler yalnızca ağırlıklar için geçerli; bağlam, KV cache ve çalışma zamanı ek yükleri hesaba dahil değil. Q4 quantization uygulanmış bir modelin ana ağırlıkları için yaklaşık 65–70 GB gerekir. Buna 51B'lik n-gram tablosunun ihtiyaç duyduğu bellek de eklenecek. N-gram tablosu VRAM'de tutulmak zorundaysa toplam gereksinim, tek makineyle çalıştırma ihtimalini çoğu kullanıcı için ortadan kaldırıyor. Sistem RAM'ine memory mapping yapılabiliyorsa 128GB+ birleşik belleğe sahip bir sistem — Mac Studio (M2 Ultra / M3 Ultra maxed), AMD Strix Halo, NVIDIA DGX Spark — kullanılabilir olabilir. Tek bir RTX 4090 veya 5090 yeterli değil.
Reddit'te u/KURD_1_STAN, modelin "yerel kullanıma uygun" olduğu yönündeki çerçeveye itiraz etti: "Ram prices this high, how can u call this local friendly?" "6B aktif" pazarlama söylemiyle 250GB bellek gereksinimi arasındaki fark gerçek. X'te @Dicklong1999, seyrek aktivasyon düzeninin donanıma sahip kullanıcılar için üretim hızını makul seviyede tutabileceğini belirtti; ancak "125B, ordinary people can basically forget about running it locally."
API erişimi ve fiyatlandırma konusunda ne bekleniyor?
Yayın sırasında Qwen3.8-Flash-Next için API fiyatlandırması ve erişilebilirlik açıklanmamıştı. Qwen'in resmi fiyatlandırma sayfasında Qwen3.8-Max için girişte $2.00/M, çıkışta $6.00/M ücret listeleniyor; 6B aktif parametre nedeniyle Flash-Next'in bunun oldukça altında fiyatlanması beklenebilir. FP8 sürümü, BF16'ya kıyasla ağırlık belleğini yarıya indirdiği için API sunumu açısından doğal bir format. Erişim ise çıkarım framework'lerinin desteğine bağlı olacak; ağırlıklar yayınlandıktan sonra sağlayıcı kataloglarını kontrol etmek gerekiyor.
Ağırlıklar yayınlanmadan önce ne yapmalı?
Qwen3.8-Flash-Next'in kullandığınız teknoloji yığını açısından önemli olup olmadığını değerlendiren bir geliştirici veya araştırmacıysanız, şu kontrol listesini izleyebilirsiniz:
1. Donanımınızı doğrulayın. Yerel çalıştırma planınız varsa 128GB+ birleşik belleğe veya çoklu GPU kurulumuna sahip olduğunuzdan emin olun. Bunlar yoksa API erişimini planlayın.
2. Hugging Face reposunu takip edin. Gerçek teknik özellikler, lisans ve bağlam uzunluğu konusunda ilk güvenilir kaynak model kartı olacak. huggingface.co/Qwen/Qwen3.8-Flash-Next adresini yer imlerine ekleyin.
3. Değerlendirme hattınızı hazırlayın. Ağırlıklar yayınlanmadan önce benchmark sorularınızı ve değerlendirme script'lerinizi hazır edin. Topluluktan gelecek ilk 24 saatteki benchmark'lar, resmi rakamlardan daha fazla fikir verebilir.
4. Üretim iş yüklerinizi taşımayın. Henüz bağımsız benchmark bulunmuyor. Mimari yeni, çalışma zamanı desteği olgunlaşmamış ve lisans doğrulanmış değil. Modeli değerlendirme amacıyla kullanın; bozulması halinde para kaybettirecek üretim işlerinde kullanmayın.
5. Çıkarım araçlarını geliştiriyorsanız hemen başlayın. GDN + QSA kombinasyonu yapılandırma değişikliği değil, kernel çalışması gerektiriyor. Mimariyi ne kadar erken anlarsanız desteği o kadar hızlı yayınlayabilirsiniz.
Sık sorulan sorular
Ağırlıklar ne zaman erişilebilir olacak?
ModelScope geri sayımı 26 Ağustos 2026, yaklaşık 23:00 UTC+8 zamanını gösteriyordu. Hugging Face aynalarının ModelScope yayınından birkaç saat sonra görünmesi alışılmadık değil. Qwen ekibi zamanlamayı resmi kanallar üzerinden doğruladı; @Alibaba_Qwen "what surprise we're dropping tonight" ifadesiyle ipucu verirken @QwenDevs modelin adını doğrudan paylaştı.
Bu model Qwen4 mü?
Hayır. Qwen3.8 adlandırmasını kullanan bir Qwen4 mimarisi önizlemesi. Qwen4'ün haftalar içinde değil, aylar içinde gelmesi bekleniyor. Flash-Next'in amacı, tam aile yayınlanmadan önce ekosistemin çalışma zamanı desteğini hazırlamasını sağlamak.
Hangi lisansı kullanıyor?
Henüz doğrulanmış değil. Son Qwen açık ağırlık sürümleri olan Qwen3.8-27B ve Qwen3.8-Max, Apache 2.0 kullanıyordu; bu nedenle en olası sonuç da bu. Ağırlıklar yayınlandıktan sonra model kartındaki bilgiyi kontrol edin.
RTX 4090 üzerinde çalıştırabilir miyim?
Hayır. Q4 quantization kullanılsa bile yalnızca ana ağırlıklar için ~65–70 GB gerekiyor. Tek bir RTX 4090'da 24 GB bellek bulunuyor. 128GB+ birleşik belleğe sahip bir sistem (Mac Studio, Strix Halo) veya yüksek VRAM'li birden fazla GPU gerekiyor.
Qwen3.8-27B'yi geçecek mi?
Bilinmiyor. Henüz benchmark yok. sqrt(125B x 6B) = 27B kestirmesi, 27B'lik yoğun bir modelle karşılaştırılabilir kaliteye işaret ediyor; ancak bu bir ölçüm değil, tahmin. Kendi kullanım senaryonuz için bağımsız değerlendirmeleri bekleyin.
Ne kadar hızlı olacak?
Token başına 6B aktif parametre, üretim hızının 125B'lik dev bir modelden çok küçük bir modele yaklaşabileceğini düşündürüyor. Ancak n-gram tablosunun bellek erişim düzeni ve GDN kernel'inin verimliliği bilinmeyen değişkenler. İlk topluluk benchmark'ları bu soruyu yanıtlayacak.
API platformlarında kullanılabilecek mi?
Büyük olasılıkla evet. FP8 sürümü API sunumu için tasarlanmış görünüyor. AIReiter ve diğer platformlar genellikle ağırlıkların yayınlanmasından sonraki günlerde Qwen modellerini ekliyor. Buradaki darboğaz, yeni attention mekanizmaları için framework desteğinin hazırlanması.
Geçen yılki Qwen3-Next'e ne oldu?
Qwen3-Next, Eylül 2025'te toplam 80B ve aktif 3B parametreyle yayınlandı ve Gated DeltaNet'i tanıttı. Daha küçük ölçekte bir mimari testi olarak GDN hibrit yaklaşımının işe yaradığını gösterdi. Flash-Next bunun ölçeği büyütülmüş devamı. X'teki @LufzzLiz, geçen yılın Next serisinin "was a letdown" olduğunu söyledi; bu da bu kez benchmark'ları beklemenin neden önemli olduğunu gösteriyor.