 AIREITER
OpenRouter, dashboard lansmanında platform genelindeki cache hit oranını %82,8 olarak açıkladı (@OpenRouter). Ancak toplulukta görünen tablo daha farklı: %1'in altına inen hit oranları (@miolini) ve beklenenin 10–32 katına çıkan faturalar (r/openrouter). OpenRouter prompt caching, giriş maliyetini gerçekten düşürebiliyor; fakat önce dört belirli sorun kaynağını ortadan kaldırmanız gerekiyor. En etkili hamle ise ardışık isteklerin aynı, ısınmış sağlayıcıda kalmasını sağlamak. Başta net bir sınır var: Prompt, sağlayıcının minimum token eşiğinin altındaysa yaptığınız hiçbir yapılandırma onu cache'lenebilir hâle getirmez.
OpenRouter'da cache hit tam olarak ne demek?
Prompt caching, sağlayıcının daha önce işlediği sabit bir prompt ön ekini yeniden kullanır. Böylece tekrarlanan giriş token'ları tam fiyat yerine indirimli ücretlendirilir. Önbellek, ilk isteği karşılayan belirli sağlayıcı endpoint'inde tutulur; bu nedenle routing davranışı, prompt yapısı kadar önemlidir. Bu mekanizma, yönlendirme gerçekleşmeden önce tamamen aynı isteği ücretsiz olarak yeniden döndüren response caching katmanından ayrıdır.
| Prompt caching | Response caching | |
|---|---|---|
| Yeniden kullandığı şey | Herhangi bir isteğin sabit ön eki | Bayt düzeyinde aynı istek (normalize edilmiş gövdenin SHA-256'sı) |
| Nasıl etkinleştirilir? | Çoğunlukla otomatik; Anthropic, Qwen ve Gemini için cache_control | X-OpenRouter-Cache: true header'ı veya preset |
| Maliyet | Cache'lenen token'lar giriş ücretinin 0,1–0,5 katı | Hit'ler ücretsiz, miss'ler normal ücretlendirilir |
| Ömür | Genellikle 3–5 dk., Anthropic'te 1 saate kadar | Varsayılan 300 sn., aralık 1–86.400 sn. |
| Ne engeller? | Ön ek değişimi, sağlayıcı değişimi, token minimumu | Herhangi bir JSON değişikliği, API key rotasyonu, hesap düzeyinde ZDR |
Response caching; yeniden denemeler, unit test'ler ve agent iş akışlarındaki birebir tekrarlanan çağrılar için özellikle kullanışlıdır. JSON özellik sırası cache key'in parçasıdır; yani zararsız görünen bir serialization değişikliği bile miss yaratır. Sağlayıcı tarafındaki çalışma mantığı için temel kaynak OpenRouter'ın prompt caching rehberi:
OpenRouter prompt caching maliyeti: sağlayıcı bazında tablo
Cache okuması her sağlayıcıda normal giriş fiyatının yalnızca bir kısmına mal olur. Buna karşılık cache'i oluşturan yazma işlemi ek ücret getirebilir: Anthropic'te varsayılan 5 dakikalık TTL için normal girişin 1,25 katı, 1 saatlik seçenek için ise 2 katı. Caching, aynı ön ek yeterince sık yeniden okunursa yazma maliyetini amorti eder; tek seferlik bir istek caching açıkken kapalı durumdan daha pahalıya bile çıkabilir. OpenRouter'ın kendi hesaplama örneğine göre Claude Sonnet 4.6'da cache'lenen giriş $0.30/M, yeni giriş ise $3.00/M.
Aynı kaynaktaki sağlayıcı bazlı yazma ve okuma çarpanları şöyle:
| Sağlayıcı | Cache yazma | Cache okuma | Notlar |
|---|---|---|---|
| Anthropic | 1,25x (5 dk.) / 2x (1 sa.) | 0,1x | TTL, breakpoint başına seçilebilir |
| OpenAI, GPT-5.6 öncesi | Ücretsiz | 0,25–0,5x | 1.024 token'dan itibaren otomatik |
| OpenAI GPT-5.6+ | 1,25x | 0,25–0,5x | Artık açık breakpoint desteği var |
| Google Gemini | Ücretsiz | 0,25x | 2.5+ sürümlerinde örtük, yaklaşık 3–5 dk. TTL |
| Grok | Ücretsiz | 0,25x | Otomatik |
| Moonshot | Ücretsiz | 0,25x | Otomatik |
| Groq | Ücretsiz | 0,5x | Yalnızca Kimi K2 modelleri |
| DeepSeek | 1,0x | 0,1x | Yazmalar normal giriş olarak ücretlendirilir |
| Alibaba Qwen | 1,25x | 0,1x | Açık cache_control zorunlu |
| Z.AI | Ücretsiz | ~0,2x | Cache depolaması sınırlı süreli ücretsiz listeleniyor |
OpenRouter'ın örneği, altı tur boyunca tekrar eden 10.000 token'ı hesaplıyor: Cache'siz durumda tek turun 6,0 katı; Anthropic'in 5 dakikalık cache'i ve sticky routing ile 1,75 katı; yazması ücretsiz ve okumaları 0,25x olan bir sağlayıcıda 2,25 katı. Hesaplamaya büyüyen mesajlar ve output token'ları dahil değil.
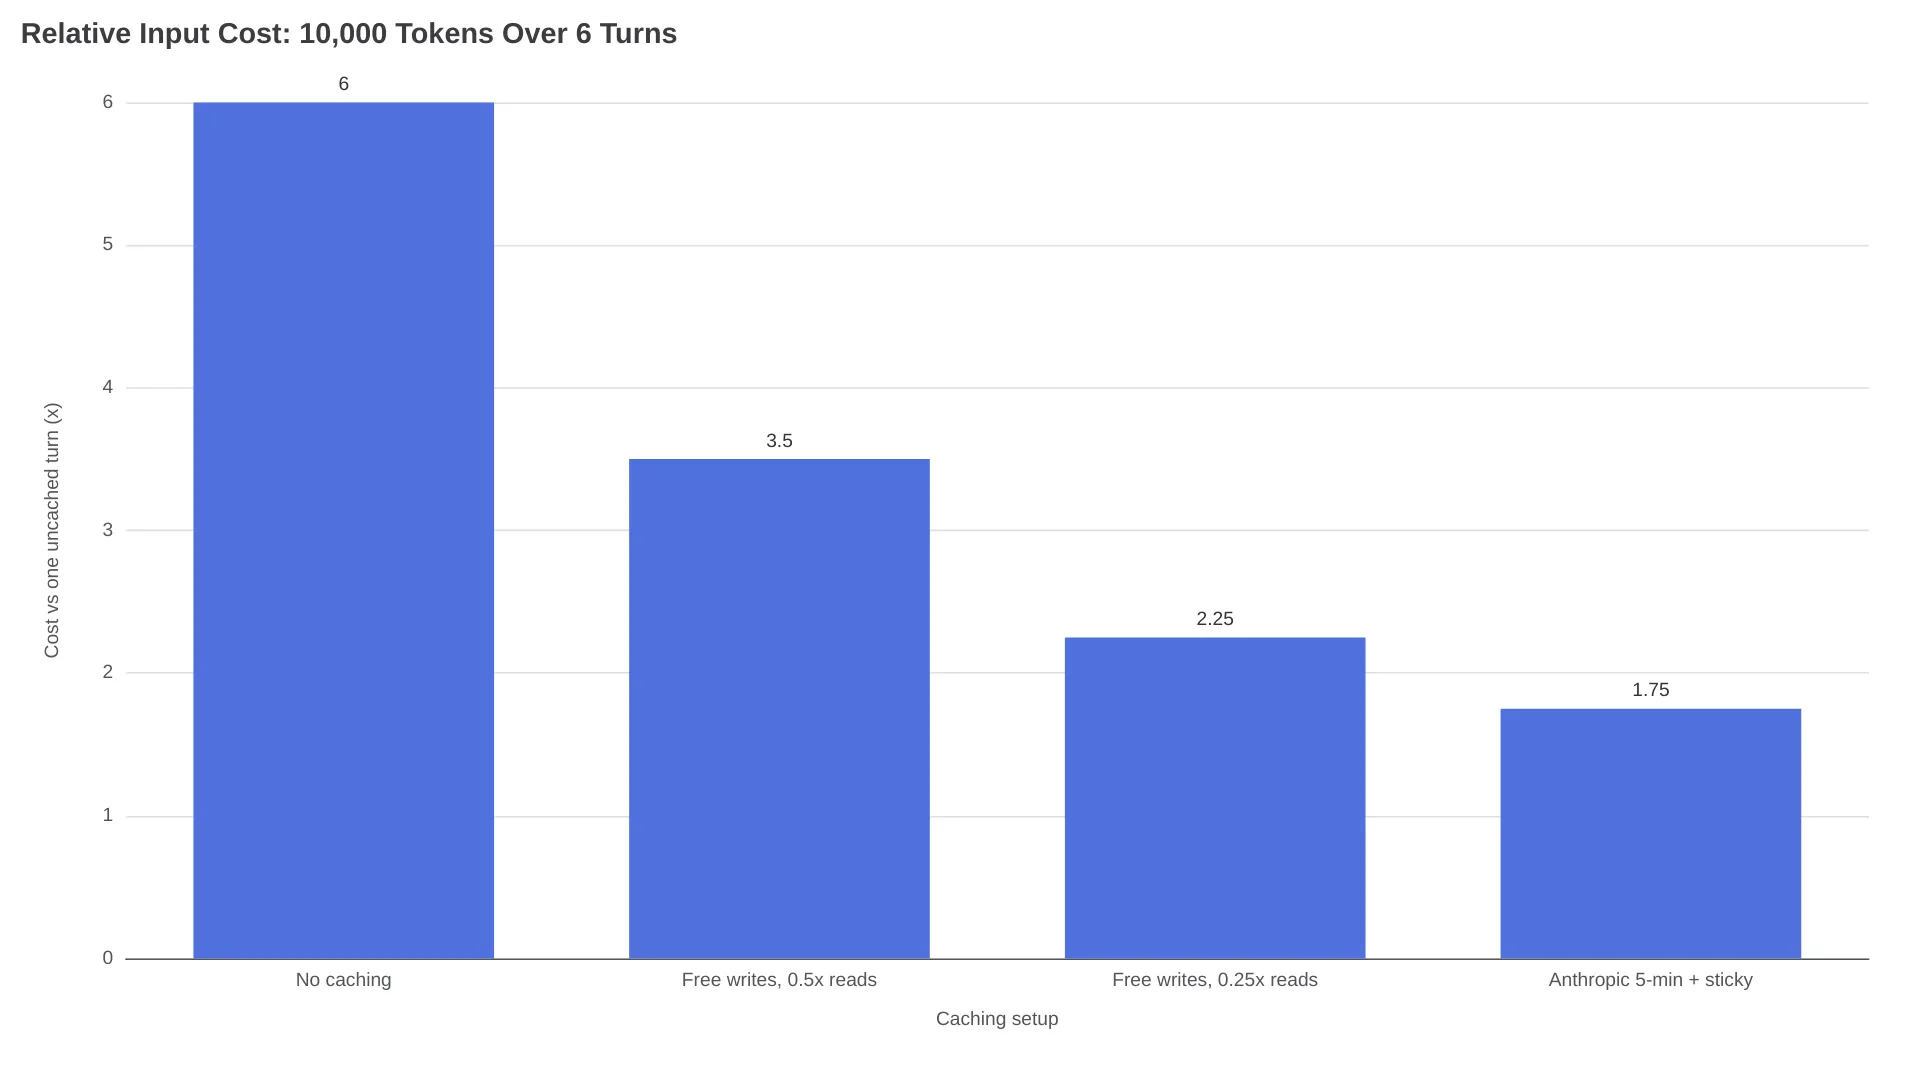
Anthropic'in pahalı yazması, ikinci turdan itibaren baskın hâle gelen 0,1x okuma maliyeti sayesinde altı turda avantajlı çıkıyor; tur sayısı arttıkça fark da açılıyor. Tek istisna, turlar arasında 5 dakikalık TTL'nin dolmasıdır: Her istekte 1,25x yazma ücretini yeniden ödersiniz. Bu, altı turda 7,5x ile cache kullanmamaktan daha kötüdür. Yazması ücretsiz bir sağlayıcıda 1,0x giriş maliyeti ise sadece cache'siz 6,0x seviyesine eşitlenir.
Debug öncesi ölçün: Hit'i kanıtlayan üç sayı
Her OpenRouter yanıtı, sonucu usage nesnesinde verir: cached_tokens, cache_write_tokens ve cache_discount. Alanların anlamları OpenRouter'ın caching rehberinde açıklanıyor. Herhangi bir ayarı değiştirmeden önce bu üç değeri okumak, gerçek bir cache miss'i fiyatlandırma sürprizinden ayırır. cached_tokens sıfırdan büyükse istek sıcak bir cache'e isabet etmiştir; sıfırsa Activity dashboard ne gösterirse göstersin hit yoktur.
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
Bu yanıt %99,8 hit anlamına gelir: 10.339 prompt token'ının 10.318'i cache'ten gelmiştir. cache_write_tokens, cache üreten ilk istekte görünür. cache_discount ise tasarruf miktarını raporlar ve Anthropic yazmalarında negatif olabilir; çünkü 1,25x yazma primi gerçek bir maliyettir ve sonraki okumalarla geri kazanılır. Aynı değerleri Activity içindeki generation detail görünümünden ya da /api/v1/generation üzerinden alabilirsiniz; nerede bulacağınızı activity dashboard rehberimiz anlatıyor.
Referans alınacak şey arayüz değil, ham metadata'dır. Bir SillyTavern kullanıcısı, logları doğrudan kontrol edene kadar aslında var olmayan bir cache sorununu takip etti:
"Ham openrouter metadata doğrudan
native_tokens_cached: 0[ve]usage_cache: nulldiyor." — u/HauntingWeakness
Bu üç sayı günler boyunca sıfır gösteriyorsa, aşağıdaki dört hata modundan biri cache'inizi tüketiyordur.
Sıcak cache'i soğutan dört sorun
OpenRouter dokümantasyonu ve topluluk deneyimleri, hit oranını çökerten dört yaygın neden üzerinde birleşiyor: Minimumun altındaki prompt'lar, turlar arasında TTL'nin dolması, ön ekin değişmesi ve sağlayıcı sürüklenmesi. Her birinin loglarda farklı bir izi ve farklı bir çözümü var.
1. Prompt, sağlayıcının minimum eşiğinin altında
Prompt caching destekleyen sağlayıcılar, modele özgü bir minimum token eşiği uygular. Örneğin 900 token'lık bir system prompt, hiçbir Claude modelinde cache'lenmez. Bu eşiği aşmak için prompt'u gereksiz metinle şişirmek de açıkça önerilmiyor: OpenRouter rehberinin ifadesiyle, "Sırf bunu zorlamak için isteği dolgu metniyle uzatmayın." Eşikler katalog genelinde dört kat fark gösterebiliyor:
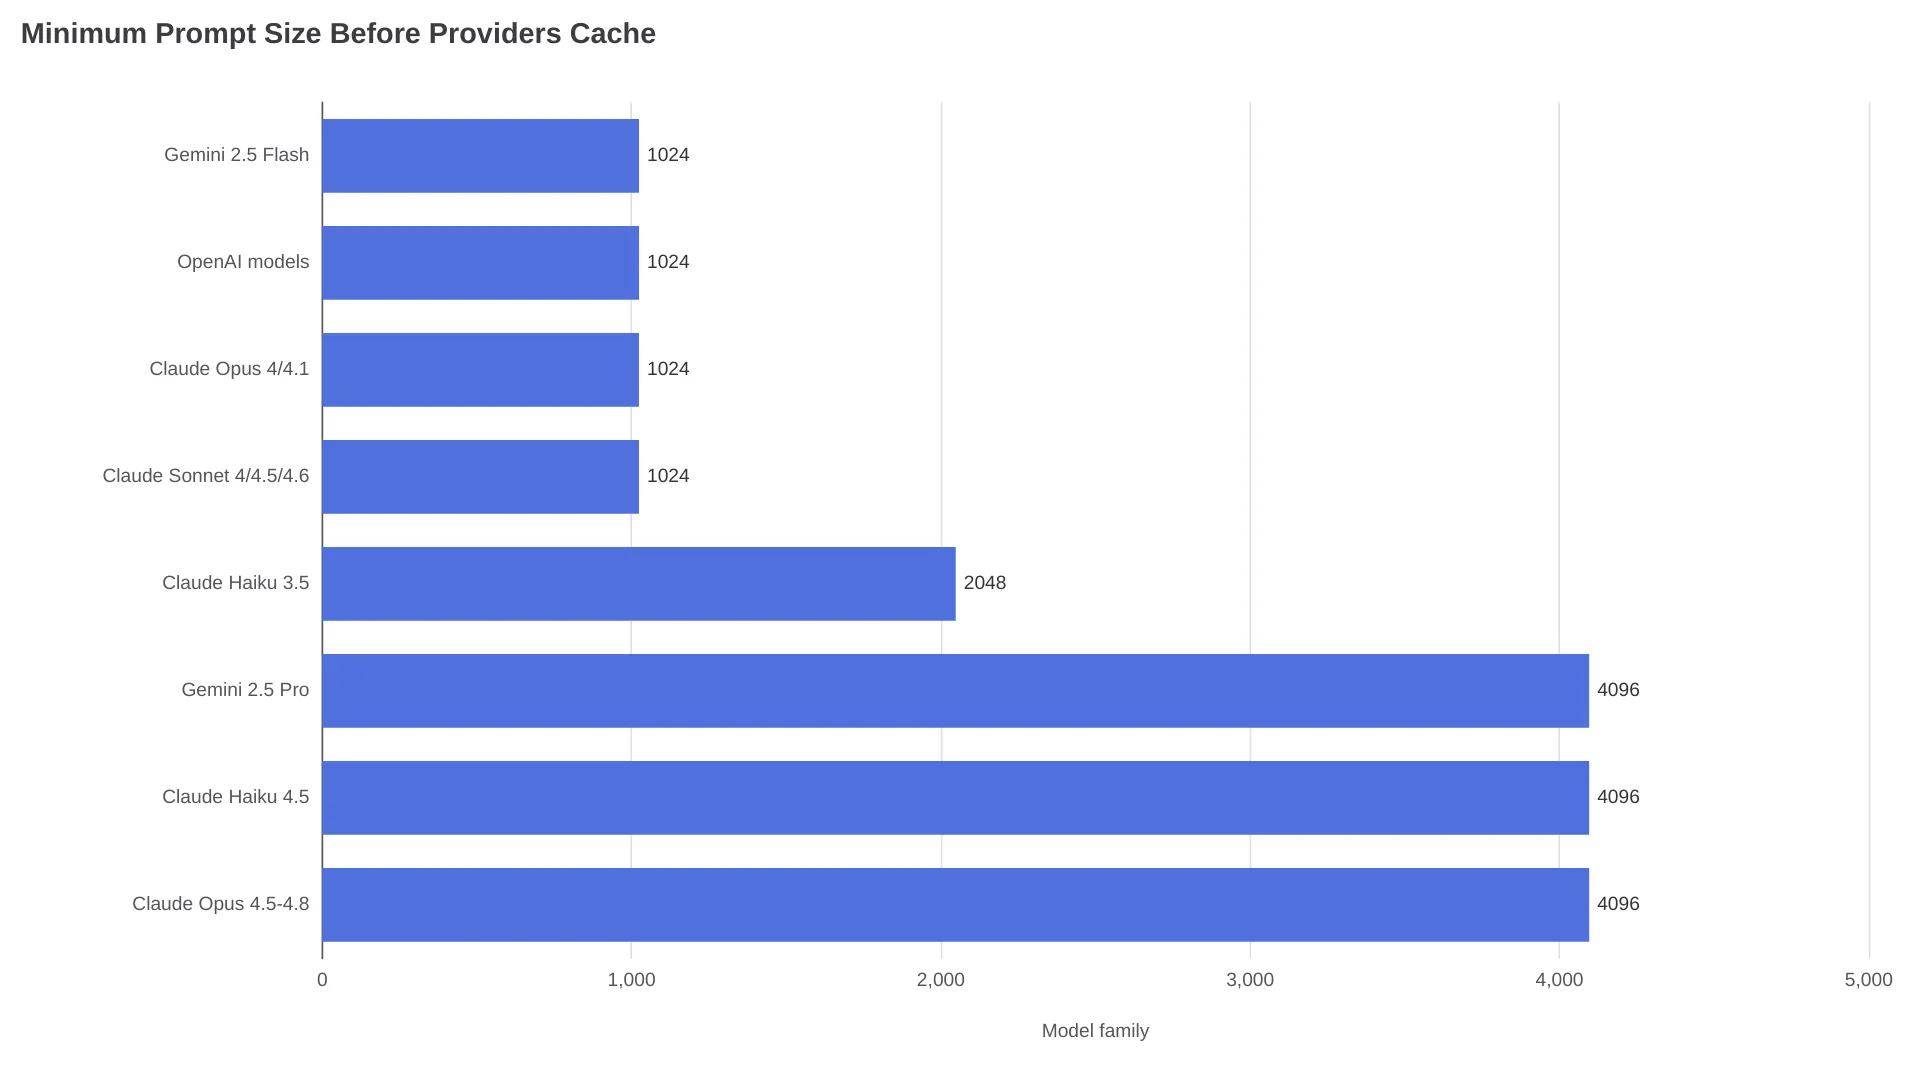
OpenRouter'ın sağlayıcı notlarına göre Claude Opus 4.5–4.8 ve Haiku 4.5'te cache'in devreye girmesi için 4.096 token gerekir. Sonnet 4/4.5/4.6 ile Opus 4/4.1 için bu eşik 1.024'tür. Gemini 2.5 Pro 4.096 token isterken Gemini 2.5 Flash 1.024 token ile çalışır; OpenAI modelleri de 1.024 token'dan itibaren cache'ler. Opus 4.8 üzerinde kısa prompt'lu bir iş yükü yapısal olarak cache'lenemez. Çözüm; statik içeriği (tool schema'ları, referans dokümanları, few-shot örnekleri) tek bir ön ekte toplamak veya daha düşük eşikli bir modele geçmektir.
2. Turlar arasında cache süresi doluyor
Anthropic'in varsayılan cache'i 5 dakika yaşar; 1 saatlik TTL ise 2x yazma maliyetine sahiptir. Gemini'nin örtük cache'i yaklaşık 3–5 dakika dayanır ve kritik nokta şu: OpenRouter rehberine göre okumalar sayacı sıfırlamaz. Sizi aynı sağlayıcıda tutan sticky session da 10 dakikalık hareketsizlikten sonra sona erer. Çağrılar arasında 5–6 dakika düşünen agent döngüleri, bu pencerelerin tamamını aşar:
"OpenRouter model test etmek için harika. Production agent'lar içinse sessizce berbat. Kirli sır şu: Gerçek iş yüklerinde caching fiilen sıfır." — @ran_cohenn, sticky affinity'nin 5–6 dakikalık agent aralıklarında sona ermesini ve ardından gelen tam cache miss'leri ile pahalı cache yazmalarını anlatırken
Oturum bir saat içinde devam ediyorsa, Anthropic'in 2x yazmalı 1 saatlik TTL'si her beş dakikada bir 1,25x yazma ücretini yeniden ödemekten iyidir. Kullanıcı araları yirmi dakikaya çıkıyorsa menüdeki hiçbir TTL bunu karşılamaz; caching yalnızca birbirine yakın turlardan oluşan bir burst içinde fayda sağlar.
3. Prompt ön eki fark etmeden değişiyor
OpenRouter, varsayılan conversation key'ini ilk system mesajı ile ilk system dışı mesajın hash'inden türetir. Prompt'un başlangıcında yapılan her değişiklik, o noktadan sonrası için cache'i geçersiz kılar. En sık karşılaşılan nedenler şunlar: System prompt'un üstüne enjekte edilen RAG context'i, ilk mesaja gömülen timestamp veya request ID'leri, her çağrıda yeniden yazılan tool definition'ları ve sohbet geçmişinin ortasına mesaj ekleyen frontend chat uygulamaları.
"Prompt'un başındaki bir şey sürekli değişiyorsa cache miss oranı artar." — u/Exact_Law_6489
Bazen değişiklik, sizin yazmadığınız araçlardan kaynaklanır. u/askchris, "Claude Code'un bende cache hit sorunlarına yol açtığını fark ettim; sanırım tool'ları enjekte etme biçiminden kaynaklanıyor," diyor. Gemini'nin de kendine özgü iki tuzağı var: OpenRouter, gönderdiğiniz son cache_control breakpoint'ini kullanır ve system instruction değiştirilemez, cache'lenmiş içerik olarak ele alınır. Dinamik materyal system prompt'un sonuna eklenmemeli, daha sonraki bir user mesajına taşınmalıdır. Her durumda çözüm aynı disiplindir: Statik system prompt, tool schema'ları ve referans dokümanları başa; istek başına değişen veri sona.
4. İstek, soğuk bir sağlayıcıya gitti
OpenRouter, kendi rehberine göre 70'ten fazla sağlayıcı arasında routing yapıyor. Prompt cache ise onu yazan endpoint'e özeldir. Sticky routing, takip isteklerini sıcak sağlayıcıya geri gönderir; ancak bu yalnızca sağlayıcının cache okuma ücreti normal giriş ücretinden düşükse geçerlidir. Elle belirlenmiş bir provider.order ise stickiness'i tamamen geçersiz kılar. Sağlayıcı hatası da pin'i kaldırır.
Topluluk verileri, bu sorunun etkisini açıkça gösteriyor:
- @bruceforai, aynı model adını farklı sağlayıcılarda ölçtü ve cache hit oranlarının %95,3'ten %0'a kadar indiğini gördü; bazı üçüncü taraf cache fiyatları resmi ücretin 10 katıydı.
- @Bryan_1269, OpenRouter üzerinden GLM 5.2 ile çok düşük hit oranı alırken aynı prompt'u doğrudan Fireworks üzerinden gönderdiğinde %85+'ı gördü.
- @miolini, OpenRouter routing'i için şunu söylüyor: "cache hit oranı gerçekten kötü, %1'den bile az."
OpenRouter'ın resmi tutumu, pinning'in çalıştığı yönünde: "Bir model veya sağlayıcı tarafından cache'lendiğinizde, cache süresi dolana kadar ona pin'lenirsiniz" (@OpenRouter). Bu açıklama dokümantasyonla da uyumlu; dolayısıyla yönetmeniz gereken konu pinning'in kendisinden çok sağlayıcılar arasındaki farktır.
cache_control nereye eklenir, ne onu yolda kaybeder?
OpenRouter üzerindeki Anthropic modellerinde iki caching yöntemi bulunur: Konuşma büyüdükçe otomatik ilerleyen tek bir üst seviye cache_control nesnesi — OpenRouter'ın çok turlu sohbetler için önerdiği yöntem budur — ve tool schema'ları, RAG dokümanları, CSV dump'ları veya character card'lar gibi büyük, sabit içerikler için tek tek content block'larına eklenen en fazla dört açık breakpoint. Üst seviye biçim Anthropic native, Vertex, Azure ve Bedrock genelinde çalışır. Bedrock API'si üst seviye alanı kabul etmediği için OpenRouter bunu sondaki bir breakpoint'e çevirir. Açık TTL ayarlamak için Responses değil, Chat Completions veya Anthropic Messages API kullanmalısınız.
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k tokens of tool schemas and reference docs>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI tarafı farklı çalışır: Caching 1.024 token'dan itibaren otomatiktir. Açık prompt_cache_breakpoint işaretçileri yalnızca GPT-5.6 ve daha yeni sürümlerde vardır; bunlar bir input_text veya text block'u üzerinde ayarlanır. TTL talep edildiğinde minimum süre 30 dakikadır.
Sağlayıcı notlarına göre OpenRouter, farklı şemalar arasında dönüşüm yapar: Anthropic cache_control işaretçisi OpenAI breakpoint'ine; OpenAI breakpoint'i ise varsayılan 5 dakikalık Anthropic işaretçisine dönüşür. TTL değerleri hiçbir zaman aktarılmaz. Qwen açık cache_control işaretçileri ister, 5 dakika cache'ler ve bunu yalnızca belirli modellerde destekler (qwen3-max, qwen-plus, qwen3-coder-plus ve diğerleri; qwen3.5-plus-02-15 gibi snapshot'lar hariçtir).
Daha sessiz ilerleyen bir başka hata da uygulamanız ile OpenRouter arasındaki bazı client ve gateway'lerin standart dışı alanları iletmeden önce silmesidir:
"Gateway'lerin arkasında anthropic prompt caching'in sıfıra düşmesi genellikle bir marshalling hatasıdır. ... cache_control işaretçileri openrouter'a iletilmeden önce sessizce siliniyor. Şema uzantılarını atarak sağlayıcıları soyutlayamazsınız." — @SiddharthInk_
İşaretçinin ulaştığını doğrulayın: Activity'deki generation detail ekranında ham request metadata'sını inceleyin veya araya hiçbir katmanın girmediği tek bir curl test isteği gönderin. Mesajları tek bir blob'a dönüştüren araçlar, breakpoint'leri ne kadar doğru yerleştirmiş olursanız olun yok eder. OpenRouter'ın examples repo'sunda işaretçileri koruyan, çalıştırılabilir TypeScript, Vercel AI SDK ve Effect örnekleri bulunuyor.
Sağlayıcıyı sabitleyin: session_id ve provider order
Kararlı bir session kimliği, routing tarafındaki en güçlü araçtır. session_id, henüz herhangi bir cache hit görülmeden önce bile takip isteklerini ilk başarılı isteği karşılayan sağlayıcıya pin'ler. Bu değer olmadan stickiness ancak ilk tespit edilen cache hit'ten sonra başlar. Varsayılan kimlik ise ilk system mesajı ile ilk system dışı mesajın hash'idir; ön ekteki her değişiklikte sessizce farklı bir kimliğe dönüşür. Bu da üçüncü hata modunu yeniden tetikler; ayrıntılar OpenRouter'ın routing dokümantasyonunda yer alıyor.
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}
Bilmeniz gereken ayrıntılar: session_id, request body içinde veya x-session-id header'ında gönderilir. İkisi de varsa body önceliklidir; üst sınır 256 karakterdir. Hiçbiri yoksa OpenRouter, OpenAI tarzı prompt_cache_key değerine geri döner.
Dokümantasyondaki iki önemli uyarı: Sağlayıcı hataları pin'i kaldırır. Ayrıca Batch API satırları eşzamanlı ve sırasız çalışır; bu yüzden bir satırdaki cache yazması sonraki satır tarafından görülmez. Batch'ler arasında "ttl": "1h" olan bir ön eki paylaşın veya önce eşzamanlı tek bir istekle cache'i ısıtın. (Auto Router rehberi, Auto Router'ın çözümlenen modeli en iyi çabayla nasıl yeniden kullandığını anlatıyor.)
Yalnızca pinning yeterli değilse sağlayıcı kümesini doğrudan daraltın:
"Bulduğum çözüm, tercih sırasına göre kullanılacak bir sağlayıcı listesi tanımlamak." — u/nabil9506
Ucuz cache okuması sunan iki veya üç sağlayıcıdan oluşan bir provider.order listesi, failover kapsamının bir kısmını cache yerelliği karşılığında feda eder. Agent iş yükleri için bu makul bir takastır. u/welcome_to_milliways, manuel kurulum yükünü "OR'da oldukça temel bir kusur" olarak nitelendiriyor. Katılırsınız ya da katılmazsınız, mevcut çalışma sözleşmesi bu.
Router üzerinden caching ne zaman mantıklı değil?
OpenRouter üzerinden prompt caching, kolay tanınan üç durumda avantajını kaybeder: Modelin token eşiğine hiç ulaşmayan prompt'lar, mevcut tüm TTL'lerden daha uzun aralar veren oturumlar ve yazma primini indirimli okumayla hiç amorti edemeyen tek seferlik istekler. Dördüncü bir durum da vardır: cache_control'ü router'a ulaşmadan silen ve değiştiremediğiniz araçlar. @grapeot, gateway katmanında caching başarısız olduğunda maliyet farkının routing ücretinin kendisini gölgede bırakacak şekilde bir büyüklük mertebesine ulaştığını belirtiyor.
Cache'in kritik olduğu ve yukarıdaki çözümlerin hiçbirinin uygulanamadığı iş yüklerinde router yerine tek, sabit bir upstream daha iyidir: Davranış deterministiktir ve yönetilecek bir pinning yoktur. Sağlayıcı sürüklenmesini çözemiyorsanız Anthropic'in kendi caching özelliğine sahip doğrudan Claude API endpoint'i net bir çıkış yoludur.
Hesap düzeyindeki Zero Data Retention, response caching'i tamamen devre dışı bırakır. ZDR altında prompt caching için ise OpenRouter'ın örtük caching'in veri saklama sayılıp sayılmadığına ilişkin analizi kontrol edilmesi gereken kaynaktır.
İzlenecek çözüm sırası
Ölçüm sırasıyla ilerlemek, en az değişiklikle tasarrufun büyük bölümünü geri kazandırır. Önce doğrulayın; ardından prompt'tan routing'e ve TTL'ye doğru katman katman ilerleyin:
| # | Yapılacak işlem | Netleştirdiği konu |
|---|---|---|
| 1 | Birkaç gerçek istekte cached_tokens ve cache_discount değerlerini okuyun | Hit oranı sorunu mu, fiyat beklentisi sorunu mu? |
| 2 | Prompt boyutunu modelin token eşiğiyle karşılaştırın | Diğer her şeyden önce "asla cache'lenemez" durumunu eler |
| 3 | Ön eki sabitleyin: Statik system prompt, schema'lar ve dokümanlar önce; timestamp'ler ve RAG en son | Sessiz geçersiz kılma sınıfını ortadan kaldırır |
| 4 | Bir konuşmadaki her istekte session_id gönderin | İlk hit'ten sonra değil, ilk turdan itibaren sağlayıcı pinning'i sağlar |
| 5 | provider.order ayarını ucuz cache okuması olan iki veya üç sağlayıcıyla sınırlayın | Sağlayıcılar arası sürüklenmeyi kaldırır |
| 6 | "ttl": "1h" ekleyin (Anthropic) veya uzun oturumlar için yazması ücretsiz bir sağlayıcıya geçin | Turlar arasında sürenin dolmasını ele alır |
1–3. adımlar kod tarafında kontrol edebildiğiniz hata sınıflarını temizler. 4–6. adımlar ise %1'in altındaki raporlarla %82,8'lik başlığı uzlaştırır. İlgili okumalar: Cache'lenen token'ların faturaya nasıl yansıdığını anlatan OpenRouter fiyatlandırma rehberi, model pinning davranışı için Auto Router rehberi ve hit oranlarını zaman içinde izlemek için activity dashboard rehberi.