 AIREITER
30B parametreli yoğun bir çok modlu model, tek bir RTX 3090 üzerinde 262K'lık tam bağlamla çalışabilir mi? Meta'nın 10 Ağustos 2026'da yayınladığı Muse Glimmer için yerel yapay zekâ topluluğunun ilk baktığı konu buydu. Sonuç: DFlash ile RTX 5090'da 236 tok/s sunuyor ve tek RTX 3090'a sığıyor. Buna karşılık TerminalBench 2.1'de Qwen 3.6 27B'nin 9 puan gerisinde kalıyor; işletim sistemi düzeyindeki otomasyon görevlerini reddetme eğilimi de var.
Muse Glimmer 30B nedir?
Muse Glimmer, Meta Superintelligence Labs'in Apache 2.0 lisansıyla yayınladığı, 30B parametreli yoğun çok modlu bir model. Kodlama liderlik tablolarının zirvesine oynamaktan ziyade, yerelde sürekli çalışan ajan iş akışları için tasarlanmış. Model; 27.9B'lik metin çözücüyü, 1.9B ViT görüntü kodlayıcısıyla ve GELU tabanlı çok modlu projektörle bir araya getiriyor. Böylece hem metni hem görüntüleri anlayabiliyor. Aşağıdaki mimari ayrıntıları SGLang'in Day-0 destek yazısından alınmıştır.
Mimari özeti
| Özellik | Ayrıntı |
|---|---|
| Toplam parametre | 30B |
| Metin çözücü | 27.9B yoğun |
| Görüntü kodlayıcı | 1.9B ViT |
| Transformer katmanı | 52 |
| Attention | Grouped-query (32 sorgu başlığı, 2 KV başlığı - 16:1 GQA) |
| Feed-forward | SwiGLU |
| Bağlam penceresi | 128K+ (262K'ya kadar test edildi) |
| Lisans | Apache 2.0 |
Mimari hibrit bir attention yaklaşımı kullanıyor: Her dört adımda, üç adet 2,048 token'lık sliding-window-attention katmanını bir tam dizi attention katmanı izliyor. Bu yapı, yerel pencere katmanlarında RoPE'u; tam attention katmanlarında ise NoPE'u birleştirerek eğitim sınırının ötesine bağlam genişletmeye imkân tanıyor. 16:1 grouped-query attention oranı KV önbelleğini küçük tutuyor. Bir topluluk ölçümünde, F16'da 131K token için yaklaşık 1.8 GiB görülüyor. Bu nedenle model, aynı F16 yapılandırmasında 24 GB GPU üzerinde tam uzunlukta bağlamı koruyabiliyor; Qwen 3.6 27B ise 70K token'da kalıyor.
Muse Glimmer donanımınızda çalışır mı?
Bu sorunun yanıtı büyük ölçüde seçtiğiniz quantization yöntemine bağlı. SGLang, BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic ve MLX 4-bit biçimlerinde resmî checkpoint'ler sunuyor. Topluluk testlerinde model, çok düşük VRAM'li sistemler için 2-bit GGUF'a kadar indirildi.
Yapılandırmaya göre VRAM ihtiyacı
| Yapılandırma | Yaklaşık VRAM | Hedef donanım |
|---|---|---|
| BF16 | ~60 GB | Tek H100 |
| NVFP4 + MXFP8 | ~19.5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + 262K bağlam | ~22-23 GB | RTX 3090 (24 GB) |
| 2-bit GGUF | ~14 GB | RTX 4060 Ti / giriş seviyesi |
| MLX Q4 (Apple Silicon) | Birleşik bellek | Mac mini / MacBook Pro |
Bir Reddit kullanıcısı, DFlash speculative decoding, çok modlu projection dosyası ve F16 KV cache ile Q4_K_XL formatındaki Muse Glimmer'ın tek RTX 3090 üzerinde 22-23 GB'a rahatça sığdığını gösterdi. Üstelik 262,144 token'lık tam bağlam da aktifti. İlk denemede yaklaşık 150K token'lık bir yığın içinde iki ayrı iğneyi buldular.
Karşılaştırma için, aynı RTX 3090'da Qwen 3.6 27B F16 KV cache ile yalnızca 70K token'a ulaşıyor; Q8 KV cache ile bu değer 125K oluyor. Gemma 4 31B ise F16'da 52K, Q8'de 81K seviyesinde. Muse Glimmer'ın aynı donanımda daha fazla bağlam taşıyabilmesinin başlıca nedeni, 16:1 GQA oranının getirdiği KV cache verimliliği.
Kurulum seçenekleri: NVIDIA tarafında NVFP4 veya GGUF checkpoint ile SGLang ya da llama.cpp kullanın ve --speculative-algorithm DFLASH seçeneğini etkinleştirin. Apple Silicon için MLX backend kullanılmalı; DFlash burada mevcut değil. 96 GB birleşik belleğe sahip bir M3 Max kullanıcısı, 17 token/s gördüğünü ve Muse Glimmer'ın kendi sisteminde hem Qwen'den hem Gemma'dan hızlı olduğunu bildirdi.
Muse Glimmer ne kadar hızlı?
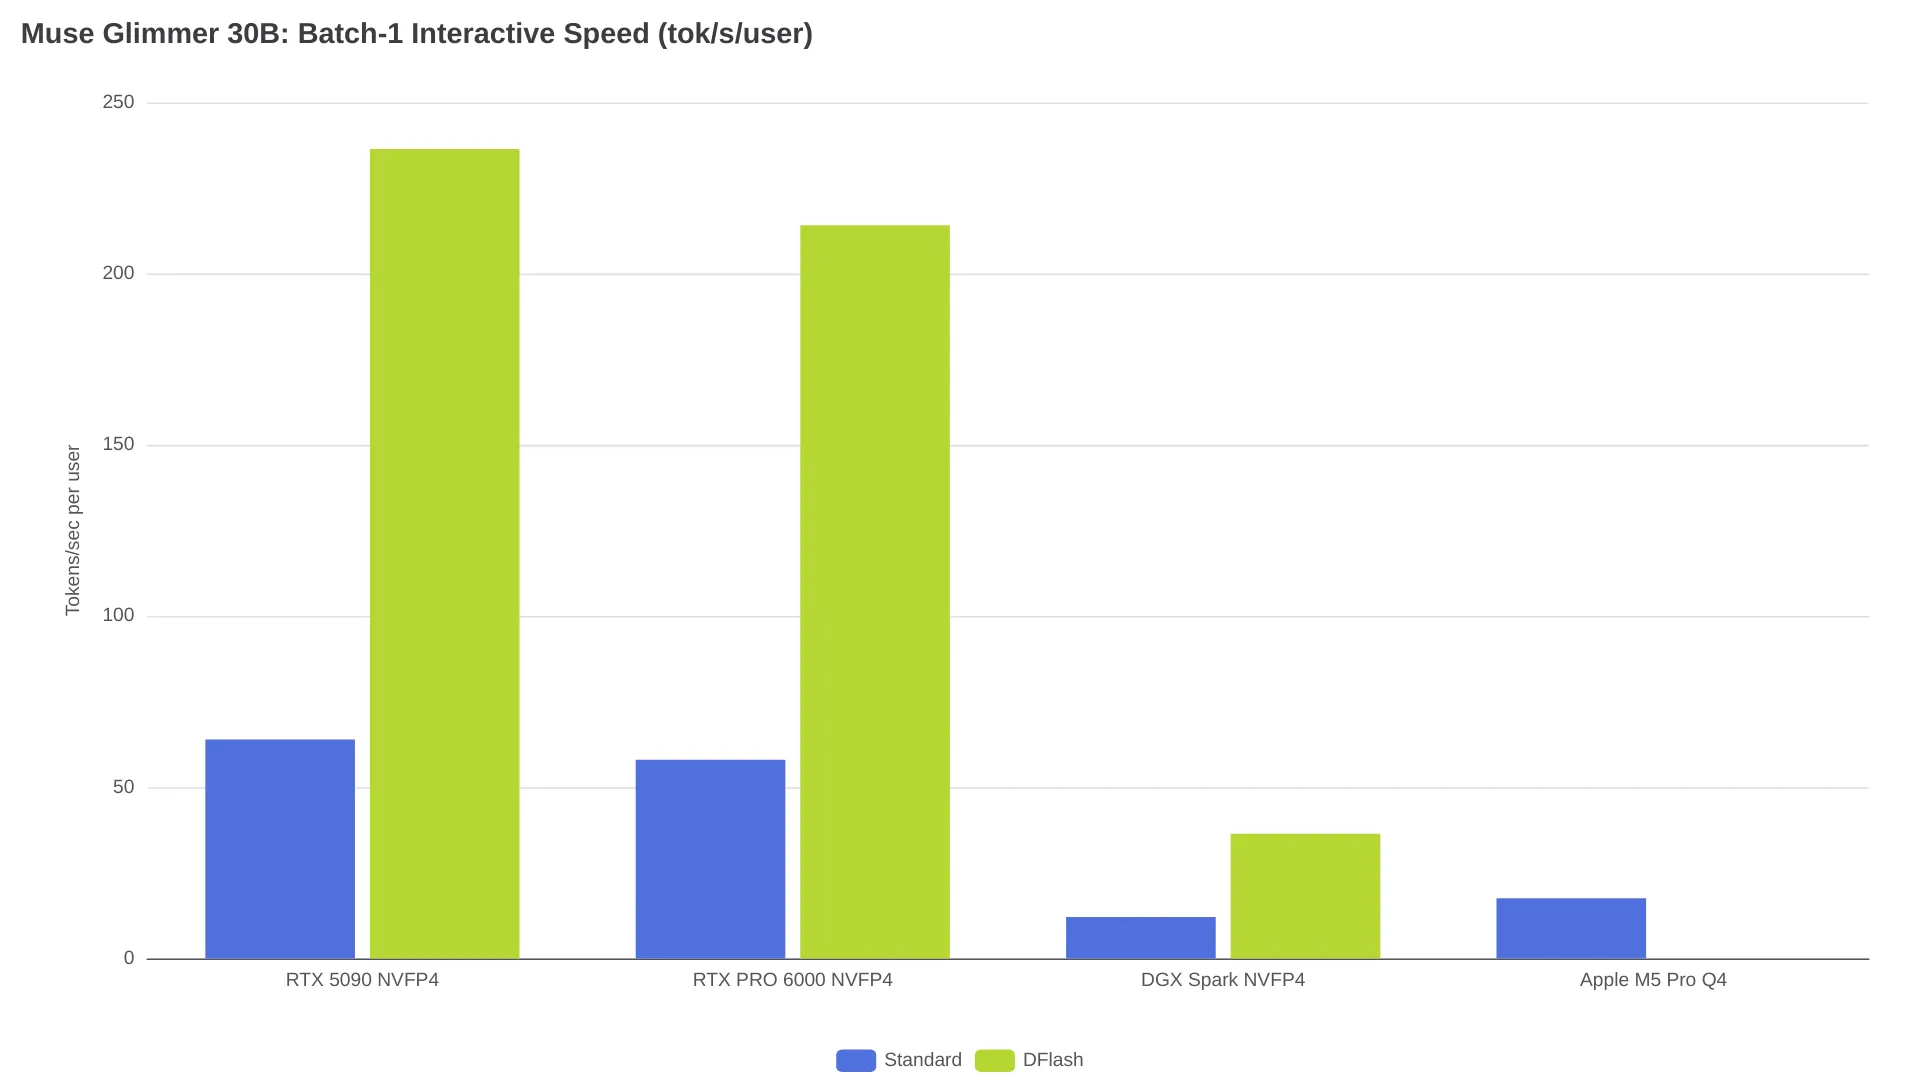
SGLang, 1'den 8'e kadar batch boyutlarını tarayarak yedi farklı donanım yapılandırması için benchmark tablosu yayınladı. --speculative-algorithm DFLASH ile etkinleştirilen DFlash speculative decoding, NVIDIA platformlarında batch-1 etkileşimli çıktıda 1.9x ile 4.3x arasında hız artışı sağlıyor.
Öne çıkan SGLang benchmark sonuçları
| Platform | Hassasiyet | Decoding | Batch-1 tok/s/kullanıcı | Batch-8 tok/s |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Standart | 17.6 | 56.9 |
RTX 5090'da batch 8 ile ulaşılan 1,452 çıktı token/s değeri toplam throughput'u ifade ediyor. Tek kullanıcılı yerel çıkarım için esas alınması gereken değer, NVFP4 ve DFlash ile elde edilen 236 tok/s. DFlash kapatıldığında aynı yapılandırma 63.9 tok/s'ye düşüyor. Topluluk raporları da bunu destekliyor: Unsloth'un Q5_K_M quantization'ını kullanan bir RTX 5090 kullanıcısı 220-253 token/s bildirdi.
DFlash performansı draft kabul oranlarına bağlı. Vulkan/RX 7900 XTX ve SYCL/B70 kullananlar, düşük draft kabul oranı ve sonuçta daha yavaş toplam throughput bildirdi.
Muse Glimmer mı, Qwen 3.6 27B mi?
TerminalBench 2.1 sonuçları
| Model | TerminalBench 2.1 | RTX 3090'da bağlam (F16 KV) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K token |
| Muse Glimmer 30B | 51.7 | ~262K token |
| Gemma 4 31B | 43.4 | ~52K token |
TerminalBench 2.1 skorları topluluk tartışmasından alınmıştır. Bağlam değerleri RTX 3090 testlerine dayanmaktadır.
Topluluk üyelerinin çoğunun, modelin uzun görevlerde güvenilir terminal komutları çalıştırıp çalıştıramadığını değerlendirmek için kritik gördüğü TerminalBench 2.1'de Qwen 3.6 27B 9 puan önde. Doğrudan kodlama testlerinde de fark korunuyor: Bir kullanıcının özel değerlendirme setinde Qwen 12/13, Glimmer ise 11/13 aldı. Qwen, Tokyo turizmi için 953 satırlık sayfayı ilk denemede doğru üretirken Glimmer 200 satırın altında kaldı (tam başlık).
"Qwen 3.6 27B'ye yaklaşamıyor bile" - Reddit kullanıcısı BarberIcy366, Glimmer'ın 21,000 token harcayarak 8-ball pool oyunu için yalnızca 220 satır HTML üretmesinin ardından (r/LocalLLaMA). Aynı başlıkta, MTP etkin Qwen 3.6 27B'nin bir Tetris uygulamasını 1.7x daha hızlı tamamladığı da bildiriliyor.
Bununla birlikte Glimmer'ın belirli alanlarda gerçek avantajları var:
- Bağlam kapasitesi: Aynı F16 KV ayarında tek RTX 3090 üzerinde Qwen'in 70K token'ına karşılık 262K token; büyük kod tabanlarında 3.7x avantaj.
- KV cache verimliliği: 16:1 GQA oranı, Glimmer'ın KV cache'ini kayda değer biçimde küçültüyor ve bağlam için daha fazla VRAM bırakıyor.
- Görüntü yeteneği: Glimmer kutudan çıktığı hâliyle çok modlu; Qwen 3.6 27B'nin temel sürümü yalnızca metin odaklı.
- MCP ve araç destekli soru-cevap: Bir kullanıcı, Glimmer'ın terminal kodlamada Qwen'in gerisinde olmasına rağmen MCP destekli kod tabanı arama ve soru-cevap iş akışlarında potansiyel gösterdiğini bildirdi.
- Yazı kalitesi: Birden fazla kullanıcı, Glimmer'ın doğal dil çıktısını Qwen'inkine tercih etti.
Bir yorumcu bu dengeyi şöyle özetledi: Glimmer, "Qwen 3.6 27B artı %5 yazım tarzı ve eksi %5 ajan yeteneği."
Kısa karar
Ana iş yükünüz tek seferlik kod üretimi veya otonom terminal ajanları ise Qwen 3.6 27B hâlâ daha güçlü tercih. TerminalBench 2.1'de 9 puan daha yüksek skor alıyor ve Glimmer'ın işletim sistemi düzeyindeki otomasyonda yaşadığı güvenlik kaynaklı retleri göstermiyor. Tek bir tüketici GPU'sunda uzun bağlamlı bilgi getirme, çok modlu girdi veya MCP destekli iş akışları arıyorsanız Muse Glimmer'ı denemeye değer. Güvenilir terminal otomasyonu gerekiyorsa topluluk fine-tune'larını bekleyin.
Bilinen sorunlar ve dikkat edilmesi gerekenler
max_tokens tuzağı
Muse Glimmer, çıktı üretmeden önce token bütçesinin önemli bölümünü iç muhakemeye ayırıyor. max_tokens çok düşük ayarlanırsa model düşünce ortasında bütçesini tüketip boş yanıt döndürebiliyor. Bir kullanıcı, değerlendirme setinde Glimmer'a başlangıçta 6/13 vermişti; çıktı token bütçesini artırınca skor 11/13'e çıktı (kaynak başlık). Muhakeme yükünü karşılayacak kadar yüksek bir max_tokens değeri belirleyin; aksi hâlde yanıtlar düşünce ortasında sonlanabilir.
İşletim sistemi otomasyonunda güvenlik retleri
Birden fazla kullanıcı, Muse Glimmer'ın fare kontrolü, klavye otomasyonu veya işletim sistemi düzeyindeki diğer araç çağrılarını içeren görevleri reddettiğini bildiriyor. İstek standart Python kütüphanelerinin kullanımını içerse bile model bunları olası güvenlik riski olarak değerlendiriyor.
"Fareyi programatik olarak hareket ettirmek otomasyon, clickjacking veya güvenlik istemlerini atlatmak için kötüye kullanılabilir." - Reddit kullanıcısı Cold_Tree190 tarafından bildirilen Muse Glimmer reddi (r/LocalLLaMA)
Kullanım amacını daha ayrıntılı açıklayan yeni bir oturum başlatmak bazen reddi çözebiliyor. Ancak model bir oturum içinde talebi zaten geri çevirdiyse genellikle bu tutumunu koruyor.
Tutarsız araç çağırma davranışı
Topluluk raporlarında araç çağırma güvenilirliği, bir C kod tabanında "bir kez bile başarısız olmadı" seviyesinden, başka kurulumlarda bitmeyen döngülere ve boş API yanıtlarına kadar değişiyor. Bazı yapılandırmalarda Unsloth Q4 ve Q5 quant'larının araç çağırma sırasında yoğun biçimde döngüye girdiği bildirildi. Buna karşılık 24 GB ve 32 GB VRAM hedefleyen resmî GGUF'ler daha güvenilir davranabilir (kaynak başlık).
Bölgesel indirme kısıtlamaları
Resmî Hugging Face sayfasının Hong Kong, Makao ve Çin'deki indirmeleri devre dışı bıraktığı bildiriliyor. Alternatif olarak Unsloth tarafından sunulan üçüncü taraf GGUF dağıtımları erişilebilir durumda.
İlgili içerikler: Muse Spark 1.2 API fiyatlandırma rehberi | 2026 için programlamaya yönelik en iyi ücretsiz OpenRouter modelleri