 AIREITER
Çok vektörlü embedding modelleri artık Sentence Transformers ekosisteminde kenarda duran bir seçenek değil. 18 Ağustos 2026'da duyurulan 6.0 sürümü, dense, sparse ve reranker modellerinin yanına MultiVectorEncoder'ı da ekledi. Ancak Hugging Face'in lansman verileri, heyecanın yanında önemli bir maliyet tablosu da çiziyor: Late interaction, aynı altyapıyı kullanan dense eşini 13 NanoBEIR veri setinin 9'unda geçti, fakat ortalama fark yaklaşık bir NDCG@10 puanıydı. Buna karşılık örnek indeksteki ham boyut, 384 boyutlu MiniLM taban çizgisinin 42 katına; aynı sınıftaki dense modelin ise 21 katına çıkıyor. Bu takasın mantıklı olup olmadığı neredeyse tamamen sorgularınızın yapısına bağlı.
Çok Vektörlü ve Late Interaction Embedding Nasıl Çalışır?
Dense embedding yaklaşımı, bir belgenin tamamını tek bir havuzlanmış vektöre indirger. Çok vektörlü modeller ise belgeyi tek vektörde özetlemek yerine her token için ayrı bir vektör saklar. Hugging Face'in desteklediği modellerde token vektörleri genellikle 128 boyutludur; geleneksel dense embedding'lerde ise 384, 768 ya da 1.024 boyut daha yaygındır. Skorlama aşamasında MaxSim, her sorgu token'ı için belge içindeki en yüksek nokta çarpımını bulur ve bu maksimumları toplar: MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). Modeller L2-normalize olduğundan her bileşen [-1, 1] aralığındadır; nihai skor da sorgu uzunluğuyla birlikte büyür.
Bu yaklaşım, özelliklerini aldığı iki mimarinin tam ortasında konumlanır:
| Mimari | Belge tarafı | Skorlama | Maliyet profili |
|---|---|---|---|
| Dense bi-encoder | Önceden hesaplanmış tek havuzlanmış vektör | Tek nokta çarpımı | En hızlı getirme; havuzlama token ayrıntısını kaybettirir |
| Late interaction | Önceden hesaplanmış, token başına bir vektör | Token çiftleri üzerinde MaxSim | Zengin eşleşme; indeks belge uzunluğuyla büyür |
| Cross-encoder | Önceden hesaplanan temsil yok | Her sorgu-belge çifti için tam forward pass | Hugging Face'in lansman yazısında çift bazında en doğru yaklaşım; ilk aşama için fazla maliyetli |
Bu yaklaşımın temeli, özgün ColBERT makalesinde "contextualized late interaction" adıyla formüle edilmişti.
Avantaj token düzeyinde belirginleşiyor. Hugging Face'in lightonai/mLateOn örneğinde sorgudaki "live" token'ı, belgede geçen "inhabit" token'ıyla 0.94 benzerlikte eşleşiyor. İki sözcük arasında doğrudan leksik örtüşme olmamasına rağmen anlamsal bağ kurulabiliyor.
Çok Vektörlü Modellerin Asıl Güçlü Olduğu Senaryolar
Kısa pasaj benchmark'ları, bu modellerin hangi işlerde gerçekten değer ürettiğini tam yansıtmıyor. Bu yazı için karşılaştırılan beş kaynakta — Hugging Face'in lansman yazısı, TopK, Qdrant'ın mühendislik incelemesi, Data AI Hub üretim rehberi ve Suhas Bhairav'ın üretim araması karşılaştırması — aynı kullanım alanları tekrar öne çıkıyor:
- Anlamsal aramada kesin tanımlayıcılar. Ürün kodları, fonksiyon adları, soyadları, hata mesajları ve madde numaraları gibi ifadeler. Havuzlanmış vektörler bunları bulanıklaştırabilir; token başına temsil ise erişilebilir tutar.
- Birden fazla koşul içeren sorgular. "X, Y ve Z ile" türü sorgularda her sorgu token'ı kendisini destekleyen belge token'ını bağımsız biçimde bulabilir. Böylece koşullardan biri ortalamada kaybolmaz.
- Cevabın küçük bir bölümde saklandığı uzun belgeler. Çok dilli uzun belge benchmark'ı MLDR'de çok vektörlü
mLateOn,mDenseOn'un 51.59 skoruna karşı 77.92 aldı. Bu fark, kısa pasaj ortalamalarındaki farkın bir büyüklük mertebesi üzerinde. - PDF'ler, tablolar ve taranmış sayfalar. ColPali ailesi, OCR adımına gerek duymadan sayfa görsellerini doğrudan metin sorgularıyla indeksleyebiliyor. Hugging Face lansman yazısı görsel belge getirmeyi late interaction'ın state-of-the-art alanı olarak tanımlıyor. TopK analizi ise kompakt bir çok vektörlü retriever'ın, kendisinden 80 kat büyük tek vektörlü modeli ViDoRe v3'te +34% recall farkıyla geçtiğini; endüstriyel belge recall'ının yaklaşık %42'den %76'ya yükseldiğini bildiriyor.
- Alan dışı kelime dağarcığı. Hugging Face, dense modelin öğrenilmiş sıkıştırmasının üretim sorgularınız için gerekli ayrıntıları eleyebildiği alan dışı verilerde kazanımlar raporluyor.
Görsel belge getirme neden bu yapıya bu kadar uygun, Hugging Face'in rakamlarında da görülüyor: İşlenmiş bir sayfa, colqwen2.5-v0.2 için yaklaşık 755 token vektörü üretiyor; ortalama bir metin pasajında ise bu sayı yaklaşık 125. Grafik, yerleşim ve tablo arttıkça tek bir havuzlanmış vektörün atması gereken bilgi de artıyor.
Kalite Artışı Var, Ama Hype'ın Söylediği Kadar Büyük Değil
En temiz karşılaştırma LightOn'ın eşleştirilmiş ikilisinden geliyor: LateOn ve DenseOn, aynı 149M parametreli ModernBERT omurgasını ve aynı eğitim verisini kullanıyor. Aralarındaki tek fark başlık katmanı: biri 128 boyutlu token vektörleri, diğeri tek bir 768 boyutlu belge vektörü üretiyor.
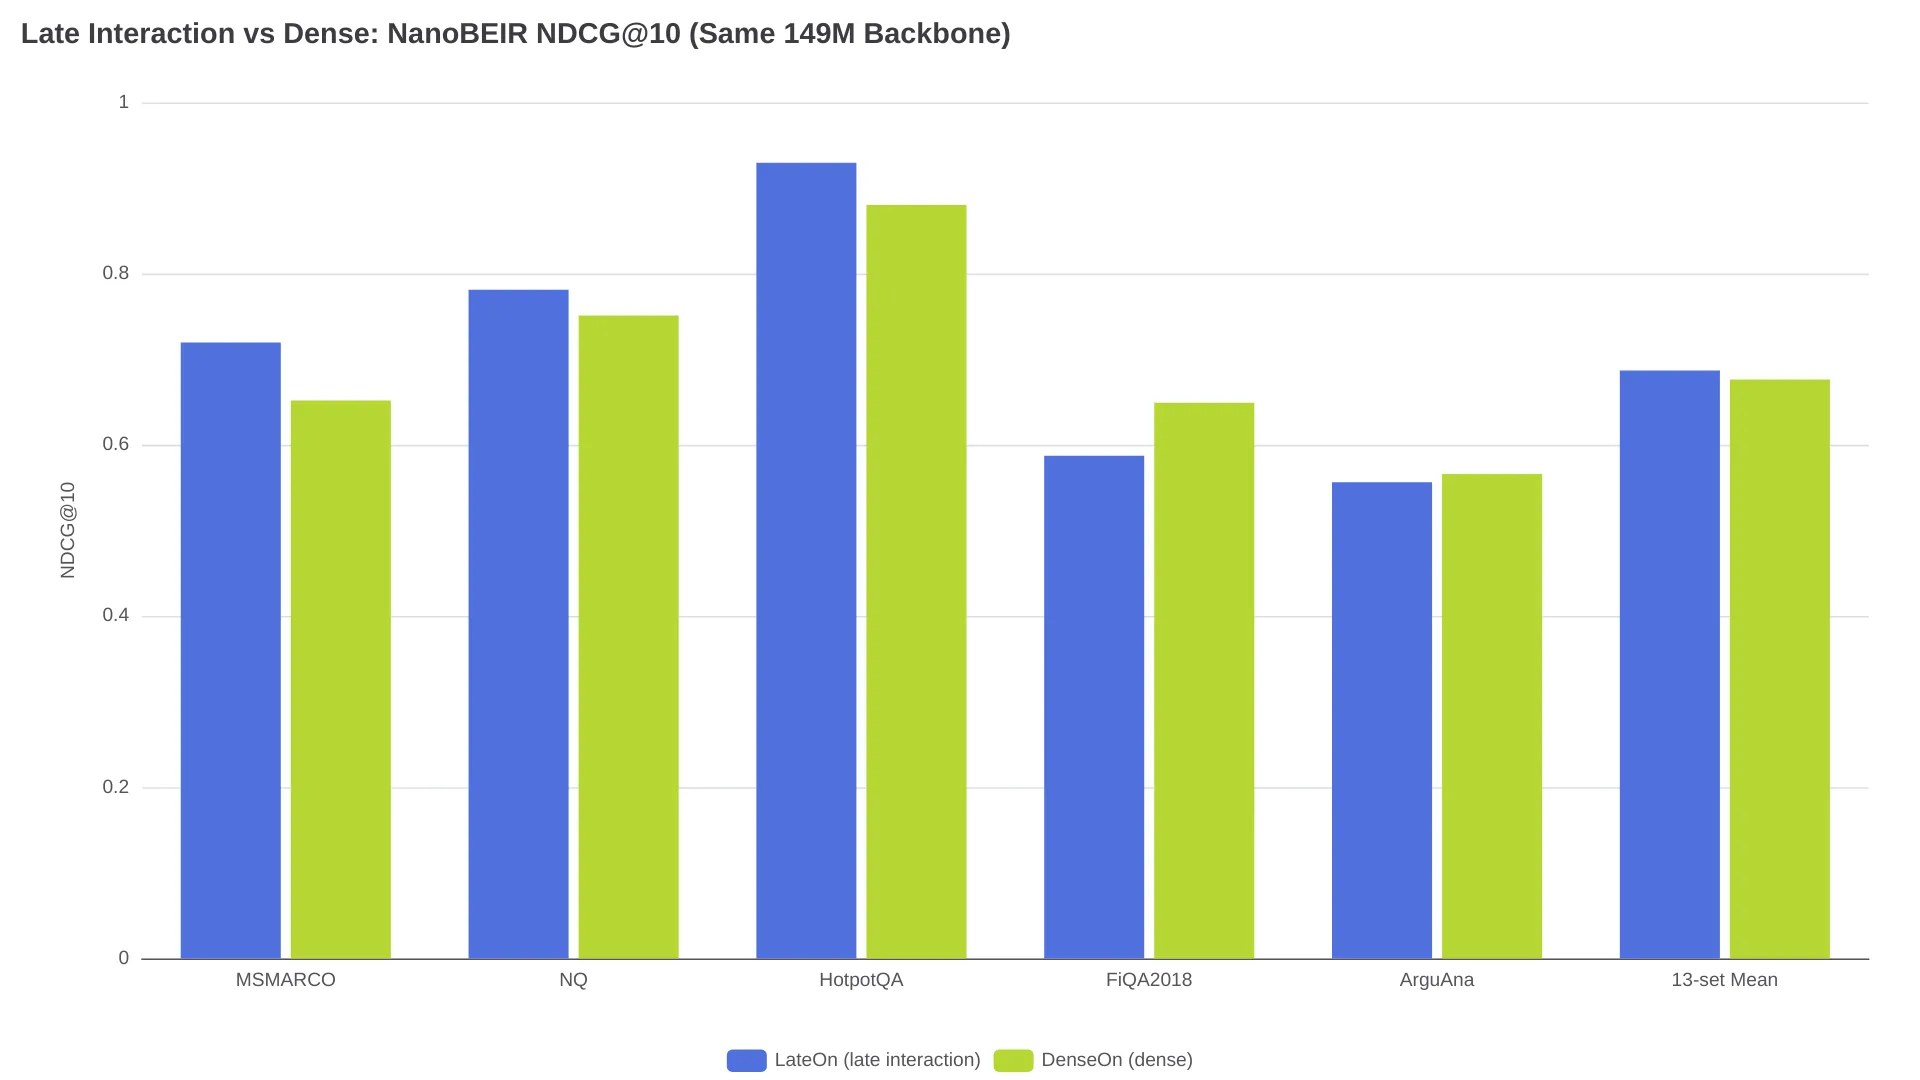
LateOn, 13 NanoBEIR veri setinin 9'unda ve ortalamada önde: NDCG@10 değeri 0.6764'e karşı 0.6868. 15 veri setli tam BEIR sonuçlarında da skor 56.20'ye karşı 57.22. Buna rağmen DenseOn, ArguAna, FiQA2018, SCIDOCS ve SciFact'te doğrudan kazanıyor. Sonucun dürüst özeti şu: Aynı model boyutunda anlamlı bir ortalama artış var, fakat bu bir kategori sıçraması değil.
Bakım sorumlusu Tom Aarsen v6.0'ı duyurduktan sonra geliştirici @saen_dev, uygulayıcıların tekrar tekrar sorduğu soruyu gündeme getirdi: "How does it benchmark against bi-encoders on domain-specific corpora?" (thread). Dürüst yanıt, ortalamada yaklaşık bir puan; büyük kazanımlar ise uzun belgelerde yoğunlaşıyor. Hugging Face de kazanımlar veri setine göre değiştiği için kullanıcıların kendi retrieval görevlerinde değerlendirme yapmasını öneriyor.
Depolama Maliyeti: Sıkıştırmadan Önce 42 Kat
Hugging Face'in örneği, 4.874 Natural Questions pasajından oluşan bir indeksin boyutunu hesaplıyor. lightonai/LateOn, bu belgelerden toplam 608.414 token vektörü çıkarıyor; pasaj başına ortalama 124.8 vektör demek bu.
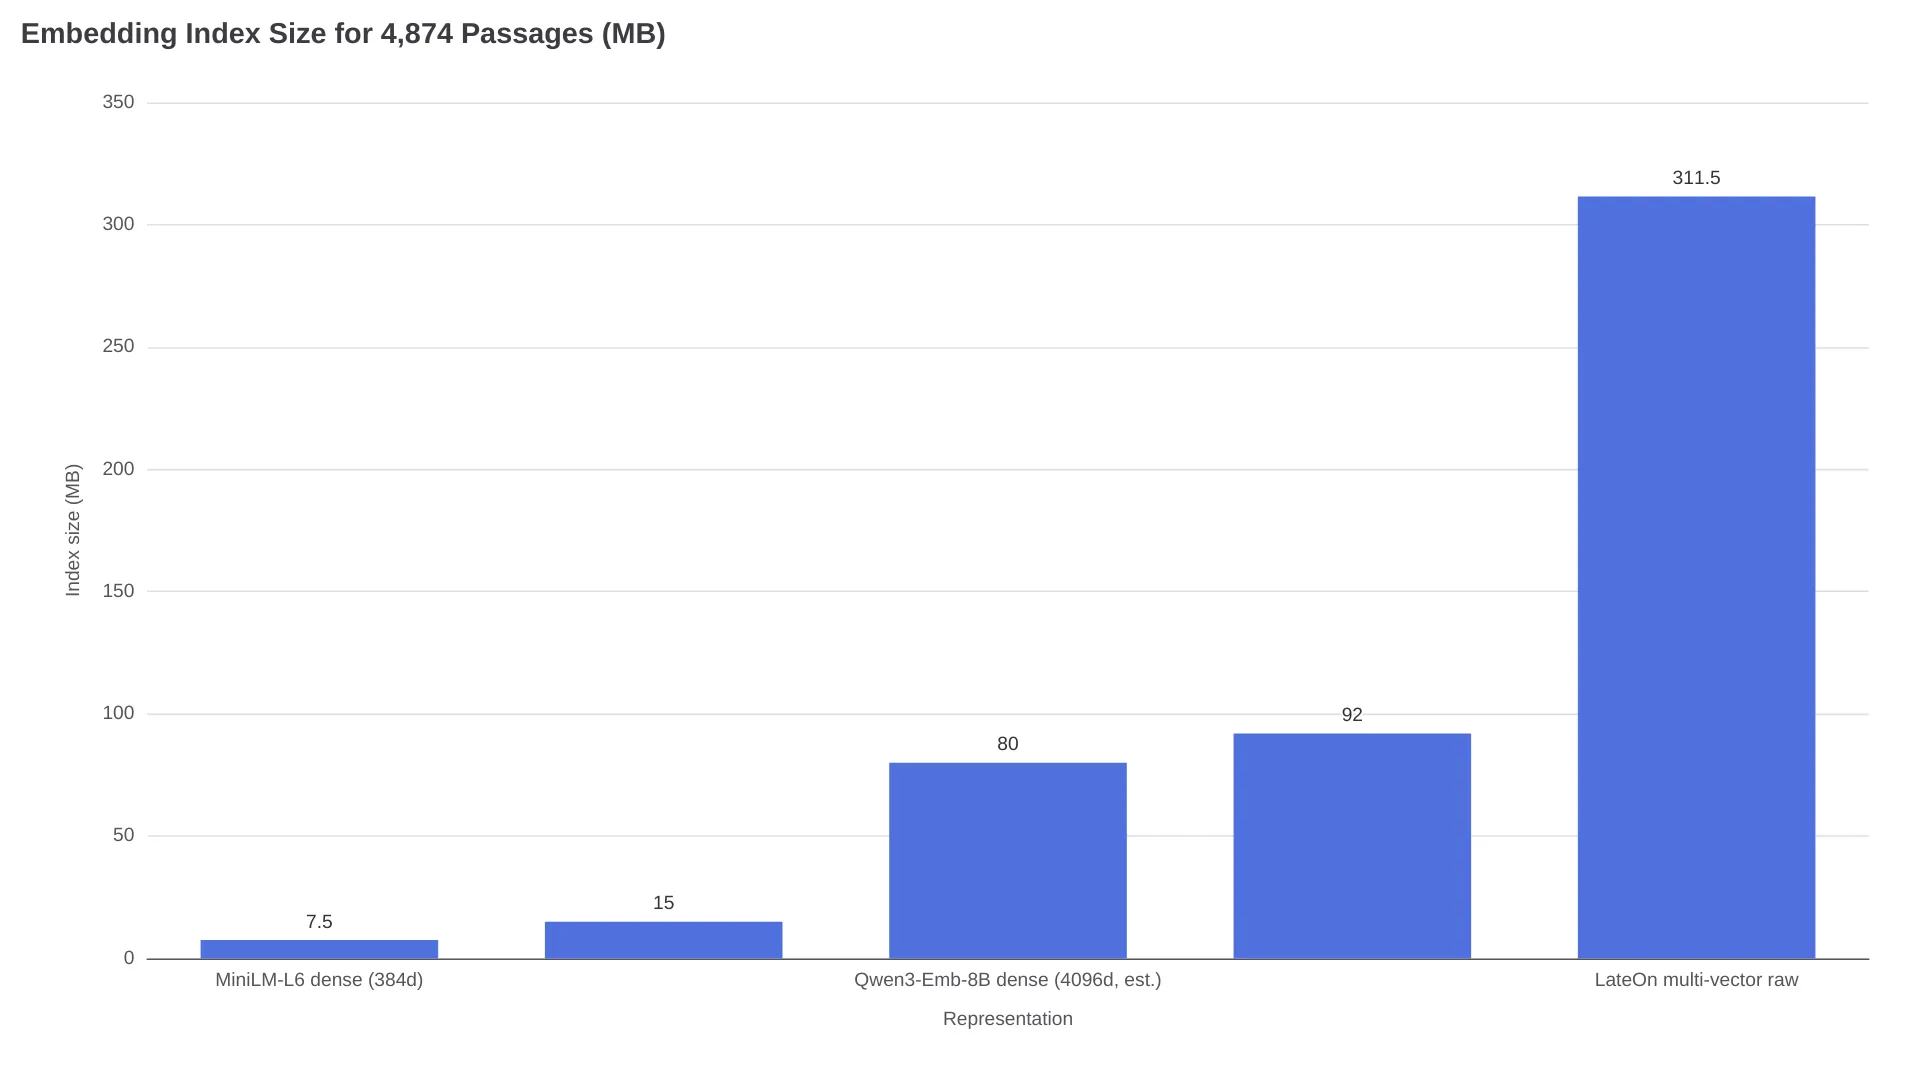
Ham float32 çok vektörlü indeks 311.5 MB yer kaplıyor. Aynı pasajlar all-MiniLM-L6-v2 dense modeliyle 7.5 MB tutuyor: Arada 42 kat fark, yani pasaj başına 62 KiB var. Aynı sınıftaki 768 boyutlu dense model gte-modernbert-base ile karşılaştırıldığında fark 21 kat (15 MB). TopK, belge uzunluğu ve hassasiyete bağlı olarak 10–100 kat aralığından söz ediyor; tek vektör karşılaştırmasına kıyasla sorgu başına binlerce kat daha fazla skorlama işi öngörüyor.
Yayın günü bir geliştirici, üretimdeki endişeyi açıkça şöyle özetledi:
Token pooling is the part that decides if this ships. Late interaction usually dies on index size and memory, not on accuracy. - @JudeJobs on X
Ölçek duygusu için: Aynı korpus üzerinde 4.096 boyutlu Qwen3-Embedding-8B dense indeksi yaklaşık 80 MB tutuyor. Bu, aşağıdaki 92 MB'lık sıkıştırılmış late-interaction indeksine yakın bir değer.
İndeksi Küçültmenin Üç Yolu
1. Token pooling. Sentence Transformers v6.0 ile gelen HierarchicalTokenPooling, belge token vektörlerini cosine distance üzerinden Ward linkage ile kümeliyor ve her kümeyi ortalama vektörüyle değiştiriyor. Sorgular kısa ve bozulmaya hassas olduğu için varsayılan olarak yalnızca belgelere pooling uygulanıyor. 608.414 vektörlük korpusta sonuçlar şöyle:
| Pooling katsayısı | Token vektörü | float32 indeks | Raporlanan retrieval korunumu |
|---|---|---|---|
| 1 (yok) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | ~98% eğilimi |
Tam korpusta pooling işlemi yaklaşık 6 saniye sürdü. LightOn'ın regularized varyantı, Hugging Face yazısında 5 kat sıkıştırmada %99.4 kalite bildiriyor. Ancak Hugging Face, v6.0 yayını itibarıyla bu regularizer ile eğitimin henüz kütüphaneye entegre edilmediğini belirtiyor.
2. Sıkıştırılmış indeksler. Aynı vektörler için oluşturulan fast-plaid (Rust PLAID) indeksi 92 MB yer kaplıyor; 5 saniyede oluşturuluyor ve RTX 3090 + i7-13700K üzerinde sorgulara 11 ms'de yanıt veriyor. Bu yaklaşım approximate çalışıyor: Hugging Face testinde en üst skorlar 11.92'den 11.88'e kaydı, ancak sıralama korundu. Weaviate'in MUVERA yaklaşımı ingestion'ı 3 kat, sorguları 1.8 kat hızlandırdı; buna karşılık test korpusunda top 50 içinden bir doğru sonucu kaybetti.
3. Quantization ve inference ayarları. Qdrant'ın token embedding'lerinde uint8 scalar quantization kullanan deneyleri belleği 4 kat azalttı. SciFact NDCG@10 ise 0.70724'ten 0.70297'ye indi; fark ihmal edilebilir düzeyde. Hugging Face'e göre fp16 ile Flash Attention birlikte kullanıldığında fp32 encoding throughput'u 2.44 katına çıkıyor ve ölçülen bir kalite kaybı oluşmuyor. CPU'da int8 kullanımı ise yaklaşık %0.4 doğruluk maliyeti getiriyor.
2–3 katsayılı pooling'i sıkıştırılmış bir indeksle birleştirdiğinizde dense modele göre fark 42 kattan tek haneli seviyelere inebiliyor. Karşılığında ayarlanacak iki parametre daha ekleniyor.
Varsayılan Mimari: Önce Aday Getir, Sonra Rerank Et
Exhaustive MaxSim, tek RTX 3090 üzerinde 4.874 belgenin tamamını 98 ms'de, uçtan uca ise 122.7 ms'de skorluyor. Birkaç bin belge için gayet makul; milyonlarca belgede ise doğrusal maliyet hızla sorun olur. Burada incelenen üç dağıtım rehberi aynı mimaride birleşiyor: Ucuz bir dense veya sparse ilk aşama adayları getiriyor, late interaction ise bunları rerank ediyor.
- Hugging Face örneği, dense tarafta en iyi 50 sonucu getiriyor ve ardından MaxSim ile rerank ediyor. Belgeler toplu halde yalnızca bir kez encode ediliyor, skorlar matris çarpımıyla hesaplanıyor. Bu, cross-encoder'ın her sorgu-belge çifti için yaptığı forward pass'ten çok daha ucuz.
- Qdrant, v1.10'dan beri yerleşik çok vektör desteği sunuyor ve late interaction'ı tam tarama için değil, birkaç yüz adayın rerank edilmesi için öneriyor.
- Data AI Hub üretim rehberi, hibrit aramayla ilk 150 sonucu getirmeyi, late interaction ile 20'ye rerank etmeyi ve isteğe bağlı olarak LLM'e gönderilecek son 5 sonuçta cross-encoder kullanmayı öneriyor.
Yalnızca rerank deseninin net bir sınırı var: İlk aşamanın kaçırdığı belgeleri geri getiremez. Üstelik çevresindeki pipeline için yerleşmiş tek bir reçete de yok:
there is hardly a universally good chunking, retrieval and re-ranking strategy. - u/gamerx88, r/MachineLearning
Hangi Veritabanları Destekliyor?
Hugging Face'in lansman yazısı, büyük motorları aynı 4.874 pasajlık korpusta karşılaştırıyor. Aşağıdaki değerler üretici pazarlama rakamları değil, kendi test sonuçları:
| Motor | Yerleşik çok vektör desteği | Ingest / sorgu (testte) | Dikkat edilmesi gerekenler |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | Tam MAX_SIM; sunucu kullanımı öneriliyor |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA daha hızlı ama bir doğru sonucu kaybetti; Windows'ta embedded mode yok |
| Vespa | "for years" | ~80 s / 75 ms warm | Tensor ifadesi olarak MaxSim; varsayılan ikinci aşama yalnızca 100 adayı rerank ediyor ve doğru ilk 3 sonucun 2'sini kaçırdı |
fast-plaid | - | 5 s / 11 ms | Sunucu yok; skorlar approximate, sıralama korundu |
| LanceDB | v0.15.0 | benchmark yapılmadı | Yerleşik MaxSim |
| Milvus | v2.6.4 | benchmark yapılmadı | Array-of-structs depolama |
| VectorChord | - | benchmark yapılmadı | PostgreSQL için MaxSim operatörü |
| Elasticsearch / OpenSearch | - | - | Yalnızca rescore; ES özelliği Enterprise katmanında technical preview durumunda |
Hugging Face'in karşılaştırma tablosunda turbopuffer'ın late-interaction indeksleme desteği private beta olarak listelenmişti.
Sentence Transformers v6.0 ile Değişenler
18 Ağustos 2026'dan önce ColBERT ailesi modellerini çalıştırmak, PyLate, Stanford ColBERT deposu veya colpali-engine gibi ayrı framework'ler gerektiriyordu. 6.0 sürümüyle MultiVectorEncoder, eğitim, inference ve yorumlanabilirlik desteğiyle kütüphanenin dördüncü birinci sınıf model türü oldu. Sentence Transformers, PyLate, Stanford ColBERT ve ColPali checkpoint'lerini yükleyebiliyor. Çıplak bir transformer da yüklenebiliyor, ancak rastgele projection kullandığı için eğitim gerektiriyor. Gereksinimler transformers v5.x, torch 2.2+ ve huggingface-hub v1.x.
Lansman dokümantasyonundaki üç önemli tuzak:
- Sorgular ve belgeler asimetrik.
encode_query()veencode_document(), farklı prompt'lar, uzunluk sınırları ve skorlama maskeleri uyguluyor. Her ikisinde de genelencode()çağrısını kullanmak, sonuçları sessizce bozmanın en hızlı yolu. - Truncation sessiz gerçekleşiyor. LateOn'ın 300 tokenlık belge sınırından geçirilen 662 tokenlık bir pasaj yalnızca 273 vektör üretti; kalanı atıldı. Sınırı 512'ye yükseltmek mümkün, ancak modelin eğitim dağılımından uzaklaşmasına ve indeksin büyümesine yol açıyor.
- Flash Attention için istisnalar var.
colbert-ir/colbertv2.0veanswerai-colbert-small-v1dahil non-attend query expansion kullanan modellerde bunun yerine"sdpa"gerekiyor.
Hugging Face'in yayımladığı skorlara göre desteklenen model seçenekleri iki büyüklük mertebesine yayılıyor:
| Seviye | Örnek model (parametre) | Skor (ortalama NDCG@10) |
|---|---|---|
| Uç cihaz metni | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| Küçük metin | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| Metin lideri | LateOn ailesi (149M) | 0.6868–0.6897 NanoBEIR |
| Görsel belge | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
Dense Tek Vektörün Hâlâ Doğru Seçim Olduğu Durumlar
Kaçınılması gereken hata, ihtiyacı olmayan iş yüklerinde çok vektörlü yapıya geçmek. Sorgular geniş ve konu odaklıysa ("tedarik zincirleri hakkında makaleler"), metinler kısaysa (başlıklar, FAQ çiftleri, tweet'ler), iş kümeleme, deduplikasyon veya öneri sistemiyse — yani öğenin tamamının benzerliği gerekiyorsa — çok vektöre ihtiyaç yok. Dense + reranker pipeline'ınız recall SLO'larını zaten karşılıyor ve temel kısıt maliyetse de dense yaklaşımda kalın. Data AI Hub rehberinin ek notu da önemli: İngilizce merkezli ColBERT checkpoint'leri, çok dilli korpuslarda çok dilli bi-encoder + reranker yığınının gerisinde kalabilir. Sık yazılan, gerçek zamanlı korpuslar da token düzeyindeki indeksler için zayıf adaylar.
Sayılarla Sık Sorulan Sorular
Normal bir dense modeli çok vektörlü model gibi kullanabilir misiniz?
Bazen ve şaşırtıcı derecede iyi sonuçlarla. Qdrant deneylerinde, 33M parametreli dense model BAAI/bge-small-en'in çıktı token embedding'leri MaxSim ile skorlandı. SciFact'te 0.73696 NDCG@10 elde edildi; bu, colbert-ir/colbertv2.0'ın 0.69579 skorunu ve bge-small'ın kendi pooled vektörünün 0.68213 skorunu geçti. ArguAna'da sıralama tersine döndü ve pooled dense yaklaşımı kazandı. Yeni model eklemeden reranking aşaması eklemek için geçerli bir yöntem, ama garanti değil.
Sıkıştırılmış çok vektörlü indeks ne kadar hızlı?
4.874 pasajlık korpusta exhaustive MaxSim 98 ms sürerken fast-plaid 11 ms'de yanıt verdi. Boyut ise 311.5 MB yerine 92 MB oldu.
Çok vektörlü modeller cross-encoder reranker'ların yerini alır mı?
Maliyet açısından evet: Belge temsilleri önceden hesaplanır ve sorgu-belge çifti başına forward pass yerine matris çarpımıyla skorlanır. Buna rağmen Hugging Face'in lansman yazısı, çift bazında en doğru seçeneği hâlâ cross-encoder olarak sıralıyor. Bu nedenle yüksek beklentili pipeline'lar son 5–20 sonuç için cross-encoder kullanmayı sürdürüyor.
Late interaction RAG için değer mi?
Hibrit veya dense adayların üzerinde bir reranking aşaması olarak evet; yukarıdaki üç dağıtım rehberinin de önerdiği desen bu. İlk aşama retriever olarak ise ancak ölçümlerdeki sorun ilk aşama recall'ıysa ve token vektörü indeksi bütçenize sığıyorsa mantıklı.
Hangi İş Yükü İçin Ne Seçilmeli?
| İş yükünüz | Öneri |
|---|---|
| Tanımlayıcı ağırlıklı veya çok parçalı sorgular, uzun belgeler, hukuk/teknik metinler | Çok vektörlü retrieval veya reranking; burası +26 puanlık MLDR alanı |
| PDF'ler, taranmış sayfalar, tablo ve grafik içeren sayfa görselleri | ColPali ailesi çok vektörlü modeller; OCR pipeline'ına gerek yok |
| Geniş konu araması, kısa metinler, kümeleme/deduplikasyon/öneri sistemi | Dense tek vektör; pooling kaybı burada önemsiz |
| Kalite neredeyse yeterli, bütçe kısıtlı | Dense ilk aşamayı koruyun, ilk 50–150 sonuçta MaxSim reranking ekleyin |
| Milyonlarca belge, maliyet odaklı yapı | Dense + cross-encoder reranker veya ölçüm yaptıktan sonra sıkıştırılmış late interaction (2–3 pooling katsayısı + fast-plaid) |
@JudeJobs'un işaret ettiği açık takas hâlâ geçerli: Sıkıştırma sonrası kalite korunumu benchmark'larda ölçülüyor, karmaşık üretim korpuslarında değil. Önce 2 katsayılı pooling uygulayın; ardından kendi verinizde ölçtüğünüz recall, sıkıştırma eğrisinde ne kadar ileri gidebileceğinizi belirlesin.