 AIREITER
MiniMax, H3 model kartında ön işleme katmanını “nihai çıktının kalitesi açısından kritik” olarak tanımlıyor. Öte yandan H3 prompt'ları üzerine 220 oy alan bir Reddit başlığı, anlamsızlaşan diyaloglarla ilgili adeta bir hata raporu. Bu MiniMax H3 prompt incelemesinde resmî formatı, kaynak gösterilen içerik üreticisi testleri ve arıza bildirimleriyle karşılaştırıyoruz: bu raporlarda kamera ve referans kontrolü, diyalog ve sese kıyasla daha güvenilir görünüyor. Hatta en iyi sonuçlar bazen sözdiziminden bilerek uzaklaşınca geliyor.
MiniMax H3 Prompt Formatı Aslında Ne?
Resmî MiniMax H3 prompt'u; integrated_multimodal_description, overall_soundscape ve non_diegetic_music adlı üç alandan oluşan yapılandırılmış bir belge. Zaman kodlu planlar, kalıcı konuşmacı kimlikleri ve <d> diyalog etiketleri içeriyor. Bunun nedeni, H3'ün normalde barındırılan bir ön işleyicinin ürettiği yapılandırılmış bir ara temsil beklemesi: H3-Context-IR. MiniMax bu katmanı açık ağırlık sürümüne dahil etmedi. Barındırılan API'de serbest yazılmış isteğinizi sistem sizin için yeniden yapılandırıyor; buna karşılık yerelde çalışan 33B açık ağırlıklar (SGLang, vLLM, Diffusers, ComfyUI), bu yapıyı elle yazmanızı gerektiriyor.
MiniMax ayrıca resmî GitHub deposunda taşınabilir bir h3-prompt-writing becerisi sunuyor. Herhangi bir kodlama ajanının haricî API çağrısı olmadan okuyabileceği iki rehber dosyası var: base-en.txt ve ref-en.txt. İçerik üreticileri, doğal dille yazılmış brief'leri tam formata çevirmek için bunu Claude veya Cursor içinde çalıştırıyor. @AI__TSUBAKI, sinematik klipler için tam olarak bu iş akışını belgeliyor.
Her prompt'u sınırlayan teknik çerçeve
| Kısıt | Değer | Prompt'a etkisi |
|---|---|---|
| Klip süresi | 4–15 saniye, 24 FPS | Zaman damgaları kesin biçimde artmalı ve toplam süre sınırları içinde kalmalı |
| Ses | 32 kHz stereo, görüntüyle birlikte üretiliyor | Soundscape ve müzik alanları zorunlu; N/A kullanılabilir |
| Çözünürlük | Varsayılan 768p; H3-Regenerate-2K ile 2K (yalnızca API) | Önce 768p'de test edin, prompt kesinleştikten sonra 2K için ödeme yapın |
| Görev türleri | T2VA (metin), I2VA (0.00 sn'de ilk kare), FL2VA (ilk + son kare), L2VA (son kare), Ref2VA (çoklu referans) | Her türün kendine ait bir hizalama cümlesi var |
| Referans sınırları | 9 görsel + 3 video klip + 3 ses klibi; toplam 12 dosya, medya türü başına toplam ≤15 sn | Daha fazla referans daha fazla yönlendirme demektir; her zaman daha iyi sonuç vermez |
| Prompt boyutu | Resmî örnekler 300–700 kelime; yalnızca metinden videoya isteklerde üst sınır yaklaşık 7.000 karakter | Referanssız kısa prompt'lar, resmî kılavuzun işaret ettiği hata senaryolarından biri |
Üç alan, tek kamera yönergesi, tırnak içindeki diyaloğa sahip kadraj içi bir konuşmacı ve müziksiz bir yapı içeren asgari tam prompt, on satıra sığabiliyor:
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
Tüm alanların sözdizimi, etiketler, hizalama cümleleri ve şablonlar için MiniMax H3 prompt rehberimize bakabilirsiniz. Bu incelemenin odağı ise bu formatın harcanan çabaya değip değmediği.
Resmî Formatın Üç Temel Vaadi Ne Kadar Gerçekçi?
Resmî rehber, açıkça söylemese de üç temel vaatte bulunuyor. Kaynak gösterilen raporlar ilk iki konuda daha olumlu; ses talimatlarına uyum ise belirgin biçimde daha sorunlu.
Vaat 1: “Yapı, beklediğiniz sonucu getirir”
Kanıtların en güçlü olduğu başlık bu. X kullanıcısı @AIWarper, resmî yapıya geçtikten sonra yaptığı önce/sonra karşılaştırmasını paylaştı:
“MiniMax'ın yayımladığı prompt rehberine uymanızı ŞİDDETLE tavsiye ediyorum. Tam olarak beklediğiniz sonucu almakta gerçekten çok yardımcı oluyor.... Son paylaşımım önerilen prompt yapısını izlemiyordu.” — @AIWarper, 306 beğeni
Üçüncü taraf test günlüğü de ayrıntı düzeyinde aynı örüntüyü gösteriyor: tam 00:05.000'de kesme istedi ve bunu aldı; yazılı bir tanıtım metnini kelimesi kelimesine seslendirdi; ilk kare kompozisyonunu 6 saniyelik bir I2VA klibi boyunca sabit tuttu. Storyboard raporları da benzer. @aimikoda'nın panoları sıralı plan yönergeleri olarak izleniyor. @nanyuan0412'nın storyboard'u da doğaçlama olmadan takip edildi; yalnızca yazmayı unuttukları ses alanları neredeyse sessizlik olarak çıktı.
Tekrarlayan sınırlama, talimatın reddedilmesi değil tempo. u/Relevant_One_2261 şöyle yazıyor: “En büyük sorun tempo oldu.” Süreye sığmayan diyaloglar ve birbirine fazla yakın zaman damgaları, tekrar eden yapısal hata kaynakları.
Vaat 2: “Kamera komutları, sonuç tariflerinden daha etkili”
Bu vaat, çözüme kavuşmuş bir kadraj sorunuyla doğrulanıyor. r/StableDiffusion'da bir kullanıcı, yürüyen karakterin tüm vücudunu kadrajda tutmak için yalnızca “entire subject remains visible throughout” talimatını verdi; H3 bunu defalarca yerine getiremedi. Çözüm, hedeflenen sonucu H3'ün kendi kamera diline çevirmek oldu:
“Kamera, karakter ileri yürürken onunla aynı hızda ve büyük genlikle geriye açılır; tam boy kompozisyon korunur.” — u/Powerful-Goal52, orijinal gönderi sahibi tarafından çalıştığı doğrulandı
Bu yaklaşım doğrudan H3'ün üç kamera boyutuna karşılık geliyor: hareket türü, genlik ve hız. Ayrıca model her plan için tek kamera talimatı bekliyor. Kısa bir dönüşüm tablosu şöyle:
| İstenen sonuç | H3'ün izlediği komut |
|---|---|
| Yürürken karakterin tamamı görünür kalsın | Karakterin yürüme hızında, büyük genlikle Pull Out |
| Kadrajı bozmadan hafif vurgu | Küçük genlikte, yavaş Push In |
| Sabit duran karakterin çevresini ortaya çıkarma | Orta genlikte Truck Left veya Truck Right |
| Tilt olmadan yükseklik değişimi | Yavaş hızda Pedestal Up / Pedestal Down |
Resmî prompt rehberi; Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll ve POV olmak üzere 13 hareket türü ailesi tanımlıyor. Her biri genlik ve hızla değiştirilebiliyor. Zoom'un odak uzaklığını değiştirmesi, push'ın ise kameranın fiziksel hareketi olması pratikte önemli; bu iki terim birbirinin yerine kullanılamaz.
Vaat 3: “Ses alanlarını ayırırsanız sonuç temiz kalır”
En zayıf katman burası. Diegetik ortam sesini non-diegetik müzikten ayırmak doğru bir tasarım tercihi, fakat talimatlara uyum tutarsız:
“Bunu kullanıyorum ama zamanın yaklaşık %20'sinde yine de müzik ekliyor lol” — u/TheElectriking,
non_diegetic_music: N/Ahakkında
Alıntının geldiği 220 oy alan başlık, sorunun diğer yönlerini de sıralıyor: klip sınırlarında ses artefaktları, rastgele anlamsız sözler söyleyen karakterler ve repliği yanlış kişinin seslendirmesi. u/krigeta1, üç özel ses referansı verip “rastgele bir ses veya karakterlere atadığım sesin hiç kullanılmadığını” bildiriyor. Başka bir başlıkta ise, ekranda görünen diyaloğun sürekli ekran dışından okunması sorunu; konuşmacı kimliğinin görünür karaktere açıkça bağlanmasıyla çözülmüş.
Ekran üzerindeki metin de aynı derecede kırılgan. Topluluk wiki'si, bunu “exact text is fragile” diye özetliyor; marka açısından kritik yazıların görsel referans olarak verilmesini veya sonradan compositing ile eklenmesini öneriyor. Karşı görüş bildiren bir rapor da var: @web4miko, kendi testlerinde H3'ün metin ve bağlam anlayışında “Seedance 2.0'ı bile geçemediğini” söylüyor. Kaynak gösterilen raporlarda ses yönlendirme, tam metin üretimi ve yoğun bağlam, tekrar eden zayıf noktalar.
Resmî Sözdiziminden Ne Zaman Sapmalı?
Kaynak gösterilen yan yana karşılaştırmalarda ve ilk elden raporlarda resmî formattan üç sapma öne çıkıyor. Tam yapıya bağlanmadan önce bunların üçünü de bilmekte fayda var.
Bazen tırnak işaretleri <d> etiketlerinden daha iyi sonuç veriyor. r/StableDiffusion'da yayımlanan bir yan yana karşılaştırmada (yaklaşık 105 oy, 81 yorum), gönderi sahibi rehberdeki <d>[Language]...台词...</d> etiketlerini kaldırıp düz tırnak içi diyalog kullandığında temiz konuşma elde ettiğini belirtti. Etiketli biçim ise istenmeyen sesler ekledi. Benzer testler yapan bir yorumcu da aynı fikirde:
“resmî diyalog prompt sistemi aşırı sorunlu... tırnak yaklaşımı da kusursuz değil ama
<d></d>etiketlemesi kadar problemli değil.” — u/networking_noob
Pratikte şu yaklaşım mantıklı: Eğitimdeki temel yol olduğu için önce <d> kullanın. Ancak konuşma bozuluyor veya gereğinden fazla üretiliyorsa, tüm prompt'u yeniden yazmak yerine aynı repliği tırnak içinde tekrar deneyin.
non_diegetic_music: N/A, tek başına etkili bir kontrol. u/Nextil, “yapının geri kalanının çoğunu görmezden gelseniz bile” bunun müziği engellediğini bildiriyor. Başka hiçbir yapılandırılmış işlem yapmayacaksanız bile bunu uygulayın; istenmeyen müzik, kaynak gösterilen raporlardaki tekrar eden şikâyetlerden biri.
Referans ağırlıklı işlerde daha fazla değil, daha az metin gerekir. Kimliği görseller, hareketi ise video taşıyorsa prompt'un görevi yalnızca yönlendirme ve yeni aksiyonu tanımlamak olur. @aimikoda'nın en çok paylaşılan şablonları — bunlardan biri 1.300'den fazla yer işareti aldı — tam da bu nedenle minimal. @CharaspowerAI ise MiniMax'ın kendi Design ajanının “act as an expert FPV director and turn this into something viral” şeklindeki tek satırı otomatik olarak tam yapılandırılmış bir prompt'a dönüştürdüğünü gösterdi. Örnek bir referans yönlendirme bloğu şöyle:
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
Bundan sonra prompt yalnızca yeni planı anlatmalı. Bu raporlardaki pratik iş akışı şu: önce sabit görselleri oturtun, yükü referanslara bırakın ve yalnızca değişen unsurlar için metin harcayın.
Kılavuzun Çözmediği Hatalar İçin Hızlı Teşhis
Resmî prompt rehberi sözdiziminde bitiyor; üretim bozuk döndüğünde ne yapmanız gerektiğini anlatmıyor. Aşağıdaki tablo, yukarıdaki hata raporlarından derlendi:
| Belirti | Olası neden | Çözüm |
|---|---|---|
N/A olmasına rağmen müzik eklenmesi | Bir kullanıcı, üretimlerinin yaklaşık %20'sinde sızıntı gözlemledi | Yeniden üretin; prompt'un hiçbir yerinde müzikal bir “mood” istemeyin |
| Repliği yanlış karakterin söylemesi | Konuşmacı-ses yönlendirme çakışması | Konuşmacı kimliğini, ekranda görünen karaktere açıkça bağlayın |
| Ekrandaki repliğin ekran dışı ses olarak okunması | Dudak senkronu ilişkisinin eksik olması | Konuşmacının görünür olduğunu belirtin; gerçek bir voice-over için “lips remain closed” ekleyin |
| Ses referansının görmezden gelinmesi | 3 klip / 15 saniye sınırının aşılması veya referansa rol atanmaması | Her klibe bir rol verin; toplam referans sesini kısaltın |
| Yerel modelin Çince diyaloğu yok sayması | ComfyUI, Qwen tokenizer'ını yeniden kullandı; shell kodlaması metni bozdu | Depodaki tokenizer'ı kullanın (resmî gereklilik) + Unicode güvenli gönderim + <d>[Chinese] 台词</d> (topluluk tarafından bildirilen çözüm) |
| Uzun tek planın (>15 sn) dağılması | 4–15 sn tasarım aralığının dışında kalması; nesneler düzleşiyor, devamlılık kayıyor | 15 saniyelik parçalara bölün ve aralarındaki devamlılığı planlayın |
Yerel kurulum satırı özellikle önemli. @eternityspring'in raporunda “H3 Çince konuşmuyor” sorununun kaynağı prompt değil, tokenizer'ın yeniden kullanılması ve karakter kodlamasıydı.
Maliyeti: Token, Deneme Sayısı ve Taşınabilirlik
Yapılandırmanın bedeli var. Resmî depo, üç tekrarlanabilir senaryo için Context-IR token kullanımını yayımlıyor ve referans sayısı arttıkça rakamlar keskin biçimde yükseliyor:
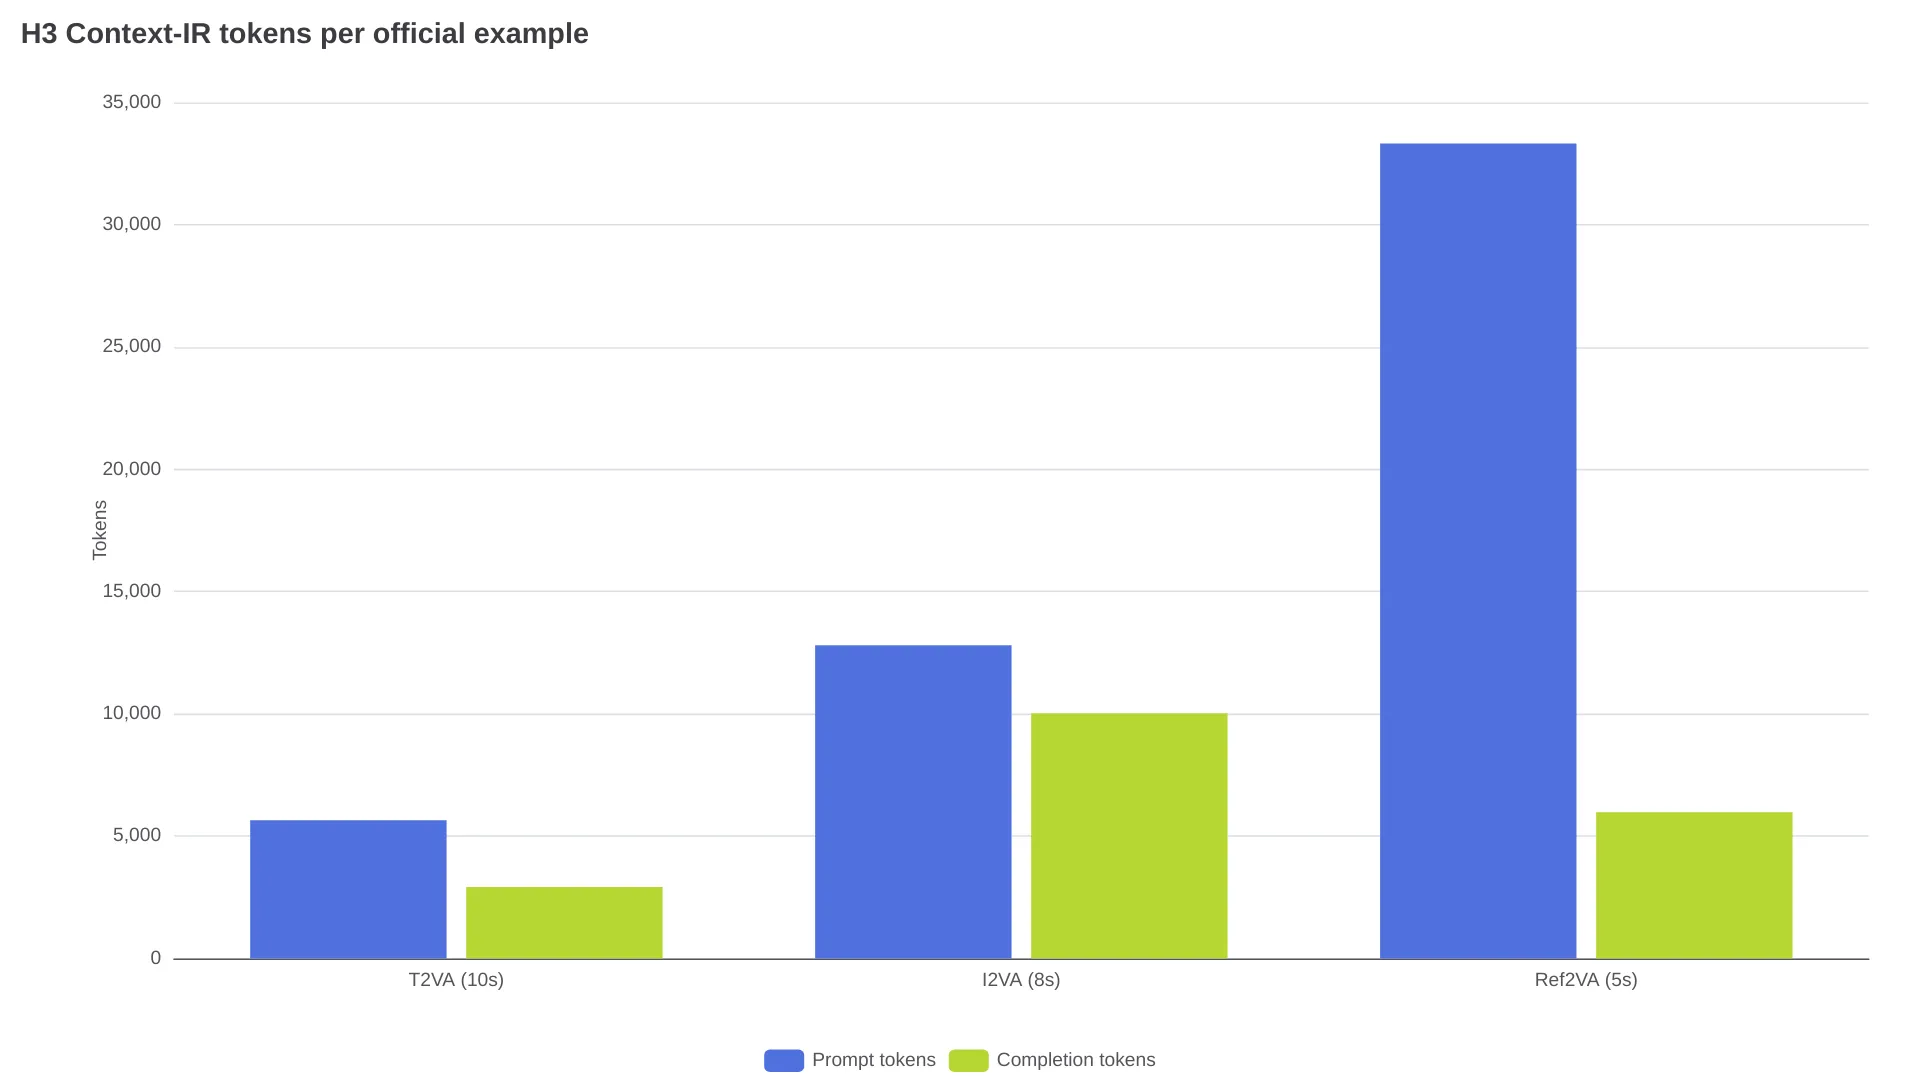
Yalnızca metinden oluşan bir üretim 8.565 ön işleme token'ı tüketiyor. Çok modlu referans işi ise bunun 33.323'ü prompt tarafında olmak üzere 39.299 token'a çıkıyor. Yerel çalıştırmalarda bu token'lar ön işleme gecikmesi ekliyor; barındırılan iş akışlarında ise fiyat üretim saniyesi üzerinden verilse bile işlem yükü yaratıyor. Zaman maliyeti de gerçek: X'te bir içerik üreticisi, üç kişilik ve yörüngesel kamera hareketi içeren tek bir prompt'u sonuç alıncaya kadar 48 saat boyunca geliştirdiğini belgeliyor (@LoveUolanda). Ekonomik deneme yöntemi şu: 6 saniyelik bir testin yaklaşık $0.68 tuttuğu 768p'de taslak hazırlayın; prompt kesinleştiğinde 2K'ya geçin. Aracının model sayfasında MiniMax H3 için $0.1125/s 768p ve $0.1825/s 2K ücretleri listeleniyor.
Son gizli maliyet taşınabilirlik. H3'ün alanları, konuşmacı kimlikleri ve etiketleri bir standart değil, kendine özgü bir lehçe. Modeller arası bir rehber, Veo 3.1'in satır içi SFX: etiketleriyle düz paragraflar istediğini, Seedance 2.0'ın ise altı bölümlü bir açıklama kullandığını gösteriyor. İkisi de H3'ün alanlarını, konuşmacı kimliklerini veya etiketlerini kabul etmiyor. H3 için oluşturduğunuz prompt kütüphanesi, başka bir yerde kopyala-yapıştırla çalışmaz; yeniden yazılması gerekir.
MiniMax H3 Prompt İncelemesi: Sık Sorulan Sorular
Yapılandırılmış prompt formatı MiniMax H3 için zorunlu mu?
Hayır. Barındırılan API'de Context-IR, serbest yazılmış doğal dil isteklerini dahili temsile dönüştürüyor. Yapı; özellikle yerelde çalışan açık ağırlıklarda ve kesin kesmeler, zaman damgaları ile konuşmacı yönlendirmesi gereken işlerde önem kazanıyor.
MiniMax H3'ün arka plan müziği eklemesini nasıl engellerim?
Prompt'u non_diegetic_music: N/A ile bitirin ve başka hiçbir yerde müzikal bir atmosfer istemeyin. Yine de sızıntı yaşanabilir; yeniden üretim yapmak normaldir.
MiniMax H3 prompt'u ne kadar uzun olmalı?
MiniMax'ın kendi örnekleri 300–700 kelime uzunluğunda ve yalnızca metinden videoya istekler yaklaşık 7.000 karakteri kabul ediyor. Kimlik ve hareketi referanslar taşıyorsa prompt uzamak yerine kısalmalı.
H3 prompt'larını Seedance veya Veo'da yeniden kullanabilir miyim?
Hayır. H3'ün adlandırılmış alanları, konuşmacı kimlikleri ve etiketleri modele özel. Seedance altı bölümlü bir format kullanırken Veo düz paragraflar alıyor; bu nedenle her hedef model için prompt'un ayrı sürümü gerekiyor.
Yerel H3 kurulumum neden İngilizce dışındaki diyalogları yok sayıyor?
Sorun çoğunlukla modelde değil, araç zincirinde. Qwen tokenizer'ını yeniden kullanan kurulumlar veya Unicode'u bozan shell ortamları, diyaloğu üretim aşamasına gelmeden bozuyor. Deponun resmî tokenizer'ını ve <d>[Language] diyalog formatını kullanın.
Sonuç: Bu Formatı Kimler Öğrenmeli?
| İşiniz | Karar |
|---|---|
| Diyalog içeren çok planlı film | Tam formatı öğrenin; ses için tekrar denemelere ve tırnak içi diyalog alternatife bütçe ayırın |
| Ürün / sabit görsel animasyonu (I2VA) | Hafif sürümü öğrenin: hizalama cümlesi + hareket + ses alanları |
| Storyboard veya karakter tutarlılığı odaklı seri | Evet — referanslar asıl yükü taşır; prompt'ları kısa ve yönlendirilebilir tutun |
| Tek seferlik kısa klipler, gündelik kullanım | Büyük kısmını atlayın: düz açıklama + non_diegetic_music: N/A yeterli olur |
| Tek bir modeller arası prompt kütüphanesi oluşturmak | Hayır — her modelin lehçesi için ayrı sürüm gerekir; model bazında yazın |
Çok planlı, zaman damgalı veya referans odaklı işler için formatı öğrenin; uyumun belgelendiği ve tekrarlanabildiği alan burası. Tek seferlik kliplerde ise bu kadar ayrıntıya girmeyin; yoğun diyaloglu seslerde itaat beklemek yerine tekrar denemeleri hesaba katın.
Topluluk da bu alışverişin iki ucuna bölünmüş durumda: aynı ay içinde hem 48 saat süren bir kamera prompt'u uğraşı hem de bir yorumcunun “kılavuzu okumak gerçekten heyecan vericiydi” dediği 880 oy alan bir gönderi ortaya çıktı. Modelin ses alanlarına uyumu kamera talimatlarına uyum seviyesine ulaşana kadar en mantıklı yaklaşım şu: yapıyı bir ajana taslak olarak hazırlatın, ses alanlarını kendiniz kontrol edin ve 2K'ya geçmeden önce 768p'de düşük maliyetle test yapın.