 AIREITER
r/codex'te aynı soru sürekli karşımıza çıkıyor: “GPT-5.5 extra-high kullanıyordum; bunun Sol ya da Terra tarafındaki karşılığı ne?” Kısa yanıt şu: GPT-5.6 Sol, API'de GPT-5.5 ile birebir aynı liste fiyatına sahip ve ajan benchmark'larında onu geride bırakıyor. Bu nedenle uzun soluklu ajan ve web tarama işleri için yükseltme, pratikte neredeyse ücretsiz sayılabilir.
Yine de “aynı fiyat” ifadesi iki önemli maliyeti gizliyor. GPT-5.5'te olmayan önbellek yazma ücreti Sol'da var. Ayrıca Sol daha uzun düşünüyor; dolayısıyla fiyat tablosu değişmemiş olsa bile görev başına harcama katlanabiliyor.
Liste fiyatı aynı, faturanın yapısı farklı
GPT-5.6 Sol ile GPT-5.5'in standart API fiyatları tamamen aynı: 1 milyon giriş token'ı için $5.00, 1 milyon çıkış token'ı için $30.00 ve önbellekten okunan giriş için $0.50. Her iki satırı da 29 Temmuz 2026'da OpenAI fiyatlandırma sayfasından aldım:
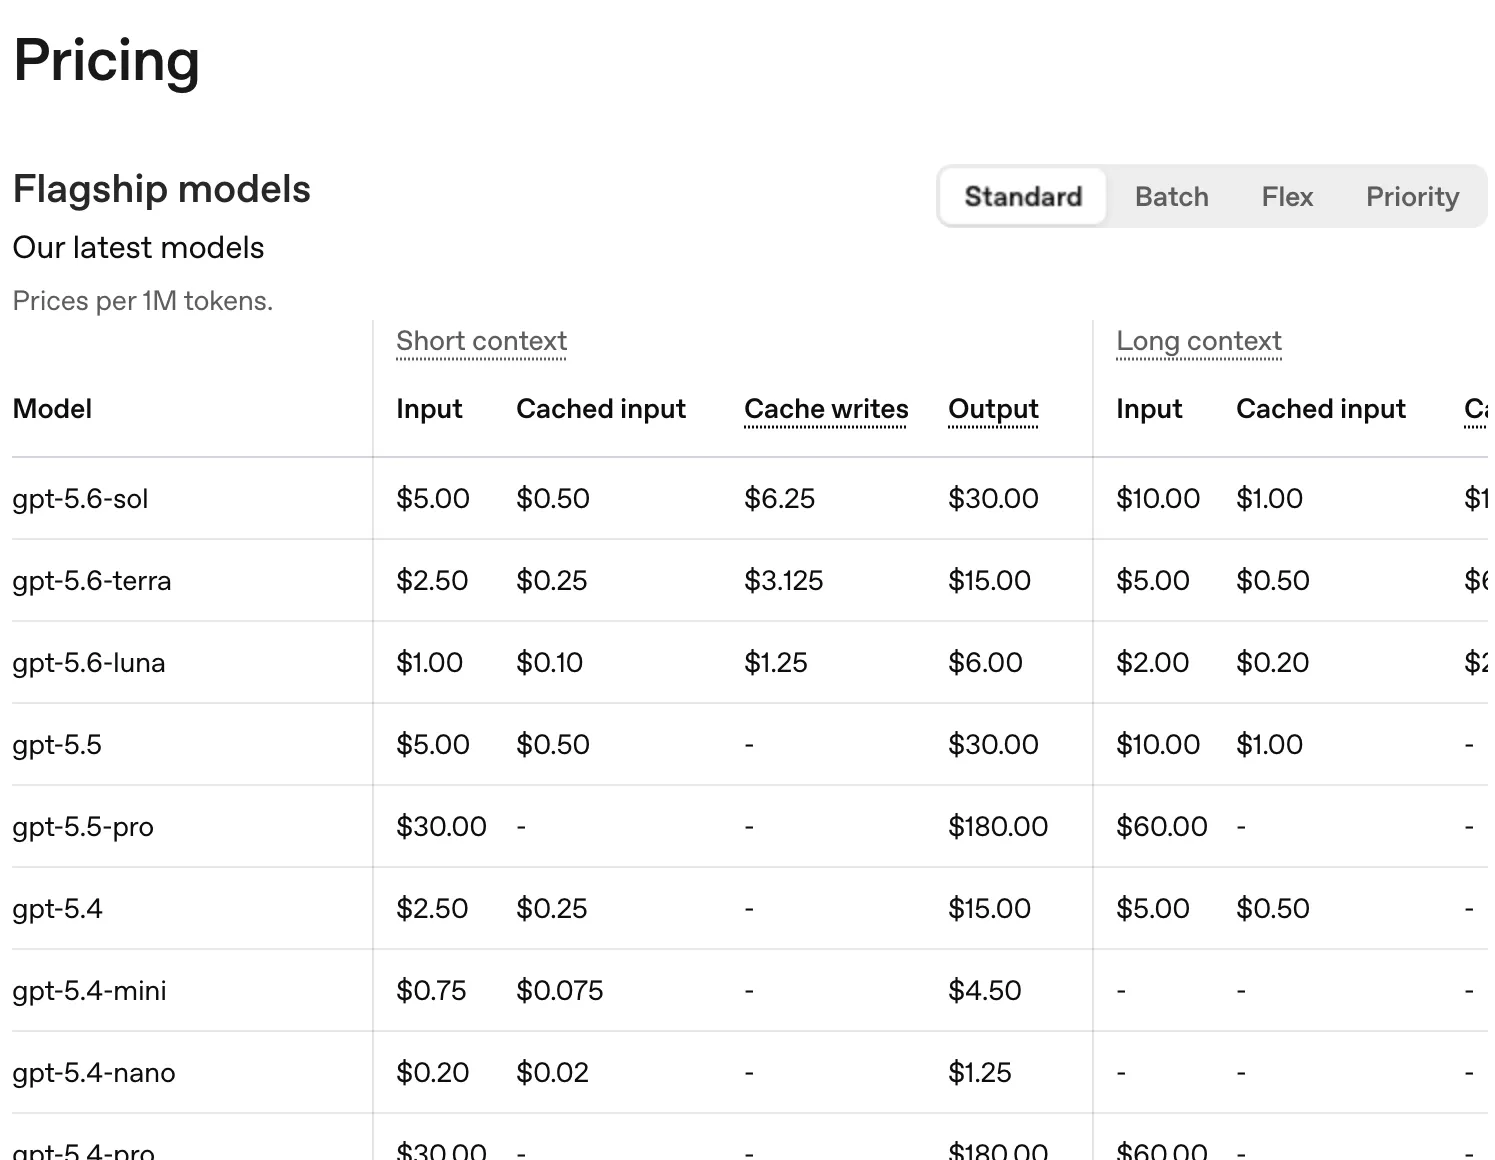
Tablodaki üç kalem, modeller arasındaki farkı oluşturuyor:
| Fiyat kalemi | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| Giriş / Çıkış (1M token başına) | $5.00 / $30.00 | $5.00 / $30.00 |
| Önbellekten giriş | $0.50 | $0.50 |
| Önbellek yazımı | $6.25 | ücretlendirilmez |
| Uzun bağlam (>272K) giriş / çıkış | $10.00 / $45.00 | $10.00 / $45.00 |
Geçişlerde asıl sürpriz çıkaran satır önbellek yazımı. GPT-5.6, en az 30 dakika ömürlü açık önbellek kırılma noktaları getiriyor (Vellum'ın açıklaması mekanizmayı ayrıntılandırıyor). Yazım, önbelleksiz giriş fiyatının 1.25 katına mal olurken okumalar %90 indirimli kalıyor. Yukarıdaki tabloyla hesap net: önbelleğe alınan bir bölümün yazımı $6.25, her okuması $0.50; aynı bölümü önbelleksiz yeniden göndermek ise $5.00. Yani önbellekleme ikinci kullanımdan itibaren kendini amorti ediyor. Ancak okuyandan çok yazan bir pipeline, GPT-5.5'te hiç bulunmayan bir ücretle karşılaşıyor.
İkinci maliyet zamanla şekilleniyor. Sol yanıt vermeden önce daha uzun akıl yürütüyor ve akıl yürütme token'ları çıkış token'ı olarak ücretleniyor. Codex'e geçen kullanıcılar bu etkiyi doğrudan raporluyor:
“5.6 sol médium, en azından 5.5'in çıkış dönemindeki kod kalitesiyle aynı sonucu verirken 5.5-xhigh'dan üç kat daha pahalı.” — r/codex, “GPT 5.5 and 5.6 conversion table”
Başka bir deyişle, fiyat tarifesi aynı olsa da model sonuca ulaşmak için üç kat token harcadığından görev başı maliyet üç katına çıkabiliyor. OpenAI'ın GPT-5.6 duyurusu ise iç karşılaştırmalarında GPT-5.5'e göre %22 daha az giriş, %23 daha az çıkış token'ı kullanıldığını belirtiyor. Bu iki iddia birbiriyle çelişmek zorunda değil: Düşünmenin her birimi daha verimli hale gelmiş olabilir, ancak yüksek efor ayarlarında model çok daha fazla düşünüyor. Sizin gördüğünüz maliyet, seçtiğiniz efor düzeyine bağlı.
Verilerde görünen asıl iyileşmeler
Bağımsız değerlendirmelerde ham zeka bakımından GPT-5.6 Sol ve GPT-5.5 neredeyse başa baş. Artificial Analysis, Sol'u (medium) Intelligence Index v4.1'de 54; GPT-5.5'i (high) ise 53 puanla değerlendiriyor. İkisinin de karma maliyeti 1 milyon token başına $4.35. Ancak öne çıkan gelişmeler başka alanlarda:
- İlk token gecikmesi: Sol'da 4.13 saniye, GPT-5.5'te (high) 16.67 saniye; yani 4 kat fark var. Etkileşimli araçlarda ve art arda onlarca çağrı yapan ajan döngülerinde günlük kullanımda en belirgin fark bu oluyor.
- Ajan benchmark'ları: Sol, Terminal-Bench 2.1'de %88.8, BrowseComp'ta %92.2 elde ediyor. Bu sürümdeki en büyük kazanımlar, uzun vadeli araç kullanımı etrafında toplanıyor.
- Bağlam: Sol için 1M token, GPT-5.5 için 922K token sunuluyor. Ayrıca yukarıda bağlantısı verilen Vellum analizinde de belgelendiği üzere akıl yürütme, konuşma turları arasında korunuyor.
- Çıkış hızı: Tek gerileme burada. Sol saniyede 65 token akıtırken GPT-5.5 77.3 token'a ulaşıyor. Toplu içerik üretim işleri hızlanmıyor, aksine yavaşlıyor.
CodeRabbit'in uzun soluklu kodlama paketinde beş dilde 100'den fazla görev üzerinde Sol'un başarı oranı %63.7. Kod inceleme benchmark'ında Sol, temel entegrasyona göre 7.4 yüzde puanlık artış sağlıyor. Fakat önemli bir not var: Sol'un inceleme kesinliği %31.6 ölçülmüş. Yani daha fazla gerçek sorunu yakalıyor, ancak bunların arasına daha fazla gürültü de katıyor. Aynı test ekibi, Sol'un yanlış bir yola sapmasının ardından basit bir değişiklik için 8 tur harcadığını da kaydetmiş. Maraton görevlerde güçlü olması, tavşan deliklerine hiç düşmeyeceği anlamına gelmiyor.
İki modele de aynı üç istemi gönderdim
Benchmark'lar uzun soluklu işleri ödüllendiriyor, oysa API çağrılarının çoğu kısa. Bu nedenle 29 Temmuz 2026'da gpt-5.6-sol ve gpt-5.5 modellerine aynı üç istemi gönderdim: Python'da tarih işleme hatası düzeltmesi, tam olarak iki geçerli yanıtı olan kısıt mantığı bulmacası ve tuzak içeren katı JSON çıkarımı. Tuzak, yılı eksik bir tarihti; kurallar bunun tahmin edilmesini değil, null yapılmasını söylüyordu. Her görev için tek API çağrısı kullandım; varsayılan akıl yürütme eforu, araç yok, tekrar deneme yok. Bu küçük bir örneklem; benchmark değil.
İki model de üçte üç yaptı. GPT-5.5, Aralık ayında oluşan çökme hatasını calendar.monthrange ile çözdü; Sol ise doğru bir artık yıl tablosunu elle oluşturdu. İkisi de dağıtım için tam olarak iki geçerli sıralamayı buldu, çıkarım görevinde bayt düzeyinde aynı JSON'u döndürdü ve “the 14th of July” için bir yıl uydurmayı reddetti.
Token tüketimi ile hız ise farklı yönlere gitti:
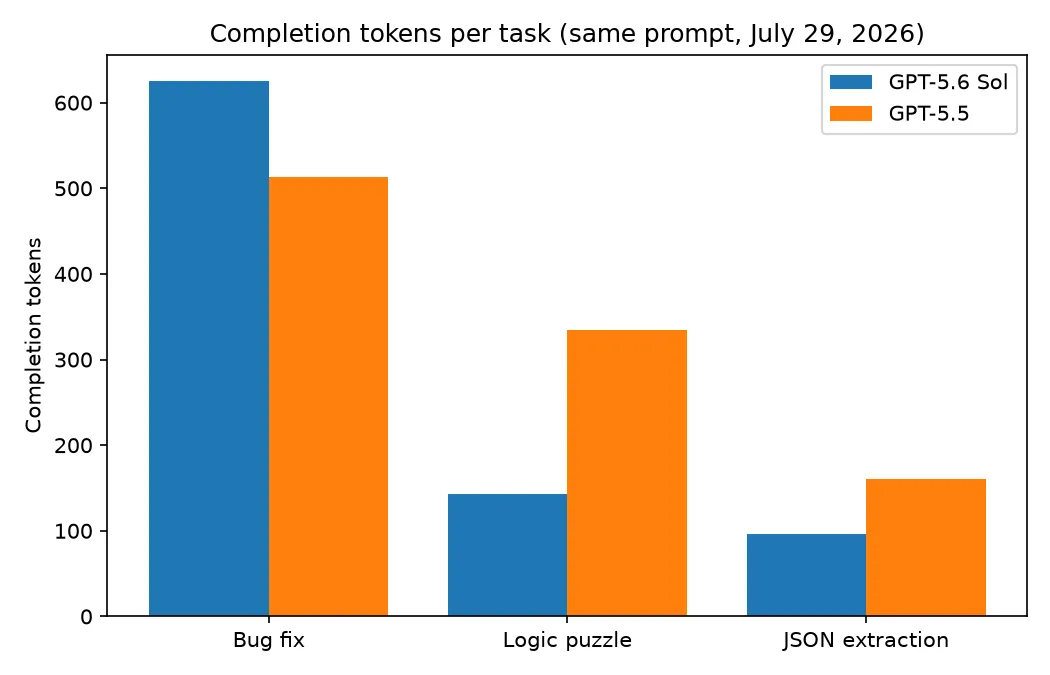
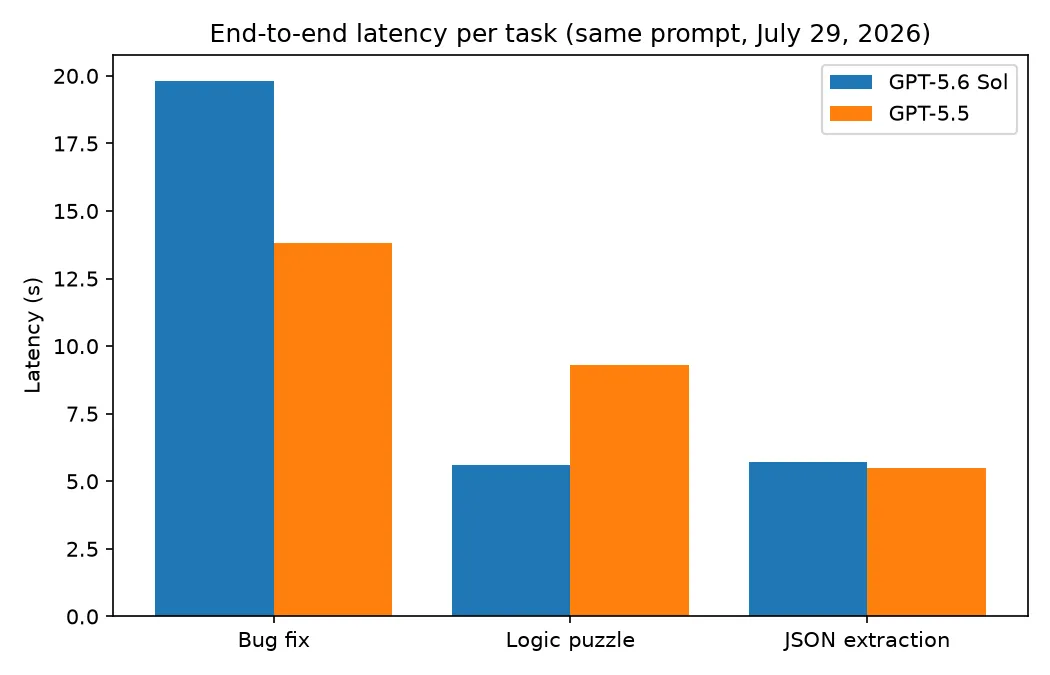
Sol toplamda daha az completion token'ı harcadı: 1,007'ye karşı 864. Buna rağmen kod görevinde daha yavaş ve daha konuşkandı: GPT-5.5'in 13.8 saniye ve 513 token'ına karşılık 19.8 saniye ve 625 token kullandı. Mantık bulmacasında ise durum tersine döndü; Sol 143 token ile 5.6 saniyede yanıt verirken GPT-5.5 334 token ve 9.3 saniye harcadı. İkisini izledikten sonraki yorumum şu: Kısa ve gereksinimleri net görevlerde modeller birbirinin yerine kullanılabilir. Bu test tek başına bir geçişi haklı çıkaracak bir neden sunmuyor. Yükseltme gerekçesi tamamen yukarıdaki benchmark bölümünde yer alan ajan ve uzun bağlam işlerine dayanıyor.
GPT-5.5 efor seviyenizi 5.6'ya nasıl taşımalısınız?
Yukarıda bağlantısı verilen Vellum incelemesine göre, yalın gpt-5.6 model kimliği varsayılan olarak gpt-5.6-sol'a yönleniyor. Yalnızca takma adı değiştirerek yükseltenler, bunu özellikle seçmeden amiral gemisi katmanına ve onun faturasına geçiyor. Bilinçli bir geçiş yapıyorsanız, eşleştirmeyi belirleyen üç veri noktası var:
- GPT-5.5 xhigh → Sol medium topluluğun kullandığı çalışma eşleştirmesi. Yukarıda alıntılanan r/codex raporu, 5.5 kalitesine yakın sonuçla çıkış döneminde görev başına yaklaşık 3 kat maliyet tespit etti. Bunu garanti olarak değil, kendi istemleriniz üzerinde doğrulamanız gereken bir başlangıç varsayımı olarak görün. 5.5 high seviyesinde çalışan bütçe hassasiyetli iş yükleri, Sol'un fiyat tarifesinin yarısı olan $2.50/$15 ile GPT-5.6 Terra'ya daha yakın duruyor.
- En üst seviyede düşünme süresi şişiyor. ChatGPT Pro kullanıcıları, 5.5 Pro'nun 5–10 dakika harcadığı görevlerde GPT-5.6'nın 20–50 dakika düşündüğünü bildiriyor. Bu ChatGPT gözlemi olsa da aynı akıl yürütme yığını API'de çıkış token'ı olarak ücretleniyor.
reasoning.mode: "pro"ayarı üç 5.6 katmanının tamamında kullanılabiliyor; dolayısıyla bu üst sınır isteğe bağlı. - Eski istemleriniz yeni modeli köstekleyebilir. Every.to'nun test ekibi, Sol'un çıktısının ancak eski modeller için yazılmış savunmacı talimatları kaldırdıklarında belirgin biçimde iyileştiğini gördü. “Her zaman X'i iki kez kontrol et” gibi kurallar, Sol'un gereğinden fazla doğrulama yapmasına ve çözümü gereksiz büyütmesine yol açıyor. Modeli taşıdıktan sonra sistem istemini de yeniden denetleyin; GPT-5.5'in ihtiyaç duyduğu ihtiyatlı iskelet, artık bir maliyet kalemi.
Kim geçmeli, kim şimdilik kalmalı?
İş yükünüz ajan tabanlıysa GPT-5.6 Sol'a geçin: çok adımlı araç kullanımı, web üzerinden araştırma veya depo ölçeğinde kodlama oturumları gibi. %88.8 Terminal-Bench ve %92.2 BrowseComp skorlarının anlamlı olduğu alan burası. İlk token gecikmesindeki 4 katlık düşüş de her döngü turunda birikiyor. Aynı $5/$30 fiyat tarifesinde yetenek sıçraması ek ücret getirmiyor; tabii ek akıl yürütme token'ları ve önbellek yazımları farkı silmezse. 1M bağlam ve turlar arası korunan akıl yürütme, 5.5 pipeline'larının çözmek zorunda kaldığı iki sorunu ortadan kaldırıyor.
Trafiğiniz kısa ve tanımı net çağrılardan oluşuyorsa şimdilik GPT-5.5'te kalın: çıkarım, sınıflandırma, tek seferlik kod düzeltmeleri ve yüksek hacimli üretim. Üç istemlik testimde modeller tam da bu iş türünde eşit sonuç verdi. Sol'un daha yavaş akışı da, saniyede 65 token'a karşı 77.3 token ile, toplu işleri kesin olarak kötüleştiriyor. Önbellek yazımı yoğun pipeline'larda geçmeden önce $6.25 satırını hesaplayın. Benzer kalitede daha düşük fatura istiyorsanız da yanıt Sol değil, Terra.
Karşılaştırmamı AIReiter üzerinden yaptım. Platform, tek API anahtarı arkasında gpt-5.6-sol ve gpt-5.5 sunuyor; dolayısıyla model dizgesini değiştirmek A/B testi için yeterli. Kendi trafiğinizde görev başına başarı oranını, uçtan uca gecikmeyi ve completion token'larını karşılaştırın.
SSS
GPT-5.6 Sol, GPT-5.5'ten daha mı iyi?
Ajan görevlerinde net biçimde daha iyi: Terminal-Bench 2.1'de %88.8, BrowseComp'ta %92.2 ve ilk token gecikmesinde 4 kat düşüş sağlıyor. Kısa, tek seferlik görevlerde ise bağımsız puanlama aralarında yalnızca 1 puan olduğunu gösteriyor (Artificial Analysis'te 54'e karşı 53); aynı istemlerle yaptığım testlerde de doğruluk farkı görmedim.
GPT-5.6 Sol, GPT-5.5'ten daha mı pahalı?
Liste fiyatı aynı: 1 milyon token başına $5 giriş, $30 çıkış. Sol, GPT-5.5'te olmayan $6.25 önbellek yazma ücreti ekliyor. Ayrıca yüksek efor ayarlarında görev başına daha fazla akıl yürütme token'ı harcıyor; r/codex kullanıcıları, 5.5 xhigh ile kalite eşitliğinde görev başı maliyeti yaklaşık 3 kat ölçtü.
GPT-5.5 xhigh'ın GPT-5.6'daki karşılığı nedir?
Medium efordaki Sol, görev başına yaklaşık üç kat maliyetle benzer kod kalitesi sunuyor. Yetenek tavanından çok maliyet eşitliği önemliyse, ekonomik açıdan daha yakın eşleşme Terra.
Yükselttikten sonra GPT-5.5'i kullanmaya devam edebilir miyim?
Evet. GPT-5.5, OpenAI'ın fiyatlandırma sayfasında hâlâ değişmeyen fiyatlarla listeleniyor; bunu 29 Temmuz 2026'da doğruladım. Yukarıdaki ekran görüntüsünde de görüldüğü gibi, henüz geçişi zorunlu kılan bir durum yok.
Kararı tek tabloda özetleyelim
| İş yükünüz | Tercih | Belirleyici veri |
|---|---|---|
| Çok adımlı ajanlar, web tarama, depo ölçeğinde kodlama | GPT-5.6 Sol | %88.8 Terminal-Bench, 4 kat düşük ilk token gecikmesi, aynı fiyat tarifesi |
| Kısa çıkarım / sınıflandırma / tek seferlik düzeltmeler | GPT-5.5 (şimdilik) | Aynı istem testlerinde eşitlik; 5.5 %19 daha hızlı akıyor |
| Yoğun istem önbelleği yazımı | GPT-5.5 veya önce mimariyi yeniden kurun | Sol'un $6.25/1M önbellek yazma ücreti yeni |
| Aynı kalite, daha düşük fatura | GPT-5.6 Terra | $2.50/$15, Sol fiyatının yarısı; yukarıdaki Terra ve 5.5 karşılaştırmasına bakın |
| Maksimum düşünme derinliği | reasoning.mode: "pro" ile Sol | 5.5'in 5–10 dakika harcadığı yerde 20–50 dakika değerlendirme |