 AIREITER
GPT-5.6 Sol’a geçtikten sonra faturanızın mantıksız biçimde yükseldiğini düşünüyorsanız, yalnız değilsiniz. 1.715 Codex oturumunda Sol, oturum başına 16,45 milyon token harcadı; bu, benzer kapsamdaki 1.667 oturumda GPT-5.5’in ortalaması olan 7,30 milyon tokenın 2,25 katı. Token başı fiyat aynı olsa da tüketim iki katı aşıyor. Dahası, Responses API’de belgelenen bir hata, Sol için faturalanan output_tokens değerini 6 kat veya daha fazla şişiriyor gibi görünüyor. GPT-5.6 faturanız hatalı görünüyorsa, muhtemelen gerçekten hatalıdır.
GPT-5.6 Sol oturum başına ne kadar token harcıyor?
Geliştirici Vincent Schmalbach, Codex kullanımındaki iki ayrı 14 günlük dönemde token tüketimini takip etti. Oturum sayıları neredeyse aynı olan GPT-5.5 xhigh ile GPT-5.6 Sol xhigh karşılaştırması şöyle:
| Metrik | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| Oturumlar | 1,667 | 1,715 |
| Toplam token | 12.17B | 28.22B |
| Oturum başına token | 7.30M | 16.45M |
Oturum sayısı yalnızca %2,9 arttı. Oturum başına token tüketimindeki artış ise %125 oldu. Yaklaşık aynı iş yükünde toplam tüketim 12,17 milyardan 28,22 milyar tokena, yani 2,32 katına çıktı.
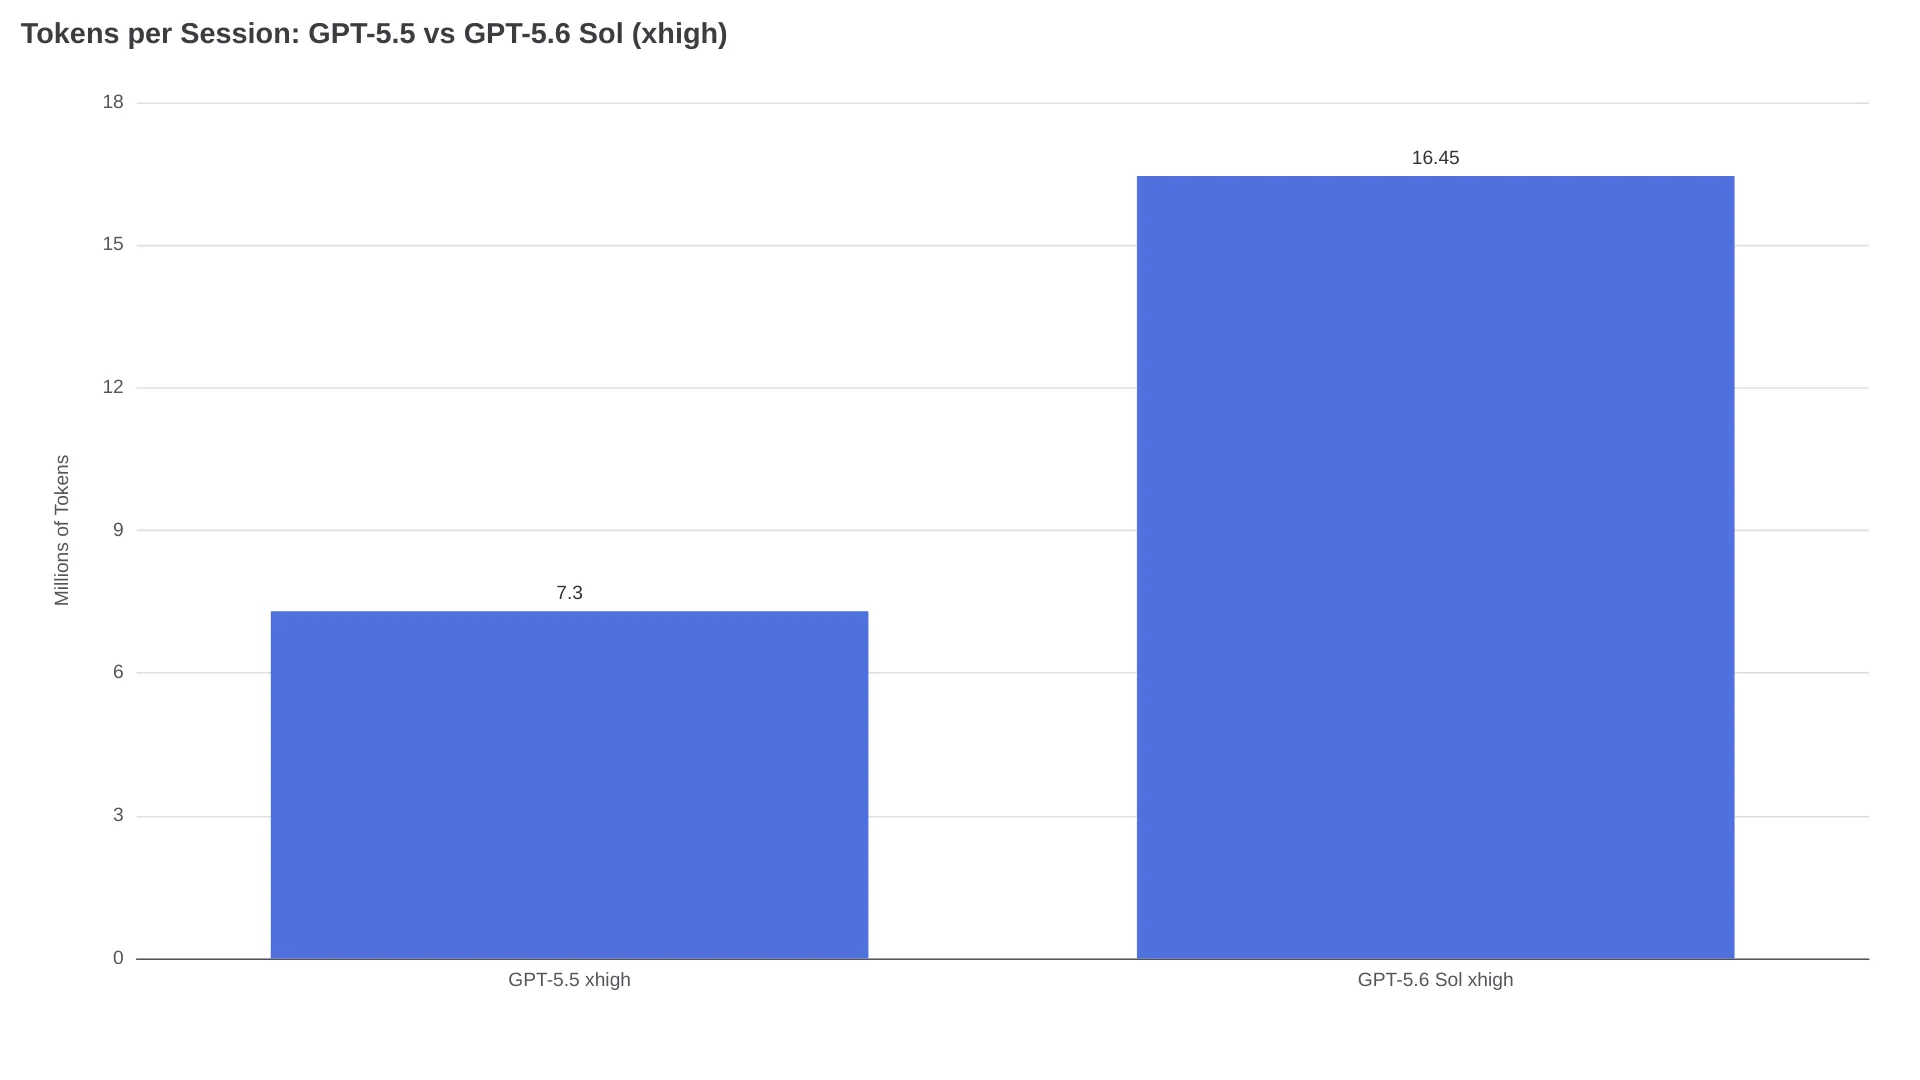
OpenAI fiyatlandırma sayfasında GPT-5.6 Sol için 1M giriş tokenı başına $5, çıkış tokenı başına ise $30 yazıyor; GPT-5.5 ile tamamen aynı fiyatlar. Dolayısıyla 2,25 kat token, görev başına yaklaşık 2,25 kat maliyet anlamına geliyor. GPT-5.6 Sol ayrıca GPT-5.5’te bulunmayan, giriş fiyatının 1,25 katı tutarında bir cache-write ek ücreti getirdi.
"GPT 5.6 Sol tam bir token fırını. Medium ya da high ayarında bile tokenları silip süpürüyor gibi. 5.6’yı yalnızca karmaşık planlama veya zor hatalar için kullanacağım." — r/codex kullanıcısı
Schmalbach’ın eskiden yoğun çalışmayla bir hafta yeten üç aboneliği, artık orta düzey kullanımda yaklaşık bir günde tükeniyor.
Sol neden daha çok token tüketiyor?
Sol, benchmark puanı başına rakiplerinden daha verimli. Artificial Analysis Coding Agent Index verilerine göre, eşdeğer skorlar için Claude Fable 5’ten daha az çıkış tokenı kullanıyor. Ancak gerçek kullanım oturumlarında daha agresif düşünüyor: plan yapıyor, geri dönüyor, doğruluyor ve alternatifleri araştırıyor. Her token daha faydalı iş çıkarabilse de bunun bedeli, görev başına daha yüksek token tüketimi oluyor.
Çıkış tokenlarını şişiren bildirilen faturalandırma hatası
Yüksek gerçek kullanımın ötesinde, Responses API’de belgelenen bir muhasebe hatası output_tokens alanını şişiriyor gibi görünüyor; faturalandırma da bu alan üzerinden hesaplanıyor. OpenAI konuyu inceliyor, ancak temel nedeni henüz kamuya açık biçimde doğrulamadı.
Bir geliştirici sorunu 710 GPT-5.6 çağrısı ve toplam 22.922 reasoning çağrısı üzerinden belgeledi. GPT-5.6, yanıt başına birden fazla reasoning öğesi üreten ilk model ailesi. Sol için medyan k=9, Terra içinse k=4. API’deki bir toplayıcı, üretim sırasında doğru nihai toplamın üzerine her reasoning öğesi için o ana kadarki reasoning toplamını bir kez daha ekliyor.
Formül şöyle:
output_tokens ≈ R × (k + 3) / 2Burada R gerçek reasoning tokenı, k ise reasoning öğesi sayısı. Sol’da medyan k=9 olduğunda faturalanan sayı yaklaşık 6 kat şişiyor. Terra’da k=4 için bu oran yaklaşık 3,6 kat.
Gerçek bir faturada nasıl görünüyor?
Belgelenen en uç örnekte, yalnızca dört karakterlik bir yanıt döndüren tek bir GPT-5.6 Terra çağrısı (d1d4), gerçekte 21.064 reasoning tokenı üretmesine rağmen 466.818 çıkış tokenı üzerinden faturalandırıldı.
| API’nin bildirdiği değer | Değer |
|---|---|
output_tokens (faturalanan) | 466,818 |
reasoning_tokens (gerçek) | 21,064 |
| Görünür çıktı | d1d4 (4 karakter) |
| Reasoning öğeleri (k) | 41 |
k=41 iken formül R × (41+3)/2 = 21,064 × 22 = 463,408 sonucunu veriyor; bu da faturalanan tutardan yalnızca %0,7 sapıyor. Bildirimi yapan kişi bunu faturalandırma panosunda doğruladı: API’nin output_tokens değerleri toplanıp yayımlanmış fiyatlar uygulandığında, pano ücretleri sentin onda birine kadar yeniden hesaplanabildi. GPT-5.6 çağrılarında faturalanan yaklaşık $320’ın yaklaşık $284’ü fazla ücretlendirmeydi.
Bu hata GPT-5.6’dan önce de vardı
k=1 olduğunda —yani GPT-5.6 öncesi modellerin ürettiği tek reasoning öğesinde— formül R × 4/2 = 2R’ye indirgeniyor. Bu, sabit 2 kat fazla ücretlendirme demek. Bildirimi yapan kişi, bunu Mayıs 2026 tarihli OpenAI kullanım dışa aktarması üzerinden doğruladı:
| Model | Faturalanan çıkış tokenı | Gerçek sayı | Oran |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini (kontrol) | 12,054,680 | 9,160,567 | 1.01x |
Hata GPT-5.6 ile ortaya çıkmadı. GPT-5.6, reasoning sürecini çok sayıda öğeye bölen ilk model olduğu için, sessizce işleyen 2 katlık farkı çok daha büyük bir çarpana dönüştürüyor. Bunun nedeni reasoning çıktısının yaklaşık 512 tokenlık parçalar halinde üretilmesi; yani k ≈ ceil(R/512). Bu değer formülde yerine konduğunda output_tokens ≈ R²/1024 + 3R/2 elde ediliyor. Başka bir deyişle fazla ücretlendirme, reasoning uzunluğu ile karesel olarak büyüyor. Düşünme miktarını ikiye katlamak, faturayı yaklaşık dört katına çıkarıyor.
Bu yazının yayımlandığı tarih itibarıyla (Ağustos 2026), OpenAI çalışanları hata bildirimine yanıt vererek ek veri talep etti; ancak kamuya açık olarak doğrulanmış bir düzeltme veya fatura düzenlemesi bulunmuyor.
30 Temmuz indirimi sonrası güncel GPT-5.6 fiyatları
30 Temmuz 2026’da OpenAI, Luna’nın fiyatını %80, Terra’nınkini ise %20 düşürdü. Sol’un fiyatı değişmedi. OpenAI fiyatlandırma sayfasındaki güncel oranlar şöyle:
| Model | Giriş (kısa) | Önbellekten giriş | Önbellek yazma | Çıkış (kısa) | Çıkış (uzun) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
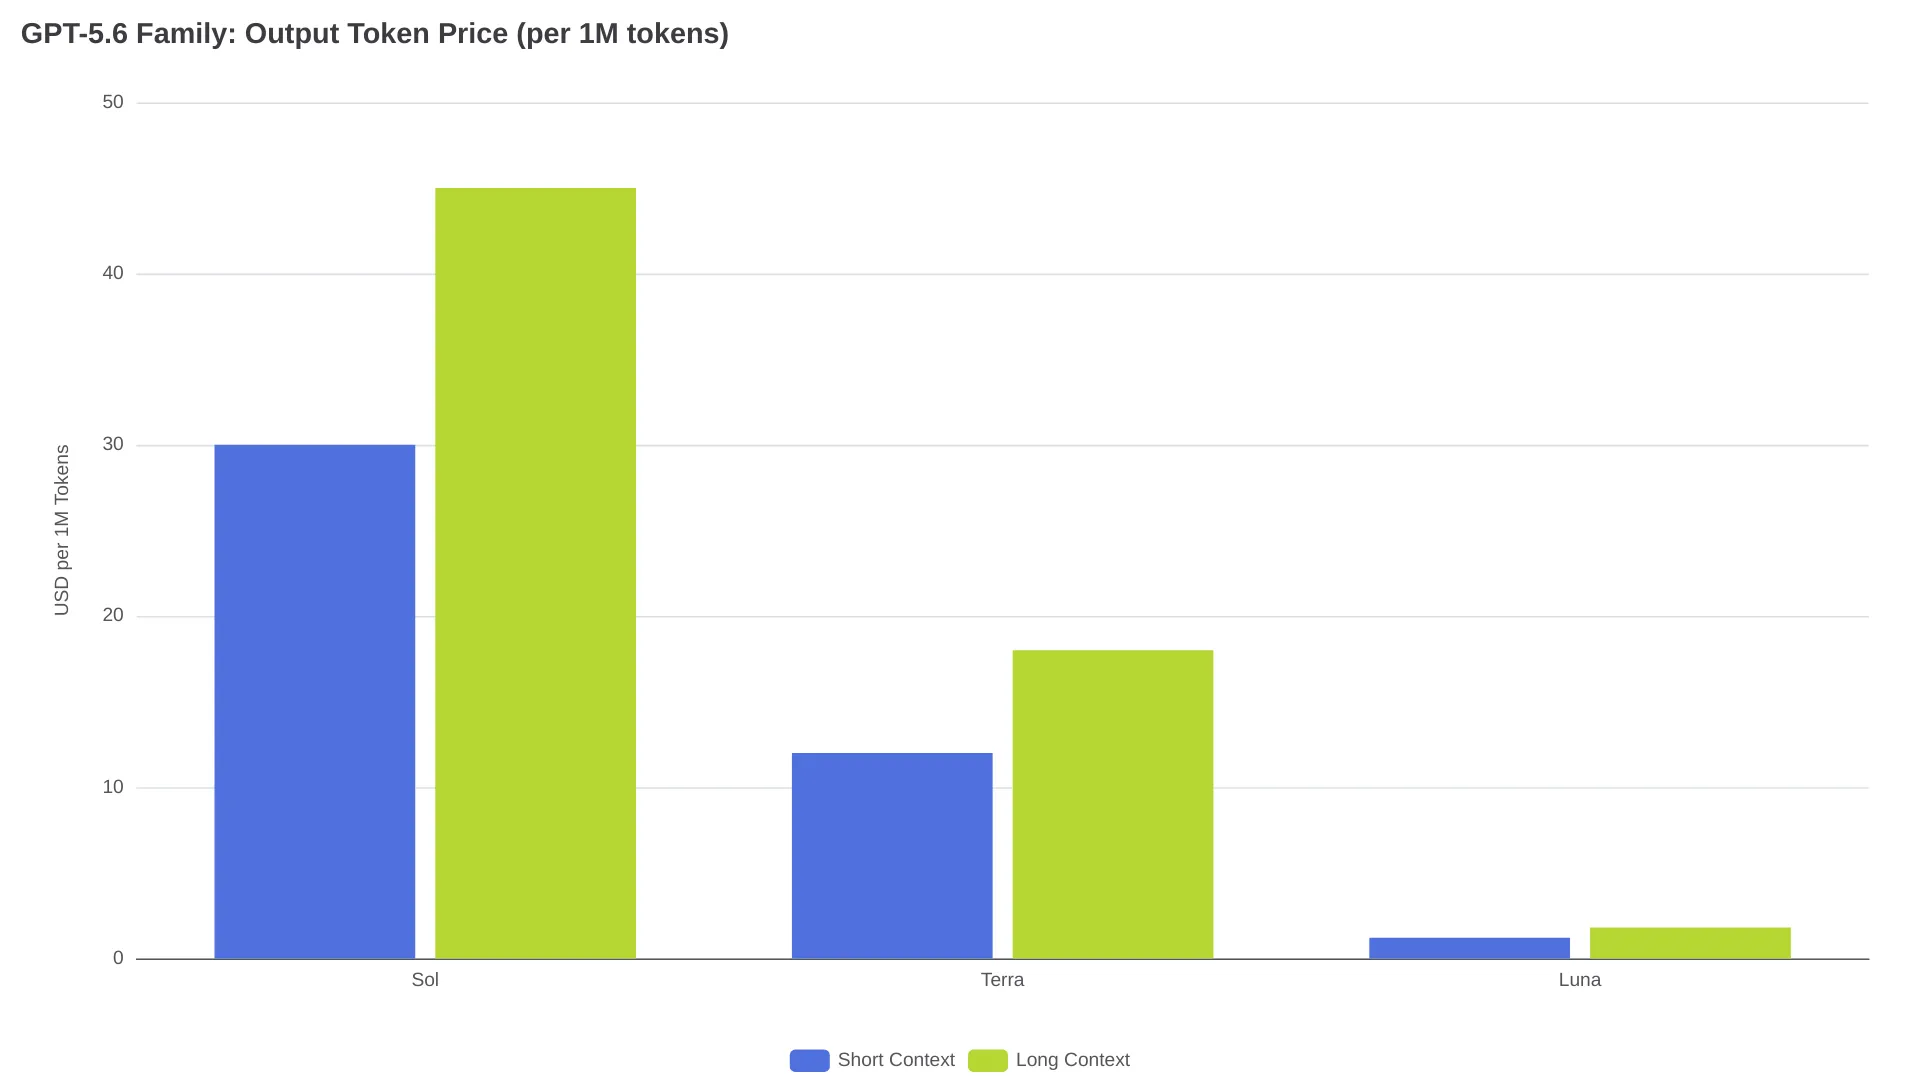
Sol’un token başı fiyatı GPT-5.5 ile aynı. Ancak görev başına 2,25 kat token kullandığı için efektif görev maliyetiniz yaklaşık iki katına çıkıyor.
Önbelleğe yazma artık ayrı bir ücret kalemi. GPT-5.6, cache write işlemleri için giriş fiyatının 1,25 katını alıyor; Sol’da bu tutar 1M token başına $6,25. GPT-5.5’te cache-write ücreti yoktu. İş yükünüzde cache-hit oranı düşükse, daha önce olmayan giriş maliyetlerinizin üzerine %25’lik ek ücret biniyor.
Luna artık GPT-5.4 nano’dan daha ucuz. İndirim sonrası $0.20/$1.20 fiyatıyla, nano’nun $0.20/$1.25 fiyatını geride bırakan Luna, OpenAI serisindeki en ucuz model konumunda.
GPT-5.6 token faturasını düşürmenin üç yolu
Rutin işler için Terra’ya inin
Terra’nın çıkış fiyatı 1M token başına $12; Sol’un $30’lık fiyatından %60 daha düşük. Artificial Analysis Coding Agent Index üzerinde Terra, Claude Fable 5’in hemen üzerinde puan alıyor. Temmuzdaki %20 fiyat indiriminin ardından Terra, $2.00/$12.00 fiyatıyla eski GPT-5.5 oranının da altına indi.
Peki Sol ne zaman hâlâ mantıklı? Çok adımlı hata ayıklama oturumları, büyük kod tabanlarında mimari planlama ve güvenlik analizi gibi işlerde. Bu görevler uzun reasoning zincirlerinden fayda sağlıyor. Standart kodlama, analiz ve içerik üretiminde ise Terra, token tüketiminin çok daha küçük bir bölümüyle benzer sonuçlar sunuyor.
Daha düşük efor ayarlarını kullanın
reasoning.effort parametresi modelin ürettiği reasoning tokenı miktarını belirliyor; bildirilen faturalandırma hatası da reasoning öğelerinin sayısıyla (k) doğrudan ölçekleniyor. medium ayarında Sol, xhigh ayarına kıyasla daha az reasoning öğesi üretiyor; dolayısıyla faturalandırmadaki şişme de orantılı olarak azalıyor.
"Terra Ultra kullanıyorum ve token kullanımı gerçekten GPT 5.5’e göre çok daha verimli görünüyor." — r/codex kullanıcısı
Token fırını davranışı, yüksek efor seviyelerindeki Sol kullanımında yoğunlaşıyor. reasoning.effort değerini xhigh veya max yerine medium ya da high yapmak, uygulayabileceğiniz en etkili tek değişiklik.
Önbellek isabet oranını artırın
GPT-5.6, açık cache breakpoint’leri ve en az 30 dakikalık önbellek ömrü getirdi. Önbellekten okunan girişler %90 indirimli; böylece Sol’un giriş maliyeti 1M token başına $5,00’dan $0,50’ye iniyor. Buna karşılık önbelleğe yazma, giriş fiyatının 1,25 katına mal oluyor; Sol için 1M token başına $6,25.
Prompt’larınızı, sistem mesajı ve sabit bağlam bir cache breakpoint’inden önce yer alacak şekilde düzenleyin. Başabaş noktası iş yükünüze bağlıdır: cache-write primi giriş fiyatının %25’i iken cache-read tasarrufu %90’dır. Bu nedenle okumalardaki tasarrufun yazma ek ücretini aşacağı bir isabet oranına ihtiyacınız var. İsteklerin çoğunun uzun bir sistem prompt’unu paylaştığı iş yüklerinde denge hızla lehinize döner.
Sık sorulan sorular
OpenAI faturalandırma hatasını kabul etti mi?
OpenAI çalışanı Mark G., 12 Temmuz 2026’da topluluk forumundaki bildirime yanıt vererek inceleme için istek kimlikleri ve zaman damgaları istedi. Ağustos 2026 itibarıyla kamuya açık biçimde doğrulanmış bir düzeltme veya geriye dönük faturalandırma ayarlaması yok.
Faturalandırma hatasının hesabımı etkileyip etkilemediğini nasıl kontrol ederim?
Birden çok reasoning öğesi içeren her yanıt için usage.output_tokens_details.reasoning_tokens ile görünür tamamlama tokenlarını toplayın. usage.output_tokens bu toplamı birkaç yüzden fazla aşıyorsa, forum bildiriminde belgelenen kümülatif yeniden toplama davranışı muhtemelen faturanızı etkiliyordur. OpenAI panosundan kullanım CSV’nizi indirin ve model bazında kontrol edin.
Sol’dan Terra’ya geçmeli miyim?
Çoğu API iş yükünde Terra daha düşük maliyetli ve kodlama benchmark’larında rekabetçi skorlar elde ediyor. Sol’un avantajı en zor görevlerde ortaya çıkıyor: OpenAI’nin kendi benchmark’ları, Sol’un Terra’yı özellikle çok adımlı reasoning ve güvenlik araştırmalarında geçtiğini gösteriyor. Bu alanlarda uzun düşünme süresinin getirisi en yüksek seviyede.