 AIREITER
Tanıtımdan önce anonim bir model Ox Alpha adıyla dolaşıma girmişti. Z.ai artık bu deneye resmi bir isim verdi: GLM-5.3-Flash. Ancak “Flash” etiketini doğru yorumlamak gerekiyor. Model her token için 18 milyar parametreyi etkinleştiriyor; buna karşın yayınlanan checkpoint yaklaşık 320 milyar parametre içeriyor ve yerel çalıştırma için hâlâ ciddi bir donanım gerekiyor.
Kısa cevap: Ox Alpha, GLM-5.3-Flash’ın ön gösterimiydi
Z.ai’nin 26 Ağustos 2026 tarihli duyurusu, GLM-5.3-Flash’ın daha önce OpenCode ve OpenRouter üzerinde Ox Alpha adıyla anonim biçimde önizlendiğini doğruluyor. Resmi Hugging Face model kartında artık herkese açık checkpoint, MIT lisansı, çok modlu girdiler ve yerel sunum seçeneklerine ilişkin bilgiler yer alıyor.
Ox Alpha hakkında yayımlananları piyasaya sürülmüş modelin kesin teknik özellikleri olarak değil, önizleme dönemi verileri olarak değerlendirin. Ox Alpha’nın kendi yönlendirme sistemi, trafik koşulları ve operasyonel sınırları vardı. Bu nedenle ilk dönem hız, kota ve politika raporları her GLM-5.3-Flash uç noktasını yansıtmayabilir.
“Benim açımdan hiçbir şeyi değiştirmedi. İki model de 32 GB RAM’li sistemim için fazlasıyla büyük.” — u/dampflokfreund, r/LocalLLaMA
GLM-5.3-Flash özellikleriyle
| Özellik | GLM-5.3-Flash |
|---|---|
| Resmi çıkış | 26 Ağustos 2026 |
| Önceki önizleme adı | Ox Alpha / ox-alpha |
| Model yapısı | Toplam 320B parametre, token başına 18B etkin parametre |
| Bağlam penceresi | 1.048.576 token (1M) |
| Girdi | Metin, görsel ve video |
| Çıktı | Metin |
| Lisans | MIT |
| Resmi checkpoint | zai-org/GLM-5.3-Flash |
| Listelenen API girdi fiyatı | 1M token başına $0.15 |
| Listelenen önbellekli girdi fiyatı | 1M token başına $0.03 |
| Listelenen API çıktı fiyatı | 1M token başına $0.50 |
Hugging Face sayfasında modelin kayıtlı boyutu yaklaşık 321 milyar parametre olarak gösteriliyor. Model açıklamasında ise daha kısa biçimiyle 320B-A18B ifadesi kullanılıyor. Bu rakamlar sırasıyla toplam kayıtlı kapasiteyi ve token başına etkin hesaplamayı anlatıyor. Token başına 18B parametrenin etkin olması, checkpoint’i yerelde çalıştırılabilen 18B’lik bir modele dönüştürmüyor.
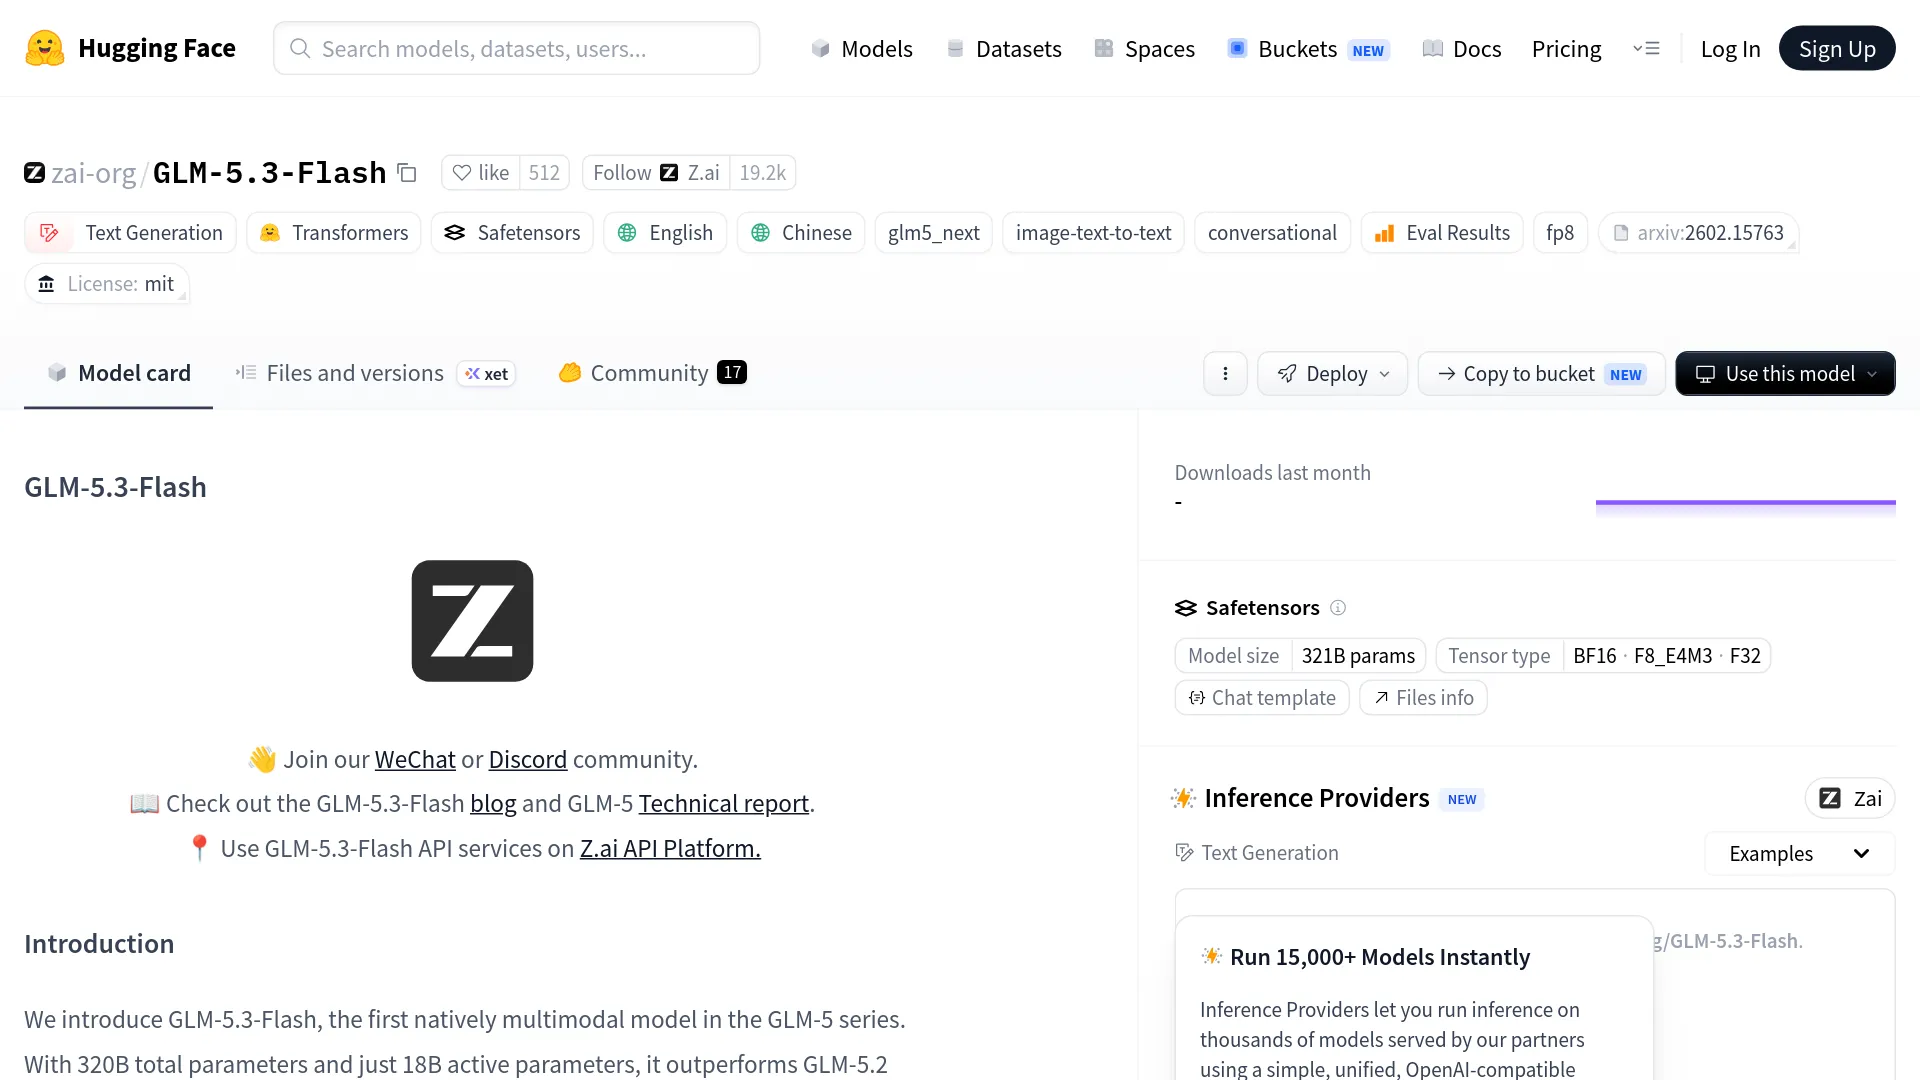
Ox Alpha’dan herkese açık modele geçerken ne değişti?
Z.ai, GLM-5.3-Flash’ı resmi olarak yayımlamadan önce gerçek kullanım geri bildirimi toplamak amacıyla OpenCode ve OpenRouter üzerinde Ox Alpha adıyla anonim biçimde çalıştırdığını söylüyor. OpenRouter kaydı, önizleme sürümünü çok modlu ve uzun bağlamlı bir model olarak, geçici $0 fiyatıyla gösteriyordu. Herkese açık sürümle birlikte sağlayıcı, checkpoint ve lisans artık açıkça belli.
Önizleme ile piyasaya sürülen model yine de aynı çalışma ortamı anlamına gelmiyor. Tokenizer eşleşmesi veya GLM tarzı bir API hatası modelin soyuna dair ipucu verebilir; ancak anonim isteklerin tamamının nihai ağırlıkları ya da aynı yönlendirme katmanını kullandığını kanıtlamaz. Dağıtım ve tekrarlanabilirlik açısından artık temel alınması gereken referans, herkese açık checkpoint.
“Flash” adının arkasındaki mimari
GLM-5.3-Flash, seyrek mixture-of-experts mimarisini çok uzun bağlamların maliyetini azaltmaya yönelik dikkat mekanizması değişiklikleriyle birleştiriyor. Z.ai; toplam 320B parametre, 18B etkin parametre, 45 katman, hibrit seyrek ve doğrusal attention, IndexPool retrieval ve Manifold-Constrained Hyper-Connections (mHC) kullanıldığını belirtiyor. Model kartına göre eğitimde 30T token’lık çok modlu bir ön eğitim veri kümesinden yararlanılmış.
Z.ai, 1M bağlamda GLM-5.3’e kıyasla attention hesaplamasının 3 kat, KV cache boyutunun ise 4,4 kat daha düşük olduğunu bildiriyor. Bunlar üreticinin mimari iddiaları; donanımdan bağımsız bir gecikme garantisi değiller. Gerçek hız; bağlam uzunluğuna, eşzamanlı istek sayısına, görsel ön işleme sürecine ve kullanılan sunum altyapısına göre değişir.
Modelin yerleşik çok modluluğu, onu genel bir “görsel sohbet botu” olarak konumlandırmaktan çok ajan senaryolarında anlam kazanıyor. Z.ai’nin hedeflediği döngüde ajan; oluşturulmuş arayüzleri, tarayıcı durumlarını, belgeleri veya diğer görsel çıktıları inceliyor, ardından kodu ya da ürettiği çıktıyı revize ediyor. Resmi model kartı görsel girdisini gösteriyor; herkese açık model ve dağıtım belgelerinde video girdisi de destekleniyor.
Benchmark tablosu bize ne söylüyor, ne söylemiyor?
Resmi duyuru ve model kartı, özellikle kodlama ve ajan görevlerinde güçlü sonuçlar bildiriyor. Model kartında görünen sonuçlar arasında TerminalBench 2.1 için 84.3, DeepSWE için 63.4 ve HLE için 55.3 bulunuyor. Z.ai’nin duyuru metni ayrıca Artificial Analysis Intelligence Index skorunu 57, AutomationBench sonucunu 48.8 ve Z.ai Code Bench’te maksimum eforla alınan sonucu 29.0 olarak veriyor.
| Benchmark | GLM-5.3-Flash | Karşılaştırma veya referans | Kaynak ve sınırlama |
|---|---|---|---|
| TerminalBench 2.1 | 84.3 | GLM-5.2: 81.0; Claude Opus 4.8: 85.0 | Z.ai/model kartı sonucu; harness ve bütçeler önem taşıyor |
| DeepSWE v1.1 | 63.4 | GLM-5.2: 46.2 | Bildirilmiş değerlendirme; her repository için genelleme yapılamaz |
| AutomationBench | 48.8 | GLM-5.2: 26.2 | Belirli bir benchmark sürümüyle yapılan değerlendirme |
| Z.ai Code Bench, maksimum efor | 29.0 | Claude Opus 4.8: 29.5 | Z.ai’nin kurulumunda neredeyse başa baş sonuç iddiası |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai’ye göre Claude Opus 4.8 ile karşılaştırılabilir | Harici endeks; görev dağılımı yalnızca kodlama skorunu göstermiyor |
Bu sonuçlar farklı harness’ler, bağlam sınırları, zaman aşımı ayarları ve değerlendiriciler kullanılarak elde edilmiş. Bu yüzden rakamları tek bir evrensel liderlik tablosu gibi değil, genel yönü gösteren veriler olarak karşılaştırmak gerekir. En makul sonuç şu: GLM-5.3-Flash’ın kodlama ajanı değerlendirmelerinde GLM-5.2’ye kıyasla ciddi bir ilerleme kaydettiğine dair inandırıcı kanıt var; ancak bu, her frontier modelini geride bıraktığı anlamına gelmiyor.
Aynı temkin, topluluk testleri için de geçerli. @prz_chojecki, Ox Alpha’nın 226 ErdosBench probleminin tamamında GLM-5.2’den daha yüksek skor aldığını bildirdi. Bu gözlem test senaryoları oluşturmak için değerli; ancak kendi araçlarınız ve repository’niz üzerinde kontrollü bir değerlendirmenin yerini tutmaz.
İlk kullanıcıların gördüğü pratik sınırlar
“Flash” ifadesi, etkileşimli gecikmeden çok etkin hesaplama ve maliyet konumlandırmasını anlatıyor. r/opencodeCLI topluluğundaki gerçek kullanıcı paylaşımları, özellikle anonim önizleme döneminde hem güçlü kodlama sonuçlarından hem de can sıkıcı bekleme sürelerinden söz etti. Bunlar resmi gecikme benchmark’ları değil; sağlayıcıya ve iş yüküne bağlı gözlemler.
“Ana modelden çok daha yavaşsa buna nasıl ‘Flash’ denebilir?” — u/ahriad, r/opencodeCLI
Operasyon açısından en anlamlı sinyal, yoğun yük altındaki uzun süreli ajan görevlerinin güvenilirliği. @solomonneas, yedi günlük bir testte 49 denemenin 30’unda başarılı derleme, 14’ünde ise zaman aşımı kaynaklı hata bildirdi. Bu veri, resmi API için sabit bir hata oranını kanıtlamıyor; yine de saatler sürebilen görevlerde yedek bir rota bulundurmayı haklı çıkarıyor.
Benchmark başlıklarının gizlediği bir başka sınır da yerel dağıtım tarafında. Resmi FP8 checkpoint, çalışma zamanı ve KV cache ek yükleri hesaba katılmadan yaklaşık 306 GiB yer kaplıyor. Yani toplam 320B parametreli model, her token için yalnızca 18B parametre etkin olsa bile yüksek kapasiteli bellek altyapısı gerektiriyor.
API, barındırılan kullanım ve yerel dağıtım seçenekleri
Barındırılan kullanımda Z.ai’nin fiyatlandırma sayfası GLM-5.3-Flash için 1M girdi token’ı başına $0.15, 1M önbellekli girdi token’ı başına $0.03 ve 1M çıktı token’ı başına $0.50 fiyatlarını listeliyor. Geçici %50 kampanyada bu rakamlar girdi için $0.075, önbellekli girdi için $0.015 ve çıktı için $0.25 olarak belirtilmiş; kampanya 9 Eylül 2026 saat 24:00’te UTC+8’e göre sona eriyor. Bütçe planlamadan önce resmi Z.AI fiyatlandırma tablosunu kontrol edin; kampanyanın bir bitiş tarihi var.
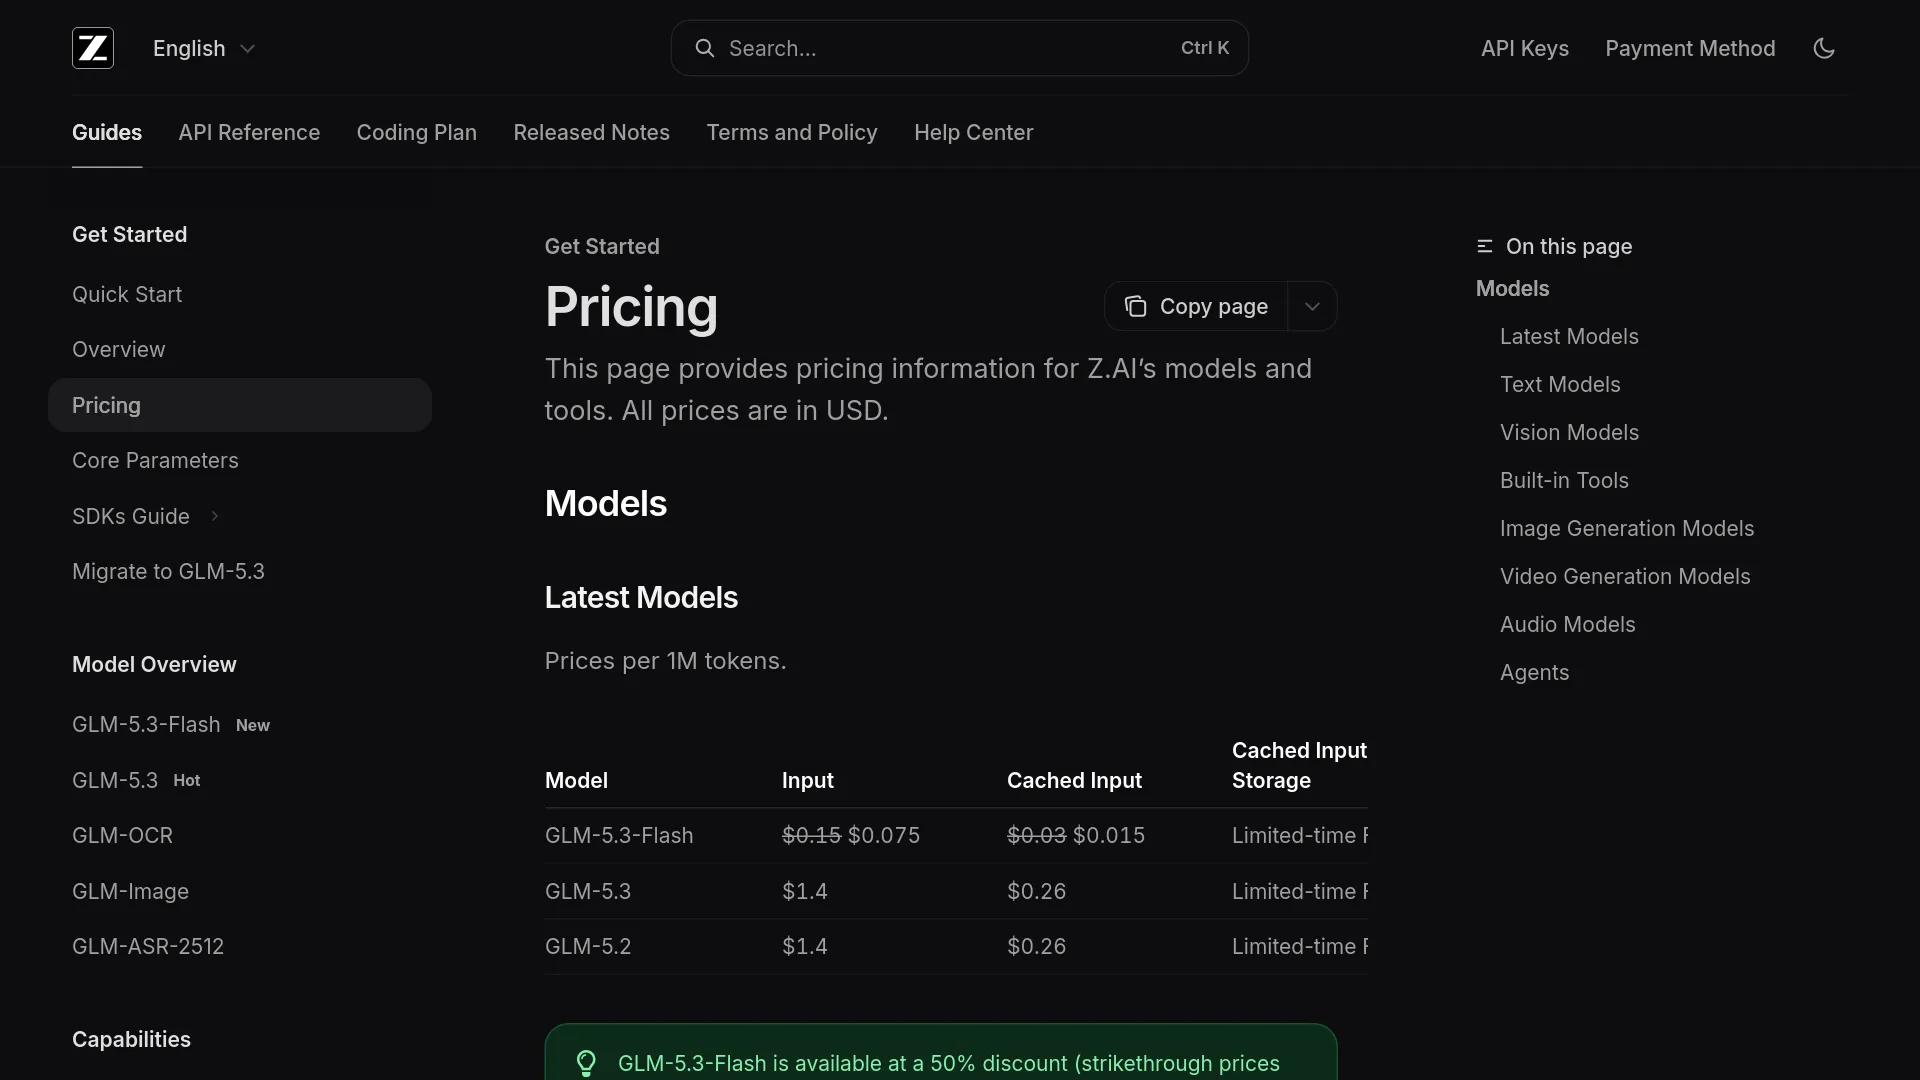
Herkese açık liste fiyatı, Ox Alpha önizlemesindeki geçici fiyatlandırmadan farklı. Basit bir örnek verelim: liste fiyatlarıyla 10M girdi token’ı ve 2M çıktı token’ı, başka sağlayıcı ücretleri hesaba katılmadan $2.50 tutar: 10 × $0.15 + 2 × $0.50. Sağlayıcı bu token’ları önbellekli olarak faturalandırdığında girdi maliyeti daha düşük olabilir.
Yerel çalıştırma mümkün; ancak bu işlem bir dizüstü bilgisayara model indirip çalıştırmaktan çok, başlı başına bir altyapı projesi. Resmi vLLM tarifi, FP8 ağırlıkları için yaklaşık 306 GiB ve varsayılan FP8 dağıtımı için 386GB VRAM listeliyor; BF16 için verilen değer ise 772GB. Desteklenen yol şu an NVIDIA Hopper veya daha yeni GPU’lar, güncel bir FlashInfer sürümü ve entegrasyon olgunlaşana kadar özel bir vLLM imajı gerektiriyor.
KTransformers öğreticisi, CPU-GPU hibrit çıkarımı, resmi FP8 ağırlıklarının doğrudan kullanımını ve en az 350GB boş sistem belleğini belgeliyor. Tek GPU örneği, modelin tek bir tüketici GPU’suna sığdığını göstermiyor; bu, ağırlıkların bir kısmının başka bileşenlere aktarıldığı bir yapılandırma. Öğreticide ayrıca doğrulanmış 501.025 token’lık bir ayar kullanılıyor ve her çok modlu istek en fazla sekiz görsel ya da bir video ile sınırlandırılıyor.
| Dağıtım yolu | Belgelerin desteklediği kullanım | Temel kısıt |
|---|---|---|
| Z.ai API | Ölçümlenebilir barındırılan erişim; liste ve kampanyalı token fiyatları yayımlanmış | Hız limitlerini, bölgesel koşulları ve güncel kampanyayı doğrulayın |
| vLLM | FP8/BF16 sunumu, OpenAI uyumlu uç nokta, tensor parallelism ve çok modlu yol | Yüksek bellekli NVIDIA altyapısı; güncel tarif Hopper+ hedefliyor |
| KTransformers | CPU-GPU hibrit çıkarımı ve FP8 yükleme | Yaklaşık 306 GiB ağırlık; en az 350GB sistem belleği öneriliyor |
| Ollama/LM Studio/llama.cpp ekosistemi | Model kartı, quantized dağıtımlara ve uyumlu araçlara işaret ediyor | Quantized desteği ve hız, kullanılan derlemeye göre değişiyor |
GLM-5.3-Flash’ı şu an kimler kullanmalı?
Maliyete duyarlı kodlama ajanları ve uzun bağlamlı mühendislik pilotları için kullanın. Düşük liste fiyatı, 1M bağlam penceresi ve GLM-5.2’ye kıyasla bildirilen ilerleme; repository analizi, birden fazla dosyada değişiklik, test üretimi ve tekrarlanan ajan çağrıları için modeli güçlü bir aday hâline getiriyor. Kendi başarı oranınız istikrarlı hâle gelene kadar kabul testlerini ve yedek bir modeli süreçte tutun.
Metin tabanlı GLM modellerinin yetersiz kaldığı çok modlu teknik işlerde kullanın. Görsel ve video girdileri, ajanın tarayıcı çıktısını, kullanıcı arayüzü düzenlerini, diyagramları, belgeleri ve oluşturulmuş görsel çıktıları incelemesine yardımcı olabilir. Bu model bir video üreticisi değil; görsel girdileri analiz eder ve metin ya da kod döndürür.
Yalnızca “18B etkin” ifadesi masaüstü bilgisayar modeli gibi göründüğü için tercih etmeyin. Toplam checkpoint yaklaşık 320B parametre içeriyor ve yerel kullanımda bağlam ile çalışma zamanı ek yükleri hesaba katılmadan önce yüzlerce gigabayt depolama veya bellek gerekiyor. Zaten yüksek bellekli çıkarım donanımınız yoksa barındırılan API genellikle daha basit ve ekonomik seçenek.
Gizli kodları doğrulanmamış bir önizleme uç noktasına göndermeyin. Herkese açık GLM-5.3-Flash sürümü Z.ai’ye ait olduğu açıkça belirtilen bir ürün; ancak sağlayıcının koşulları, veri saklama politikası ve yönlendirme yapısı yine de önem taşıyor. Üretim trafiğinde uç noktanın güncel veri politikasını kayda geçirin ve resmi API’yi ya da çalışma koşullarını denetleyebileceğiniz bir sağlayıcıyı kullanın.
Sık sorulan sorular
Ox Alpha ile GLM-5.3-Flash tamamen aynı mı?
Z.ai, GLM-5.3-Flash’ın daha önce Ox Alpha adıyla önizlenen model olduğunu resmi olarak belirtiyor. Ox Alpha dönemindeki davranışlar hâlâ yararlı bir bağlam sunuyor; ancak önizleme yönlendirmesi ve sınırları herkese açık modelin teknik özellikleri olarak kabul edilmemeli.
GLM-5.3-Flash açık kaynak mı?
Resmi Hugging Face checkpoint’i MIT lisansıyla yayımlandı ve Z.ai yerel çalıştırma seçeneklerine ilişkin referanslar sağlıyor. Operasyonel açıdan en doğru ifade “açık ağırlıklar”: ağırlıklara erişilebiliyor, ancak modelin tamamını çalıştırmak hâlâ ciddi bir altyapı gerektiriyor.
GLM-5.3-Flash’ı yerelde çalıştırmak için ne kadar bellek gerekiyor?
Resmi FP8 ağırlıkları, çalışma zamanı ve KV cache ek yükleri hariç yaklaşık 306 GiB yer kaplıyor. vLLM tarifi varsayılan FP8 dağıtımı için 386GB VRAM listelerken, KTransformers hibrit çıkarım için en az 350GB sistem belleği öneriyor.
API gerçekten milyon girdi token’ı başına $0.15 mi?
Evet. Z.AI’nin resmi fiyatlandırma sayfasında girdi için $0.15, önbellekli girdi için $0.03 ve çıktı için $0.50 belirtiliyor. %50 kampanya ise UTC+8’e göre 9 Eylül 2026 tarihine kadar listelenmiş.
GLM-5.3-Flash diğer Flash modellerinden daha hızlı mı?
Mevcut veriler evrensel bir gecikme sıralaması ortaya koymuyor. İlk kullanıcılar yavaşlayan veya zaman aşımına uğrayan ajan oturumları bildirdi. Bu nedenle kendi sağlayıcı rotanızda ilk token’a kadar geçen süreyi, tamamlanma süresini, tekrar denemeleri ve başarıyla kabul edilen görev oranını ölçün.
GLM-5.3-Flash görsel ve video desteği sunuyor mu?
Evet. Z.ai ve resmi model kartı metin, görsel ve video girdilerini; metin çıktısıyla birlikte desteklediğini belirtiyor. Yerel çalıştırma belgelerinde ise KTransformers kurulumu için en fazla sekiz görsel veya bir video gibi istek sınırları ekleniyor.
GLM-5.3-Flash’ın maliyet avantajından ve çok modlu yapısından çok yüzlerce gigabaytlık bir çıkarım sunucusu kurmadan yararlanmak istiyorsanız barındırılan API’yi kullanın. Yerel çalıştırmayı ise ancak bu altyapı zaten elinizdeyse pilot olarak deneyin. Uzun süren ajan görevlerinde test edilmiş bir yedek model bulundurun; çünkü mevcut kanıtlar yetenek ve fiyat konusunda, kesintisiz etkileşim güvenilirliğine kıyasla daha güçlü.