 AIREITER
GLM-5.3-Flash için $0.15'lik giriş fiyatı, toplam maliyetin yalnızca başlangıç noktası. Önbellek isabetleri, çıktı token'ları, zorunlu reasoning süreci ve yaklaşık 320B parametreli checkpoint; API'nin mi yoksa açık ağırlıkları kendi altyapınızda çalıştırmanın mı gerçek kullanım senaryonuza uygun olduğunu belirliyor.
Şu anda geçerli olan GLM-5.3-Flash fiyatları
Z.AI'nin resmi fiyatlandırma sayfasında GLM-5.3-Flash için 1 milyon yeni giriş token'ı başına $0.15, önbellekten gelen giriş token'ı başına $0.03 ve çıktı token'ı başına $0.50 ücret yer alıyor. Sayfada ayrıca UTC+8 (Singapur saati) ile 9 Eylül 2026 saat 24:00'te sona erecek geçici %50 promosyon da bulunuyor.
| GLM-5.3-Flash kalemi | Liste fiyatı / 1M token | Promosyon / 1M token |
|---|---|---|
| Yeni giriş | $0.15 | $0.075 |
| Önbelleğe alınmış giriş | $0.03 | $0.015 |
| Çıktı | $0.50 | $0.25 |
| Önbelleğe alınmış giriş depolaması | Sınırlı süreyle ücretsiz | Sınırlı süreyle ücretsiz |
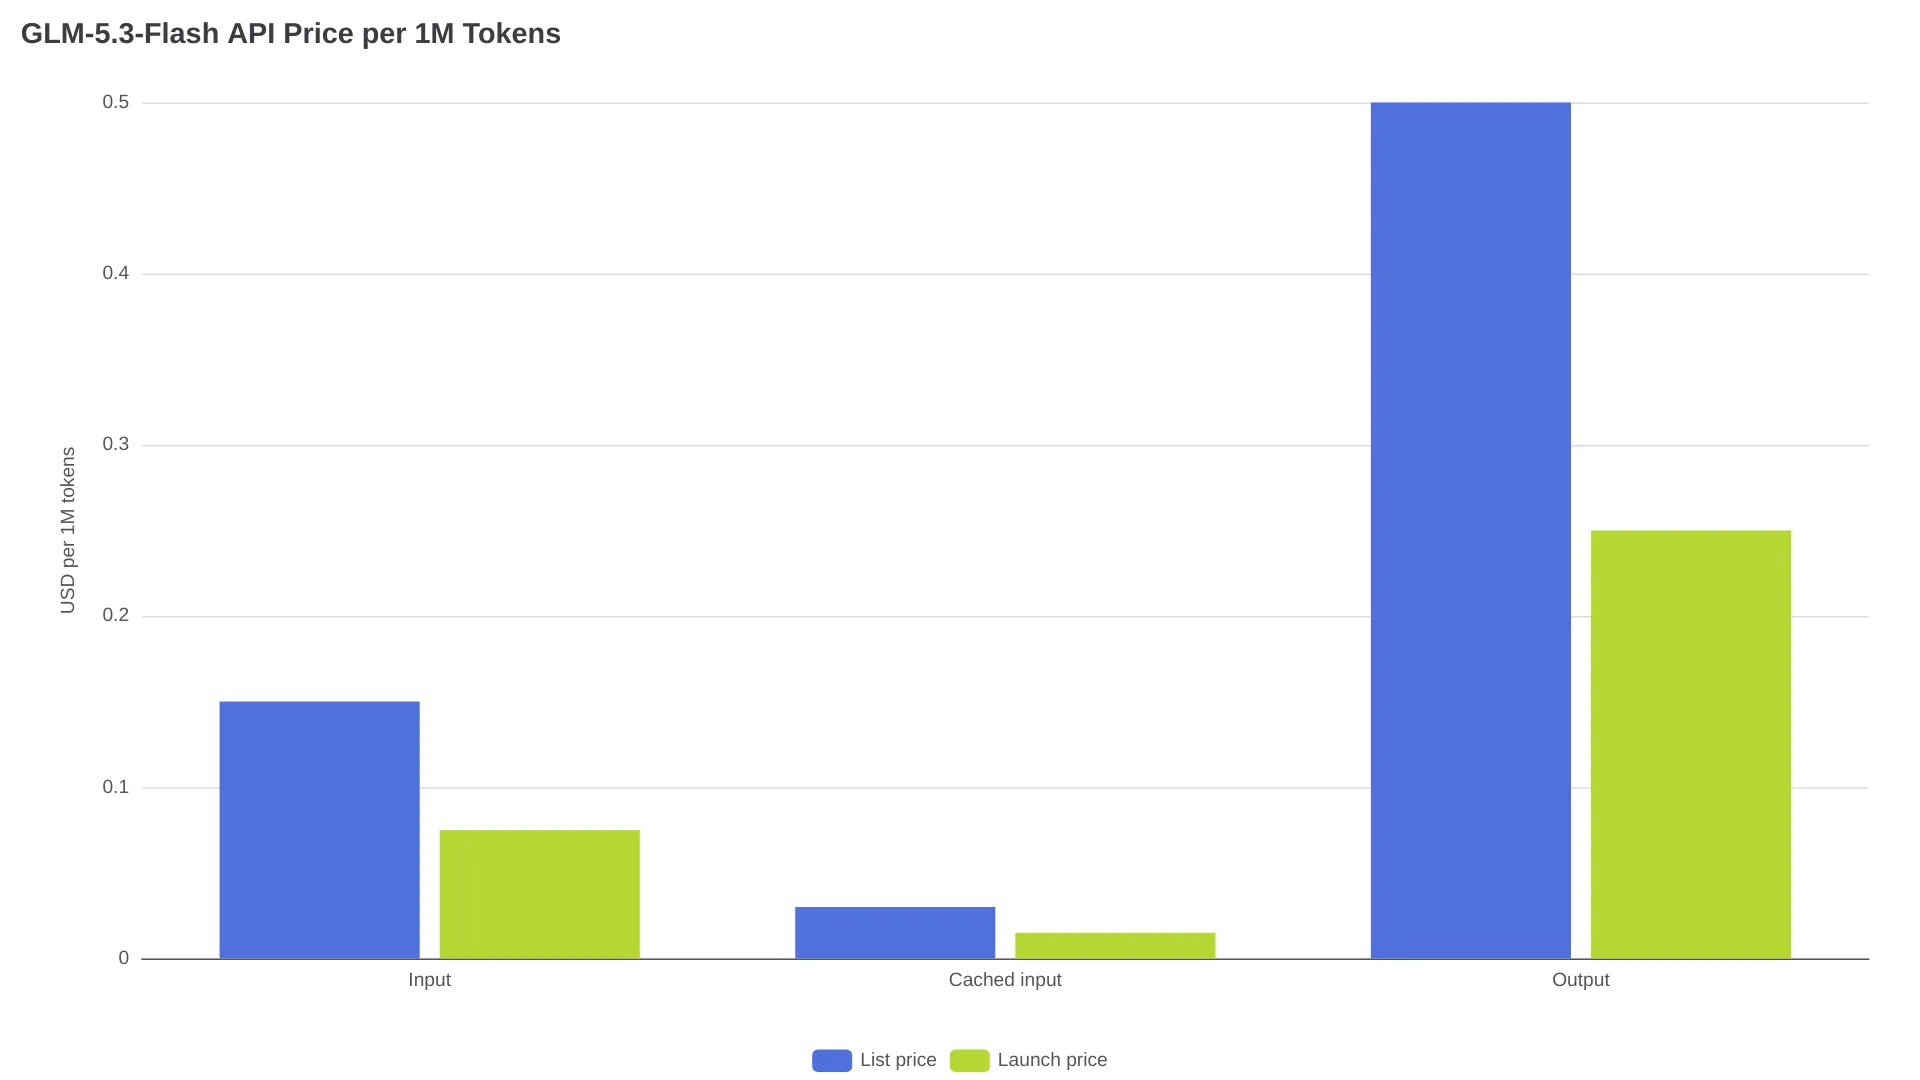
%50 indirimi üretim bütçesinin kalıcı tabanı olarak değil, geçici bir kampanya olarak değerlendirin. Z.AI'nin duyurusunda ox-alpha, önceki önizleme kimliği olarak belirtiliyor.
Aynı resmi tabloda standart GLM-5.3 için 1 milyon token başına $1.40 giriş, $0.26 önbelleğe alınmış giriş ve $4.40 çıktı fiyatı yazıyor. Liste fiyatları üzerinden bakıldığında Flash, hem girişte hem çıktıda yaklaşık %89 daha ucuz. Ancak bu, iki modelin kalite, gecikme ya da operasyonel davranış açısından aynı olduğu anlamına gelmiyor.
Satın aldığınız şey küçük bir yerel model değil, API erişimi
GLM-5.3-Flash; toplam 320B parametreye ve token başına 18B aktif parametreye sahip, MIT lisanslı, açık ağırlıklı çok modlu bir model. Resmi Hugging Face model kartı, herkese açık zai-org/GLM-5.3-Flash checkpoint'ini ve yerel sunum yollarını belgeliyor. Z.AI ise yayın materyallerinde 1 milyon token'lık bağlam penceresi ile metin, görsel ve video girdisi desteğinden söz ediyor.
“18B aktif” ifadesi, toplam bellek ihtiyacını değil seçilen uzmanların yaptığı hesaplamayı anlatır. Tam ağırlıkların kapladığı alan, KV cache, çalışma zamanı ek yükü, çok modlu işleme ve bağlam uzunluğu; yerel çalıştırmanın uygulanabilirliğini hâlâ belirler.
| Erişim yolu | Sunduğu şey | Başlıca kısıt |
|---|---|---|
| Z.AI API | Giriş, önbelleğe alınmış giriş ve çıktı token'larına göre ücretlendirilen barındırılmış çıkarım | Hesap limitleri ve reasoning kaynaklı gecikme |
| Resmi checkpoint | Kendi sunucunuzu kurmak veya uyarlama yapmak için MIT lisanslı ağırlıklar | Kesinlik ve quantization'a bağlı yüksek bellekli altyapı gereksinimi |
| Topluluk yapımı quantized sürüm | Bazı yerel çalışma ortamları için daha küçük dosyalar | Derleme kalitesi, modalite desteği, hız ve uyumluluk değişkenlik gösterir |
Düşük token fiyatı ile düşük barındırma maliyeti aynı iddia değildir. Değişken trafikte API maliyeti istek geldikçe oluşurken, kendi sunucunuzu işletmek boşta kalınan dönemlerde bile kapasite ayırmayı gerektirir.
Gerçek iş yüklerinde API faturası nasıl oluşur?
GLM-5.3-Flash maliyeti; yeni giriş, sistemin önbellekten tanıdığı giriş ve üretilen çıktı arasındaki dağılıma bağlıdır:
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
Liste fiyatıyla 10 milyon yeni giriş token'ı ve 2 milyon çıktı token'ı $2.50 tutar: giriş için $1.50, çıktı için $1.00. Promosyon döneminde aynı hacmin maliyeti $1.25 olur.
| İş yükü | Liste fiyatı hesabı | Liste fiyatı toplamı | Promosyonlu toplam |
|---|---|---|---|
| 10M yeni giriş + 2M çıktı | $1.50 + $1.00 | $2.50 | $1.25 |
| 2M yeni giriş + 8M önbellek girişi + 2M çıktı | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 100K yeni giriş + 10K çıktı | $0.015 + $0.005 | $0.020 | $0.010 |
Artificial Analysis tarafından gösterilen milyon token başına $0.10'luk karma rakam, tanımlı 7:2:1 önbellek isabeti, giriş ve çıktı dağılımına dayanıyor. Karşılaştırılabilir bir iş yükü için yararlıdır; GLM-5.3-Flash için evrensel bir tarife değildir.
Önbellek tasarrufu için gerçekten cache hit alınması gerekir. Z.AI'nin Chat Completion yanıt şeması, usage.prompt_tokens_details.cached_tokens alanını sunuyor. Bu yüzden üretim muhasebesi, tekrar ediyor gibi görünen prompt'ların otomatik olarak indirimli sayılacağını varsaymak yerine bu alanı kaydetmeli. r/opencodeCLI topluluğundaki bir kullanıcı, lansman dönemindeki ekonomik tabloyu şöyle yorumladı:
“There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f...” — u/CriteriumA, Reddit discussion
İndirim bitiş tarihi Z.AI'nin fiyat listesiyle doğrulanıyor; karşılaştırma ve kullanıcı deneyimi ise bu yorumcuya ait. Sabit ve tekrar eden bağlam, önbellek yeniden kullanımını artırabilir; fakat çıktı, yeniden denemeler, araç kullanımı veya hesap limitlerinden doğan maliyetleri ortadan kaldırmaz.
Kısa bir bütçe çalışma tablosu
Tahminde dört ayrı satır kullanın: yeni giriş, önbelleğe alınmış giriş, çıktı ve ücretli araçlar. Z.AI, Web Search kullanımını $0.01 olarak listeliyor; dolayısıyla sık çalışan ajan aramaları yalnızca token'lara dayalı tahmini aşabilir.
| Aylık kullanım varsayımı | Liste fiyatı formülü | Aylık maliyet |
|---|---|---|
| 100M yeni giriş + 20M çıktı | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 20M yeni giriş + 80M önbellek girişi + 20M çıktı | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 Web Search çağrısı | 100 × $0.01 | $1.00 |
Bunlar kota değil, aritmetik örneklerdir. Yeniden denemeleri ve yarıda bırakılan ajan çalıştırmalarını ayrıca ekleyin. Çıktı hacmi yüksekse, gerçekçi bir max_tokens değeri belirlemek ve uygun durumlarda daha düşük reasoning_effort kullanmak, küçük bir prompt önekini optimize etmekten daha fazla etki yaratabilir.
Geçişten önce bilinmesi gereken Z.AI API kısıtları
Resmi Z.AI API'nin genel base URL'si https://api.z.ai/api/paas/v4/; sohbet tamamlama endpoint'i ise https://api.z.ai/api/paas/v4/chat/completions. Kimlik doğrulama Bearer API anahtarıyla yapılıyor. Z.AI, API giriş dokümanında özel bir base URL kullanarak OpenAI uyumlu Python, Node.js ve Java istemci kalıplarını açıklıyor.
Güncel Chat Completion referansı, thinking ve reasoning açıklamalarında GLM-5.3-FLASH'ten söz ediyor; ancak oluşturulan model enum'unda glm-5.3-flash görünmüyor. Buna karşılık resmi fiyatlandırma sayfası ve lansman materyalleri Flash SKU'sunu listeliyor. Üretim trafiğini taşımadan önce, tam barındırılan model kimliğini küçük bir istekle test edin.
| Entegrasyon ayrıntısı | Doğrulanmış kısıt |
|---|---|
| Test edilecek barındırılmış model kimliği | glm-5.3-flash; canlı hesap şemasıyla kabul edildiğini doğrulayın |
| Barındırılmış endpoint | https://api.z.ai/api/paas/v4/chat/completions |
| Kimlik doğrulama | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH'te thinking etkin kullanılır; derinlik reasoning_effort ile kontrol edilir |
| Reasoning seviyesi | low, high veya max |
Azami max_tokens | Güncel parametre referansında 131,072 |
| Coding Plan | Ayrı anahtar, endpoint ve kredi sistemi kullanır; genel API bakiyesi değildir. Bkz. Z.AI Coding Plan hızlı başlangıç |
Z.AI, varsayılan reasoning seviyesi olarak max kullanıyor. Token tarifesi seviyeye göre değişmese de reasoning, çıktı kullanımını ve bekleme süresini değiştirebilir. Hesap limitleri için Z.AI, kullanıcıları hesaba özel rate-limit paneline yönlendiriyor; herkese açık rehberde tüm API hesapları için tek bir evrensel sayısal üst sınır belirtilmiyor.
Açık ağırlıkları çalıştırmak mı, barındırılmış API mi?
Resmi model kartında Transformers, vLLM, SGLang, TokenSpeed ve KTransformers için yerel sunum tarifleri yer alıyor. Ancak bu tarifler, tüketici sınıfı GPU'larda pratik bir dağıtım yapılabileceğini göstermiyor.
Trafik düzensizse veya yüksek bellekli çıkarım donanımınız yoksa barındırılmış API'yi tercih edin. Kullanım sürekli yüksekse ya da veri işleme üzerindeki kontrol operasyonel maliyeti haklı çıkarıyorsa dağıtık veya yerel sunumu değerlendirin. Düşük hassasiyetli, yalnızca metin odaklı bir sürüm; resmi çok modlu kurulumu birebir sunmayabilir.
Kendi sunucunuzu kurmak ne zaman anlamlı olur?
GetDeploying tahmini, 4-bit bir kurulum için yaklaşık 192 GB GPU belleği, 8-bit için yaklaşık 384 GB ve BF16 için 768 GB öngörüyor. Sürekli çalıştırılan $2.90/saatlik MI300X yapılandırmasının aylık maliyetini yaklaşık $2,088 olarak hesaplıyor; 5:1 giriş-çıktı oranında API ile kendi sunucunu çalıştırma arasındaki denge noktası da saatte yaklaşık 14 milyon token.
Bunlar Z.AI'nin donanım garantileri değil, üçüncü taraf tahminleridir. 192 GB'lık 4-bit yapılandırma sıkışık olarak işaretleniyor; KV cache, çalışma zamanı ek yükü, çok modlu işleme, batching ve boşta kalma süresi denge noktasını değiştirebilir. Yerel çıkarımı seçmeden önce saatlik altyapı maliyetini, kullanım oranını, saat başına efektif token sayısını, cache hit oranını ve tamamlanan görev başına maliyeti karşılaştırın.
GLM-5.3-Flash ve GLM-5.3 arasında seçim nasıl yapılır?
Flash ile standart GLM-5.3, farklı fiyatlandırma tablolarına ve farklı dağıtım konumlarına sahip.
| Soru | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Liste giriş fiyatı | $0.15 / 1M | $1.40 / 1M |
| Liste önbellek girişi | $0.03 / 1M | $0.26 / 1M |
| Liste çıktı fiyatı | $0.50 / 1M | $4.40 / 1M |
| Geçici promosyon | 9 Eylül 2026 UTC+8'e kadar %50 indirim | Flash'e eşdeğer bir promosyon gösterilmiyor |
| Açık ağırlıklı checkpoint | Resmi MIT checkpoint'i listeleniyor | Ayrı model listesi; ağırlıkların aynı olduğunu varsaymayın |
| Çok modlu konumlandırma | Doğal olarak çok modlu; Z.AI görsel/video girdisini açıklıyor | Standart GLM-5.3 kapsamını ayrı değerlendirin |
| Yerel dağıtım | Büyük checkpoint ve yüksek bellekli sunum gerekir | Kendi model ve dağıtım dokümantasyonunu kullanın |
Token maliyeti, çok modlu girdi veya açık ağırlıklı bir seçenek önemliyse ve uygulamanız zorunlu reasoning ile sağlayıcı kısıtlarını tolere edebiliyorsa önce Flash'i seçin. Standart GLM-5.3'ü ise daha yüksek fiyatın, uygulama için önem taşıyan bir yetenek veya güvenilirlik farkı getirip getirmediğini ölçtükten sonra değerlendirin.
SSS
GLM-5.3-Flash API'nin güncel fiyatı nedir?
Resmi liste fiyatları 1M token başına giriş için $0.15, önbelleğe alınmış giriş için $0.03 ve çıktı için $0.50. Yukarıdaki tabloda geçici %50 indirimli fiyatlar da yer alıyor.
Önbelleğe alınmış girişte $0.03 tarifesi mi uygulanır?
Evet, Z.AI token'ları önbelleğe alınmış olarak tanıdığında bu tarife uygulanır. Önbelleğe alınmış giriş depolaması ayrıca sınırlı süreyle ücretsiz listeleniyor; bu nedenle depolama durumu ile cache hit ücretlendirmesini birbiriyle karıştırmamak gerekir.
GLM-5.3-Flash açık kaynak mı?
Daha doğru tanım, MIT lisanslı açık ağırlıklı bir checkpoint olduğudur. Lisans geniş kullanım imkânı verse de toplam 320B parametreli model; önemli miktarda bellek, uyumlu yazılım ve sunum kapasitesi gerektirir.
GLM-5.3-Flash'i normal bir dizüstü bilgisayarda çalıştırabilir miyim?
Pratik bir tam hassasiyetli kurulum olarak hayır. Üçüncü taraf 4-bit tahminleri bile yaklaşık 192 GB GPU belleğine işaret ediyor; 18B aktif parametre de tam checkpoint'in depolama ve çalışma zamanı maliyetini ortadan kaldırmıyor.
GLM-5.3-Flash, GLM-5.3'ten daha mı hızlı?
“Flash” adı, evrensel bir gecikme garantisinden ziyade maliyet ve aktif hesaplama konumlandırmasıyla destekleniyor. Artificial Analysis, ölçüm ortamında Z.AI üzerinden saniyede 48.7 çıktı token'ı ve ilk yanıt token'ına kadar 42.57 saniye raporluyor; reasoning süresi ve iş yükünün şekli, algılanan yanıt süresinde belirleyici olabilir.
Coding Plan aynı API bakiyesini sunuyor mu?
Hayır. Z.AI'nin Coding Plan hızlı başlangıç dokümanı, ayrı bir Coding Plan anahtarı, ayrı endpoint'ler ve resmi olarak desteklenen araçlar ile ürünlerle sınırlı erişim tanımlıyor. Coding Plan aboneliğini doğrudan token başına dolar cinsinden genel API bütçesine çevirmemek gerekir.
Trafik düzensizse ve donanım maliyeti zaten karşılanmıyorsa API daha düşük riskli yoldur. Yerel sunum ise sürekli kullanım, bellek gereksinimleri ve veri kontrolü ihtiyacına bağlı, farklı bir ekonomik karardır.