 AIREITER
Google, 3.6 Flash'ten yalnızca üç hafta sonra Gemini 3.7 Flash'ı yayınladı. Yeni modelin en dikkat çekici farkı, gerçek depo görevlerinde uzun soluklu yazılım mühendisliğini ölçen DeepSWE v1.1 sonucunda görülüyor: skor %48,6'dan %65,3'e çıktı. Üstelik iki model de Aralık 2026'ya kadar milyon token başına 0,75 $ giriş ve 3,75 $ çıkışlık aynı tanıtım fiyatını kullanıyor. Yani token maliyeti artmadan yükseltme yapılabiliyor; ancak bunun getirisi iş yüküne göre değişiyor.
Gemini 3.7 Flash ve 3.6 Flash: 18 testte sonuçlar
Google DeepMind'ın resmî model sayfasındaki veriler, Gemini 3.7 Flash'ın neredeyse her alanda ilerlediğini gösteriyor. En büyük sıçramalar ise kodlama ajanları ve kurumsal otomasyon testlerinde. Aşağıdaki tabloda, Google'ın iki model için yayımladığı 18 metriğin tamamı yer alıyor. Claude Sonnet 5 ve GPT-5.6 Terra sonuçları da karşılaştırma bağlamı için eklenmiş durumda.
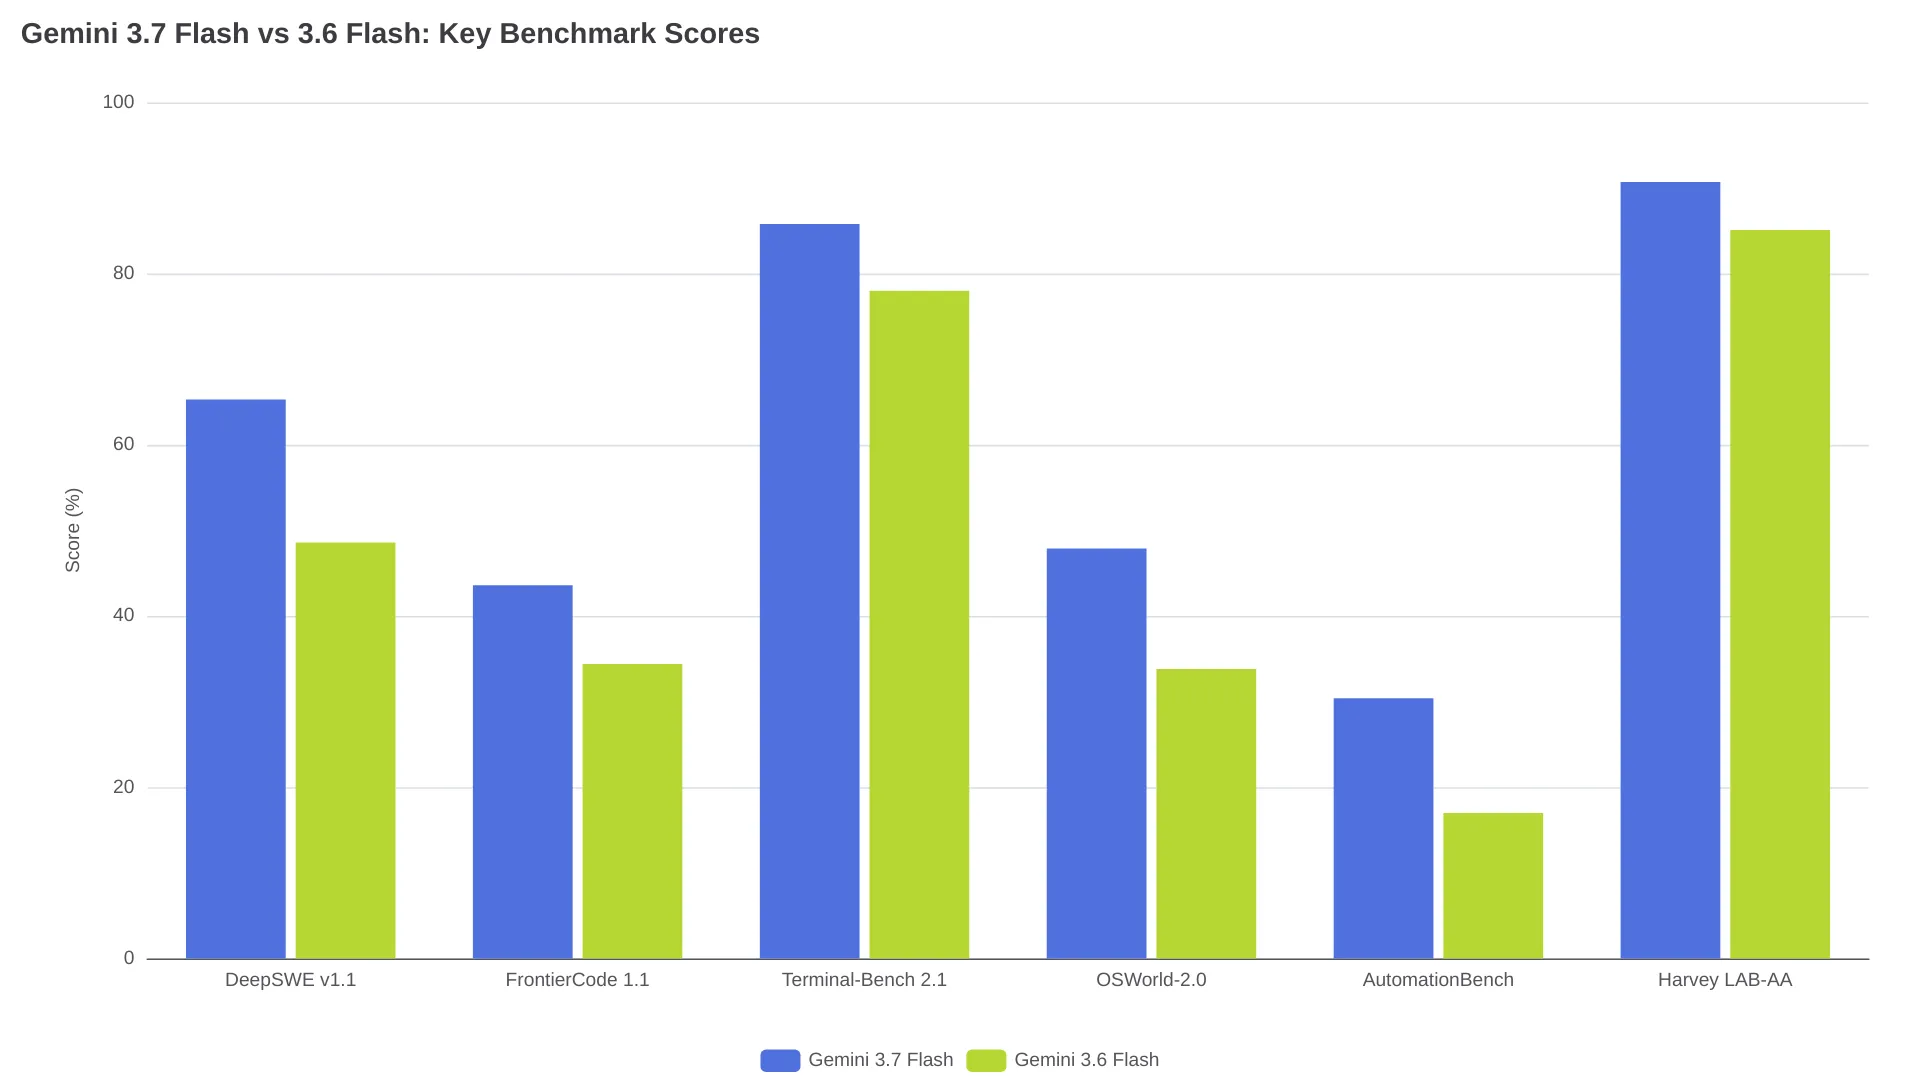
| Test | Gemini 3.7 Flash | Gemini 3.6 Flash | Fark |
|---|---|---|---|
| Artificial Analysis Intelligence Index (bileşik) | 56 | 52 | +4 |
| FrontierCode 1.1 (üretim kodu kalitesi) | 43.6% | 34.4% | +9.2 |
| DeepSWE v1.1 (uzun soluklu yazılım mühendisliği) | 65.3% | 48.6% | +16.7 |
| Code Arena (web geliştirme Elo) | 1588 | 1538 | +50 |
| Terminal-Bench 2.1 (ajan tabanlı terminal kodlama) | 85.8% | 78.0% | +7.8 |
| Terminal-Bench 3.0 (genel ajan yetenekleri) | 14.9% | 5.4% | +9.5 |
| AutomationBench (kurumsal iş akışı otomasyonu) | 30.4% | 17.0% | +13.4 |
| GDPVal-AA v2 (bilgi işi Elo) | 1525 | 1422 | +103 |
| Harvey LAB-AA (karmaşık hukuk iş akışları) | 90.7% | 85.1% | +5.6 |
| GDP.pdf (uzman düzeyinde PDF anlama) | 34.0% | 22.0% | +12.0 |
| CharXiv, araçsız (grafik akıl yürütme) | 84.5% | 85.2% | −0.7 |
| CharXiv, araçlarla | 88.7% | 89.4% | −0.7 |
| LVBench (uzun video anlama) | 85.4% | 84.2% | +1.2 |
| GDM-MRCR v2, 128k (uzun bağlamdan bilgi getirme) | 97.0% | 91.8% | +5.2 |
| OSWorld-2.0 (ajan tabanlı bilgisayar kullanımı) | 47.9% | 33.8% | +14.1 |
| Agent's Last Exam (masaüstü ajan görevleri) | 26.3% | 24.2% | +2.1 |
| HLE-Verified (çok disiplinli uzman akıl yürütme) | 53.6% | 51.2% | +2.4 |
| LABBench2 (biyoloji araştırma görevleri) | 82.1% | 76.1% | +6.0 |
Tüm rakamlar, Google DeepMind tarafından 3.7 Flash model sayfasında yayımlanan üretici verileridir. Bu testlerin çoğu için henüz bağımsız tekrar çalışmaları yayımlanmadı. Bu nedenle farkları, kendi iş yükünüz için garanti edilmiş sonuçlar değil, yön gösterici veriler olarak değerlendirmek daha doğru olur.
Kodlama ve ajan görevlerinde 3.7 Flash farkı açıyor
İki model arasındaki en belirgin fark kodlama ve ajan odaklı testlerde ortaya çıkıyor. Gerçek depo görevlerinde uzun vadeli yazılım mühendisliğini ölçen DeepSWE v1.1, %48,6'dan %65,3'e çıkarak 16,7 yüzde puan yükseldi. Aynı metrikte Claude Sonnet 5'in %53,8'lik sonucunu geride bırakıyor ve GPT-5.6 Terra'nın %69,6'lık skorunun altında kalıyor. Karşılaştırma sonuçlarının tamamı DeepMind test tablosundan alınmıştır.
Diğer ajan odaklı testlerde de benzer sıçramalar var:
- Terminal-Bench 3.0 (çok araçlı ajan yetenekleri): %5,4 → %14,9; neredeyse üç kat artış
- AutomationBench (kurumsal iş akışı otomasyonu): %17,0 → %30,4
- FrontierCode 1.1 (üretim kodu kalitesi): +9,2 puan
- OSWorld-2.0 (ajan tabanlı bilgisayar kullanımı): %33,8 → %47,9
Reddit'teki ilk kullanıcı yorumları, test başarıları ile günlük geliştirici deneyimi arasındaki farkı iyi özetliyor:
Uygulama geliştirme tarafında etkili, ancak planlama, kod inceleme ve zor problemlerin ayrıştırılmasında daha zayıf kalabilir.
— r/google_antigravity üzerindeki kullanıcı tartışmasından
Google'ın DeepMind model sayfasında yayımladığı müşteri verileri de bu tabloyu destekliyor. Browser Use, "Gemini 3.7 Flash ajanının 3.6 Flash'a kıyasla %35 daha ucuz olduğunu; gözlemlenen prompt-cache isabet oranının %8 arttığını ve araç hatalarının azaldığını" bildirdi. Harvey, Legal Agent Bench'te tüm testleri geçme oranında 2,6 puanlık artış ölçtü. Nunu.ai ise GPT-5.6-Terra ile benzer performansa "yaklaşık yarı maliyetle" ulaştığını belirtti. Üç örnekte de tasarrufun nedeni token başına indirim değil, daha az ajan döngüsü adımı kullanılması.
Bilgi işleri ve çok modlu kullanımda artış daha sınırlı
Kodlama dışındaki alanlarda kazanımlar daha dar, ancak yine de anlamlı. Artificial Analysis Intelligence Index 52'den 56'ya yükseldi. DeepMind karşılaştırma tablosuna göre bu sonuç, Gemini 3.7 Flash'ı Claude Sonnet 5'in 55 puanlık ve GPT-5.6 Terra'nın 57 puanlık skorları arasına yerleştiriyor. Kodlama dışındaki en güçlü gelişme belge anlamada görülüyor: GDP.pdf, karmaşık belgeler, finansal raporlar veya hukuki dosyaları işleyen sistemler için %22,0'den %34,0'e, yani 12 puan yükseldi. 128K token'da uzun bağlamdan bilgi getirmeyi ölçen GDM-MRCR v2 de %91,8'den %97,0'ye çıktı.
Karmaşık hukuk iş akışlarını değerlendiren Harvey LAB-AA %85,1'den %90,7'ye ulaştı. Uzun video anlama testi LVBench ile biyoloji araştırma görevlerini ölçen LABBench2'nin her ikisinde de yaklaşık 6 puanlık iyileşme var. Bunlar uzmanlaşmış iş yükleri için önemli olabilir, fakat tek başına yükseltme kararını belirlemesi pek olası değil.
Fiyatlandırma: İki modelde de aynı tanıtım tarifesi
| Model | Giriş ($/1M token) | Çıkış ($/1M token) | Standart fiyat (1 Ocak 2027'den itibaren) |
|---|---|---|---|
| Gemini 3.7 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Gemini 3.6 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Claude Sonnet 5 | $2.00 | $10.00 | — |
| GPT-5.6 Terra | $2.00 | $12.00 | — |
\*Tanıtım fiyatı 31 Aralık 2026'da sona eriyor. Tüm fiyatlar DeepMind model sayfasından alınmıştır.
Google, 3.7 Flash'ı 13 Ağustos 2026'da yayınladığında iki Flash modeline de 0,75 $/3,75 $ promosyon tarifesini uyguladı. Öncesinde 3.6 Flash'ın standart ücreti 1,50 $/7,50 $ idi. Google kampanyayı uzatmadığı sürece iki model de 1 Ocak 2027'den itibaren 1,50 $/7,50 $ tarifesine dönecek. Token başına ücret aynı olduğundan maliyet farkını görevi tamamlama verimliliği yaratıyor: Browser Use'un bildirdiği %35'lik ajan maliyeti düşüşü, aynı iş yüklerinde ölçüldü ve farklı bir fiyatlandırmadan değil, daha az araç çağrısı ile daha yüksek önbellek isabet oranından kaynaklandı.
Önbellekleme, Batch API ve grounding ücretleri dahil 3.7 Flash API maliyetlerinin ayrıntılı dökümü için Gemini 3.7 Flash API fiyatlandırma rehberimize bakabilirsiniz.
3.6 Flash'ın önde kaldığı alan
3.6 Flash, grafik akıl yürütmede küçük bir üstünlüğe sahip. Araç kullanılmayan CharXiv testinde 3.6 Flash %85,2, 3.7 Flash ise %84,5 alıyor. Araçlar etkinleştirildiğinde fark değişmiyor: %89,4'e karşı %88,7. 1 puanın altındaki bu marjlar, tekil grafik görevlerinde iki modelin de benzer performans gösterebileceği kadar dar. Varsayılan modeli seçmeden önce kendi grafik iş yükünüzde doğrulama yapın.
Google'ın karşılaştırma tablosunda 3.6'nın 3.7'nin önüne geçtiği başka bir test yok. Grafik akıl yürütme dışındaki en yakın alan, 52'ye karşı 56'lık intelligence index farkı; ancak burada da lider 3.7 Flash.
Geçişte model adından başka neler değişiyor?
Teknik açıdan geçiş yalnızca model kimliğini değiştirmekten ibaret: gemini-3.6-flash yerine gemini-3.7-flash kullanılıyor. DeepMind model sayfasına göre iki model aynı bağlam penceresini paylaşır: 1M giriş ve 64K çıkış. Girdi türleri de aynı: metin, görsel, video, ses ve PDF. Function calling, search grounding ve computer use dahil araç kullanımı yetenekleri de eşdeğer. Model sayfasında 3.7 Flash'ın durumu genel kullanıma açık olarak listeleniyor.
Yine de bir uyarı var: 3.5'ten 3.6'ya geçişte geliştiricileri hazırlıksız yakalayan, sessiz API davranışı değişiklikleri yaşandı. Bağımsız testlerin belgelediğine göre temperature, top_p ve top_k sessizce yok sayıldı; thinking_budget, string-enum türünde bir thinking_level alanına dönüştü; response prefilling kaldırıldı. Google, 3.7 Flash'ta benzer değişiklikler olup olmadığını henüz açıklamadı. Bu dokümantasyon yayımlanana kadar üretim trafiğini taşımadan önce değerlendirme paketinizi her iki model kimliğiyle de çalıştırın. 3.6'yı yedek seçenek olarak hazır tutun.
Gemini 3.7 Flash'a geçmeli misiniz?
Karar, kullandığınız iş yüküne göre değişiyor:
- Kodlama ajanları kullanıyorsanız hemen geçin. DeepSWE v1.1'de 16,7 puanlık artış var; Terminal-Bench 3.0 skoru ise neredeyse üç katına çıktı. Token başına fiyat aynı olduğundan, kodlama ajanı iş yüklerinde 3.6'da kalmak için finansal bir neden bulunmuyor.
- Karmaşık belgeler işliyorsanız hemen geçin. GDP.pdf belge anlama skoru 12 puan arttı: %22,0 → %34,0. 128K token'da uzun bağlamdan bilgi getirme sonucu ise %97,0 ile neredeyse kusursuz.
- Ana işiniz grafik akıl yürütmeyse önce test edin. CharXiv sonuçları 3.6'yı 1 puandan az bir farkla öne çıkarıyor. Karar vermeden önce iki modeli yan yana değerlendirin.
- Doğrulanmış ve kararlı bir hattınız varsa 3.6'da kalın. DeepMind model sayfasında 3.6 Flash için bir kullanımdan kaldırma tarihi yer almıyor. İş akışınız regresyon testlerinden geçiyorsa ve kodlama kazanımlarına acil ihtiyacınız yoksa, davranış değişikliklerini ayıklamanın maliyeti faydayı aşabilir. Her seferinde tek bir iş akışını taşıyın.
- Sürüm temposunu da hesaba katın. Google, 3.7'yi 3.6'dan üç hafta sonra yayınladı. 3.7'nin avantajının en büyük olduğu iş akışlarını şimdi taşıyın, 3.6'yı yedek olarak sabitleyin ve her Flash sürümünü platform değişimi değil, değerlendirilmesi gereken kademeli bir güncelleme olarak ele alın.
İki modeli yan yana denemek için Gemini 3.7 Flash ve Gemini 3.6 Flash sohbet arayüzlerini kullanabilirsiniz.
Gemini 3.7 Flash yeni bir mimari mi, yoksa eğitim sonrası bir güncelleme mi?
Google, 3.7 Flash'ı ne yeni bir mimari ne de eğitim sonrası bir yama olarak kamuya açık biçimde tanımladı. Artificial Analysis Intelligence Index 52'den 56'ya çıktı. Buna karşılık bağımsız testler, 3.5 ve 3.6 Flash'ın aynı endekste 50 puan aldığını doğruladı. 3.7'deki iyileşmenin mimari değişikliklerden mi yoksa daha iyi eğitim verisinden mi kaynaklandığı belgelenmiş değil.
Gemini 3.7 Flash, 3.6 Flash'tan daha mı pahalı?
Hayır. Her iki model de 31 Aralık 2026'ya kadar milyon giriş token'ı başına 0,75 $, milyon çıkış token'ı başına ise 3,75 $ ücretlendiriliyor. Sonrasında ikisi de 1,50 $/7,50 $ tarifesine geçecek. Yükseltmeden doğan tasarruf, token başına daha düşük fiyatlardan değil, görev başına daha az araç çağrısı ve akıl yürütme adımı gerekmesinden geliyor.
Gemini 3.7 Flash nerelerde kullanılabiliyor?
DeepMind model sayfasına göre 3.7 Flash; Gemini API, Google AI Studio, Google Antigravity, Vertex AI, Gemini Enterprise ve Gemini App üzerinden kullanılabiliyor. Modelin durumu genel kullanıma açık olarak belirtiliyor.
Şimdi geçmek yerine sonraki Flash sürümünü mü beklemeliyim?
3.7 Flash, yayımlanmış test sonuçları ve müşteri benimsemesi bulunan bir GA modeli. İş yükünüz kodlama ve ajan tarafındaki kazanımlardan fayda sağlıyorsa bu iş akışlarını şimdi taşıyın; sonraki sürüm yayınlandığında yeniden değerlendirin. Beklemek, bugün kullanabileceğiniz iyileştirmelerden doğan fırsat maliyetini beraberinde getirir.