 AIREITER
Burada varsayılan tercih modelin isminden çok iş yükünün yapısına bağlı. Sınırları belirli ve yoğun çıktı üreten işlerde Claude Opus 5 daha güvenli bir başlangıç noktasıyken, Claude Fable 5.1 uzun süre çalışan ajanlar ve tekrar kullanılan olağanüstü büyük bağlamlar için test edilmesi gereken uzman seçenek. Fable 5.1'in öne çıkan maliyet avantajı, daha düşük giriş ya da çıktı ücretlerinden değil, önbellek okuma ücretlerinden geliyor.
Fable 5.1 mi Opus 5 mi? Kararı iş yükü verir
Çoğu ekip için doğru yaklaşım Opus 5 ile başlamak, daha fazla muhakeme gerektiren işlerde çaba düzeyini yükseltmek ve yalnızca gerçekten zor olduğu kanıtlanan vakaları Fable 5.1'e yönlendirmektir. Anthropic'in Fable 5.1 dokümantasyonu da benzer bir yol öneriyor: Çoğu iş yükünde Opus 5 ile başlayın; yüksek çaba düzeyindeki Opus değerlendirmeleri gereksinimi karşılamadığında Fable 5.1'e geçin.
| Temel kısıtınız... | Başlangıç modeli | Neden? |
|---|---|---|
| Kısa veya kapsamı sınırlı istekler | Opus 5 | Giriş ve çıktı ücretleri Fable 5.1'in yarısıdır. |
| Yoğun çıktı üreten üretim trafiği | Opus 5 | Fable'ın düşük önbellek okuma ücreti, üretilen token'lara indirim sağlamaz. |
| Tanımlı spesifikasyonla çok dosyalı kodlama | Opus 5 | Düşük maliyet, tekrar denemeleri ve daha yüksek çaba düzeylerini daha kolay karşılamayı sağlar. |
| Uzun süre çalışan, araç kullanan ajanlar | Fable 5.1—değerlendirme sonrasında | Fable, Anthropic'in yayımladığı ajan ve araç kullanımı karşılaştırmalarında önde. |
| Tur boyunca tekrar kullanılan büyük bağlam | Fable 5.1—maliyet modellemesinden sonra | Önbellek okuma fiyatı Opus 5'in yarısıdır. |
| Fallback'e duyarlı bir üretim yönlendiricisi | Önce Opus 5 | Fable 5.1, düşünme blokları ve konuşma geçmişi davranışını değiştirir. |
Asıl karşılaştırma, doğru çaba ve maliyet düzeyindeki Opus 5 ile doğru bağlam yapısı ve güvenilirlik eşiğindeki Fable 5.1 arasındadır.
Fable 5.1 ile Opus 5 arasındaki somut farklar neler?
Claude Fable 5.1, Anthropic'in zorlayıcı muhakeme ve uzun ufuklu ajan çalışmaları için sunduğu üst seviye modeldir. Claude Opus 5 ise ciddi kodlama, ajanlar ve profesyonel işler için daha düşük maliyetli seçenek olarak konumlanır. Her iki modelin de 1 milyon token bağlam penceresi ve 128.000 token maksimum çıktısı var. Bu nedenle Fable'ın farkı, yayımlanmış daha büyük bir bağlam sınırı değil, uzun soluklu yürütme yeteneğidir.
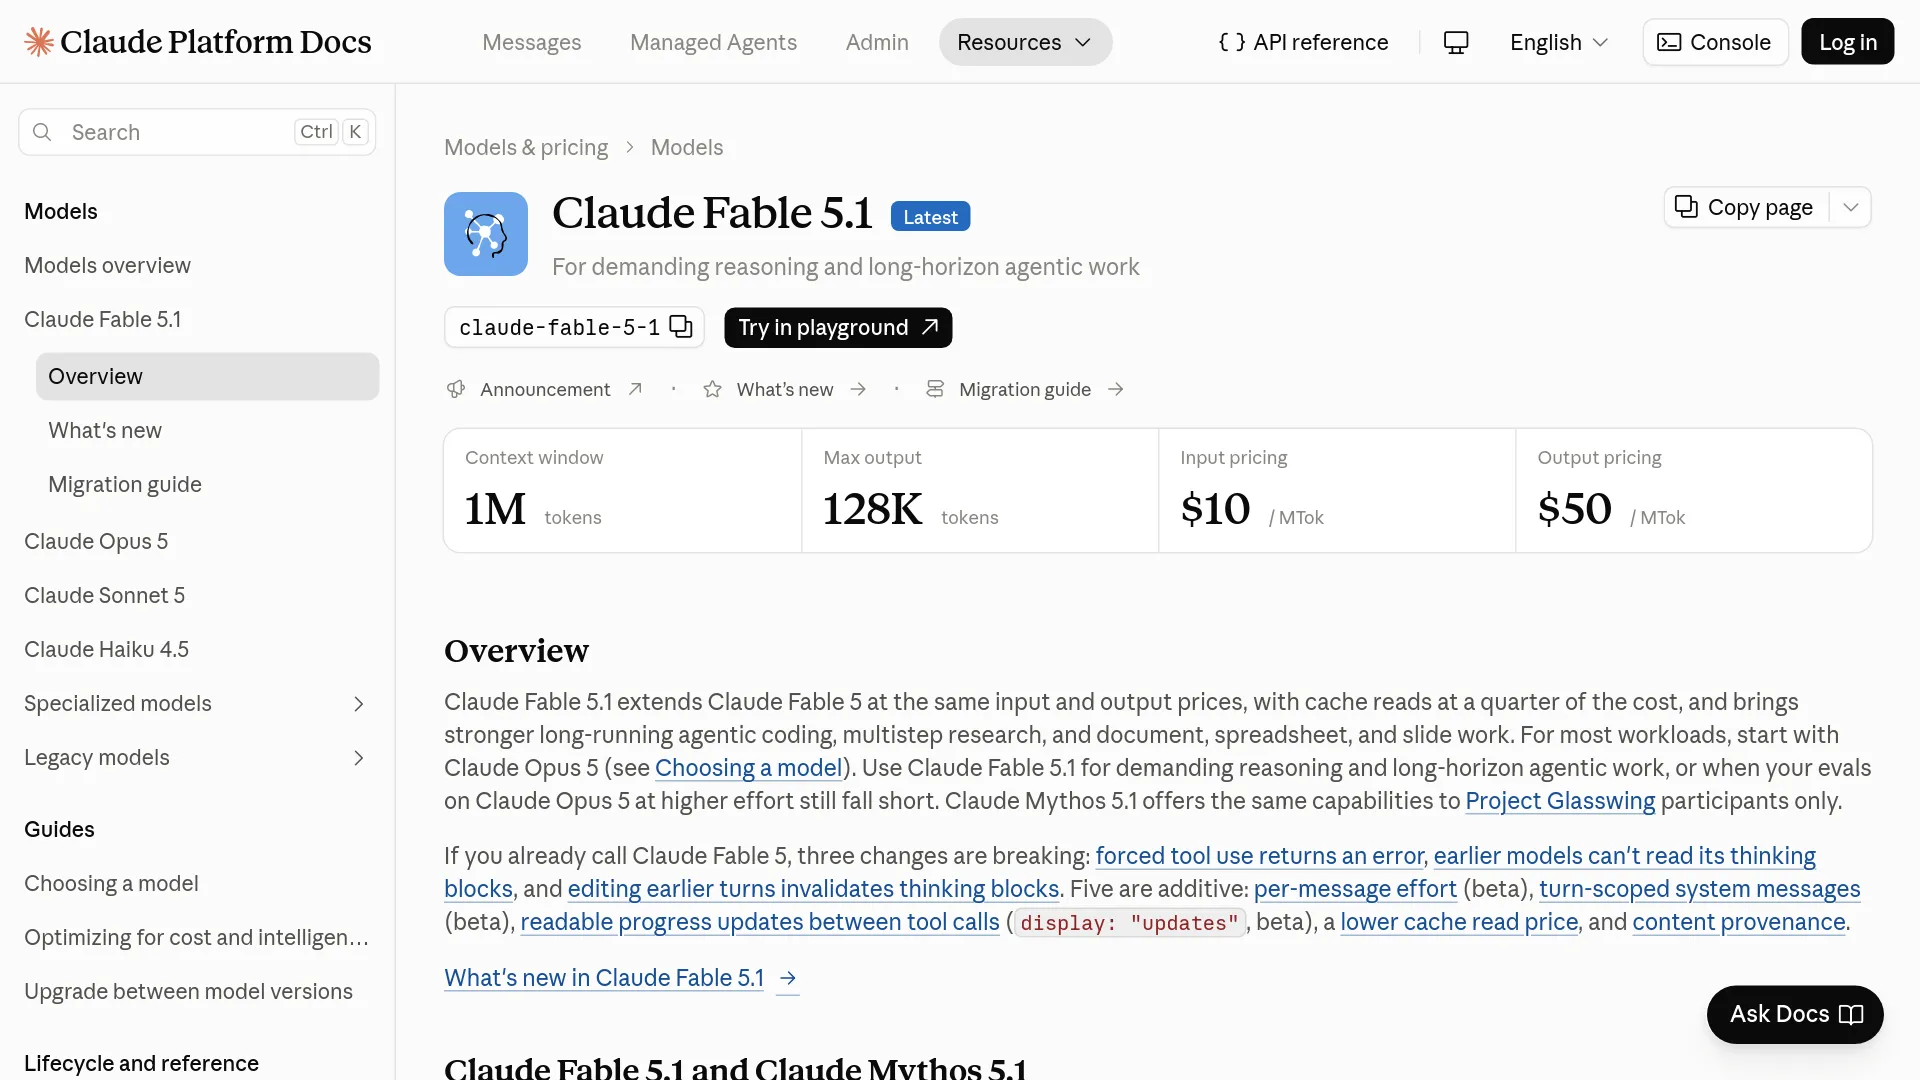
| Özellik | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| API model kimliği | claude-fable-5-1 | claude-opus-5 |
| Bağlam penceresi | 1 milyon token | 1 milyon token |
| Maksimum çıktı | 128.000 token | 128.000 token |
| Giriş modları | Metin ve görseller | Metin ve görseller |
| Çıktı modu | Metin | Metin |
| Düşünme | Uyarlanabilir, her zaman açık | Çaba kontrollü muhakeme |
| Çaba kontrolleri | low, medium, high, xhigh, max | Yapılandırılabilir çaba düzeyleri |
| Anthropic'in konumlandırması | Zorlayıcı muhakeme ve uzun ufuklu ajanlar | Çoğu iş yükü ve ciddi kodlama |
| Yayın durumu | Aktif/güncel; 1 Eylül 2026'da yayımlandı | Aktif Opus modeli; 24 Temmuz 2026'da yayımlandı |
Dağıtıma özel model kimlikleri ve erişilebilirlik için Fable 5.1 model sayfasına ve Claude Opus 5 ürün sayfasına bakın.
Benchmark'lerde Fable 5.1 önde, ancak sonuç evrensel değil
Anthropic'in yayımladığı benchmark tablosunda, iki modelin de raporlandığı her satırda Fable 5.1, Opus 5'in önünde yer alıyor. Ancak tablo üretici tarafından hazırlanmış; dolayısıyla sonuçlar lansman değerlendirmesi için yararlı bir kanıt, üretim ortamı garantisi değil.
| Anthropic değerlendirmesi | Fable 5.1 | Opus 5 | Fable 5.1 farkı |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | 23.6 puan |
| Terminal-Bench 4.0 | 55.8% | 52.3% | 3.5 puan |
| GDPval-AA v2 | 1,853 Elo | 1,824 Elo | 29 Elo |
| OSWorld 2.0, strict | 41.7% | 39.6% | 2.1 puan |
| Humanity’s Last Exam, araçlarla | 65.0% | 63.6% | 1.4 puan |
| AutomationBench | 31.4% | 26.9% | 4.5 puan |
| CursorBench 3.2.0 | 73.4% | 70.0% | 3.4 puan |
Anthropic, üretim güvenlik önlemlerinin etkin olduğunu; bazı müdahalelerin sıfır skorla sonuçlanabildiğini veya işi fallback modellere yönlendirebildiğini belirtiyor. Ayrıca Terminal-Bench-Science 0.1'de model başına standart hatanın yaklaşık 3.5–4.5 yüzde puanı olduğunu raporluyor. Bu yüzden 23.6 puanlık fark, Humanity’s Last Exam'deki 1.4 puanlık farktan daha anlamlıdır.
45 görev ve bilinen 105 sorun noktasını içeren üçüncü taraf bir CodeRabbit değerlendirmesinde, Fable 5.1 %61.0 recall ve %37.3 precision elde ederken Opus 5 %55.2 recall ve %39.3 precision aldı. Her iki model de 166 işlenmiş yorum üretti; ancak yazarlar kurulumların farklı olduğu uyarısını yapıyor.
“Fable 5.1 uzmanlaşmış bir incelemeci.” — CodeRabbit'in değerlendirme sonucuna ilişkin tanımı (CodeRabbit)
Pratik karşılaştırmayı API fiyatları değiştiriyor
Önbelleğe alınmamış giriş ve çıktı için Fable 5.1, Opus 5'in iki katına mal oluyor; buna karşılık önbellek okumaları yarı fiyatına. Bu durum uzun ve tekrarlı ajan oturumlarında bir kesişim noktası yaratır, fakat her Fable 5.1 isteğini daha ucuz hâle getirmez.
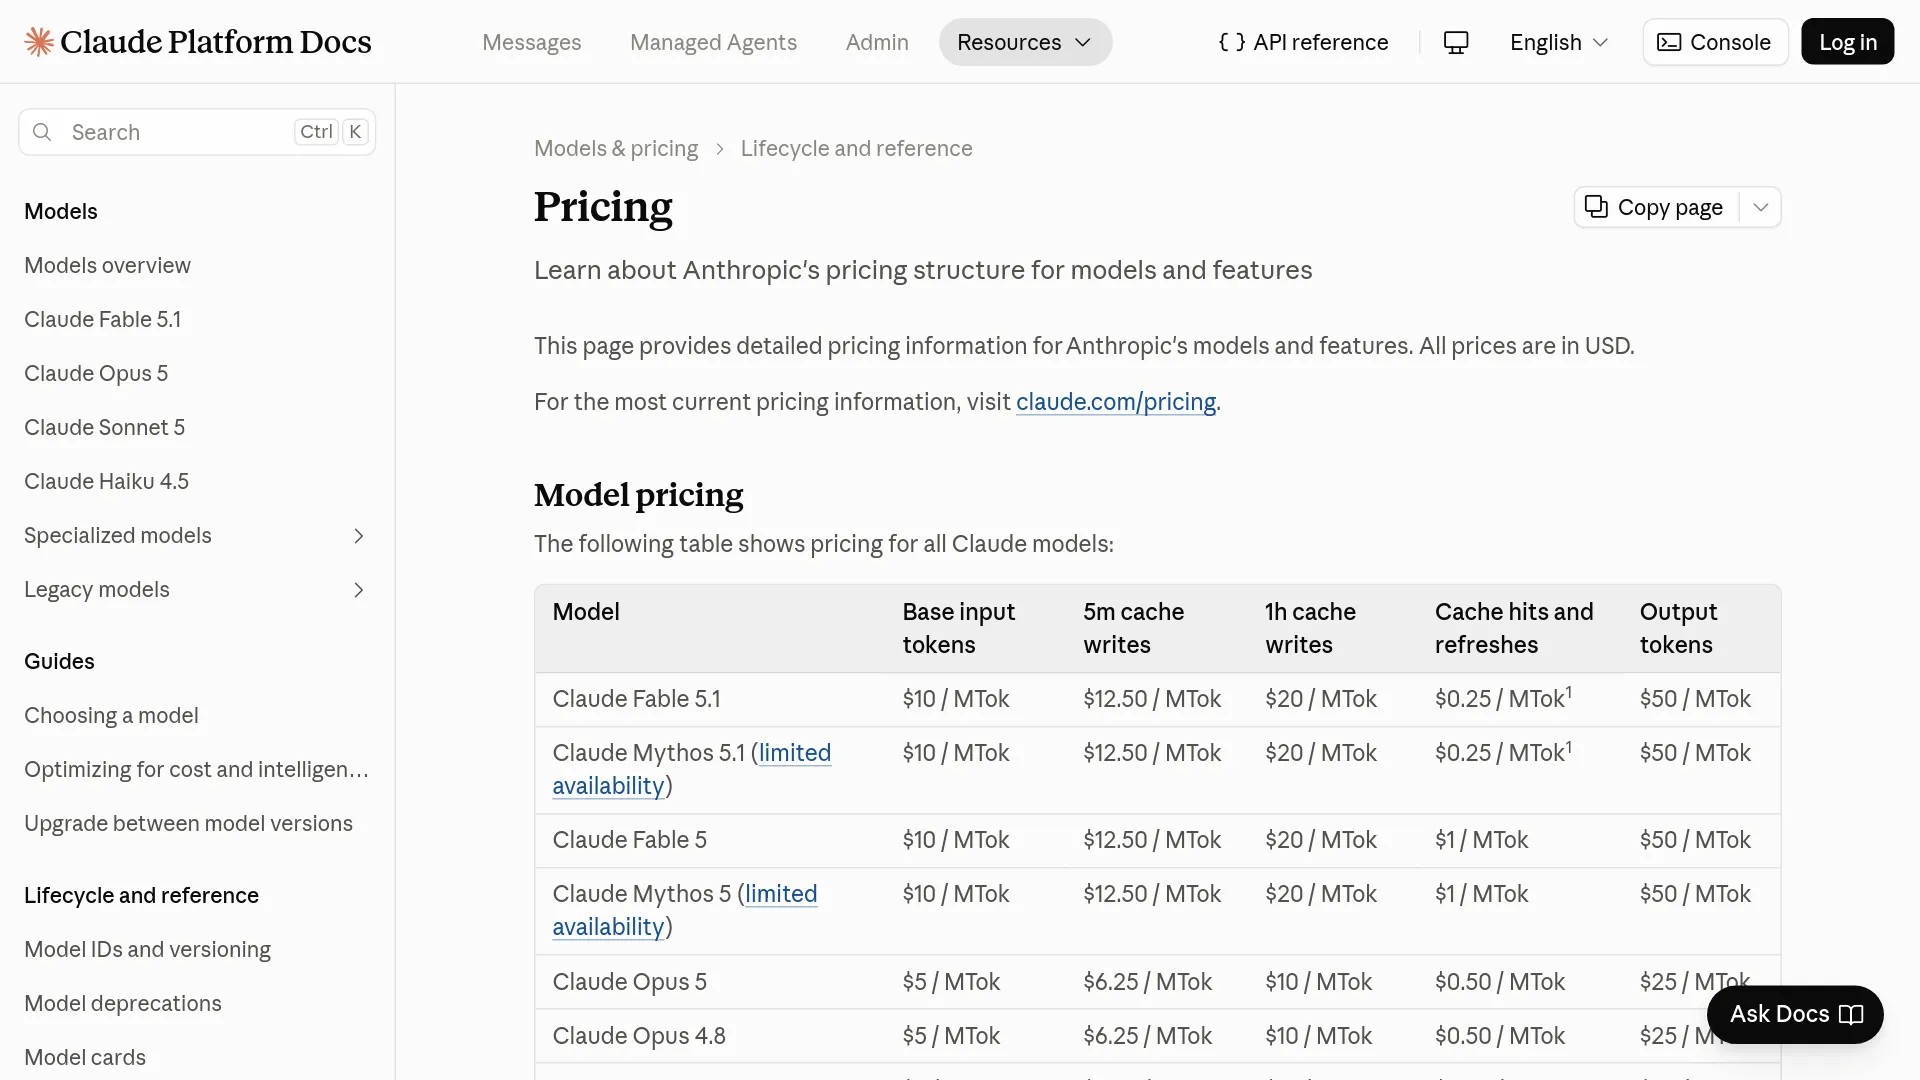
Aşağıdaki ücretler, Anthropic'in güncel API fiyatlandırma dokümantasyonundan alınmıştır ve 1 milyon token başına ABD doları cinsindendir.
| Faturalama kalemi | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Temel giriş | $10.00 | $5.00 |
| 5 dakikalık önbellek yazımı | $12.50 | $6.25 |
| 1 saatlik önbellek yazımı | $20.00 | $10.00 |
| Önbellek okuma | $0.25 | $0.50 |
| Çıktı | $50.00 | $25.00 |
| Toplu giriş / çıktı | $5.00 / $25.00 | $2.50 / $12.50 |
Fable 5.1'in giriş ve çıktı fiyatları Fable 5'e göre değişmedi. Tanıtımlarda belirtilen tasarrufu sağlayan değişiklik önbellek okuma ücretinde: Fable 5'te 1 milyon token başına $1.00 olan ücret, $0.25'e indi. Anthropic, tipik iş yükü maliyetinin yaklaşık %25 daha düşük olacağını ve yoğun ajan kullanımlı işlerde maliyetin yaklaşık %45'e kadar azalabileceğini tahmin ediyor; ancak bunlar evrensel indirimler değil, iş yüküne bağlı tahminlerdir.
Tur başına basit bir hesaplama, ödünleşimi daha net gösterir. Önbelleğe alınmış bağlam C, yeni giriş I ve çıktı O olsun; her biri milyon token cinsinden ölçülsün. Önbellek yazma ücretleri hesaba katılmadığında Fable 5.1'in maliyeti 10I + 0.25C + 50O; Opus 5'in maliyeti ise 5I + 0.50C + 25O olur.
Fable'ın daha ucuz önbellek okumaları, daha yüksek yeni giriş ve çıktı ücretlerini ancak şu koşulda dengeler:
0.25C > 5I + 25O
2.000 tokenlık yeni bir prompt ve 1.000 tokenlık yanıt için I = 0.002 ve O = 0.001 olur. Yalnızca okuma maliyeti hesabında Fable'ın avantajlı hâle gelmesi için önbelleğe alınmış bağlamın yaklaşık 140.000 token değerini aşması gerekir. Önbellek yazma ücretleri eklendiğinde kesişim noktası daha da ileri gider.
Bu nedenle kısa çıkarım, sınıflandırma, yeniden yazma ve tek seferlik kodlama çağrıları fiyat gerekçesiyle Fable 5.1'e yükseltilmemeli. İndirim uygulanabilecek yeniden kullanılabilir önek ya çok azdır ya da hiç yoktur; ayrıca üretilen her token, Opus 5'in iki katı ücretlendirilir.
Gerçek iş akışlarında hangi model nerede anlamlı?
Pratik ayrım, kapsamı sınırlı yürütme ile uzun ufuklu süreklilik arasındadır. İş açıkça tanımlanmışsa veya yoğun çıktı üretiyorsa Opus 5'i gerekçelendirmek daha kolaydır. Bir ajanın planını koruması, araçları tekrar tekrar kullanması, hatalardan toparlanması ve büyük bağlamı birçok tur boyunca taşıması gerektiğinde Fable 5.1 daha ilgi çekici hâle gelir.
Kodlama ajanları: Benchmark sırasına değil, tamamlanan işe bakın
Olağan depo işleri için ilk denenmesi gereken model Opus 5'tir: Kapsamı belirlenmiş hata düzeltmeleri, tanımlı refactor'lar, kod incelemeleri ve düşük maliyetin yeniden deneme ya da çaba yükseltme esnekliği sunduğu görevler. Çok dosyalı değişiklikler, geçişler, sistem düzeyinde hata ayıklama ve geç gelen bir hatanın yavaş yanıttan daha maliyetli olduğu eşzamansız kodlama oturumlarında Fable 5.1 bir pilot uygulamayı hak eder.
Topluluk geri bildirimleri iki farklı operasyonel riske işaret ediyor. Büyük bir r/ClaudeCode tartışmasında u/CyCoCyCo şunu yazdı:
“Başarılı olduğum tek yol, ona hedef prompt'ları hazırlatıp bunu uçtan uca çalıştırmak oldu.” — Reddit'te u/CyCoCyCo
Bu, Opus 5'in her kod tabanında başarısız olduğunun kanıtı değil; prompting ve iş akışına yönelik bir şikâyetin göstergesi. Aynı tartışmadaki başka kullanıcılar da daha uzun, bağlam ağırlıklı görevlerde talimattan sapma ve yeni hatalara yol açan düzeltmeler gibi sorunlar anlattı.
Fable 5.1'in şikâyet profili farklı: Bir yayın tartışmasında kullanıcılar alışılmadık derecede hızlı token veya kota tüketimi bildirdi. Bu anekdotsal rapor, evrensel bir abonelik sınırı kanıtlamaz; ancak modeli yalnızca çıktı kalitesine göre değerlendirmek yerine pilot süreçte kullanımı izlemeniz için bir gerekçedir.
Mantıklı bir kodlama ajanı pilotunda şunlar kaydedilir:
- İnsan müdahalesi olmadan tamamlanan görevler.
- Model başarı bildirdikten sonra yeniden açılan hatalar veya regresyonlar.
- Toplam giriş, önbelleğe alınmış giriş ve çıktı token'ları.
- Geçen süre ve araç çağrısı sayısı.
- İnsan düzeltme süresi ile geç aşamadaki başarısız çalıştırmaların maliyeti.
Araştırma ve belge yoğun işler: Fable'ın gerekçesi daha net
İş çok büyük bir belge kümesi, tekrarlanan araç çağrıları, görsel grafikler, çok aşamalı araştırma veya birkaç revizyon turuna dayanması gereken bir teslimat içeriyorsa Fable 5.1 daha güçlü adaydır. Anthropic, modeli özellikle belgeler, elektronik tablolar, slaytlar, diyagramlar, tablolar ve uzun soluklu araştırmalar için konumlandırıyor.
Opus 5 de aynı 1 milyon token bağlam kapasitesine sahip ve Anthropic tarafından karmaşık belgeler ile gelişmiş ajanlar için yetkin olarak tanımlanıyor. İş, ciddi miktarda üretilmiş çıktı içeren tek bir analizse Fable'ın önbellek avantajından çok Opus'un düşük ücreti önem kazanabilir. Fable'ın benchmark üstünlüğünü üretim gereksinimi saymadan önce temsili bir örnek çalıştırın.
Bilgisayar kullanımı ve iş otomasyonu: Tüm süreci test edin
Fable 5.1, Anthropic'in OSWorld ve AutomationBench satırlarında Opus 5'in önünde; ancak bu görevler tek yanıttan ziyade bir eylem dizisini ölçüyor. Tarayıcı veya iş süreci ajanlarında modelin doğru son duruma ulaşıp ulaşmadığını, ne kadar sık toparlanmaya ihtiyaç duyduğunu ve başarısız bir eylemin çalıştırmanın kalanını geçersiz kılıp kılmadığını değerlendirin.
Buradaki ilgili metrik yalnızca milyon token başına maliyet değil, tamamlanan sonuç başına maliyettir. Uzun bir iş akışındaki tekrar denemeleri engelleyen model, daha yüksek ücretine rağmen ekonomik olabilir; son duruma ulaşmadan kullanım bütçesini tüketen model ise olamaz.
Geçmeden önce ekiplerin kontrol etmesi gereken entegrasyon ayrıntıları
Fable 5.1'in geçiş dokümantasyonu, zorunlu araç kullanımı, düşünme blokları ve konuşma geçmişi doğrulamasındaki değişiklikleri açıklıyor. Kendi mesaj yönlendiricisini kullanan ekipler, varsayılan modeli değiştirmeden önce bunları test etmeli.
| Değişiklik | Olası sonuç | Geçiş adımı |
|---|---|---|
| Zorunlu araç kullanımı | tool_choice: {"type":"any"} veya adlandırılmış araç seçimi HTTP 400 döndürebilir. | Net araç talimatlarıyla auto kullanın veya uygun yerlerde yapılandırılmış çıktılardan yararlanın. |
| Düşünme bloklarının taşınabilirliği | Önceki modeller Fable 5.1 düşünme bloklarını okuyamaz; fallback turları bunları bırakabilir. | Model değiştirme ve fallback yollarını denetleyin. |
| Konuşma düzenlemeleri | Önceki bir mesajı, sistem prompt'unu veya araç listesini düzenlemek sonraki düşünme bloklarını geçersiz kılabilir. | Geçmişi yalnızca eklemeli kabul edin veya desteklenen tur kapsamlı kontrolleri kullanın. |
| Düşünme yapılandırması | Fable 5.1 uyarlanabilir düşünme kullanır ve düşünmeyi Opus 5 ile aynı şekilde devre dışı bırakmayı desteklemez. | Harcamayı çaba ayarlarıyla kontrol edin ve token kullanımını yeniden test edin. |
Fallback ayrıntısı, karma model yönlendiricilerinde önem taşır. Fable 5.1 isteği kendi muhakeme bağlamıyla devam edebilir; ancak Opus 5'e fallback, Fable 5.1 düşünme bloklarını tüketemez. Yönlendirici bunları sessizce bırakırsa fallback yeniden planlama yapabilir; bu da gecikme ve token ekler. Hem başarı hem hata yolunu, üretime benzer geçmişlerle test edin.
Büyük model iddiaları yerine küçük bir değerlendirme yapın
Her iki modelde de aynı prompt'ları, araçları, bağlamı, çaba politikasını ve kabul testlerini kullanın; aksi hâlde model karşılaştırması, test düzeneği karşılaştırmasına dönüşebilir.
- Sınırlı iş hattı: Kapsamı belirlenmiş hata düzeltmeleri, çıkarım, yapılandırılmış yazım ve kod incelemesi çalıştırın. Faydalı çıktı, düzeltme süresi ve maliyeti izleyin.
- Uzun ufuklu iş hattı: Çok dosyalı bir özellik, geçiş, araştırma görevi veya tarayıcı iş akışı çalıştırın. Son durum başarısı, toparlanma, regresyonlar ve geçen süreyi izleyin.
- Önbellek yoğun iş hattı: Kararlı bir sistem prompt'unu, araç setini ve depo ya da belge önekini tekrarlayın. Önbellek isabet oranını ve önbellek yazımları ile çıktılar dâhil toplam faturayı izleyin.
Opus 5'i gerçekten dağıtacağınız çaba düzeyinde başlatın. Görevi Fable 5.1'e taşımadan önce daha yüksek Opus çabasını test edin. Fable için en az medium ve high düzeylerini deneyin; çaba adının modeller arasında doğrudan aynı anlama geldiğini varsaymayın. Anthropic, çaba ayarlarının derinlik/maliyet dengesini kontrol ettiğini söylüyor; üçüncü taraf testleri de daha yüksek muhakemenin toplu kod inceleme sonuçlarını otomatik olarak iyileştirmediğini gösterdi.
Fable 5.1 ve Opus 5: Sık sorulan sorular
Kodlama için hangi model daha iyi?
Fable 5.1, Anthropic'in yayımladığı Terminal-Bench ve CursorBench sonuçlarında Opus 5'in önünde. Buna rağmen kapsamı belirli ve maliyete duyarlı kodlama işleri için başlangıç noktası olarak Opus 5 daha uygundur. Fable'ın daha yüksek tamamlanma kalitesinin fiyatını ve gecikmesini dengeleyip dengelemediğine temsili bir depo değerlendirmesiyle karar verin.
Fable 5.1, API'de iki katı fiyata değer mi?
Varsayılan olarak hayır. Giriş ve çıktı ücretleri Opus 5'in iki katıyken önbellek okumaları yarı fiyatınadır; Fable, iş yükü büyük bağlamı tekrar tekrar kullandığında ve görece az çıktı ürettiğinde finansal açıdan ilgi çekici hâle gelir.
Fable 5.1'in bağlam penceresi daha mı büyük?
Hayır. Anthropic, her iki model için de 1 milyon token bağlam penceresi ve 128.000 token maksimum çıktı belirtiyor. Fable'ın ayrıştığı nokta, daha büyük yayımlanmış bir pencere değil; daha uzun ufuklu muhakeme ve ajan süreçleri için konumlandırılmasıdır.
Geçmeden önce Opus 5'in çaba düzeyini artırmalı mıyım?
Evet. Anthropic'in model rehberi, Fable 5.1'e geçmeden önce yüksek çaba düzeyindeki Opus 5'in değerlendirilmesini öneriyor. Her isteği en yüksek çaba düzeyinde çalıştırmak yerine ek token maliyetini kalite artışıyla karşılaştırın.
Fable 5.1'den Opus 5'e güvenle fallback yapabilir miyim?
Bu fallback'i kurabilirsiniz, ancak konuşma durumunun taşınabilir olduğunu varsaymayın. Önceki modeller Fable 5.1 düşünme bloklarını okuyamaz ve Fable 5.1'in geçmiş doğrulaması önceki turları düzenleyen yönlendiricileri ortaya çıkarabilir. Fallback'i gerçek araç şemaları ve mesaj geçmişleriyle test edin.
Geliştiriciler Fable 5.1 ve Opus 5'e nereden erişebilir?
Anthropic, her iki modeli de Claude planları kapsamında; platformu ve bulut pazaryeri entegrasyonları üzerinden geliştirici erişimi için listeliyor. Tam model kimlikleri ve kullanılabilirlik sağlayıcıya göre değişebilir. Bu nedenle dağıtıma özel tanımlayıcıyı Fable 5.1 dokümantasyonundan veya Opus 5 ürün sayfasından doğrulayın.
Pratik tercih kalıcı yükseltme değil, yönlendirme kuralıdır
| Karar | Opus 5 kullanın | Fable 5.1 kullanın |
|---|---|---|
| Karma trafik için varsayılan model | Evet | Yalnızca değerlendirmeden sonra |
| Kısa, tek seferlik çağrılar | Evet | Fiyat gerekçesi yok |
| Yoğun çıktı üretimi | Evet | Genellikle hayır |
| Büyük önbelleğe alınmış önekler | Dikkatle karşılaştırın | Olası maliyet gerekçesi |
| Uzun süre çalışan otonom kodlama | Önce pilot uygulama | Güçlü aday |
| Sıkı biçimde sınırlandırılmış refactor'lar | Genellikle | Opus kabul testlerini geçemezse |
| Tarayıcı veya çok adımlı otomasyon | Önce pilot uygulama | Güçlü benchmark gerekçesi |
| Özel fallback yönlendiricisi | Daha basit temel yapı | Geçiş testi gerektirir |
Opus 5'i temel model olarak koruyun, iki modeli de aynı sınırlı ve uzun ufuklu görev setinde çalıştırın; Fable 5.1'e yalnızca dolar başına tamamlanan işi iyileştirdiğinde yönlendirin.
Modele özgü maliyet ayrıntıları için Claude Fable 5.1 API pricing sayfasına; daha geniş model başvurusu için ise Claude Opus 5 sayfasına bakın.