 AIREITER
"Sonnet 5, Opus 4.8'e yakın, ama daha ucuz" ifadesi Anthropic'in kendi iddiası. Bunun nerede geçerliliğini yitirdiğini öğrenmek istedik, bu yüzden Claude Code CLI aracılığıyla her iki modelde de dört özdeş görev çalıştırdık ve her API yanıtından gerçek maliyeti, süreyi ve araç çağrısı sayılarını kaydettik. En önemli olanı şuydu: Sonnet 5'i, Opus 4.8'in varsayılan olarak yaptığını eşleştirmek için xhigh çabasına yükselttik ve ölçtüğümüz fiyat farkı neredeyse ortadan kayboldu — buna karşılık Opus 4.8 işi yaklaşık yarı sürede tamamladı.
Sonnet 5 ile Opus 4.8’e Genel Bakış
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
Yayınlanma | 30 Haziran 2026 | |
Bağlam penceresi | 1M tokens | 1M tokens |
Maksimum çıktı | 128K tokens | 128K tokens |
Fiyatlandırma (1M tokens başına giriş/çıkış) | 31 Ağustos 2026'ya kadar tanıtım fiyatı $2/$10, ardından $3/$15 | $5/$25 |
Hızlı mod | Desteklenmiyor | Desteklenir (araştırma önizlemesi), premium fiyatlandırmayla ~2.5x'e kadar çıktı hızı |
Çaba seviyeleri | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
Konumlandırma | Daha ucuz, ajan odaklı Sonnet-seviyesi model | Anthropic'in amiral gemisi, en yüksek doğruluklu seçenek |
Bağlam penceresi ve maksimum çıktı aynıdır — burada ayırt edici bir unsur yoktur. Farklı olan bir şey şu: Sonnet 5, Anthropic’in aynı metin için Sonnet 4.6’dan “yaklaşık %30 daha fazla token” ürettiğini söylediği yeni bir tokenizer üzerinde çalışır; bu yüzden Sonnet 4.6’dan devralınan bir max_tokens bütçesi veya maliyet tahmini doğrudan geçerli olmaz.
Resmi Benchmark Karşılaştırması
Anthropic’in kendi açıklamalarına ve llm-stats.com tarafından yapılan üçüncü taraf analizle birlikte derlenen verilere göre, örüntü tutarlı: Sonnet 5 birkaç kıstas ölçütünde kazanıyor ya da berabere kalıyor, Opus 4.8 ise çoğunda önde; genellikle tek haneli farklarla.
Karşılaştırma Ölçütü | Sonnet 5 | Opus 4.8 | Fark |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (with tools) | 57.4% | 57.9% | Berabereye yakın |
Humanity's Last Exam (no tools) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
İki şey öne çıkıyor. Opus 4.8’in en büyük üstünlüğü zor matematikte (USAMO), kodlamada değil — kodlama farkları (SWE-bench, Terminal-Bench) hep tek haneli ve Sonnet 5 bunlardan birini doğrudan kazanıyor. Araçlarla desteklenmiş genel akıl yürütmede (HLE with tools) ise ikisi, bunu beraberlik sayacak kadar yakın.
Yine de, bir yetenek ölçütü olmasa da dikkat çekmeye değer bir güvenlik sayısı da var: aynı açıklamalara göre, ek korumalar olmadan browser-use senaryolarında Sonnet 5'in ölçülen prompt-injection saldırısı başarı oranı %0,93'tü; Opus 4.8 için ise bu oran %31,5 idi. Anthropic, bu özel fark için ayrıntılı bir açıklama yayımlamadı. Açık web'de gözetimsiz gezinme yapan herhangi bir agentic şey geliştiriyorsanız, amiral gemisi modelin otomatik olarak daha güvenli varsayılan olduğunu kabul etmek yerine kendi korumalarınızı test etmeye değer.
Dört Bire Bir Testi Kendi Başımıza Yaptık
Şu anda dışarıda bulunanların çoğu ya yukarıdaki resmi benchmark tablosunu derliyor ya da öznel, tek model izlenimlerini paylaşıyor. Kontrollü, aynı prompt ile bir maliyet ve gecikme karşılaştırması bulamadık, bu yüzden kendi çalışmamızı yaptık.
Yöntem: 2026-07-01 tarihinde çalıştırılan dört görev, her seferinde Claude Code CLI (claude -p --model <id> --effort <level> --output-format json) aracılığıyla claude-sonnet-5 ve claude-opus-4-8 modeline gönderilen aynı istemle yapıldı. Maliyet, süre ve tur sayıları, her çalıştırmanın API yanıtından doğrudan okunmuştur; belirteç sayılarından tahmin edilmemiştir. Her model/effort yapılandırması, görev başına bir kez çalıştırıldı — tek bir çalıştırmadan elde edilen gerçek sayılar, istatistiksel olarak ortalanmış bir örnek değil. Her boşluğun boyutunu tam olmaktan ziyade yönsel olarak değerlendirin; yön, yaptığımız her testte tutarlıydı.
Test 1: Maliyet Tersine Çevirme Kontrolü
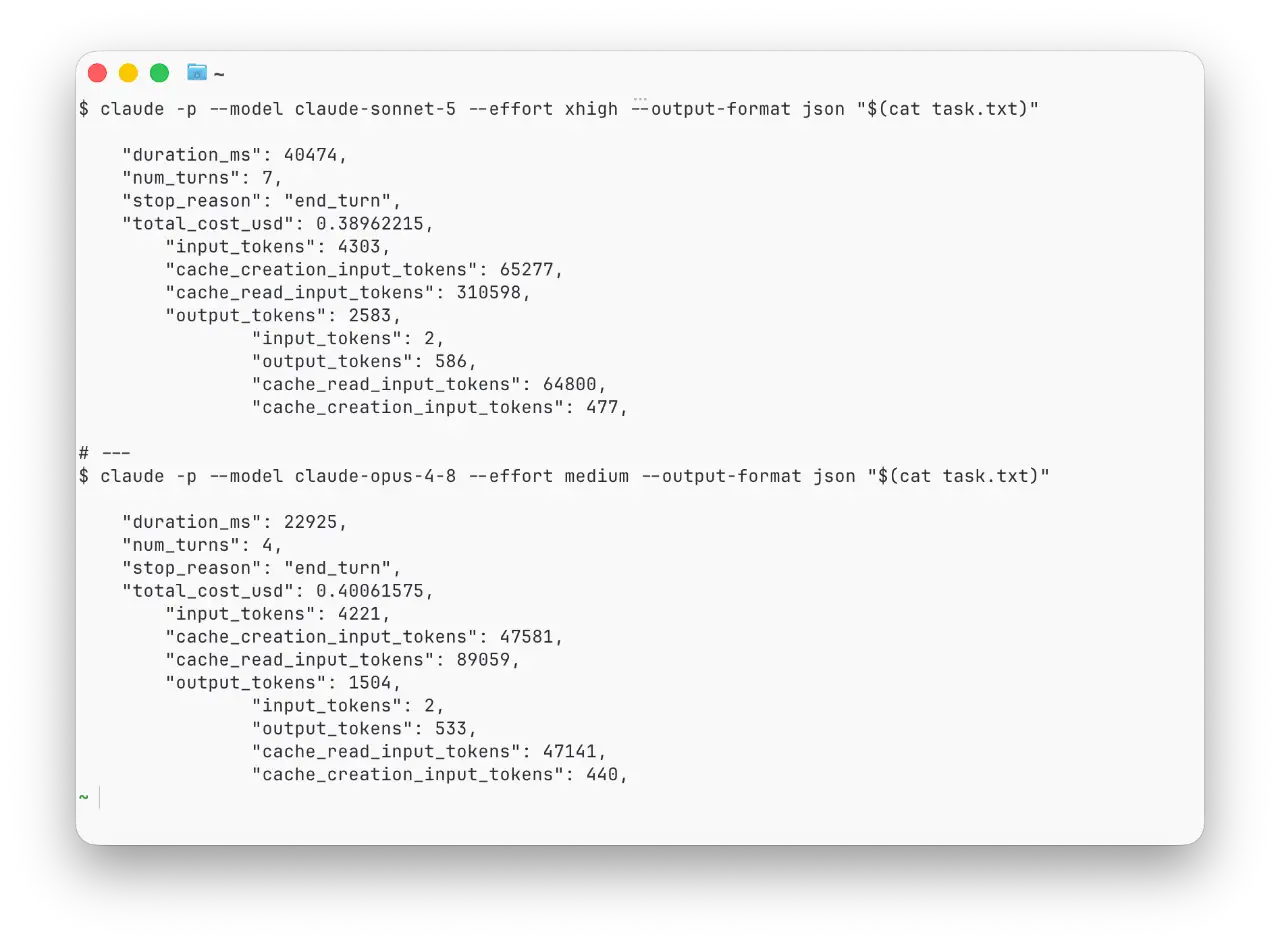
Cevaplamak en çok istediğimiz soru şuydu: daha zor bir görevi telafi etmek için çaba düzeyini yükselttiğinizde Sonnet 5 daha ucuz kalmaya devam ediyor mu? Test 2'deki (aşağıda) aynı kodlama görevini Sonnet 5 xhigh ile Opus 4.8 medium karşısında çalıştırdık.
Kurulum | Maliyet | Süre | Tur | Sonuç |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
%3 maliyet farkı — esasen başa baş — ve Opus 4.8, kendi daha düşük çaba ayarında, yaklaşık yarı sayıda tur kullanarak sürenin %57’sinde tamamladı. Her ikisi de doğru, çalışan kod üretti. Bu, insanların Hacker News üzerinde zaten işaret ettiğine uyuyor: oradaki bir yorumcu, karşılaştırılabilir iş için Opus 4.8’in medium reasoning’de yaklaşık $0.45, Sonnet 5’in ise xhigh/max’te yaklaşık $0.52 tuttuğunu tahmin etmişti.
Eşleştirilmiş Eforla Test 2: Kodlama Görevi
Aynı istem, her iki model de high effort ile: verimli bir en uzun palindromik alt dizi fonksiyonu yazın, uç durumları kapsayan test vakaları oluşturun, bunları çalıştırın, başarısız olan her şeyi düzeltin.
Kurulum | Maliyet | Süre | Tur | Sonuç |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
İkisi de aynı merkezin etrafında genişletme yaklaşımına yöneldi ve ilk denemede tüm testleri geçti. Opus 4.8 daha hızlı ve daha az turda oraya ulaştı, yaklaşık %16 daha fazla maliyetle. Kalite aynı olduğunda, bu tur yalnızca hız nedeniyle Opus’un olur.
Test 3: Yazma / Bilgi Çalışması
Tek bir doğru cevabı olmayan bir iş kararı istemi: Seri A turunun kapanmasına altı hafta kala, 12 kişilik bir SaaS şirketine felaket kurtarma için ikinci bir AWS bölgesine geçiş yapmak üzere 3-4 hafta harcayıp harcamamaları konusunda tavsiyede bulunun.
Kurulum | Maliyet | Süre | Tur |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
İkisi de esasen aynı öneriyi verdi — tam geçişi atlayın, bunun yerine hafif bir yedekleme/çalıştırma kitabı (runbook) yayınlayın — ve benzer kalitede gerekçelendirme sundu. Sonnet 5 bunu yaklaşık üçte iki sürede başardı ve %14 daha düşük maliyetle tamamladı. Bu, "Sonnet 5 bilgi işleri konusunda gayet iyi dayanıyor" sonucunun net biçimde ortaya çıktığı tek test oldu.
Test 4: Ajan Tabanlı Arama — Sonnet 5 Gerçekten "Aşırı mı Düşünüyor"?
Some Reddit konuları, Sonnet 5'i basit istekler konusunda Opus 4.8'e kıyasla daha fazla aşırı düşünmeye yatkın olarak tanımlıyor. Gerçekten basit bir testi denedik: bir dizin ağacındaki her .py dosyasının bayt boyutunu toplayın ve hangi alt dizinin bunlardan en fazla içerdiğini bildirin.
Kurulum | Maliyet | Süre | Tur Sayısı |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
İkisi de aynı doğru sonuca ulaştı. Maliyet arasındaki fark yuvarlama hatası düzeyindeydi, ancak Sonnet 5 bir ek araç çağrısı turu ve yaklaşık %50 daha fazla süre aldı. Bu, "fazla düşünme" şikayeti için gerçek, olsa da mütevazı, bir veri noktası — ve Test 1 ile örtüşüyor: Sonnet 5, aynı noktaya ulaşmak için daha fazla adım atma eğiliminde.
Öyleyse Hangisini Gerçekten Kullanmalısınız?
Opus 4.8'i seçin hızın önemli olduğu kodlama görevleri, çok sayıda araç çağrısı içeren agentic iş akışları veya normalde Sonnet 5'in effort ayarını çıktıya güvenmek için
highseviyesinin ötesine taşımak isteyebileceğiniz her şey için — Sonnet 5'in maliyet avantajının ortadan kalktığı durum tam olarak budur.Sonnet 5'i seçin yüksek hacimli, bütçe duyarlı işler ve genel bilgi/yazma görevleri için; ancak
mediumveyahigheffort seviyesinde tutun. "Sırf güvenli olsun diye" onu refleks olarakxhighseviyesine çıkarmayın — fiyatlandırma hikâyesinin dağıldığı yer tam da burasıdır.İkisi de işe yarar basit sorgular ve tek turlu istekler için; ölçtüğümüz pratik fark bir ek tur ve birkaç saniyeydi, yanlış bir cevap değil.
SSS
Claude Sonnet 5 gerçekten Opus 4.8'den daha ucuz mu?
Uyumlu çaba seviyelerinde, evet — belirgin şekilde. Ancak Sonnet 5’i daha zor bir görevi telafi etmek için xhigh seviyesine çıkarırsanız, fark birkaç yüzdeye kadar daralabilir; öte yandan daha düşük bir çaba ayarında Opus 4.8 daha hızlı tamamlar. Para tasarrufu yaptığınızı varsaymadan önce aslında hangi çaba seviyesinde çalıştırdığınızı kontrol edin. Haiku, Sonnet ve Opus için tam fiyat listesi için Claude API fiyatlandırma rehberimize bakın.
Claude Sonnet 5 ile Sonnet 4.6 hakkında ne düşünüyorsunuz?
Bir model katmanı seçimi değil, nesilsel bir yükseltme — ve maliyet de aynı yönde hareket etmiyor. Sonnet 5, Terminal-Bench’te Sonnet 4.6’yı çift haneli farkla geçiyor, ancak kendi başa baş maliyet testlerimizde Sonnet 5, denediğimiz her çaba seviyesinde Sonnet 4.6’dan daha pahalı çıktı; bunun başlıca nedeni yeni tokenizer. Tüm testler ve rakamlar için Sonnet 5 vs Sonnet 4.6: Gerçekten Daha Ucuz mu?
Claude Sonnet 5 ile Opus 4.6 adil bir karşılaştırma mı?
Aslında değil — Opus 4.6, Opus 4.8'in bir nesil gerisinde. Bugün ne kullanacağınıza karar veriyorsanız, öncülüyle değil, Opus 4.8 ile karşılaştırın.
İki model arasında bağlam penceresi farklı mı?
Hayır — her ikisi de 1M belirteçlik bağlam penceresi ve 128K maksimum çıktı sunar.
Opus 4.8'in prompt enjeksiyonu oranı tarayıcı kullanımında neden bu kadar daha yüksek?
Anthropic'in açıklamalarına göre, ek korumalar olmadan %31,5; özellikle gözetimsiz tarayıcı kullanım senaryolarında Sonnet 5'in %0,93'üne kıyasla. Anthropic ayrıntılı bir açıklama yayınlamadı. Bunu, amiral gemisi modelin otomatik olarak daha güvenli varsayılan olduğu kabulü yerine, kendi özel korumalarınızı test etmek için bir neden olarak değerlendirin.
Ek: Tam İstemler ve Ham Çıktı
Burada bunu yeniden üretmek isteyen herkes için, her test için gönderdiğimiz tam istemler yer alıyor (Test 1 ve Test 2 aynı kodlama istemini kullandı, yalnızca farklı çaba seviyelerinde).
Test 1 & 2 — kodlama istemi:
longest_palindromic_substring(s: str) -> str adlı bir Python fonksiyonu yazın; bu fonksiyon
s'nin en uzun palindromik alt dizgesini döndürsün ve
kaba kuvvet O(n^3)'ten daha verimli bir yaklaşım kullansın (ör. merkezden genişletme veya Manacher algoritması). Bunu
solution.py dosyasına kaydedin.

Ardından, boş dizge,
tek karakter, tümü aynı karakterler, uzunluğu 1'den büyük palindrom olmayan durum, bir
çift uzunluklu palindrom ve bir tek uzunluklu palindromu kapsayan en az 6 test vakası içeren test_solution.py dosyasını yazın.

Testleri pytest ile çalıştırın ve hepsinin geçtiğinden emin olun. Eğer herhangi biri başarısız olursa, kodu düzeltin ve
hepsi geçene kadar yeniden çalıştırın. Nihai pytest çıktısını bildirin.
Test 3 — yazma/bilgi işi istemi:
12 çalışanı, aylık 80 bin dolar MRR’si olan ve şu anda tek bir AWS bölgesinde çalışan küçük bir SaaS şirketine, 6 hafta sonra kapanacak Series A fon toplama sürecinden önce felaket kurtarma amacıyla ikinci bir AWS bölgesine genişleyip genişlememeleri konusunda tavsiyede bulunuyorsunuz.

Mühendislik ekibi, geçişin 3-4 hafta süreceğini ve bu süre boyunca ekibin kapasitesinin büyük kısmını tüketeceğini, bunun da müşteriler tarafından talep edilen iki özelliği geciktireceğini tahmin ediyor.

Yaklaşık 350 kelimelik bir yönetici önerisi yazın: bunu şimdi mi yapmalılar, ertelemeli mi, yoksa orta bir yol mu bulmalılar? Takasları gerekçelendirin. Giriş yapmayın, sadece öneriyi yazın.
Test 4 — aracısal arama istemi:
Geçerli dizin ağacında, .py uzantılı tüm dosyaları bulun, toplam boyutlarını
bayt cinsinden toplayın ve hangi tek alt dizinin (çalışma dizininin doğrudan
alt öğesi) sayıca en fazla .py dosyası içerdiğini söyleyin. Sadece iki
sayı/cevap; herhangi bir yeni dosya yazmaya gerek yok.
Test 1'deki Sonnet 5 (xhigh) çalıştırması için, maliyet ve zamanlamayla ilgili alanlara kısaltılmış gerçek API yanıtı aşağıdadır:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
Bu, Claude Code CLI’nin o çalıştırma için döndürdüğü düzenlenmemiş total_cost_usd, duration_ms ve token sayılarıdır — yukarıdaki Test 1 tablosundaki sayılar doğrudan bu tür alanlardan gelir; her çalıştırma için bir JSON yanıtı vardır.