 AIREITER
MuseTalk запускается даже на ноутбучной видеокарте с 4 ГБ памяти: в официальном README указано, что RTX 3050 Ti Laptop обрабатывает восьмисекундный ролик примерно за пять минут в FP16. Именно разница между «оно запускается» и «оно работает достаточно быстро» определяет, подходит ли вам MuseTalk lipsync. И та же развилка проявляется в разрешении, установке и итоговой стоимости.
Что MuseTalk меняет в ролике, а что оставляет как есть
MuseTalk перерисовывает рот и нижнюю часть лица в уже готовом видео, подгоняя движения губ под отдельную аудиодорожку. Положение головы, движения глаз, мимика, фон и движение камеры не генерируются заново — модель сохраняет их из исходника. Это локальная правка, а не генератор говорящей головы: сначала у вас уже должно быть видео с хорошо различимым лицом.
Такая скорость достигается архитектурой модели. Репозиторий Tencent Music Lyra Lab использует замороженный VAE sd-vae-ft-mse для кодирования замаскированного лица, замороженную модель Whisper-tiny для извлечения аудиопризнаков и объединяет эти данные через cross-attention в UNet, заимствованном у Stable Diffusion v1.4. Вместо итеративного цикла удаления шума MuseTalk выполняет одношаговый inpainting в латентном пространстве. Именно это, по заявлению авторов, позволяет получить скорость от 30 кадров в секунду на NVIDIA Tesla V100.
Что означает область лица 256x256 для исходника в 1080p
Значение 256x256 — это размер редактируемой области лица, а не разрешение готового видео. Ролик в 1080p останется в 1080p и сохранит исходную частоту кадров: модель лишь генерирует участок 256x256 и смешивает его с областью вокруг рта. Поэтому результат тем лучше, чем крупнее лицо в кадре. На плотном крупном плане мягкость обработанного участка особенно заметна рядом с резкими деталями лица.
Есть два способа немного сгладить это ограничение, но у каждого своя цена. Если убрать --use_float16, качество вырастет, зато потребуется больше видеопамяти и времени. Обработка готового ролика через GFPGAN или CodeFormer делает область рта резче, но добавляет отдельный этап и слегка меняет внешность персонажа.
Качество в цифрах: где MuseTalk выигрывает, а где Wav2Lip остается сильнее
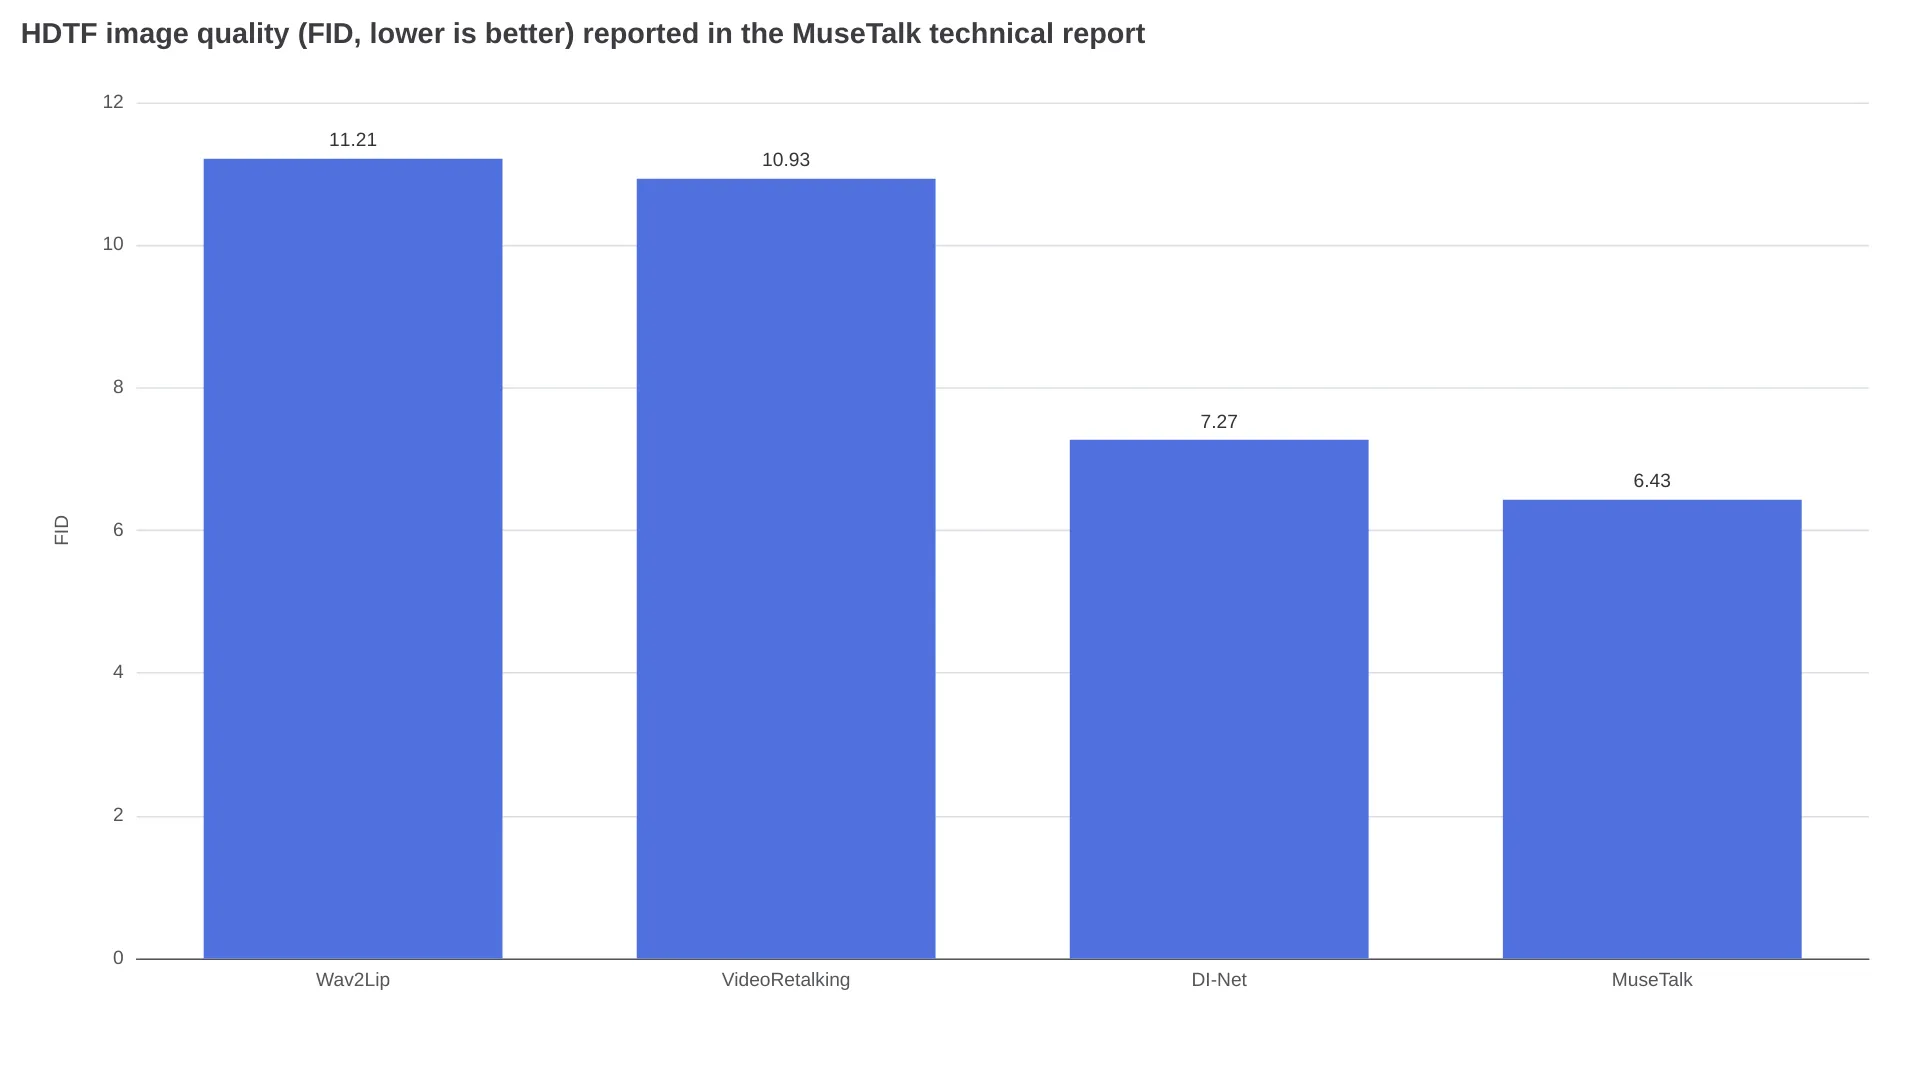
Главное преимущество MuseTalk — качество изображения, а не абсолютная точность синхронизации. На датасете HDTF технический отчет MuseTalk приводит FID 6.43 против 7.27 у DI-Net, 10.93 у VideoRetalking и 11.21 у Wav2Lip.
Но по метрике синхронизации расстановка меняется. В том же отчете у Wav2Lip LSE-C равен 7.46 против 6.53 у MuseTalk. Зато MuseTalk немного опережает конкурента по сходству личности: CSIM 0.8225 против 0.8184. Иными словами, старая GAN-модель лучше отслеживает движения губ, а MuseTalk лучше сохраняет качество изображения. Результаты пользовательского исследования выглядят достаточно сдержанно у всех моделей: 3.62 из 5 за визуальное качество, 3.55 за сходство личности и 3.41 за синхронизацию губ.
Если учитывать ограничение области 256x256, эти цифры описывают модель для убедительных средних планов, но не для крупных планов в 4K.
Сколько стоит минута синхронизации губ
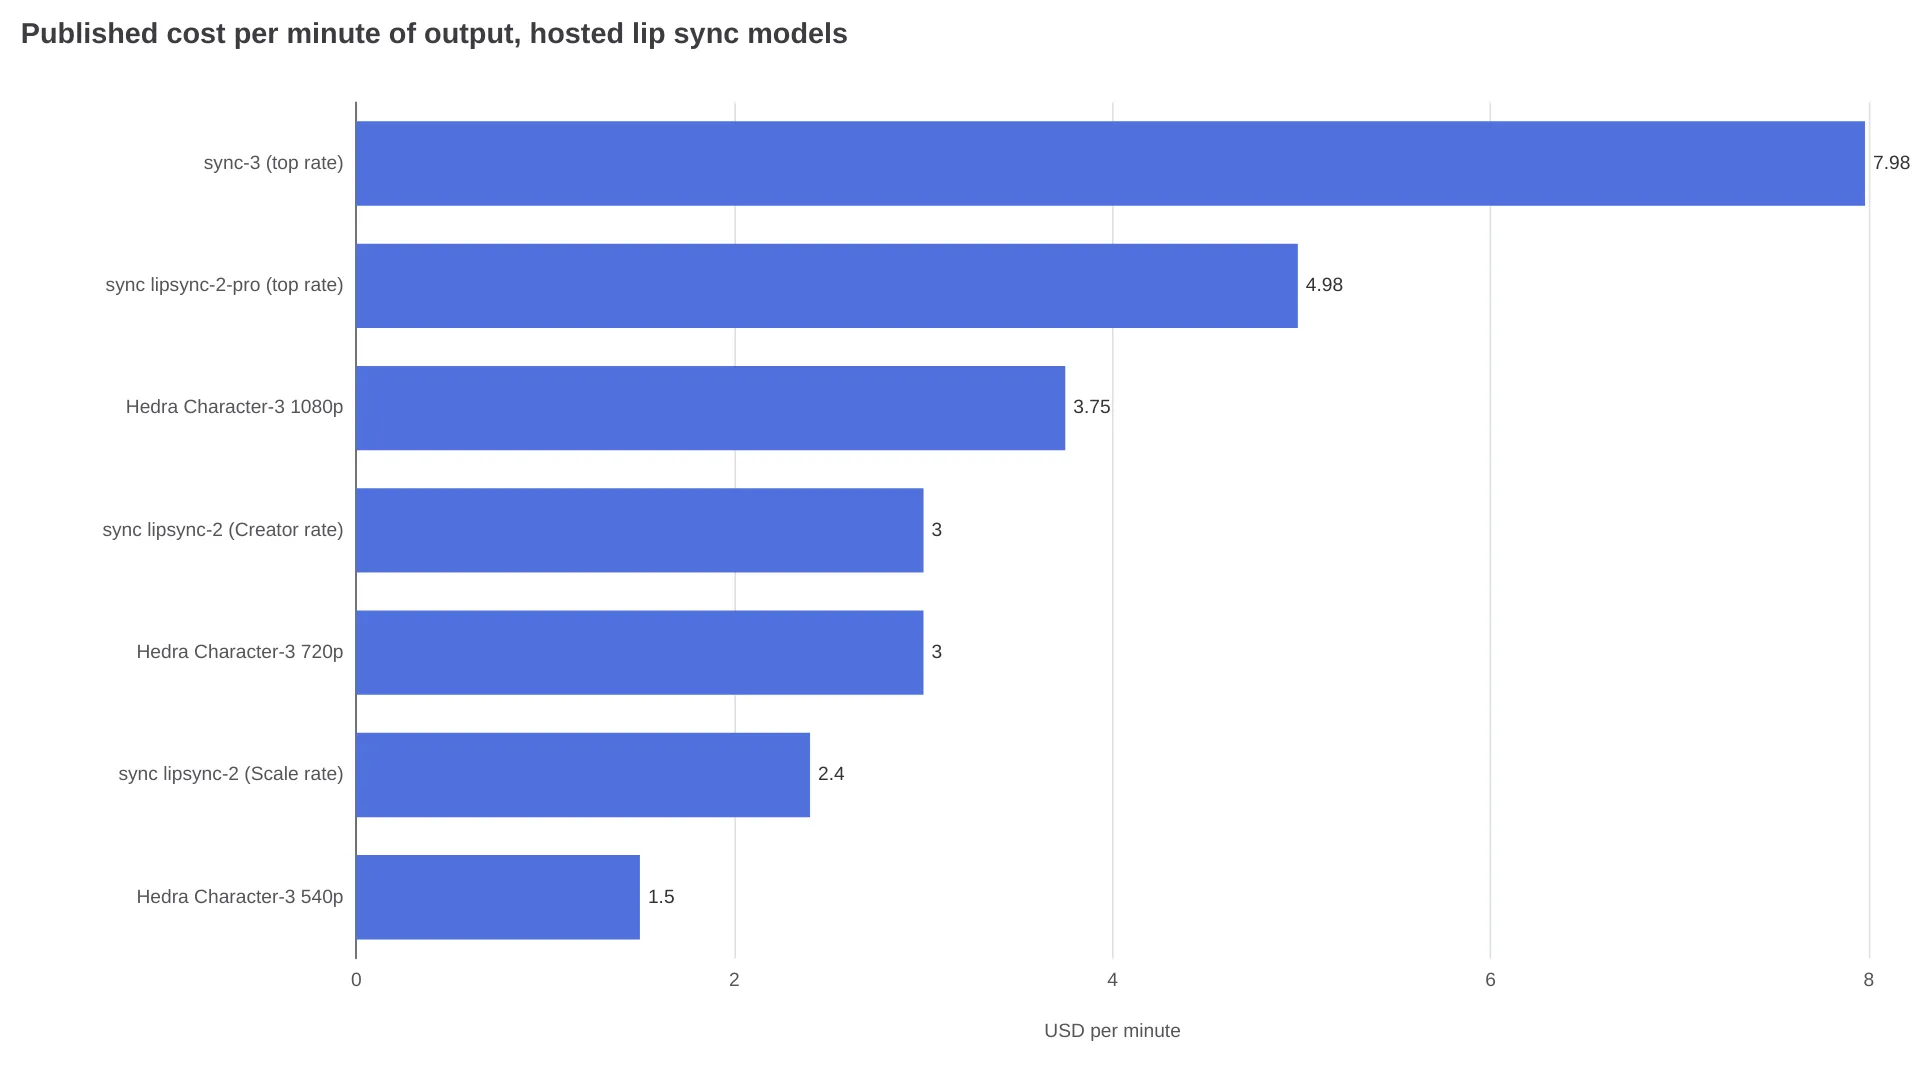
Здесь открытая модель действительно раскрывается с лучшей стороны. Опубликованные тарифы размещенных lipsync-моделей составляют от $1.50 до почти $8.00 за минуту готового видео.
| Вариант | Опубликованный тариф (единицы тарификации различаются) | За минуту готового видео | Разрешение лица |
|---|---|---|---|
| MuseTalk на собственном сервере, аренда Tesla V100 | $0.188 / GPU-час | ~$0.006 при 2 GPU-мин на минуту ролика | 256x256 |
| MuseTalk на Replicate | ~$0.052 / запуск, типичная длительность запуска 54 с согласно странице модели | Оплата за запуск, а не за минуту | 256x256 |
| MuseTalk на fal.ai | Оплата за секунду вычислений | На странице модели не опубликовано | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — image-to-video, а не готовая замена для обработки существующего видео | 2.5¢ / 5¢ / 6.25¢ за секунду | $1.50 / $3.00 / $3.75 | н/д |
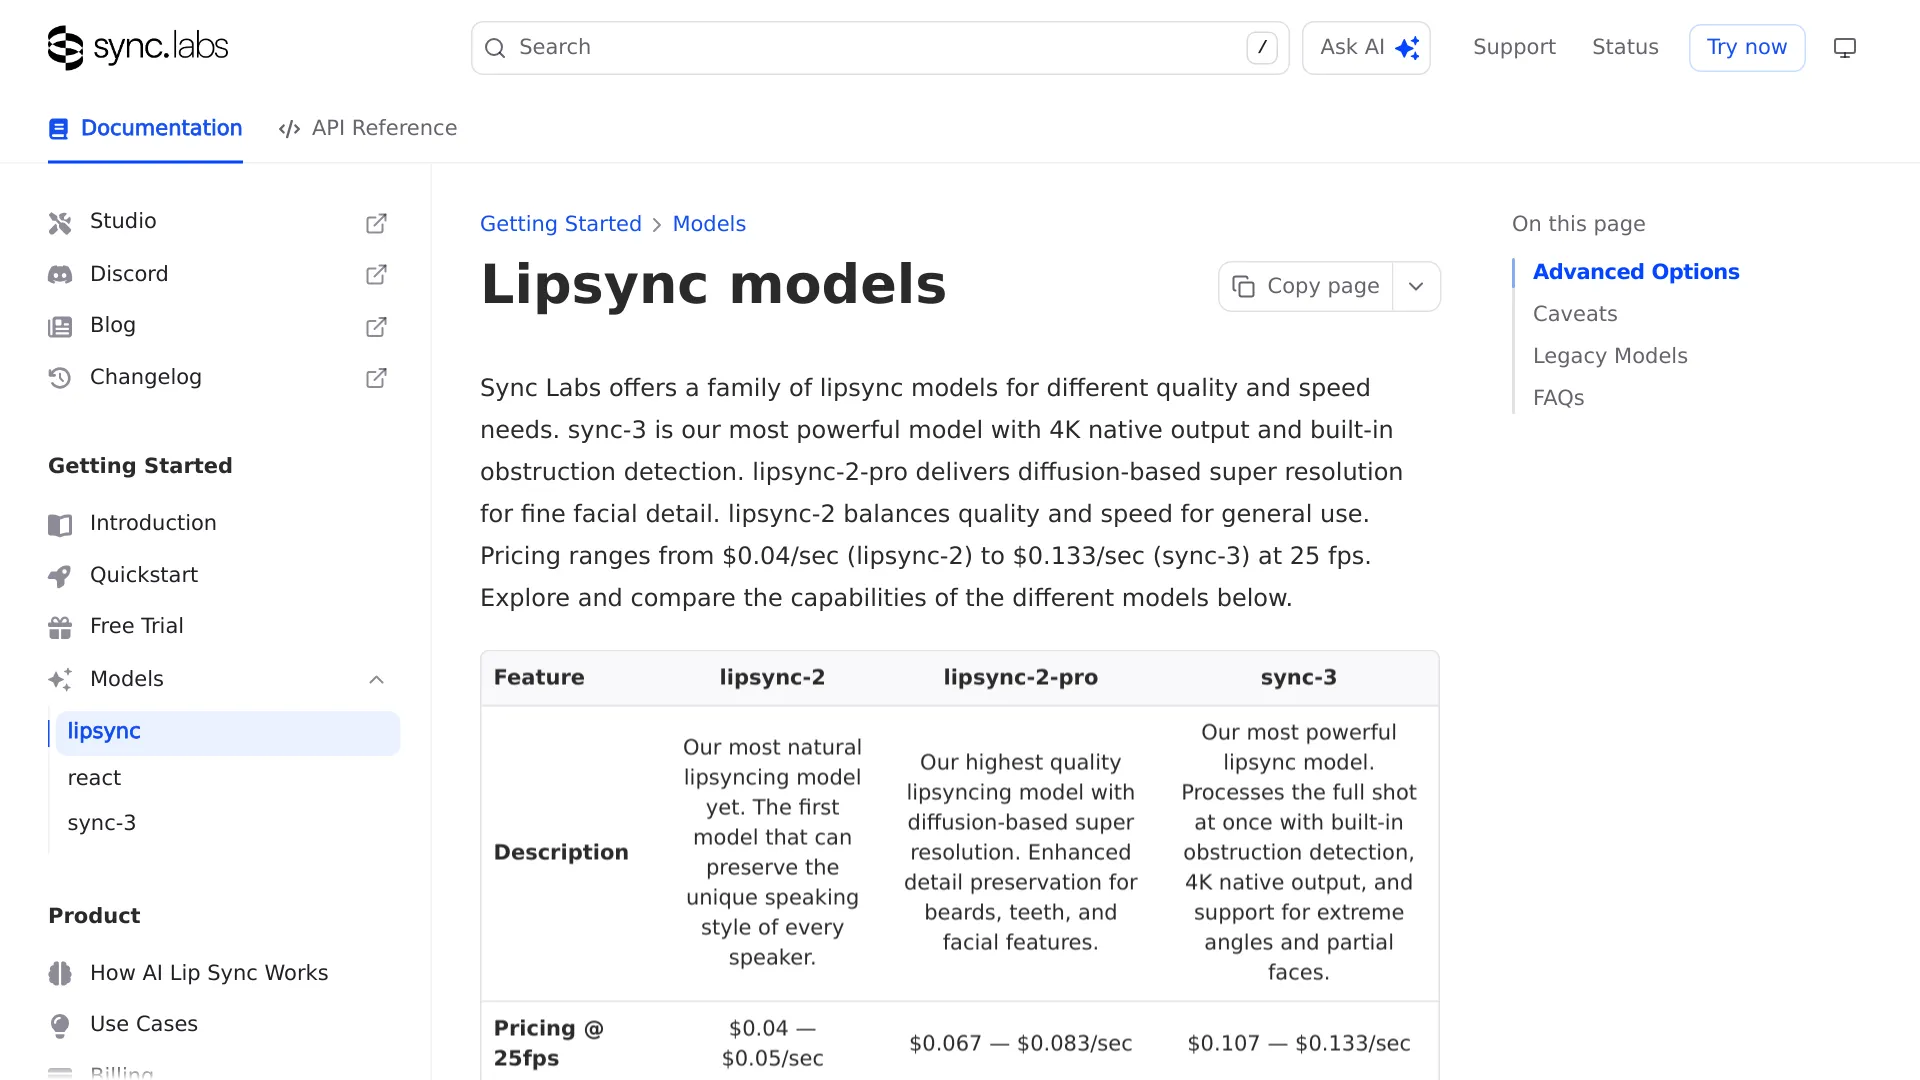
| sync lipsync-2 | $0.04–0.05 / сек при 25 кадрах/с | $2.40–$3.00 | 512x512 |
| sync lipsync-2-pro | $0.067–0.083 / сек | $4.02–$4.98 | 512x512 + дополнительная детализация |
| sync-3 | $0.107–0.133 / сек | $6.42–$7.98 | нативное 4K |
Расчет для самостоятельного запуска взят из разбора стоимости NexGPU. В нем на минутный ролик закладываются две минуты работы GPU: инференс, детекция DWPose, кодирование и декодирование VAE, а также упаковка через FFmpeg. Сто минутных роликов обойдутся примерно в $0.63 вычислительных расходов на V100 по тарифу $0.188 в час и еще примерно в $0.09 за время настройки. Это только аренда GPU: инженерные часы, хранилище и операционные расходы сюда не входят.
На большом объеме разница становится очевидной почти сразу. Пятьсот минут озвученного видео — это примерно $3 аренды GPU при самостоятельном запуске MuseTalk и $1,200 за sync lipsync-2 по тарифу Creator.
В какой момент бесплатный вариант перестает быть бесплатным
Доплата за минуту дает вполне конкретные преимущества:
- Разрешение генерируемого лица. Согласно документации sync, lipsync-2 и lipsync-2-pro создают лица в разрешении 512x512 — вдвое больше области MuseTalk. sync-3 выводит видео в нативном 4K и использует встроенное суперразрешение.
- Сложные ракурсы. В той же документации указано, что sync-3 изначально умеет работать с профилем, съемкой через плечо и частично закрытым лицом, а также автоматически обнаруживает перекрытия. MuseTalk, напротив, выполняет детекцию лица на каждом кадре, поэтому повернутое лицо или рука перед ртом становятся типичными точками отказа.
- Несколько людей в кадре. Во всех трех актуальных моделях sync заявлена детекция активного говорящего. У MuseTalk аналогичного параметра нет.
- Время на настройку. При самостоятельном развертывании вы платите им один раз, но сумма получается далеко не символической.
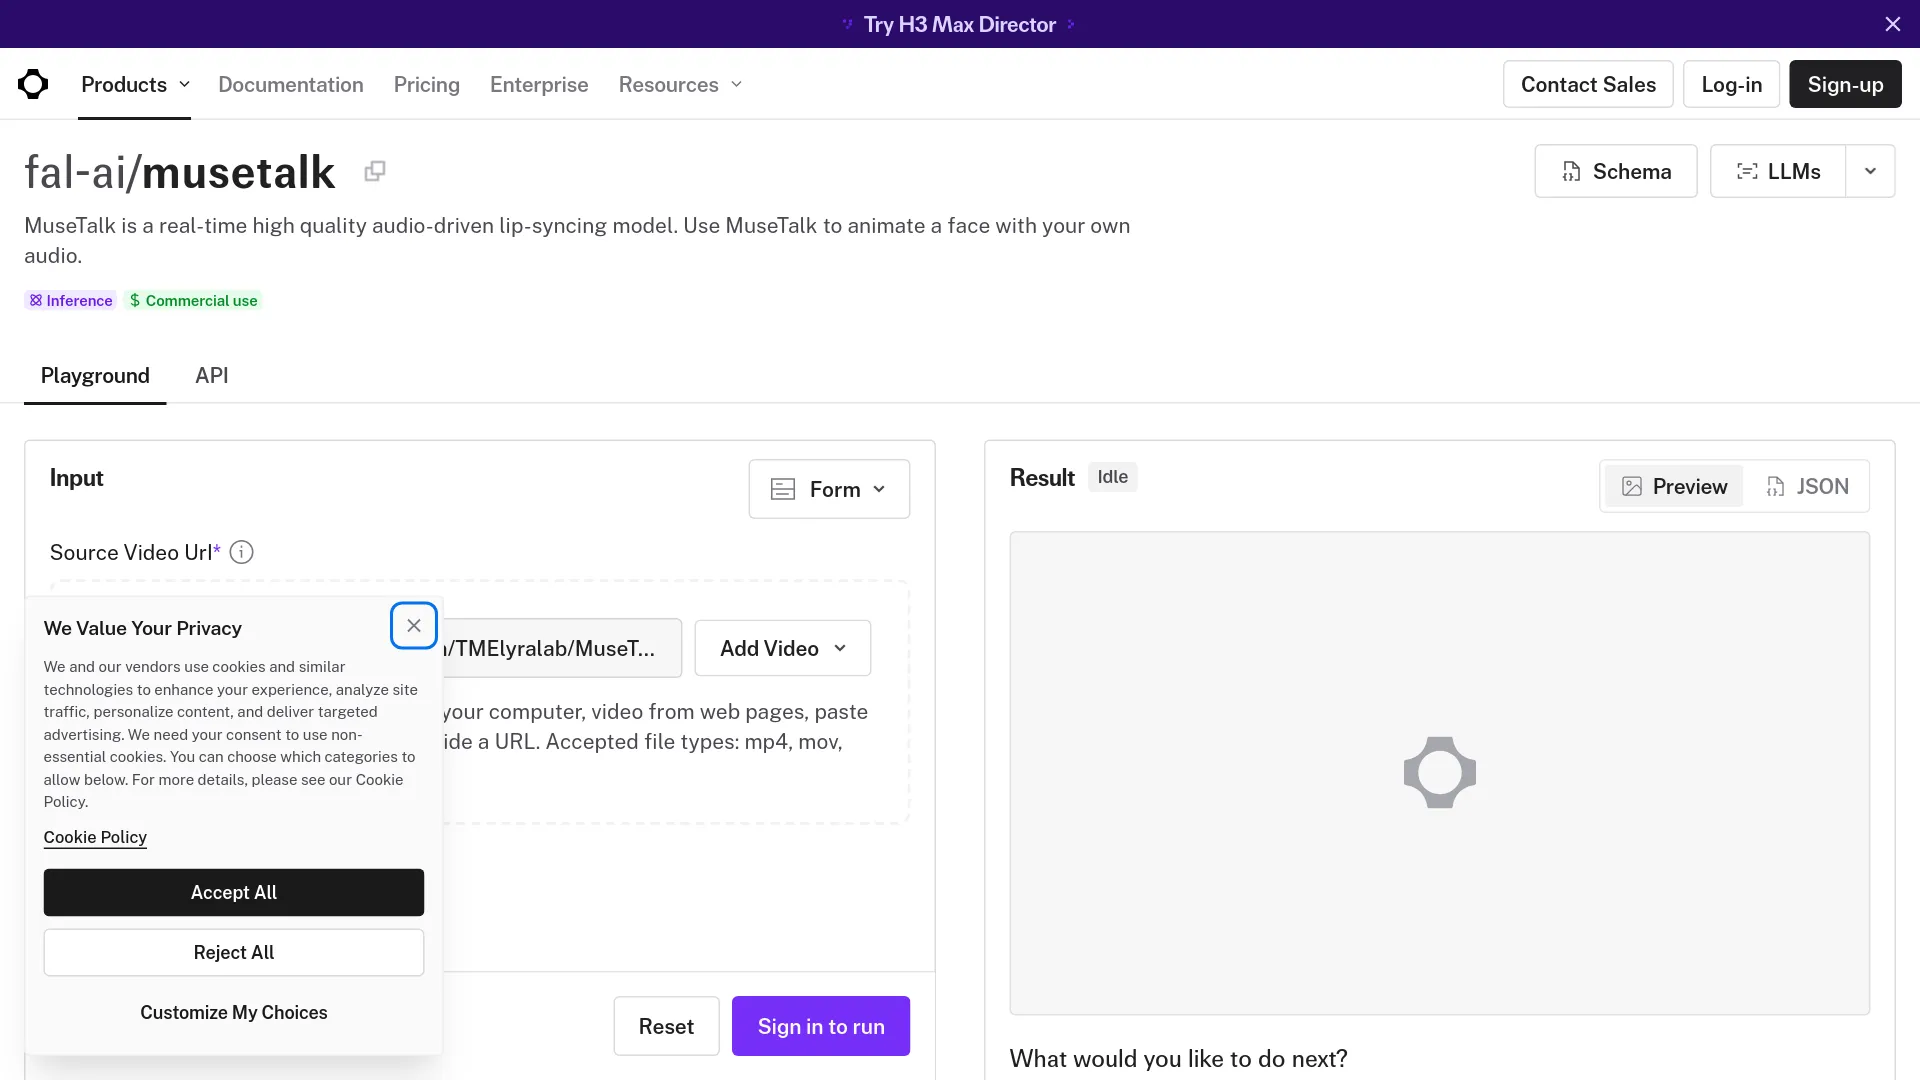
Страница MuseTalk на fal.ai хорошо показывает, за что вы платите в последнем пункте: URL видео, URL аудио — и больше ничего. Не нужно настраивать conda-окружение, подбирать версии CUDA и раскладывать веса по каталогам.
Как запустить MuseTalk и не утонуть в зависимостях
Повторяющаяся претензия к модели связана не с качеством результата, а со стеком OpenMMLab. Пользователь r/StableDiffusion, сравнивавший MuseTalk и LatentSync, сформулировал проблему предельно прямо:
«LatentSync и Musetalk работают и показывают похожий результат... Но Musetalk сложно настраивать, поскольку он зависит от библиотек OpenMMLab». — u/Traditional_Tap1708, r/StableDiffusion
Зафиксированные в README версии устанавливайте через mim, а не обычный pip:
- Создайте чистое conda-окружение с Python 3.10. В нем должны быть PyTorch 2.0.1, torchvision 0.15.2 и torchaudio 2.0.2.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0". Более свежая версия mmcv чаще всего и вызывает ошибки импорта mmdet.- Добавьте FFmpeg в
PATHи проверьте установку командойffmpeg -version. В Windows путь можно передать напрямую через--ffmpeg_path. - Запустите
sh download_weights.sh, чтобы скачать весь набор весов. Одного UNet недостаточно: скрипт также загружает sd-vae-ft-mse, Whisper,dw-ll_ucoco_384.pthдля DWPose и веса BiSeNet для парсинга лица. Если какого-то файла не хватает, это часто проявляется не ясной ошибкой, а сбоем детекции лица или смешивания изображения. - Преобразуйте исходник в 25 кадров/с командой
ffmpeg -i input.mp4 -r 25 output.mp4. Репозиторий рекомендует подавать видео именно с такой частотой, поскольку на ней обучалась модель. Несовпадение частоты кадров — самая частая причина рассинхронизации. - Укажите видео и аудио в
configs/inference/test.yaml, затем запуститеpython -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15.
Если вы снова и снова генерируете ролики с одним и тем же лицом, один раз включите preparation: true в configs/inference/realtime.yaml. После того как система сохранит coords.pkl, latents.pt и набор масок в results/v15/avatars/, верните значение на false. Параметр --skip_save_images важнее, чем может показаться: запись PNG на диск способна стать узким местом и замедлить обработку сильнее, чем сама модель.
MuseTalk 1.5 или 1.0: какие веса скачивать
Берите 1.5. В репозитории это последняя версия, датированная 28 марта 2025 года. Авторы связывают ее улучшения с perceptual-, GAN- и sync-loss, а также с двухэтапным обучением: модель лучше сохраняет четкость, идентичность и соответствие движений губ речи.
Единственная причина оставить 1.0 под рукой — параметр bbox_shift, который работает только с этой версией. Он вертикально двигает границу маски: положительные значения сильнее открывают рот, отрицательные — закрывают его.
Сначала запустите обработку со значением по умолчанию — скрипт выведет допустимый диапазон для вашего ролика. В примере из README получается диапазон [-9, 9], а оптимальным оказывается -7. Перерендеривайте ролик в пределах своего диапазона: смещайтесь в отрицательную сторону, если рот открывается слишком широко, и в положительную, если движения почти незаметны.
С какими сбоями вы столкнетесь и что можно исправить настройками
| Симптом | Причина | Можно исправить? |
|---|---|---|
| Обработка прерывается, лицо не найдено | На одном из кадров лицо повернуто, закрыто или отсутствует | Да. Обрежьте или удалите проблемный фрагмент |
| Рот почти не двигается | Голос тонет в музыке или граница маски расположена слишком высоко | Да. Выделите вокал; для v1.0 увеличьте bbox_shift |
| К середине ролика губы начинают отставать | Исходник не приведен к 25 кадрам/с | Да. Конвертируйте видео до обработки |
| Рот выглядит мягким на фоне резкого лица | Лицо слишком маленькое в кадре для области 256x256 | Частично. Увеличьте лицо кадрированием, отключите fp16, добавьте восстановление лица |
| Виден шов, усы не сохраняются | Синтез нижней части лица заменяет детали внешности | Нет. Это ограничение модели |
| Между кадрами появляется дрожание | Кадры генерируются независимо друг от друга | Частично. Авторы связывают двухэтапное обучение v1.5 с улучшением согласованности |
| Мультяшное или стилизованное лицо обрабатывается плохо | Модель обучалась на лицах реальных людей | Нет |
| Энергичная речь при неподвижном персонаже | MuseTalk не меняет движения головы и мимику | Нет. Нужно переснять или заменить исходный ролик |
Пользователь, тестировавший модель на видеокарте с небольшим объемом памяти, сообщил о результате «171s for 7 seconds of audio» и добавил, что она «only works with realistic images» (u/Bartholomheow, r/StableDiffusion). Заявленные «30 кадров в секунду в реальном времени» относятся к устойчивой скорости генерации после подготовки аватара, а не к задержке от загрузки файлов до готового результата. Разработчик, создающий говорящие головы в r/LocalLLaMA, также отметил, что для его интерактивного сценария «the preparation time is too long» (u/lonyPorgrammer).
Какой вариант синхронизации подойдет для вашей задачи
| Вариант | Когда выбирать | Главный компромисс |
|---|---|---|
| MuseTalk на собственном сервере | Большие объемы и предсказуемые исходники: черновики локализации, интерактивные аватары с одним лицом для тысяч аудиоклипов, внутреннее обучающее видео | Настройка занимает часы, а не минуты; скорость зависит от арендованной GPU |
| Размещенный MuseTalk (Replicate, fal.ai) | Нужно обработать несколько роликов или проверить качество на собственном материале до полноценного развертывания | То же ограничение 256x256, в схемах обоих API нет параметра кэширования аватара, оплата идет за запуск |
| Платная lipsync-модель (sync-3, lipsync-2-pro) | Клиентский контент, крупные планы, профильные ракурсы, перекрытия лица, несколько говорящих, выдача в 4K | $4–$8 за минуту, при этом видео покидает вашу инфраструктуру |
Чтобы воспроизвести заявленную официальную скорость, арендуйте V100, а для потоковой обработки в реальном времени — 4090. Работа с размещенными API подробнее разобрана в наших обзорах Replicate и fal.ai.
FAQ по MuseTalk lipsync
Запустится ли MuseTalk на видеокарте с 6 или 8 ГБ памяти?
Да. В README описан тест на ноутбучной RTX 3050 Ti с 4 ГБ видеопамяти в FP16, так что базовый инференс помещается даже в ограниченный объем VRAM. На практике сильнее ограничивает не запуск, а скорость.
256x256 — это разрешение готового видео?
Нет. Это редактируемая область лица, которая смешивается с видео и сохраняет исходные разрешение и частоту кадров.
Работает ли MuseTalk с мультяшными или аниме-лицами?
Нестабильно. Модель обучалась на реальных говорящих людях, а пользователи, проверявшие ее на стилизованных изображениях, сообщают о непредсказуемых результатах.
Входит ли препроцессинг в показатель «30 fps real time»?
Нет. Это скорость генерации на Tesla V100 после подготовки аватара. Детекция лица, кодирование латентов и первоначальное кэширование выполняются до этого этапа.
MuseTalk или LatentSync?
Выбирайте MuseTalk, если проект упирается в задержку и объем: одношаговый инференс и кэширование аватара сокращают затраты на каждый клип. Пользователь r/StableDiffusion, которого мы цитировали выше и который тестировал обе модели, назвал их производительность похожей. Значит, решающим фактором становится скорость, а не разница в качестве.
Можно ли использовать MuseTalk в коммерческих проектах?
Код репозитория распространяется по лицензии MIT, но у зависимостей разные условия. Whisper, VAE, DWPose, парсинг лица BiSeNet и SyncNet поставляются со своими лицензиями, а для примеров данных репозиторий отдельно указывает ограничения. Перед выпуском продукта проверьте каждую из них.
Компромисс, который эта цена пока не решает
MuseTalk почти бесплатно закрывает большую часть задачи. Но с сохранением идентичности при сложных условиях модель справляется не идеально: усы, точная форма губ, лицо крупным планом, поворот головы посреди фразы — все это быстро показывает ограничения.
Для большинства команд оптимальный ответ — не одна универсальная модель. Используйте MuseTalk для больших объемов, а платную модель оставьте для кадров, которые зритель будет рассматривать во весь экран.
Читайте также
- Обзоры Higgsfield AI и сравнение цен с доступом через API
- Руководство по локальной установке Kokoro 82M TTS — для генерации аудиодорожки, которую использует MuseTalk
- Руководство по Wan 2.2 Animate