 AIREITER
10 августа 2026 года Meta выпустила Muse Glimmer — плотную мультимодальную модель на 30B параметров. Сообщество локального ИИ сразу взялось выяснять, способна ли она заменить Qwen 3.6 27B на обычном пользовательском железе. Итог неоднозначный: модель помещается на одну RTX 3090 с полным контекстом 262K и развивает 236 токенов/с на RTX 5090 с DFlash. Однако в TerminalBench 2.1 она отстаёт от Qwen 3.6 27B на 9 баллов и нередко отказывается выполнять задачи по автоматизации на уровне ОС.
Muse Glimmer 30B: что это за модель
Muse Glimmer — мультимодальная плотная модель Meta Superintelligence Labs с 30B параметров, выпущенная по лицензии Apache 2.0. Её создавали не для верхних строчек в рейтингах программирования, а для постоянно работающих локальных агентных сценариев. В модели объединены текстовый декодер на 27,9B параметров, визуальный энкодер ViT на 1,9B и мультимодальный проектор на основе GELU — поэтому она умеет работать и с текстом, и с изображениями. Подробности архитектуры приведены по данным блога SGLang о поддержке в день релиза.
Ключевые особенности архитектуры
| Характеристика | Значение |
|---|---|
| Всего параметров | 30B |
| Текстовый декодер | 27,9B, плотный |
| Визуальный энкодер | ViT, 1,9B |
| Слои Transformer | 52 |
| Внимание | Grouped-query: 32 query-heads, 2 KV-heads — GQA 16:1 |
| Feed-forward | SwiGLU |
| Контекстное окно | 128K+ (протестировано до 262K) |
| Лицензия | Apache 2.0 |
В архитектуре используется гибридная схема внимания: после трёх слоёв sliding-window attention с окном 2 048 токенов следует слой внимания по всей последовательности; цикл повторяется каждые четыре слоя. Для локальных окон здесь применяется RoPE, а для полновнимательных слоёв — NoPE, что позволяет расширять контекст за пределы лимита обучения. Соотношение GQA 16:1 уменьшает KV-кеш: согласно замерам сообщества, 131K токенов в F16 занимают около 1,8 GiB. Поэтому на GPU с 24 GB модель удерживает полный контекст, тогда как Qwen 3.6 27B в той же F16-конфигурации ограничивается 70K токенов.
Какое железо нужно для Muse Glimmer
Всё в первую очередь зависит от выбранного квантования. SGLang предлагает официальные чекпойнты в форматах BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic и MLX 4-bit. Энтузиасты также довели модель до 2-битного GGUF для систем с особенно ограниченной VRAM.
Потребление VRAM в разных конфигурациях
| Конфигурация | Примерный объём VRAM | Целевое оборудование |
|---|---|---|
| BF16 | ~60 GB | Одна H100 |
| NVFP4 + MXFP8 | ~19,5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB для speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + контекст 262K | ~22–23 GB | RTX 3090 (24 GB) |
| 2-битный GGUF | ~14 GB | RTX 4060 Ti / младшие модели |
| MLX Q4 (Apple Silicon) | Общая память | Mac mini / MacBook Pro |
Пользователь Reddit показал, что Muse Glimmer в Q4_K_XL с спекулятивным декодированием DFlash, файлом мультимодальной проекции и F16 KV-кешем уверенно занимает 22–23 GB на одной RTX 3090. При этом активен весь контекст в 262 144 токена. В тесте модель с первой попытки нашла две «иголки» в «стоге сена» объёмом около 150K токенов.
Для сравнения: Qwen 3.6 27B на той же RTX 3090 достигает лишь 70K токенов с F16 KV-кешем либо 125K с Q8 KV-кешем. У Gemma 4 31B это 52K в F16 или 81K в Q8. Главное преимущество Muse Glimmer здесь даёт эффективный KV-кеш благодаря GQA 16:1.
Варианты запуска: на NVIDIA используйте SGLang или llama.cpp с чекпойнтом NVFP4 либо GGUF и включите --speculative-algorithm DFLASH. На Apple Silicon выбирайте MLX-бэкенд — DFlash там недоступен. Пользователь M3 Max с 96 GB общей памяти сообщил о скорости 17 токенов/с; по его словам, Muse Glimmer на этой системе была быстрее и Qwen, и Gemma.
Скорость Muse Glimmer в бенчмарках
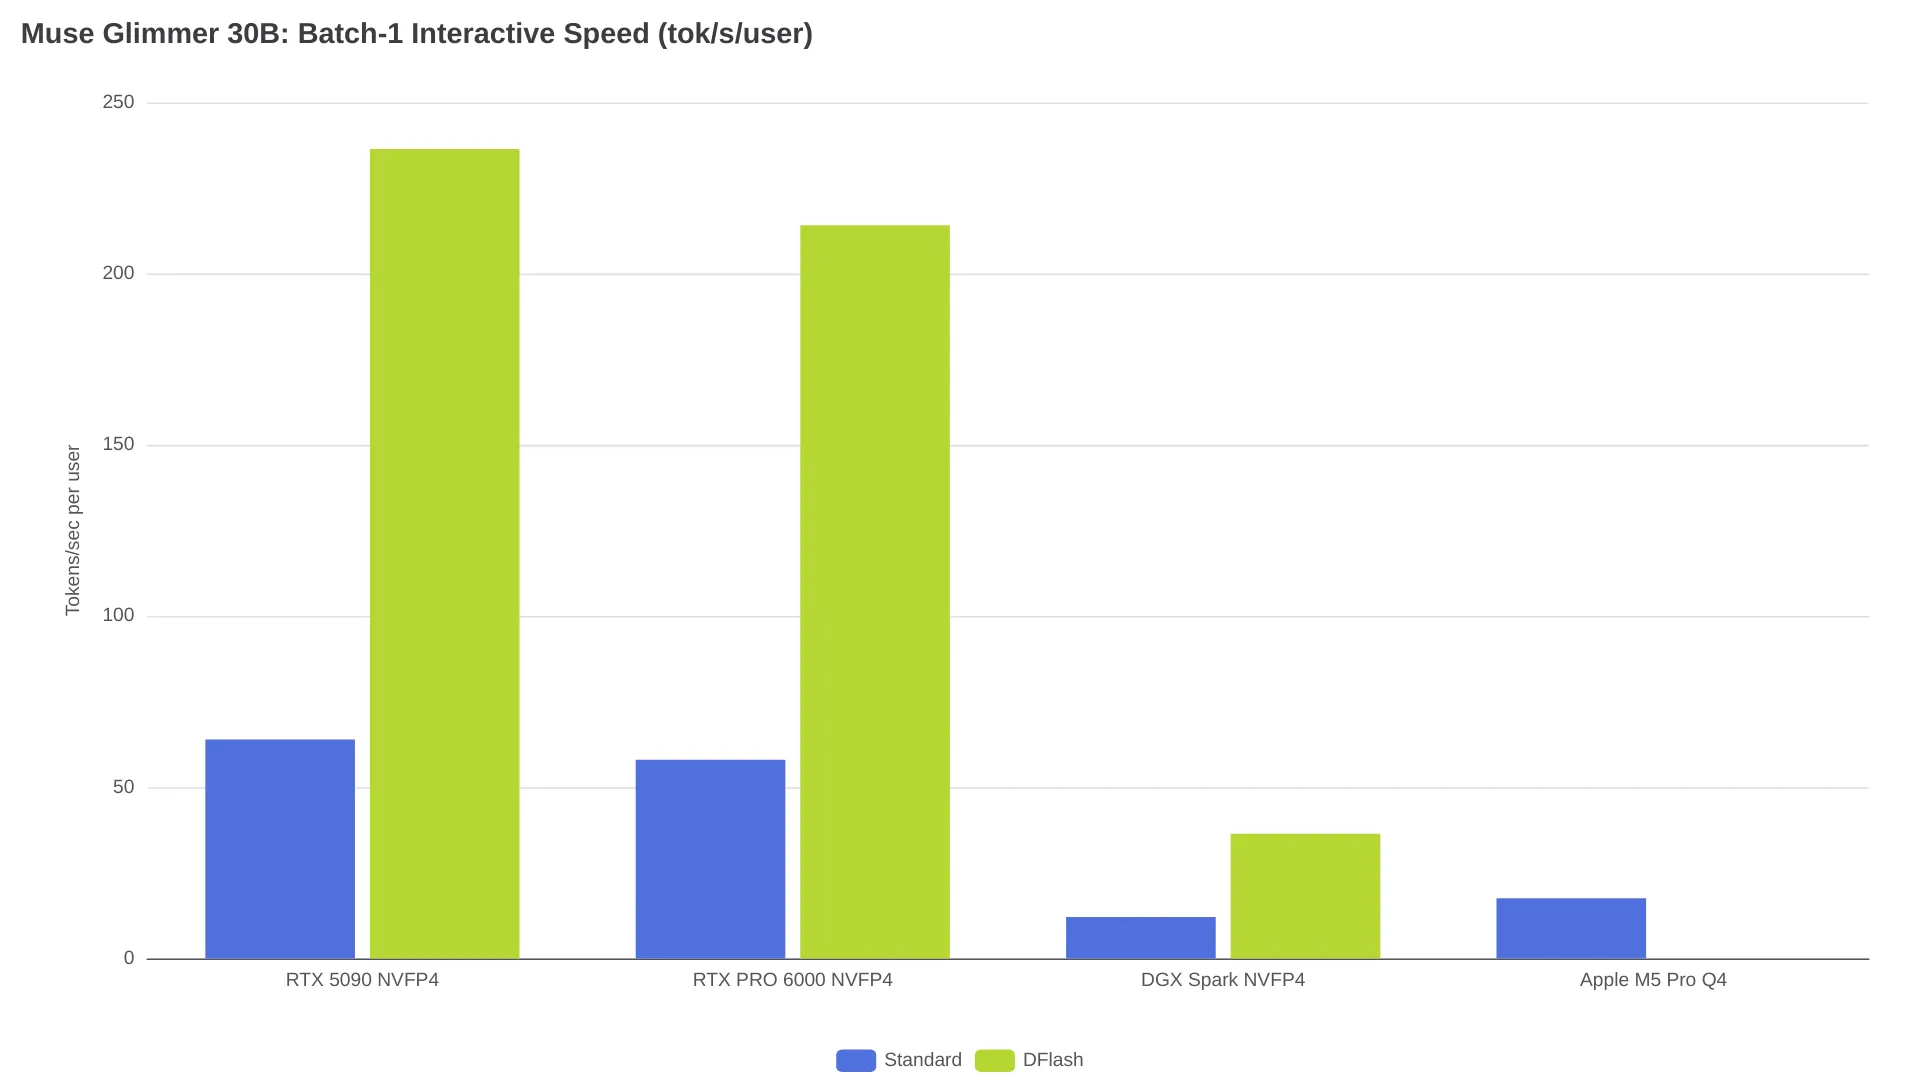
SGLang опубликовал результаты тестов на семи аппаратных конфигурациях с batch size от 1 до 8. Спекулятивное декодирование DFlash, включаемое параметром --speculative-algorithm DFLASH, повышает интерактивную производительность при batch 1 на NVIDIA-платформах в 1,9–4,3 раза.
Главные результаты SGLang
| Платформа | Точность | Декодирование | Batch 1, токенов/с на пользователя | Batch 8, токенов/с |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Стандартное | 17.6 | 56.9 |
Показатель 1 452 выходных токена/с на RTX 5090 при batch 8 — это суммарная пропускная способность. Для локального инференса одним пользователем важнее 236 токенов/с: такую скорость даёт NVFP4 с DFlash. Без DFlash тот же вариант замедляется до 63,9 токена/с. Замеры сообщества это подтверждают: пользователь RTX 5090 с квантованием Unsloth Q5_K_M получил 220–253 токена/с.
Эффективность DFlash определяется долей принятых черновых токенов. Пользователи Vulkan/RX 7900 XTX и SYCL/B70 сообщали о низком принятии черновиков и, как следствие, более низкой общей скорости.
Muse Glimmer или Qwen 3.6 27B: что выбрать
Результаты TerminalBench 2.1
| Модель | TerminalBench 2.1 | Контекст на RTX 3090 (F16 KV) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K токенов |
| Muse Glimmer 30B | 51.7 | ~262K токенов |
| Gemma 4 31B | 43.4 | ~52K токенов |
Баллы TerminalBench 2.1 приведены в обсуждении сообщества. Данные о контексте — из тестов на RTX 3090.
В TerminalBench 2.1 Qwen 3.6 27B опережает соперника на 9 баллов. Именно этот бенчмарк многие участники сообщества считают важнейшим показателем того, сможет ли модель надёжно выполнять команды в терминале на длинной последовательности действий. В прямых тестах программирования разрыв сохраняется: в частном наборе оценок одного пользователя Qwen набрала 12/13 против 11/13 у Glimmer. Кроме того, Qwen с первой попытки корректно сгенерировала страницу о туризме в Токио на 953 строки, тогда как Glimmer выдала менее 200 строк (полное обсуждение).
«Даже близко не Qwen 3.6 27B» — так пользователь Reddit BarberIcy366 оценил Glimmer после того, как модель выдала лишь 220 строк HTML для игры в пул-восьмёрку, израсходовав 21 000 токенов (r/LocalLLaMA). В той же ветке есть сообщение, что Qwen 3.6 27B реализовала Tetris в 1,7 раза быстрее при включённом MTP.
Впрочем, у Glimmer есть реальные преимущества в отдельных сценариях:
- Объём контекста: 262K токенов на одной RTX 3090 против 70K у Qwen с тем же F16 KV-кешем — преимущество в 3,7 раза при работе с крупными кодовыми базами.
- Экономный KV-кеш: соотношение GQA 16:1 заметно сокращает KV-кеш и оставляет больше VRAM под контекст.
- Работа с изображениями: Glimmer мультимодальна из коробки, тогда как базовая Qwen 3.6 27B работает только с текстом.
- MCP и ответы через инструменты: один пользователь отметил, что Glimmer уступает Qwen в терминальном программировании, но перспективна для поиска по кодовой базе и ответов на вопросы с помощью MCP.
- Качество текста: несколько пользователей предпочли естественность текстовых ответов Glimmer стилю Qwen.
Один из комментаторов описал компромисс так: Glimmer — это «Qwen 3.6 27B, плюс 5% к стилю письма и минус 5% к агентным возможностям».
Вывод
Если вам прежде всего нужны разовое написание кода или автономные терминальные агенты, более сильным выбором остаётся Qwen 3.6 27B: она набрала на 9 баллов больше в TerminalBench 2.1 и не страдает от отказов по безопасности, которые мешают Glimmer в автоматизации на уровне ОС. Если же на одной пользовательской GPU нужны поиск в длинном контексте, мультимодальный ввод или сценарии с MCP, Muse Glimmer стоит протестировать. Для надёжной автоматизации терминала лучше дождаться дообученных версий от сообщества.
Известные проблемы и нюансы
Не занижайте max_tokens
Перед ответом Muse Glimmer расходует заметную часть токенов на внутреннее рассуждение. При слишком низком значении max_tokens бюджет может закончиться посреди мысли, и модель вернёт пустой ответ. Один пользователь поначалу получил для Glimmer 6/13 в своём наборе оценок, но после увеличения лимита выходных токенов результат вырос до 11/13 (исходная ветка). Задавайте max_tokens с запасом на рассуждение, иначе ответы могут обрываться на полуслове.
Отказы при автоматизации на уровне ОС
Несколько пользователей сообщают, что Muse Glimmer отказывается от задач, связанных с управлением мышью, автоматизацией клавиатуры и другими вызовами инструментов на уровне ОС. Модель воспринимает их как потенциальные угрозы безопасности, даже если запрос предполагает стандартные библиотеки Python.
«Программное перемещение мыши может использоваться во вредоносных целях: для автоматизации, clickjacking или обхода запросов безопасности». — отказ Muse Glimmer, приведённый пользователем Reddit Cold_Tree190 (r/LocalLLaMA)
Иногда помогает начать новую сессию и подробнее объяснить предполагаемый сценарий использования. Но если в текущей сессии модель уже отказалась, она обычно не меняет позицию.
Нестабильные вызовы инструментов
Отзывы сообщества о надёжности tool calling противоречивы: у одних модель «ни разу не подвела» на кодовой базе C, у других возникают бесконечные циклы и пустые ответы API. В отдельных конфигурациях кванты Unsloth Q4 и Q5 часто зацикливались при вызове инструментов, тогда как официальные GGUF, рассчитанные на 24 GB и 32 GB VRAM, могут вести себя надёжнее (исходная ветка).
Региональные ограничения на загрузку
Сообщается, что на официальной странице Hugging Face отключена загрузка для Гонконга, Макао и Китая. Альтернативой остаются сторонние GGUF-сборки от Unsloth.
Читайте также: цены API Muse Spark 1.2 | лучшие бесплатные модели OpenRouter для программирования в 2026 году