 AIREITER
Оригинальный репозиторий facebookresearch/demucs с 1 января 2025 года доступен только для чтения. Но Demucs по-прежнему остаётся одним из лучших бесплатных инструментов для разделения трека на стемы на своём компьютере — если ставить его из форка с версией v4.1.0 и помнить, что сильнее всего модель сдаёт на гитаре и фортепиано.
Ставьте Demucs из актуального репозитория, а не из архивного
На GitHub есть два репозитория с одинаковым README, но исправления по-прежнему получают только в одном. facebookresearch/demucs архивирован и доступен только для чтения; в его README прямо указано, куда переходить дальше. Актуальный репозиторий — adefossez/demucs. Автор проекта Alexandre Défossez пишет, что теперь это «официально поддерживаемый Demucs после моего ухода из Meta в Kyutai», но сразу предупреждает: «ответы могут быть медленными, а новых функций пока не будет».
Разница между репозиториями влияет не только на ссылку: меняются и команды установки.
Что изменилось в v4.1.0
В записи релизов от 11/07/2026 Demucs v4.1.0 описывается как версия с «обновлённой упаковкой, более лёгкими зависимостями для инференса, многочисленными исправлениями и предобученными моделями на Hugging Face». На практике это означает следующее:
| Параметр | Архивный репозиторий | Актуальный репозиторий (v4.1.0) |
|---|---|---|
| Минимальная версия Python | 3.8 | 3.10 |
| Самый быстрый запуск | pip install -U demucs | uvx demucs MY_TRACK.mp3 (устанавливать ничего не нужно) |
| Постоянная установка | pip install -U demucs | uv tool install demucs (pip по-прежнему работает) |
| ffmpeg | Обязателен | Не обязателен, но нужен для вывода в FLAC и форматов, которые sphn не умеет декодировать |
| Квантованные модели | Включены | Требуют дополнительной зависимости: uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| Где хранятся веса | dl.fbaipublicfiles.com | Hugging Face |
Есть и важное ограничение, о котором стоит знать до отправки баг-репорта: PyTorch прекратил поддержку Intel Mac после версии 2.2. Поэтому пользователям Mac на Intel доступна максимум Python 3.12, а запускать Demucs им рекомендуют командой uvx --python 3.12 demucs.
Какую модель выбрать: htdemucs, htdemucs_ft, htdemucs_6s или mdx
Модель выбирается флагом -n, и вариант по умолчанию подходит не всегда. В Demucs есть модели на четыре источника — ударные, бас, прочее и вокал, экспериментальная модель на шесть источников, а также более старые модели MDX, созданные для соответствующего конкурса.
| Модель | Источники | Скорость | Официальная оговорка | Когда выбирать |
|---|---|---|---|---|
htdemucs | 4 | Базовая (по умолчанию) | нет | Для первого прогона, пакетной обработки и всего, где важна скорость |
htdemucs_ft | 4 | Примерно в 4 раза медленнее | «может быть немного лучше» | Для финального рендера важного трека |
htdemucs_6s | 6 | Между двумя предыдущими | Гитара — «приемлемо», фортепиано — «работает не очень хорошо», с «множеством протечек и артефактов» | Если нужен отдельный гитарный стем и вы готовы мириться с артефактами |
hdemucs_mmi | 4 | Базовая | Архитектура v3, переобученная | Для сравнения, если v4 плохо звучит на конкретном миксе |
mdx / mdx_extra | 4 | Базовая | mdx_extra обучалась на данных, включавших тестовый набор MUSDB | Для старого материала или если артефакты v4 мешают |
mdx_q / mdx_extra_q | 4 | Самые быстрые и компактные | «качество может быть немного хуже» | Для компьютеров с небольшим объёмом памяти и быстрых превью |
Обратите внимание на осторожную формулировку про htdemucs_ft: вычислений требуется в четыре раза больше, а прирост качества сам автор описывает лишь как возможный. На CPU это особенно болезненно — пользователи прямо об этом пишут.
Что на самом деле означают показатели SDR 9,00 и 9,20 дБ
Оба числа встречаются в одном и том же README, но это не взаимозаменяемые результаты. Hybrid Transformer Demucs достигает 9,00 дБ SDR на тестовом наборе MUSDB HQ. Более высокий результат — 9,20 дБ — требует разреженных ядер внимания и дообучения для каждого источника. При этом разреженная модель «не предоставляется, поскольку для неё нужен нестандартный код CUDA, ещё не готовый к выпуску».
Иными словами, ни одну доступную для скачивания модель нельзя запустить так, чтобы воспроизвести результат 9,20 дБ. В собственной сравнительной таблице README дообученная версия v4 показывает общий SDR 9,0 — столько же, сколько Band-Split RNN, обученная на 1,7 тыс. миксов.
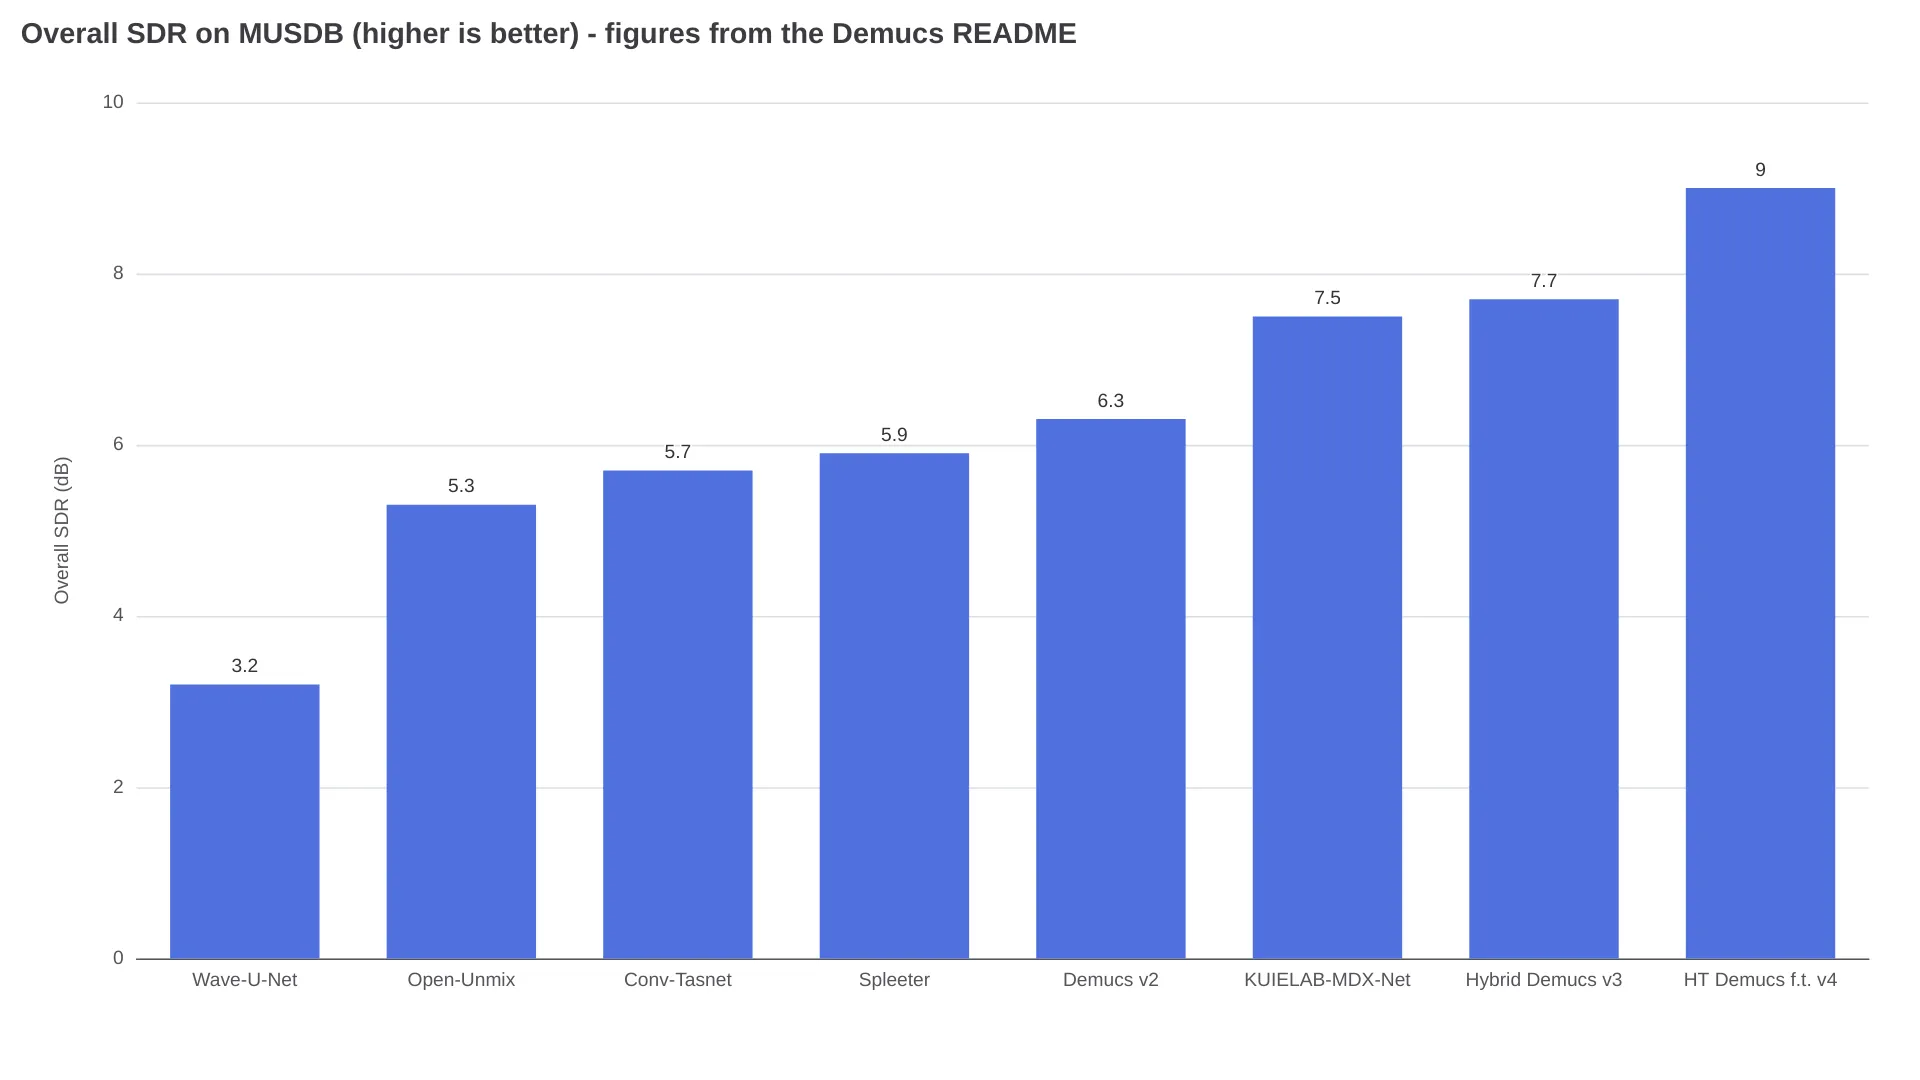
В той же таблице Spleeter получает 5,9 дБ, хотя обучался на 25 тыс. песен. Разрыв с дообученной v4 составляет примерно 3 дБ.
Флаги, которые меняют результат
В большинстве случаев при запуске Demucs нужно принять три решения: сколько стемов получать, сколько вычислительных ресурсов потратить и в каком формате сохранить результат.
--two-stems=vocalsвключает караоке-режим: на выходе будутvocals.wavиno_vocals.wav. Сначала Demucs разделяет полный микс, а затем сводит результат, поэтому такой режим не быстрее и не экономнее обычного запуска.--shifts=Nусредняет N предсказаний для входного сигнала со случайными сдвигами. Обработка становится в N раз медленнее; в README советуют «не использовать этот параметр без GPU». В исследовании применялось 10 сдвигов, а в размещённой версии на Replicate по умолчанию используется 1.--overlapпо умолчанию равен 0.25. Его можно снизить до 0.1, немного выиграв в скорости.--segment N— главный рычаг против ошибки OOM. Но здесь есть деталь, из-за которой скопированные команды часто не работают как ожидается: модели Hybrid Transformer поддерживают максимальную длину сегмента 7,8 секунды. Поэтому большое значение--segmentимеет смысл только для моделей без HT.- Флаги формата — это
--mp3(по умолчанию 320 кбит/с),--flac(требует ffmpeg),--int24и--float32. По умолчанию Demucs сохраняет WAV в int16 с частотой 44,1 кГц в каталогеseparated/MODEL_NAME/TRACK_NAME. --clip-modeважнее, чем может показаться. По умолчанию Demucs масштабирует стемы, чтобы избежать клиппинга, но из-за этого может нарушиться относительная громкость между ними. В режимеclampвместо этого используется жёсткое ограничение уровня.
Требования к железу из той же документации такие: минимум 3 ГБ видеопамяти, около 7 ГБ с настройками по умолчанию. Если у вас 3 ГБ или меньше, используйте --segment 8 вместе с PYTORCH_NO_CUDA_MEMORY_CACHING=1. Для CPU документация обещает, что «время обработки должно быть примерно в 1,5 раза больше длительности трека». Рядом с отзывами о htdemucs_ft это выглядит довольно оптимистично.
Где Demucs ошибается и как пользователи исправляют это в два прохода
О протечках в соседние стемы пользователи говорят постоянно. Особенно заметны они, когда вокал и ведущий инструмент находятся в одном регистре. Ryan Herr (@rrherr) описал результат одной из попыток так:
demucs let a lot of sax bleed into the 'vocals' track.
Опытные пользователи обычно решают проблему не дополнительным флагом, а второй моделью. Японский продюсер 夜凪P (@yonagip, 145 лайков) сначала запускает MelBand Roformer в UVR5, чтобы отделить вокал от инструментальной части, а затем передаёт инструментал в htdemucs_ft для разделения ударных, баса и прочего:
Demucs単体だとVoが他に漏れるんだけど (при использовании только Demucs вокал протекает в другие стемы)
Ещё два пользовательских отчёта указывают в том же направлении. Один продюсер отмечает более чёткий бас у htdemucs_ft, но говорит, что на CPU обработка в четыре раза медленнее (@hachi_vm). Другой опубликовал сравнение извлечения гитары, в котором htdemucs-6s заметно проигрывает модели BS-RoFormer (@junon_12). Это отдельные пользовательские наблюдения, а не бенчмарки, но они совпадают с официальным описанием: когда Défossez представлял шестиисточниковую модель в декабре 2022 года, он писал, что заметил «некоторые протечки и артефакты».
Практическое правило: если в записи есть саксофон, ведущая гитара или мелодическая партия фортепиано, считайте результат одного прохода Demucs отправной точкой, а не готовым материалом. Модели класса Roformer доступны через интерфейс UVR5 и подходят для второго прохода.
Как использовать Demucs через API, не устанавливая его
Если нужен результат без настройки Python-окружения, можно воспользоваться популярной размещённой версией cjwbw/demucs на Replicate. Она работает на Nvidia T4, насчитывает примерно 1,5 млн запусков, а сама страница оценивает стоимость примерно в $0.020 за запуск (около 50 запусков за доллар). Обычно предсказания завершаются менее чем за 90 секунд.
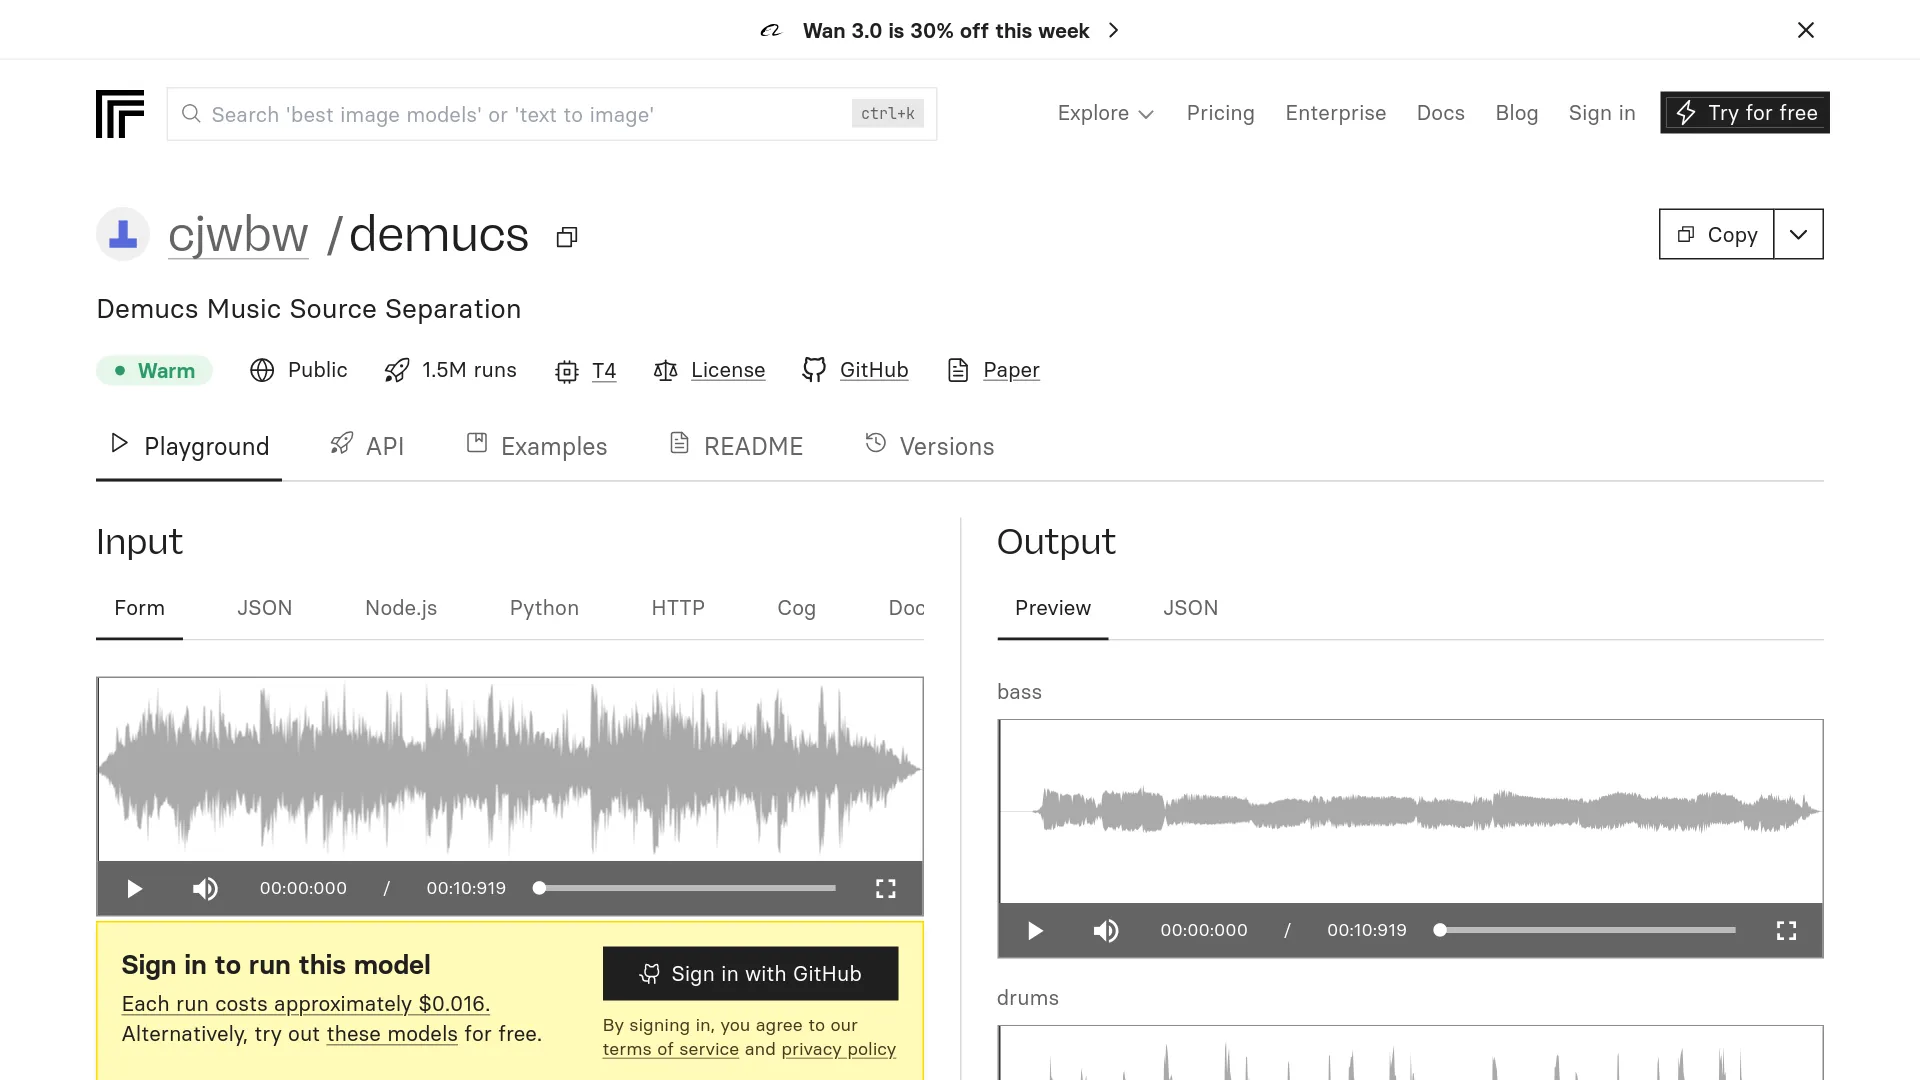
Схема входных параметров повторяет CLI: model_name (по умолчанию htdemucs), stem, shifts (по умолчанию 1), overlap (0.25), clip_mode (rescale), mp3_bitrate (320), float32, output_format (mp3).
Есть нюанс, о котором страница сама не предупреждает: последняя версия датирована примерно тремя годами ранее, а размещённая конечная точка использует зафиксированный снимок. Вы обращаетесь именно к этой сборке, а не к упаковке и зависимостям v4.1.0, выпущенным в июле 2026 года. Время работы тоже может заметно отличаться от рекламной цифры: один общедоступный пример на той же модели выполнялся 6 минут 18 секунд.
Во сколько на самом деле обходится обработка четырёхминутного трека
Для выбора рабочего процесса важнее всего стоимость обработки одного трека. И здесь есть деталь биллинга, с которой многие сталкиваются уже после оформления подписки.
LALAL.AI считает расход так: длина файла × количество выбранных типов разделения стемов. Поэтому четырёхминутная песня, разделённая на четыре стема, расходует 16 минут, а не 4.
На той же странице тарифов указаны разовые пополнения (проверено 25 сентября 2026 года): $50 за 750 минут Fast Queue, $190 за 3 000 минут и $300 за 5 000. При таких ставках разделение четырёхминутной песни на четыре стема стоит от $0.96 до $1.07.
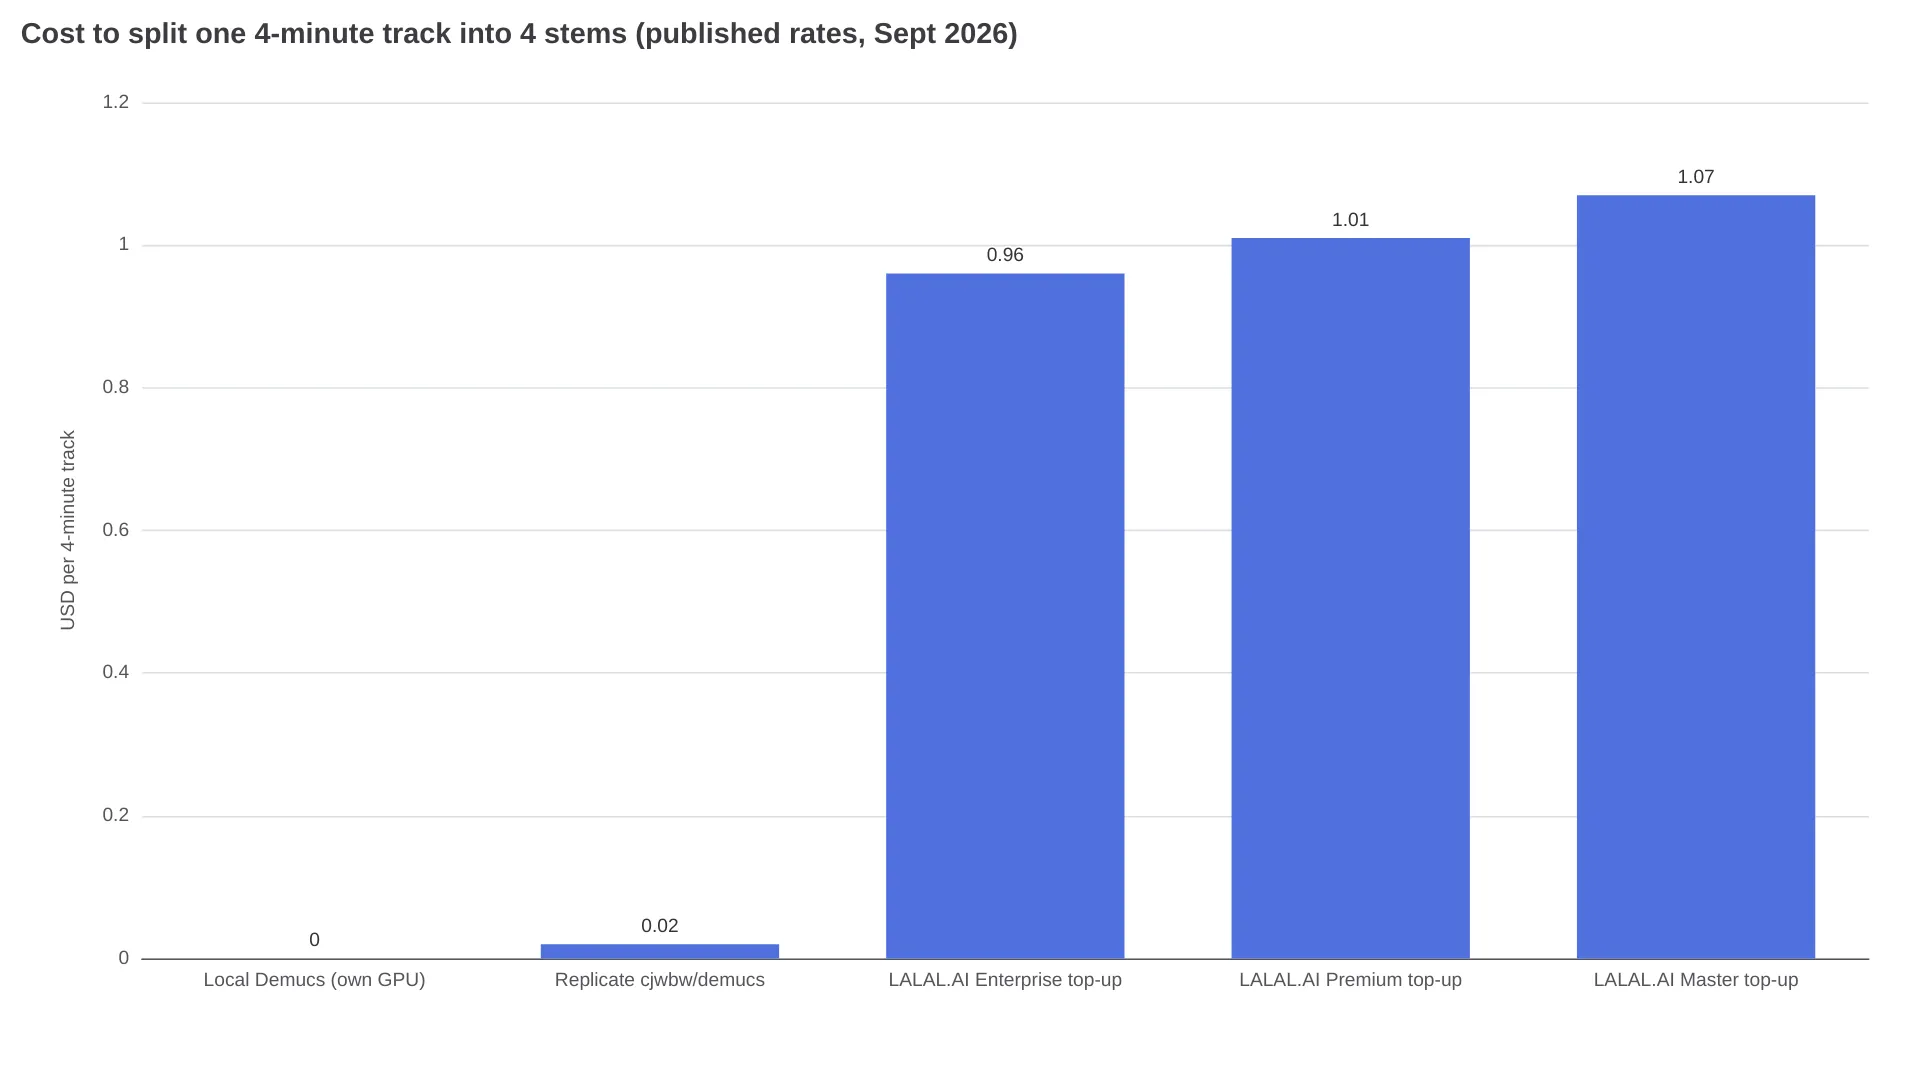
Но эту диаграмму нужно читать с одной поправкой: суммы LALAL.AI относятся к обработке с приоритетом. В платные планы входят безлимитные минуты Relaxed Queue, а компания заявляет, что обе очереди «обеспечивают одинаковое качество разделения». Fast Queue просто сокращает время ожидания.
| План | Цена | Что входит | Основные ограничения |
|---|---|---|---|
| LALAL.AI Starter | Бесплатно | 10 минут Relaxed Queue | Ограничение загрузки — 200 МБ |
| LALAL.AI Lite | €6.75/мес., €81 при оплате за год | Безлимитная Relaxed Queue, 90 минут Fast Queue | Нет пакетной обработки, VST и API; минуты не переносятся |
| LALAL.AI Pro | €13.50/мес., €162 при оплате за год | Безлимитная Relaxed Queue, 250 минут Fast Queue | Единственный тариф с API, VST-плагином и пакетной обработкой |
| Moises | Публично не указана | Бесплатный тариф с ограниченным числом загрузок в месяц | Таблица тарифов доступна после входа; заявлено 27 типов стемов |
Replicate cjwbw/demucs | ~$0.020/запуск | T4, обычно менее 90 с | Версия зафиксирована примерно на уровне трёхлетней давности |
| Локальный Demucs | Бесплатно (лицензия MIT) | Без ограничений, офлайн | Время работы вашей видеокарты и настройка окружения |
90 минут Fast Queue в тарифе Lite хватит примерно на пять четырёхминутных треков, разделённых на четыре стема, после чего придётся перейти в очередь с обычным приоритетом. Если обрабатывать больше нескольких песен в неделю, поминутная оплата быстро перестаёт быть выгодной. Именно на таком объёме установка Demucs начинает окупать один свободный вечер.
Какой вариант выбрать под конкретную задачу
| Ситуация | Оптимальный вариант | Почему |
|---|---|---|
| Редкие разделения, нет GPU и желания работать в терминале | LALAL.AI Starter, затем Lite | 10 бесплатных минут позволяют проверить качество до оплаты |
| Разучивание песен, практика прежде всего со смартфона | Moises | 27 типов стемов, а также инструменты для темпа и аккордов; цену нужно проверять после входа |
| Большие объёмы, собственная видеокарта | uvx demucs с htdemucs | Нулевая стоимость каждого запуска, неограниченная обработка, файлы не покидают компьютер |
| Один важный финальный рендер | htdemucs_ft, --shifts 2 на GPU | Дополнительная доля качества за счёт вычислений, которых требуется в 4 раза больше |
| Нужен гитарный стем | Сначала htdemucs_6s, затем сравнить с моделью класса Roformer в UVR5 | Официальная документация признаёт наличие протечек у шестиисточниковой модели |
| Неразрелизный или защищённый соглашением NDA материал | Только локальный Demucs | Нет загрузки в облако, лицензия MIT, обработка офлайн |
| Бэкенд приложения, нет бюджета на инфраструктуру | Replicate cjwbw/demucs | ~$0.020 за запуск и никакого собственного GPU-кластера |
FAQ о разделении на стемы в Demucs
Какая модель Demucs лучше всего отделяет вокал?
htdemucs_ft — самая сильная из доступных четырёхисточниковых моделей для вокала. Обработка занимает примерно в четыре раза больше времени, чем у htdemucs. На сложных миксах пользователи сообщают о лучших результатах при разделении в два прохода: сначала модель класса Roformer отделяет вокал, затем Demucs разбирает инструментальную часть.
Умеет ли Demucs отделять гитару и фортепиано?
Только с помощью htdemucs_6s. В официальном README качество гитарного стема в быстром тесте названо «приемлемым», а про фортепиано сказано, что оно «работает не очень хорошо», с «множеством протечек и артефактов».
Нужна ли для Demucs видеокарта NVIDIA?
Нет. Demucs работает на CPU с флагом -d cpu, а документация оценивает время обработки примерно в 1,5 длительности трека. На Apple Silicon можно использовать -d mps. Для ускорения на GPU требуется минимум 3 ГБ видеопамяти, а с настройками по умолчанию — около 7 ГБ.
Почему разделённые стемы не складываются обратно в исходный микс?
Demucs масштабирует каждый стем, чтобы предотвратить клиппинг, вызванный артефактами разделения. Из-за этого может нарушиться относительная громкость стемов. Используйте --clip-mode clamp для жёсткого ограничения уровня или уменьшите громкость исходного микса перед обработкой.
Куда Demucs сохраняет стемы?
В каталог separated/MODEL_NAME/TRACK_NAME/ в виде стереофайлов WAV с частотой 44,1 кГц и кодированием int16: drums.wav, bass.wav, other.wav и vocals.wav, если отдельно не запросить вывод в MP3, FLAC, int24 или float32.
Как исправить ошибку CUDA out of memory?
Уменьшите значение --segment (для видеокарт с 3 ГБ документация указывает 8 как нижнее значение), задайте PYTORCH_NO_CUDA_MEMORY_CACHING=1 или переключитесь на -d cpu. Помните, что для моделей Hybrid Transformer длина сегмента ограничена 7,8 секунды, поэтому увеличение значения выше этого порога ничего не даст.