 AIREITER
O nome sugere ausência de limites, mas o arquivo de configuração do modelo da Baidu define max_position_embeddings como 32.768. Esse é o dado mais importante para planejar uma implantação: o Unlimited OCR troca o OCR tradicional, feito página por página, por uma única passagem de inferência — desde que o documento caiba no orçamento de 32K tokens e os scans tenham qualidade razoável.
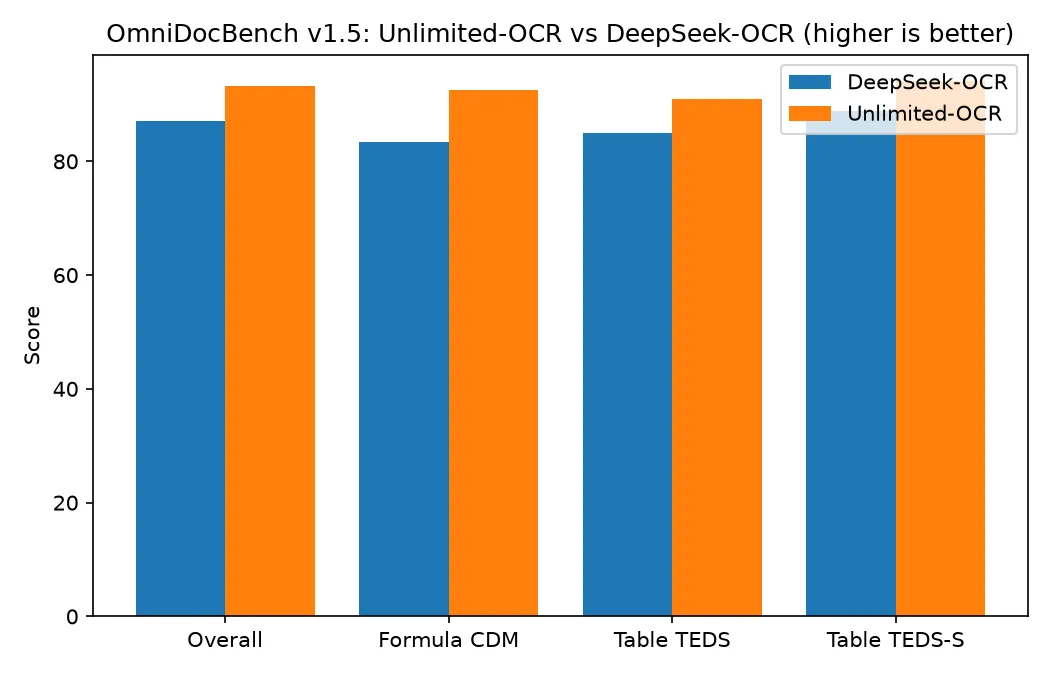
A ressalva não diminui o peso do lançamento. Os pesos usam licença MIT, os metadados do safetensors registram 3.336.106.240 parâmetros em BF16, e o modelo obtém 93,23 no OmniDocBench v1.5, contra 87,01 do DeepSeek-OCR que serviu de base. Em 2026-07-29, a página no Hugging Face mostrava 2.694.935 downloads nos 30 dias anteriores e 3.389 likes.
O limite por trás do “Unlimited”
No processamento de múltiplas páginas, cada página é codificada em 1024×1024 e comprimida 16 vezes, chegando a cerca de 256 tokens visuais. Com isso, dá para calcular o orçamento de páginas antes mesmo de escrever código.
| Páginas em uma passagem | Tokens visuais (prefill) | Tokens restantes para saída | Orçamento por página |
|---|---|---|---|
| 10 | ~2.560 | ~30.200 | ~3.020 |
| 20 | ~5.120 | ~27.600 | ~1.380 |
| 40 | ~10.240 | ~22.500 | ~560 |
Uma apresentação ou um contrato pouco denso comporta 40 páginas sem dificuldade. Já uma página de jornal densa, com duas colunas, pode passar sozinha de 560 tokens em markdown; nesse tipo de material, o teto prático fica bem abaixo de 40 páginas. O artigo deixa isso claro: com uma janela de contexto finita, o parsing não pode ser realmente ilimitado, porque o prefill continua crescendo conforme entram mais páginas. O roadmap da Baidu prevê uma versão com contexto de 128K e um “prefill pool” para buscar blocos de páginas sob demanda. Na prática, o nome se refere a um decode sem limite em relação ao tamanho do cache, não a uma quantidade infinita de páginas.
O que o R-SWA muda — e o que continua igual
Em relação ao DeepSeek-OCR, houve duas mudanças. A pilha visual DeepEncoder, uma cascata de SAM-ViT-B com CLIP-L, foi mantida e congelada durante o treinamento. Já todas as camadas de atenção do decoder foram substituídas por Reference Sliding Window Attention: cada token gerado atende a todos os tokens de referência — os tokens visuais e o prompt —, mas apenas aos últimos 128 tokens de saída. O config.json confirma: sliding_window_size: 128, 12 camadas de decoder, 64 experts roteados e 6 ativos por token.
Os ganhos aparecem em várias frentes, especialmente nas partes de uma página que exigem geração mais longa. No OmniDocBench v1.5, o CDM de fórmulas subiu de 83,37 para 92,61, enquanto o TEDS de tabelas passou de 84,97 para 90,93. A distância de edição da ordem de leitura caiu pela metade, de 0,086 para 0,045. Como o encoder não foi retreinado, essas diferenças vêm da mudança no decoder, e não de uma pilha visual mais forte.
Isso também significa que os problemas do encoder permanecem. Uma geração mais longa não melhora o reconhecimento de caracteres em um fax desbotado.
O ganho de velocidade aparece em saídas longas
Com 256 tokens de saída, os dois modelos são praticamente idênticos: 7.229,52 contra 7.229,32 tokens por segundo. A diferença surge conforme a geração se prolonga. Em 6.144 tokens de saída, o modelo-base cai para 5.822,87, enquanto o Unlimited OCR sustenta 7.847,71 tokens por segundo — cerca de 35% mais rápido.
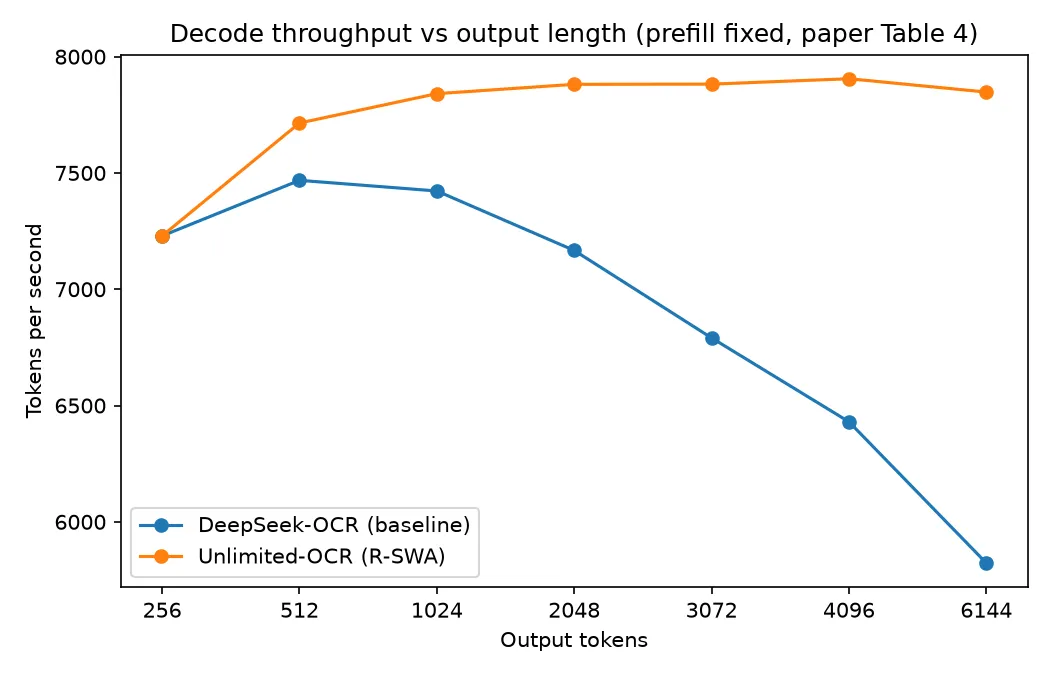
Na execução completa do OmniDocBench, em modo base e com concorrência de 512, a vantagem encolhe para 12,7%: 5.580 contra 4.951 tokens por segundo. O batching já esconde boa parte do custo de atenção por etapa. Para processar faturas de uma única página com alta concorrência, o R-SWA quase não traz ganho.
A precisão se mantém até 40 páginas — depois começa a ceder
O artigo mede a distância de edição em relação à quantidade de páginas processadas em uma única passagem, e a curva não permanece estável.
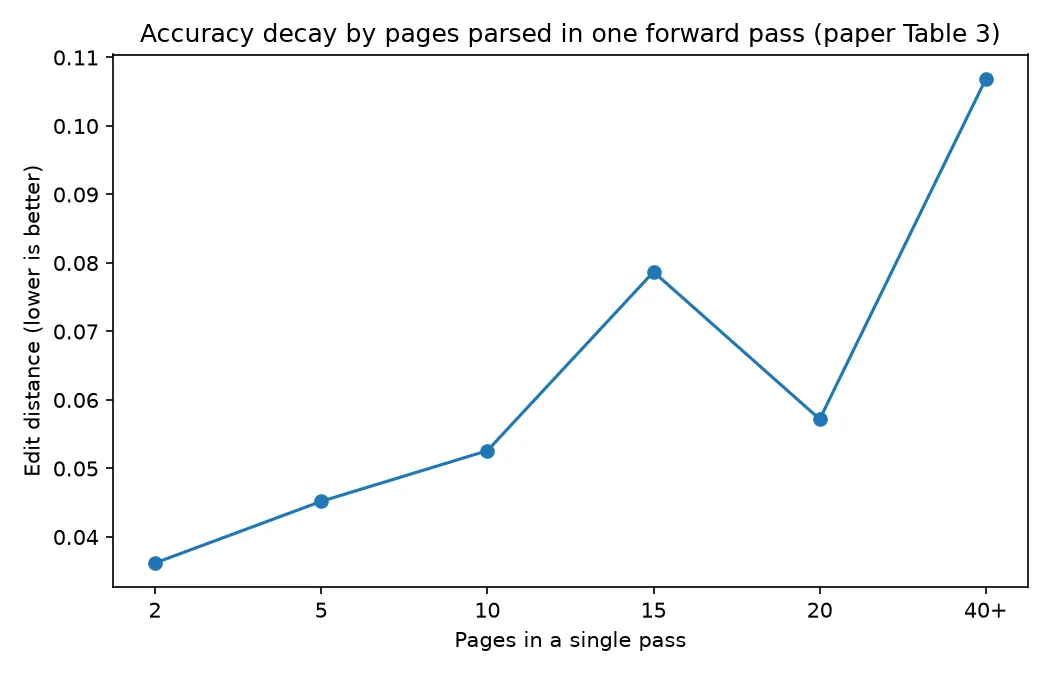
Com duas páginas, o resultado é 0,0362. Em 10 páginas, vai para 0,0526. A partir de 40 páginas, chega a 0,1069, enquanto o Distinct-35 cai de aproximadamente 99,9% para 96,90%, sinal de que n-gramas repetidos começam a aparecer na saída. A medição de 15 páginas, de 0,0787, é pior que a de 20 páginas, de 0,0572. Portanto, trate a curva como tendência, não como garantia por quantidade de páginas. A Baidu atribui as falhas de repetição principalmente ao texto pequeno na resolução-base de 1024×1024, e não a uma deriva de atenção. Isso faz sentido diante da limitação: entradas com várias páginas e PDFs não podem usar o modo de crop com mais detalhes disponível para imagens únicas.
A conta de VRAM por trás do “8 GB é suficiente”
A receita do vLLM afirma que uma GPU única com 8 GB ou mais basta para inferência em BF16. Relatos da comunidade não confirmam isso, e a própria configuração do modelo ajuda a explicar a diferença.
O único arquivo safetensors tem 6,673 GB. O lado do cache depende de quatro campos do config.json: num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128, com use_mla: false. Como há a mesma quantidade de cabeças de query e de key/value, trata-se de MHA convencional, sem compartilhamento GQA ou MQA para reduzir o volume. Assim, o cache por token é 2 (K e V) × 12 camadas × 10 cabeças × 128 dimensões × 2 bytes = 61.440 bytes, ou 60 KiB. Daí saem três números:
- Prefill completo de 32K: 32.768 × 60 KiB = 1,875 GiB de cache
- Lado de decode do R-SWA, limitado por
sliding_window_size: 128: 7,5 MiB, constante - O mesmo decoder sem R-SWA, com 6.144 tokens de saída: 360 MiB, crescendo linearmente
Esses são tamanhos teóricos de cache, não o pico de alocação. Ativações do encoder visual, fragmentação do alocador e o bloco de cache pré-alocado pelo motor entram por cima. É por isso que os pesos somados a um prefill longo pressionam uma placa de 8 GB. Uma execução local com SGLang em uma RTX 4070 Ti Super de 16 GB relatou cerca de 12 GB em uso, algo compatível com essa conta, mas não uma prova dela. Considere 8 GB como o piso para uma página curta, não como especificação para o cenário de 40 páginas.
Os números também deixam claro o que o R-SWA entrega: ao limitar o cache de decode, ele economiza centenas de megabytes, não gigabytes, neste porte de modelo. O benefício prático é que o custo de atenção por etapa deixa de crescer, exatamente o que a curva de throughput mede.
Sem API oficial: estas são as formas reais de rodar
A página do modelo no Hugging Face informa: “This model isn't deployed by any Inference Provider.” Não existe endpoint de primeira parte nem página de preços hospedada pela Baidu. Para servir o modelo por conta própria, há três opções: Transformers com trust_remote_code, SGLang ou a receita do vLLM. Esta última requer vLLM 0.25.0 ou mais recente, usando o container dedicado vllm/vllm-openai:unlimited-ocr, porque a arquitetura ainda não está em uma wheel pip estável.
Quatro configurações determinam se você terá saída ou não:
- Registre o processador de logits de n-gramas. Use
NGramPerReqLogitsProcessor. Sem ele, documentos longos entram em loop nos tokens de coordenadas<|det|>. - Ajuste o tamanho da janela conforme a entrada. Use
ngram_size: 35comwindow_size: 128para imagens únicas e1024para múltiplas páginas ou PDFs. - Comece o conteúdo textual com o token literal
<image>. O formato é<image>Multi page parsing.. O modelo não inclui um template de chat. - Informe
skip_special_tokens: False. Manter o padrão resulta em strings vazias.
As gerações brutas trazem marcação de grounding. Para obter markdown limpo, mantenha o texto entre <|ref|> e descarte as caixas delimitadoras <|det|>. O modelo também não emite limites de página nativamente; se isso for necessário para uma trilha de auditoria, peça rótulos de página no prompt.
O servidor e a requisição validados pela receita são estes:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Em placas Hopper, use a tag de imagem unlimited-ocr-cu129. Vale notar que várias imagens na mesma requisição fazem o modelo cair no modo base sem crop; é justamente esse caso que pede window_size: 1024.
Custo por 1.000 páginas: self-hosting versus API gerenciada
Pesos abertos não significam operação gratuita. Um dos poucos números publicados de throughput em uso real vem de um profissional na thread do Hacker News: aproximadamente 200 páginas por hora de um PDF japonês de gramática em uma RTX 4090, usando Transformers. Compare isso à tarifa Community da RunPod, de US$ 0,34 por hora para uma 4090.
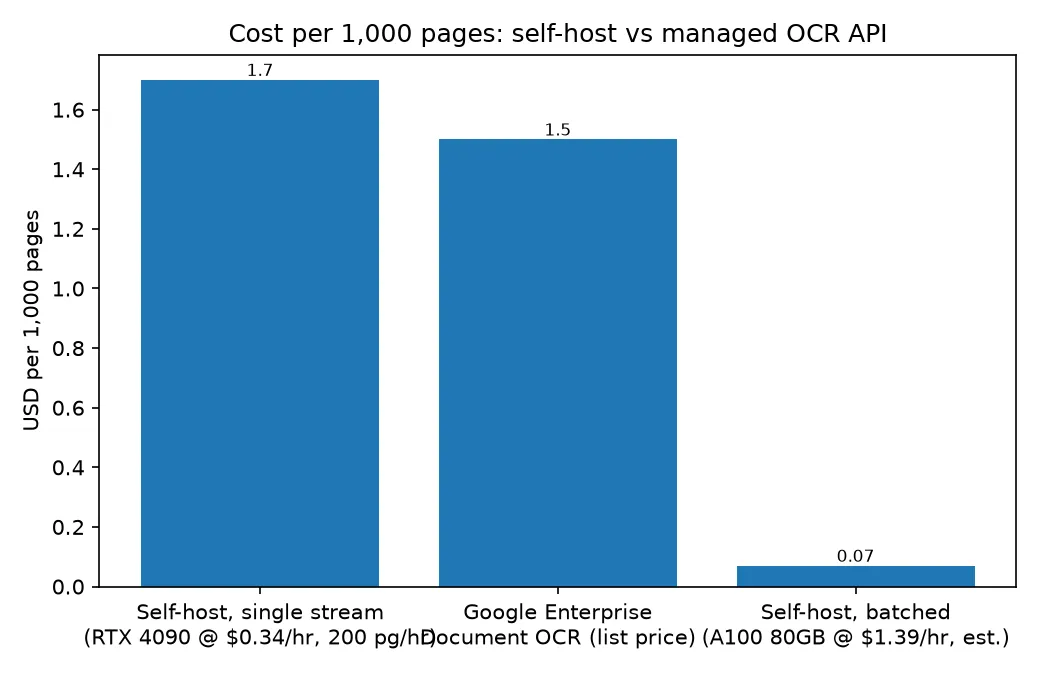
| Opção | Custo por 1.000 páginas |
|---|---|
| Self-host, stream único (4090 a US$ 0,34/h, 200 páginas/h) | ~US$ 1,70 |
| Google Enterprise Document OCR, de 1 mil a 5 milhões de páginas/mês | US$ 1,50 (preço de tabela) |
| Google Layout Parser, na mesma faixa de páginas | US$ 10,00 (preço de tabela) |
| Self-host, piso de batch saturado (A100 80GB a US$ 1,39/h, modelado) | ~US$ 0,07 |
Preços de tabela em 2026-07-29. As primeiras 1.000 páginas mensais do Google são gratuitas, e a tarifa cai para US$ 0,60 acima de 5 milhões de páginas. A última linha é um piso modelado, não uma medição, e varia conforme o tamanho da saída. No throughput de 5.580 tokens por segundo do artigo, com concorrência de 512, 700 tokens de saída por página resultam em cerca de 28.700 páginas por hora, ou US$ 0,05 por 1.000; 1.000 tokens resultam em cerca de 20.000 páginas, ou US$ 0,07; uma página densa de 2.000 tokens fica em cerca de 10.000 páginas, ou US$ 0,14. Esse throughput foi medido no cluster de avaliação da própria Baidu, não em uma A100 alugada. Portanto, a linha combina uma taxa de benchmark com um preço de locação. Implantações reais custam mais que os três cenários quando se incluem capacidade ociosa, novas tentativas em páginas com falha, pré-processamento e armazenamento.
Em stream único numa placa de consumo, o custo fica próximo ao OCR gerenciado do Google. O self-hosting vence por concorrência e residência de dados, não pela licença. E o parsing é só metade do trabalho: transformar markdown em campos ainda exige uma chamada a um modelo de texto com contexto longo, voltando à cobrança por token em vez de por página — seja na sua própria stack, seja em algo como a API GPT-5.6.
Onde o modelo falha
Os problemas relatados são exatamente os esperados de um encoder congelado. A mesma execução na 4070 Ti Super apresentou saída corrompida, regiões perdidas e desvio de estrutura em recibos, escrita à mão e scans complexos, embora páginas impressas e limpas tenham sido processadas corretamente. Participantes da thread no Hacker News descrevem uma classe de erro de VLM-OCR importante para trabalhos de conformidade: palavras estrangeiras traduzidas silenciosamente para inglês e um nome manuscrito “corrigido” para uma grafia considerada mais provável. São dois relatos isolados; trate-os como casos a testar, não como taxas medidas.
O posicionamento também importa. O Unlimited OCR não lidera as tabelas de precisão. Em listagens agregadas do OmniDocBench, o PaddleOCR-VL-1.6 aparece com 96,33, dado autodeclarado pelo fornecedor, contra 93,92 no v1.6 para o modelo da Baidu. O Unlimited OCR também não aparece no olmOCR-Bench. Sua disputa não é no eixo da precisão por página.
Vale a pena rodar?
É uma boa opção se o seu pipeline atual percorre as páginas e depois remonta o texto, se os documentos são digitais de origem ou têm scans limpos, e se estruturas entre páginas — como tabelas partidas por uma quebra de página — prejudicam sua saída atual.
É uma escolha ruim se você processa milhares de faturas de uma página por dia, pois pipelines por página fazem batch melhor e custam menos; se manuscritos ou recibos fotografados representam uma parcela relevante das entradas; ou se você precisa hoje de SLA e trilha de auditoria, não de uma GPU e uma tag de container.
De todo modo, teste antes de assumir compromisso. Um mínimo funcional: 50 documentos do seu próprio acervo, separados por tamanho — de 1 a 5 páginas, de 6 a 20 e 20 ou mais — e por qualidade de entrada — digital de origem, scan limpo e fotografado. Produza manualmente o ground truth de 10 deles. Em seguida, meça separadamente a taxa de erro de caracteres, a distância de edição da ordem de leitura e o TEDS de tabelas, em vez de fazer uma média; registre também os segundos reais por página na GPU que pretende alugar. Compare com a solução atual nos mesmos 50 arquivos e defina a meta no ponto em que sua etapa posterior realmente falha — para extração de campos, em geral isso significa a estrutura das tabelas, não o CER bruto. Como referência de quanto a otimização pode mexer no resultado, uma equipe que processa PDFs em escala empresarial relatou taxa de erro de caracteres de 0,94% após reescrever a camada de inferência em Rust.
Perguntas frequentes
Unlimited OCR é gratuito?
Os pesos têm licença MIT e podem ser baixados gratuitamente no Hugging Face ou no GitHub, inclusive para uso comercial. A inferência não é gratuita: reserve aproximadamente US$ 0,07 a US$ 1,70 por 1.000 páginas, conforme a eficiência do seu batching, além do tempo de engenharia.
Existe uma API oficial do Unlimited OCR?
Não. A página do modelo não mostra implantação em nenhum Inference Provider. Assim, qualquer endpoint encontrado será de terceiros servindo os pesos abertos, com preço e limites de taxa definidos pelo fornecedor, não pela Baidu.
Unlimited OCR é o melhor modelo de OCR atualmente?
Não nas tabelas de precisão: o PaddleOCR-VL-1.6 informa 96,33 no OmniDocBench, contra 93,92 da Baidu no v1.6. O modelo também ainda não possui entrada no olmOCR-Bench, então a consistência entre benchmarks não foi comprovada. Sua vantagem medida é processar 40 páginas em uma única passagem com distância de edição de 0,1069.
Posso rodar Unlimited OCR no Ollama?
O card oficial documenta apenas Transformers, vLLM e SGLang, e a arquitetura personalizada exige trust_remote_code. Há quantizações da comunidade no Hugging Face, mas considere qualquer build para Ollama não verificado até comparar sua saída com o caminho de referência nos seus próprios arquivos.