 AIREITER
Com o encerramento marcado para 26 de agosto de 2026, o maior erro é encarar a migração da OpenAI Assistants API como uma simples troca de nomes. O fim da Assistants API foi anunciado com um ano de antecedência, no aviso de descontinuação de 26 de agosto de 2025, e a substituta é a Responses API. No papel, os objetos até parecem ter equivalentes diretos. Na prática, a orquestração muda — e desenvolvedores que seguiram o guia oficial ainda colocaram quebras em produção. A seguir, veja o que deixa de existir, o que os mapeamentos escondem e como agir com o tempo que você tem.
O que para em 26 de agosto de 2026 — e o que continua disponível
Todas as famílias de endpoints da Assistants passarão a retornar erros após o prazo. Isso inclui /v1/assistants, /v1/threads, mensagens de thread, runs e run steps, além de qualquer fluxo que ainda envie o header OpenAI-Beta: assistants=v2. As configurações dos assistants e o histórico das threads deixarão de ser acessíveis pela API.
Nem tudo que faz parte de uma integração com Assistants desaparece:
| Indisponível em 26 de agosto de 2026 | Continua disponível |
|---|---|
Endpoints CRUD de /v1/assistants | Vector stores e arquivos enviados, reutilizáveis com file search na Responses |
/v1/threads e mensagens de thread | Chat Completions API, que não faz parte deste encerramento |
| Runs e run steps | Responses API e Conversations API |
Fluxos com OpenAI-Beta: assistants=v2 | Realtime API |
O próprio rastreador de descontinuações da OpenAI aponta Responses e Conversations como os substitutos designados:
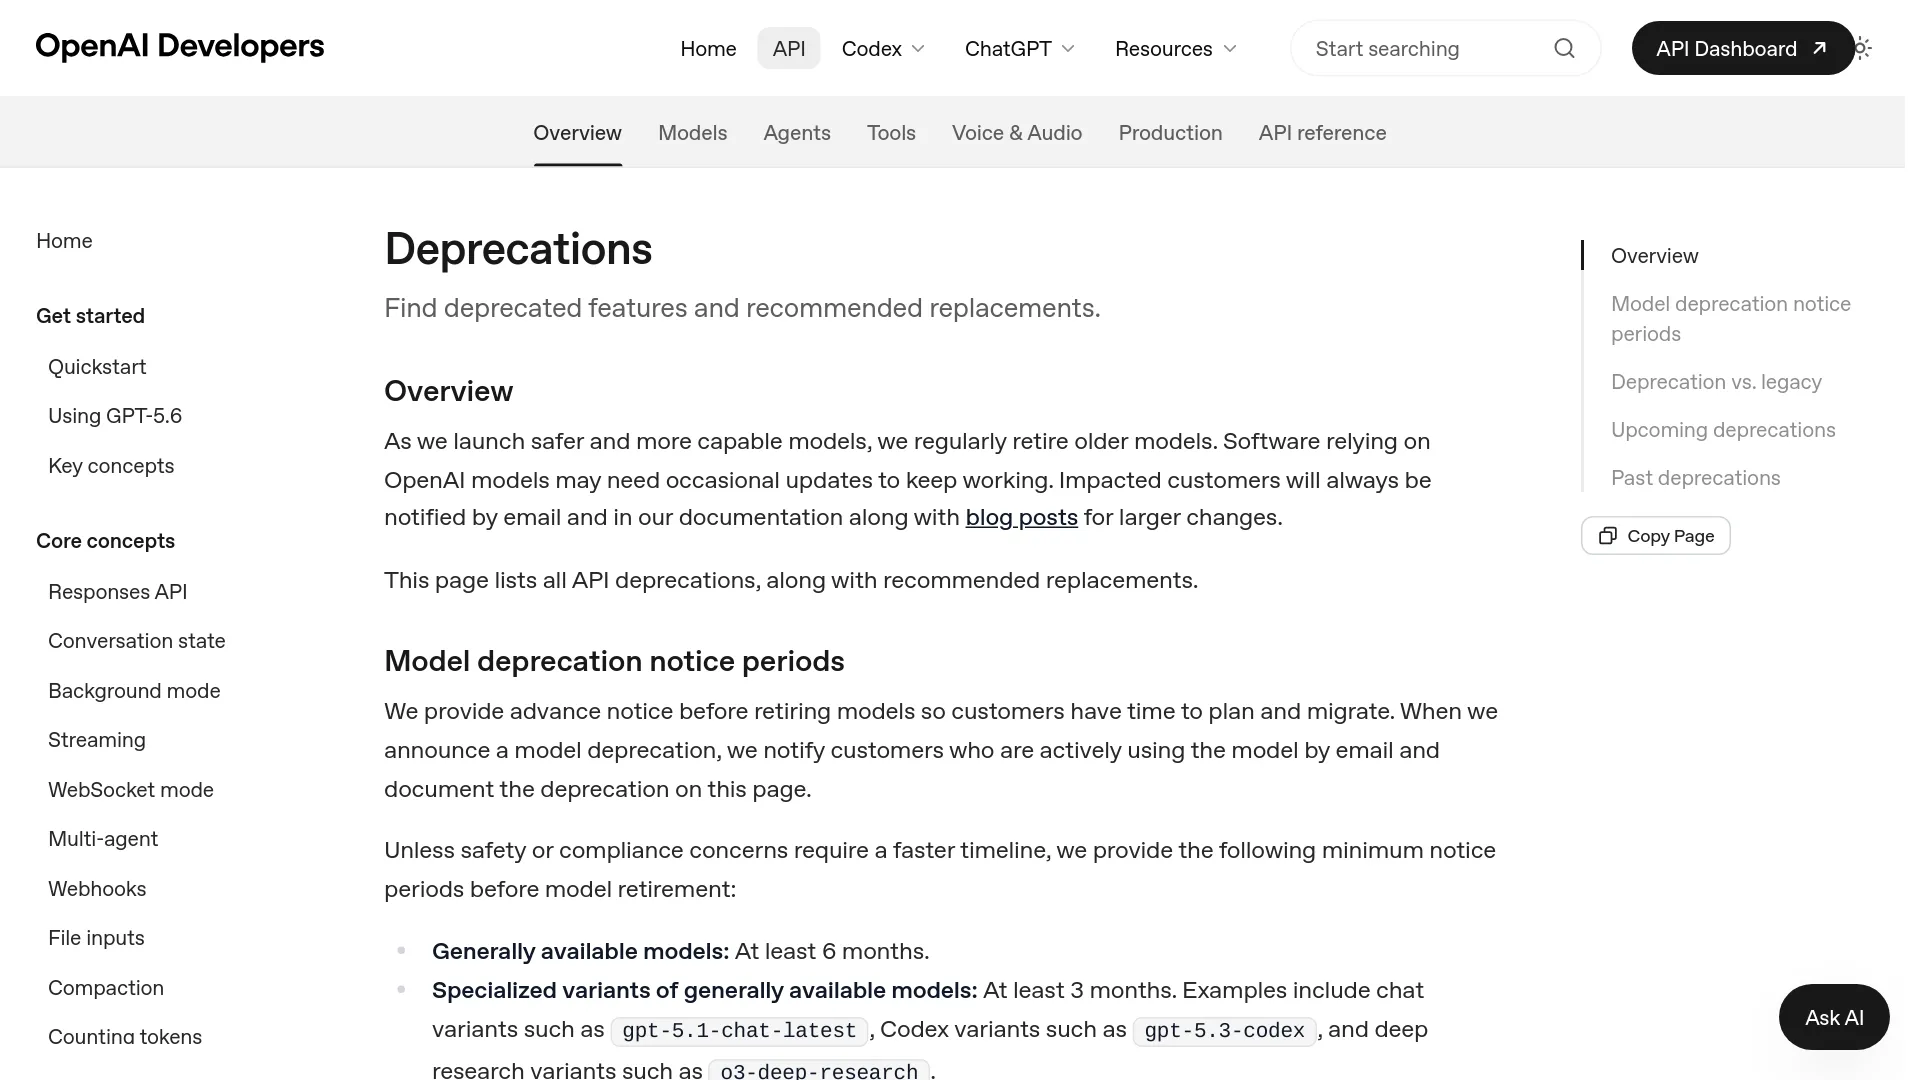
Os quatro mapeamentos de objetos e os dois detalhes que alteram a arquitetura
O guia de migração da OpenAI relaciona quatro conceitos da Assistants aos seus equivalentes na era da Responses:
| Assistants API | Substituto | O que muda de fato |
|---|---|---|
Assistants | Prompts | A configuração passa para um objeto versionado, criado no dashboard |
Threads | Conversations | Armazena itens genéricos — mensagens, chamadas de ferramenta e resultados — e não apenas mensagens |
Runs | Responses | O ciclo de criar run, consultar status e recuperar resultado vira uma única chamada responses.create |
Run steps | Items | Um tipo union que abrange mensagens, chamadas de função e resultados |
Essa simplificação do ciclo aparece nos exemplos oficiais: uma run concluída em gpt-4.1 registra 34 tokens de prompt e 130 tokens de completion, enquanto uma response concluída em gpt-5.5 registra 17 tokens de input e 150 tokens de output. É um formato de carga semelhante, mas com campos diferentes.
E aí está a primeira observação importante. Dashboards de cobrança e parsers de payload baseados nos campos antigos podem falhar silenciosamente quando os nomes mudam:
| Campo da Assistants | Campo da Responses |
|---|---|
usage.prompt_tokens | usage.input_tokens |
usage.completion_tokens | usage.output_tokens |
max_completion_tokens / max_prompt_tokens | max_output_tokens |
truncation_strategy | truncation |
object: "thread.run" | object: "response" |
A segunda observação é arquitetural. Prompts só podem ser criados pelo dashboard, não por API. Isso inviabiliza sistemas que criam dinamicamente um Assistant para cada cliente, workspace ou conjunto de documentos. O próprio guia oficial recomenda verificar o cronograma de descontinuação de prompts antes de adotar objetos de prompt em uma integração de longa duração, porque objetos reutilizáveis de prompt também carregam o risco de um futuro sunset. O padrão mais durável é manter instruções, schemas de ferramentas e a escolha de modelo no seu próprio controle de versão, enviando tudo a cada requisição. Quanto ao histórico das threads, a posição da OpenAI cabe em uma frase: "We will not provide an automated tool for migrating Threads to Conversations."
Como migrar as três ferramentas integradas
Cada ferramenta da Assistants tem um destino específico na Responses, mas parte da responsabilidade passa para sua aplicação:
| Ferramenta da Assistants | Destino na Responses | O que passa a ser responsabilidade da aplicação |
|---|---|---|
| File search | Os vector stores permanecem; informe vector_store_ids na definição da ferramenta durante a requisição | Resolver os IDs corretos dos stores antes de cada chamada |
| Code interpreter | Container configurado com type: "auto" | Ciclo de vida do container |
| Functions | A chave aninhada function deixa de existir; name, description e parameters sobem um nível | O ciclo de ferramentas: executar a chamada, devolver o resultado com o call_id correspondente e decidir se deve continuar o loop |
A linha de file search traz uma mudança arquitetural discreta, mas relevante para apps multi-tenant. Antes, um vector store por tenant podia ser vinculado ao objeto Assistant no momento da configuração. Agora, a sessão recebida precisa ser associada aos IDs de store corretos antes que a requisição seja enviada.
O que quebrou para equipes que já fizeram a migração
A justificativa da OpenAI é que a Responses alcançou paridade de recursos. Os relatos de migração mostram paridade no nível dos objetos, mas uma refatoração real por baixo. O responsável por um SaaS de chatbot multi-tenant documentou uma migração de duas semanas no r/aiagents, e os problemas apareceram mesmo com uma leitura fiel do guia oficial:
Tive de adaptar todos os campos opcionais como
["type", "null"], o que parece uma gambiarra para contornar o sistema de tipos. — u/aidenclarke_12
Schemas estritos de ferramentas exigem que propriedades opcionais sejam declaradas como anuláveis e continuem listadas em required. Com isso, os schemas crescem, e todo handler que pressupunha que ausência significava campo ausente precisa ser revisto. O mesmo desenvolvedor apontou onde está a mudança mais profunda:
a mudança na infraestrutura de vector stores é a verdadeira alteração arquitetural. — u/aidenclarke_12
Streaming é a segunda fonte de quebra silenciosa. O streaming de runs da Assistants não se adapta à Responses: ele precisa ser refeito com base em eventos SSE tipados, como response.created, response.output_text.delta, response.completed e response.function_call_arguments.delta / .done. Há eventos explícitos de conclusão e novos formatos para eventos de chamadas de ferramentas; os nomes dos eventos estão catalogados na cobertura sobre a migração. Tanto os proxies SSE quanto os handlers do cliente precisam ser reescritos, incluindo a lógica de reconexão.
O terceiro ponto de ruptura não está na API, mas na defasagem do ecossistema:
a Responses API existe há bastante tempo, mas muitos SDKs de frameworks ainda não a suportam — u/zhlmmc
Se sua stack depende de um framework de agentes que ainda pressupõe o modelo de Threads/Runs — a defasagem encontrada por u/zhlmmc — reserve tempo para migrar essa camada, além do seu código de integração.
Como escolher a estratégia de estado: encadeamento, Conversations ou replay manual
Há três formas de manter contexto em múltiplos turnos na Responses, e elas não são equivalentes:
| Estratégia | Mais indicada para | Atenção |
|---|---|---|
previous_response_id | Encadeamento mais simples, com poucas alterações | O contexto anterior continua entrando como input cobrável |
| Conversations API | O equivalente mais próximo de Threads; histórico no servidor | O backfill é por sua conta; não há ferramenta do fornecedor |
Replay manual, store: false | ZDR e exigências rígidas de retenção | Todo o estado fica sob sua responsabilidade; itens de raciocínio precisam ser carregados adiante |
Para transferir histórico, esta é a sequência recomendada pela OpenAI para converter uma thread antiga:
- Liste as mensagens da thread em ordem crescente.
- Converta cada mensagem de texto do usuário em
input_text. - Converta cada mensagem de texto do assistant em
output_text. - Converta conteúdo de URL de imagem em
input_image, preservandoimage_urledetail. - Crie a Conversation com os
itemsconvertidos.
Um erro no mapeamento de papéis tem uma consequência específica: o modelo passa a interpretar suas próprias respostas anteriores como novas instruções do usuário. Responses armazenadas têm TTL padrão de 30 dias, a menos que você envie store: false. Já conversations ficam fora desse TTL de response e não tinham uma duração publicada separadamente até o fim de julho de 2026, segundo a cobertura que acompanhou a migração. Isso importa se suas divulgações prometem uma janela de exclusão.
O impacto da migração na sua conta de tokens
Dois pontos de cobrança merecem atenção.
Primeiro: previous_response_id oferece praticidade, não desconto. O guia de migração para Responses da OpenAI afirma que tokens de input anteriores na cadeia de responses continuam sendo cobrados como tokens de input. Sem poda, conversas longas crescem linearmente.
Segundo: input em cache custa muito menos que input sem cache — cerca de um décimo da tarifa de input nas faixas GPT-5.x listadas em julho de 2026. Além disso, testes internos reportados pela OpenAI indicaram aproveitamento de cache 40–80% melhor na Responses do que no Chat Completions, conforme a cobertura compilada. Trate essa faixa de aproveitamento como um número do fornecedor até que seus próprios dashboards a confirmem. A comparação que realmente importa é a contagem de tokens por sessão antes e depois da virada.
Se a migração também for o momento de rever o preço da carga em GPT-5.x, o detalhamento de preços do GPT-5.6 mostra a matemática por token, e endpoints compatíveis com OpenAI, como a página da API GPT-5.6, executam as mesmas cargas no estilo Responses para uma comparação direta.
Um plano de migração conforme o tempo que resta
Restam de 1 a 6 dias. Faça backup antes de qualquer coisa: liste assistants e vector stores com limit=100, baixe seus arquivos e serialize objetos do SDK com model_dump(). Guias que priorizam backup, como este material sobre backup antes da migração, destacam uma limitação importante: não existe endpoint para listar threads. Portanto, você só consegue exportar IDs de thread que sua própria aplicação já tenha armazenado. Em seguida, faça a virada com uma flag: sessões novas passam imediatamente para Responses, enquanto threads antigas recebem backfill sob demanda, apenas quando o usuário as reabrir.
Uma semana ou mais. Migre primeiro um fluxo de baixo risco, de ponta a ponta, antes de mexer no restante. Reconstrua o loop de ferramentas e confirme que cada resultado de função leva o call_id correspondente; substitua o tratamento de streaming por ramificações baseadas no tipo de evento; depois compare comportamento, latência, uso de tokens e taxas de erro com a linha de base da Assistants antes de ampliar o tráfego.
Depois do prazo. Os endpoints retornam erros, e as configurações dos assistants somem do lado da API. A recuperação depende de reconstruir a partir do que estiver no banco de dados e nos backups da sua aplicação, com vector stores e arquivos ainda acessíveis via file search.
A troca que permanece em aberto é esta: sai um ciclo de vida gerenciado pelo servidor — polling, truncation e o loop de ferramentas — e entra um modelo de chamada única, com uma orquestração que você pode enxergar e testar. Um desenvolvedor que colocou ambos em produção resumiu assim:
A Responses API é o equilíbrio ideal: ela cuida do trabalho pesado, mas ainda é flexível o suficiente para você administrar sua própria funcionalidade. — u/landongarrison
Perguntas frequentes sobre o encerramento da OpenAI Assistants API
A Chat Completions API também será encerrada?
Não. A Chat Completions não faz parte do encerramento de 26 de agosto de 2026, e a orientação da OpenAI é migrá-la para Responses um fluxo por vez, sem prazo obrigatório.
A OpenAI vai migrar minhas threads existentes automaticamente?
Não. O guia oficial de migração afirma de forma direta: "We will not provide an automated tool for migrating Threads to Conversations." O backfill deve ser implementado no código da sua aplicação, seguindo a sequência de conversão de itens acima.
Posso continuar usando a Assistants API depois de 26 de agosto de 2026?
Não. Assistants, threads, mensagens, runs e run steps passarão a retornar erros após essa data, incluindo os fluxos com assistants=v2. Exporte tudo de que precisar antes do prazo.
Responses armazenadas expiram?
Sim. Responses armazenadas têm uma janela de retenção padrão de 30 dias, a menos que você envie store: false. Conversations ficam fora desse TTL, conforme os relatos de julho de 2026.
Preciso levar a configuração do meu assistant para Prompts?
Não — e, para assistants gerados dinamicamente, você não deve fazer isso. Prompts só são criados pelo dashboard, e o próprio guia oficial recomenda revisar o risco de descontinuação de objetos de prompt reutilizáveis. Manter instruções e schemas de ferramentas no controle de versão e enviá-los por requisição é o padrão mais durável.