 AIREITER
Um leaderboard pode mostrar que dois reconhecedores de fala estão praticamente empatados. A Monsoon acrescenta a pergunta que realmente importa: empatados para quais falantes, regiões, dispositivos e convenções de escrita? Os novos conjuntos de avaliação en-IN e hi-IN tornam o Open ASR Leaderboard mais útil para avaliar ASR multilíngue, mas as gravações públicas curtas ainda exigem uma leitura cuidadosa dos resultados.
Em resumo: a Monsoon mostra mais do que o leaderboard consegue explicar
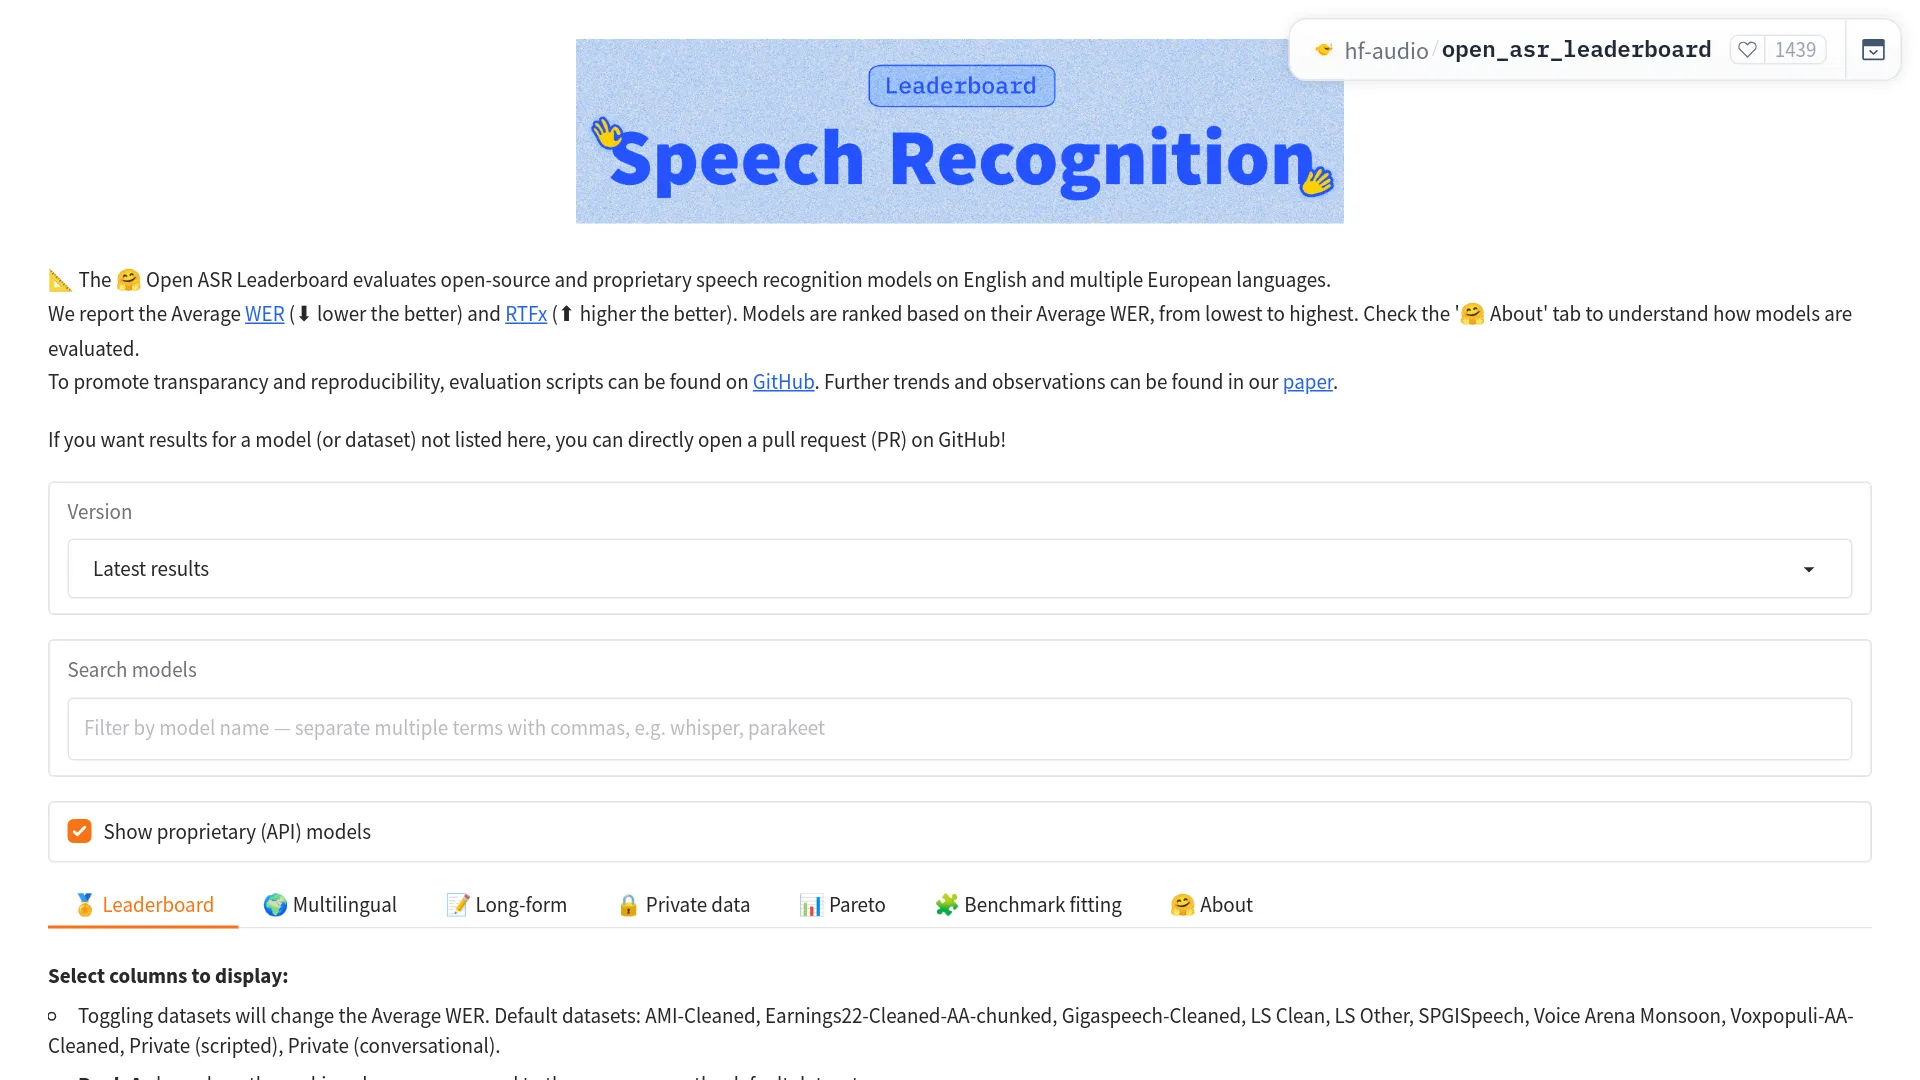
O Open ASR Leaderboard agora inclui dois conjuntos de avaliação do Voice Arena: Monsoon en-IN, para inglês indiano, e Monsoon hi-IN, para hindi. O inglês indiano aparece nas colunas principais do leaderboard e contribui para a Average WER exibida no destaque. Já o hindi aparece na visão de avaliação multilíngue, na qual o modelo precisa cobrir os idiomas selecionados para receber uma classificação multilíngue.
Os quatro splits, públicos e privados, reúnem 4.888 falantes sem sobreposição entre conjuntos e registram 12 atributos relacionados a cada falante, distribuídos entre dados demográficos, contexto, geografia e aparelhos. Com isso, pesquisadores podem ir além de “qual modelo tem a menor WER média?” e investigar em quais cenários cada sistema perde estabilidade. A Monsoon é uma evolução relevante para avaliar robustez regional e a pontuação de transcrições em hindi — mas não é uma garantia de desempenho em produção nem uma medida representativa de todas as línguas faladas na Índia.
O que a Monsoon acrescenta ao Open ASR Leaderboard
A Monsoon adiciona quatro splits de teste coletados pelo mesmo pipeline de fala espontânea e conversacional. Cada idioma tem um split público, para pontuação independente, e um split privado, criado para dificultar ajustes específicos ao benchmark. O anúncio oficial descreve o lançamento como a primeira adição de um idioma indiano ao contexto multilíngue deste leaderboard.
O inventário de cada split
| Split | Áudio | Falantes | Clipes | Distritos de origem | Estados / territórios da união | Dispositivos | Formato da referência |
|---|---|---|---|---|---|---|---|
| Monsoon en-IN público | 5.62 h | 1,444 | 2,102 | 428 | 24 / 6 | 556 | Texto normalizado com disfluências |
| Monsoon en-IN privado | 5.58 h | 1,405 | Não divulgado | 420 | 24 / 6 | 560 | Texto normalizado com disfluências |
| Monsoon hi-IN público | 1.33 h | 468 | 753 | 202 | 11 / 3 | 315 | Lattice de variantes aceitas |
| Monsoon hi-IN privado | 4.47 h | 1,571 | Não divulgado | 295 | 12 / 3 | 582 | Lattice de variantes aceitas |
O dataset card público do Monsoon en-IN informa áudio a 16 kHz, duração média de 9.6 segundos por clipe e mediana de 10.4 segundos. O card do Monsoon hi-IN informa média de 6.4 segundos e mediana de 5.0 segundos no split público. Os quatro splits somam 17.00 horas, portanto este é um benchmark focado em diversidade, formado por segmentos conversacionais curtos — não por chamadas longas.
Público para reprodução, privado para medir generalização
Pesquisadores podem carregar os splits públicos pelo Hugging Face, executar um reconhecedor, normalizar a saída e calcular uma pontuação em nível de corpus. No en-IN, o dataset card exige que o total de inserções, deleções e substituições seja dividido pelo total de palavras de referência, em vez de calcular a média da WER de cada clipe.
Para o hindi, o card público oferece o scorer voi-oiwer, compatível com lattices. Um padrão mínimo de carregamento é:
from datasets import load_dataset
from voi_oiwer import oiwer

hi = load_dataset(
    "VoiceArena/MonsoonASR-Open-ASR-leaderboard-hi-IN",
    split="test",
)
hypothesis = "replace with your model output for hi[0]"
result = oiwer(hypothesis, hi[0]["lattice"], "hindi")
score, (ins, dele, sub), ref_words = result[0], result[4], result[5]
Os splits privados continuam mantidos fora do alcance público e sem sobreposição de falantes, para impedir que as equipes ajustem o modelo com base em cada exemplo de avaliação. O desenho dos dados privados mantém esses resultados em visões agregadas separadas, sem redefinir a classificação pública padrão.
A cobertura de falantes é a principal mudança na avaliação
O conjunto público en-IN contém 1.444 falantes em 2.102 clipes, enquanto o conjunto público hi-IN reúne 468 falantes em 753 clipes. A tabela de cobertura do anúncio oficial informa que os dez maiores contribuidores respondem por apenas 2.8% a 6.8% da duração total nos quatro splits.
Isso reduz a chance de que um único falante muito presente, microfone ou estilo de gravação domine a pontuação, mas não torna a amostra representativa da população. Os 12 atributos registrados cobrem gênero, data de nascimento, ocupação, escolaridade, estado civil, renda, distrito e estado de origem, cidade atual, anos no distrito atual, fabricante do dispositivo e modelo do dispositivo.
O inglês indiano é uma distribuição geográfica, não um sotaque único
O split público en-IN abrange 428 distritos de origem, 30 estados e territórios da união, 641 cidades atuais e 556 modelos de celular. A composição dos segmentos inclui Sul, com 35%; Leste, com 18%; Centro, com 18%; Norte, com 16%; e Oeste, com 11%. Segundo o anúncio do Hugging Face, nenhum estado supera 13% dos falantes.
Os campos native_district, native_state, current_city, years_spent_in_current_district, device_manufacturer e device_model permitem comparar recortes regionais e por aparelho. “Inglês indiano”, portanto, não corresponde a uma única condição de microfone nem a um único sotaque. Um modelo pode se sair bem em uma distribuição regional de fala e ser menos estável em outra, mesmo mantendo uma WER geral competitiva.
O hindi tem outra cobertura — e outro desafio de pontuação
O split público de hindi é menor: 1.33 hora, 468 falantes, 202 distritos e 315 modelos de celular. A cobertura do hindi se concentra no cinturão hindi; o anúncio afirma que Uttar Pradesh representa cerca de 40% dos falantes de hindi na coleta. Esse dado é importante para contextualizar um resultado em hindi, mas não mostra que todas as comunidades falantes do idioma estejam igualmente representadas.
O hindi também inclui palavras de origem inglesa, code-switching, compostos escritos juntos ou separados, variações de grafia em devanágari e alternativas romanizadas. Por isso, o dataset card do hi-IN armazena um lattice no qual cada trecho da transcrição pode conter várias formas escritas aceitas.
A análise regional de erros revela empates que a WER agregada esconde
O exemplo regional oficial usa o split público de inglês indiano. Oito modelos ficam entre 4.81 e 4.99 de WER, uma diferença de apenas 0.18 ponto. O anúncio alerta que um conjunto de teste de aproximadamente cinco horas talvez não consiga distinguir uma diferença tão pequena.
Quando os mesmos resultados são divididos pelas cinco zonas geográficas, o quadro de estabilidade muda:
| Modelo | Observação geral | Variação regional | Resultado regional concreto |
|---|---|---|---|
openai/whisper-large-v3-turbo | Pontuação geral competitiva | 0.46 ponto de WER | A região mais fraca não foi divulgada no exemplo |
mistralai/Voxtral-Mini-3B-2507 | 0.14 ponto atrás do Whisper no resultado geral | 1.68 ponto de WER | 4.38 no Centro contra 6.06 no Leste |
ibm-granite/granite-speech-3.3-2b | Incluído na análise regional | Não informado | O Norte foi sua região mais fraca |
microsoft/VibeVoice-ASR-HF | Incluído na análise regional | Não informado | O Sul foi sua região mais fraca |
A diferença maior indica uma variabilidade regional mais alta no Voxtral, não quatro vezes mais erros de transcrição. As fragilidades regionais também variam de um modelo para outro, o que aponta para sensibilidades específicas de cada sistema, sem provar a causa desse comportamento.
O usuário @FoucqueThomas destacou a mesma diferença após o lançamento:
“⚡ L'Open ASR Leaderboard ajoute l'hindi et l'anglais indien (4 888 locuteurs, 12 attributs/clip). Résultat : deux modèles quasi identiques sur le WER global affichent jusqu'à ~4x d'écart selon la région du locuteur. Un benchmark enfin honnête sur la diversité vocale.” — @FoucqueThomas on X
Se os usuários estiverem concentrados em uma região específica, um empate na média não basta para escolher entre os modelos. O exemplo não prova que algum desequilíbrio nos dados de treinamento tenha causado o padrão regional.
Por que a pontuação com lattice do hindi importa na avaliação de ASR multilíngue
A WER tradicional pressupõe uma referência canônica. Isso funciona para normalização de caixa e ortografia, mas se torna limitado diante do hindi com code-switching. Uma saída válida pode usar uma grafia em devanágari, uma forma romanizada, uma grafia de origem inglesa ou uma divisão diferente entre palavras compostas.
A Monsoon hi-IN lida com isso usando lattices de referência: o lançamento oficial descreve a expansão de variantes candidatas, a revisão por linguistas nativos e a filtragem para manter apenas formas compatíveis com o enunciado. Assim, uma alternativa válida pode ser considerada correta, em vez de penalizada por divergir da forma escolhida por um anotador.
O leaderboard usa a Orthographically-Informed Word Error Rate (OIWER) na avaliação em hindi. Uma variante aceita conta como correta, enquanto um erro genuíno de reconhecimento continua sendo contabilizado. O commit de integração do leaderboard mostra como os dados em hindi e as visões multilíngues por idioma foram conectados à aplicação.
Essa regra de pontuação pode mudar a ordem dos modelos. O anúncio oficial informa que transformar os lattices de hindi em referências únicas eleva as taxas de erro de todos os sistemas testados e que os aumentos não são uniformes. Um leaderboard multilíngue pode, portanto, se tornar linguisticamente mais justo sem reduzir todos os resultados a um único número universal.
Como usar o leaderboard atualizado na escolha de modelos
Use a Monsoon como uma etapa de triagem e diagnóstico e, depois, valide os finalistas com áudio do seu próprio domínio.
- Use a Average WER para reduzir o número de candidatos. O en-IN agora afeta a média principal do leaderboard. Com isso, modelos que funcionam bem apenas com inglês lido ou com variedades não indianas ficam menos protegidos contra um teste conversacional com sotaques indianos.
- Confira a cobertura de idiomas antes de comparar médias multilíngues. O código-fonte do leaderboard mostra os idiomas selecionados ausentes como
NAe informa um valor deCoverage, como3/5; o modelo só recebe uma posição no ranking multilíngue quando oferece suporte a todos os idiomas selecionados. Consulte o código de integração. - Divida os dados públicos da Monsoon pelos campos documentados. Compare distrito e estado de origem, cidade, dispositivo e outros metadados disponíveis. Observe a dispersão e a concentração de falhas, não apenas a melhor pontuação de cada subgrupo.
- Valide com áudio representativo da produção. Teste a combinação de celulares, condições de ruído, padrões de code-switching, VAD e duração da fala do seu caso. Os clipes públicos da Monsoon têm média inferior a dez segundos, portanto não substituem a validação de todos os cenários de call center, reuniões ou agentes de voz.
No X, o profissional @PlimmApp alertou que o VAD pode esconder alucinações de silêncio quando a avaliação começa com segmentos que contêm fala: “the vad step in your pipeline is also the blind spot… a model that emits fluent text over silence never gets charged for it.” Leia o comentário completo. Equipes que trabalham com processamento no dispositivo devem avaliar separadamente VAD, detecção de fim de fala e tratamento de alucinações.
O que a Monsoon ainda não consegue responder
- Escala e transferência para áudio longo: O conjunto público en-IN tem 5.62 horas e o conjunto público hi-IN tem 1.33 hora; os clipes têm duração média de 9.6 e 6.4 segundos, respectivamente. Diferenças pequenas na pontuação e comportamento com áudio longo exigem validação separada.
- Representatividade nacional: A ampla cobertura de distritos, estados e dispositivos não equivale a um censo ponderado pela população de falantes de inglês indiano ou hindi.
- Explicações causais: Associações regionais não permitem determinar se a causa está nos dados de treinamento, na acústica, na fonética, na decodificação ou em outro fator.
- Capacidade de previsão dos conjuntos privados: Os splits privados, sem sobreposição de falantes, foram criados para testar generalização, mas seus exemplos não podem ser inspecionados de forma independente.
- Adequação ao texto downstream: Busca, legendas, analytics e transcrições jurídicas podem exigir convenções diferentes de script, normalização, pontuação ou code-switching.
FAQ sobre a Monsoon do Open ASR Leaderboard
O inglês indiano afeta a média principal do leaderboard?
Sim. O Monsoon en-IN é uma entrada padrão do leaderboard de inglês e contribui para a Average WER. Consulte o inventário dos splits para ver os tamanhos público e privado.
O hindi faz parte do ranking principal do leaderboard?
O hindi aparece na visão multilíngue. Os idiomas selecionados que não são suportados são exibidos como NA, e apenas os modelos com cobertura completa dos idiomas escolhidos recebem uma posição no ranking multilíngue.
Posso baixar os conjuntos públicos e calcular a pontuação?
Sim. Os cards do en-IN e do hi-IN trazem exemplos de carregamento. Use agregação em nível de corpus e OIWER para os lattices de hindi.
Por que o hindi não usa a WER comum?
Uma referência fixa em hindi pode penalizar variantes válidas em devanágari, romanizadas, com code-switching ou com diferentes divisões de palavras compostas. O lattice registra as formas aceitas para cada trecho da transcrição.
Uma WER geral menor significa que o modelo é melhor em todas as regiões da Índia?
Não. O exemplo oficial do en-IN mostra WERs gerais quase empatadas, mas dispersões regionais diferentes. Analise o comportamento dos subgrupos e teste áudio representativo antes de colocar o modelo em produção.
A decisão prática
Use o en-IN para a triagem pela pontuação principal, o hi-IN e o OIWER para comparações em hindi ou multilíngues e a dispersão regional como sinal de risco quando a variação for grande. Depois, valide o finalista com o áudio, o ruído, o comportamento do VAD e as convenções de texto que seus usuários realmente produzem.