 AIREITER
O Muse Spark 1.3 aparece atualmente no OpenRouter por US$ 1,25 por milhão de tokens de entrada e US$ 4,25 por milhão de tokens de saída — mas o preço é só parte da decisão. O modelo chama atenção em programação com contexto longo e tarefas com agentes, embora o lançamento ainda seja recente, o modo de raciocínio máximo não estivesse disponível no início e a latência até o primeiro token possa ser alta.
O que é o Muse Spark 1.3 — e o que significa estar “disponível”
O Muse Spark 1.3 é o modelo proprietário de raciocínio da Meta voltado para tarefas prolongadas com agentes, programação e uso multimodal. A Meta anunciou o modelo em 2 de setembro de 2026, informando que ele começaria a chegar ao Muse Code e à Meta Model API. Os modos de raciocínio existentes foram liberados primeiro; o modo de raciocínio máximo ainda dependia de testes adicionais de segurança. (Anúncio da Meta AI Research)
Como o material de lançamento exibe resultados do modo máximo, embora esse modo ainda dependesse de testes adicionais de segurança, não dá para presumir que esses números serão reproduzíveis desde o primeiro dia.
Segundo a Meta, o Muse Spark 1.3 é melhor em manter restrições ao longo de tarefas extensas, lidar com interrupções na mesma conversa, fazer perguntas de esclarecimento, pedir confirmação antes de ações importantes e reconhecer quando está travado. A empresa também afirma que o modelo faz cerca de 20% menos chamadas de ferramentas e usa 25% menos tokens que o Muse Spark 1.2 em comparações internas de programação. São números divulgados pelo fornecedor, sem um conjunto de tarefas reproduzível ou margens de erro.
A publicação de lançamento trata os pesos abertos como parte do roteiro futuro. As fontes consultadas aqui listam o Muse Spark 1.3 como um modelo hospedado e acessível somente por API, sem documentar um checkpoint para download, uma licença confirmada, a quantidade de parâmetros ou os requisitos de hardware.
O preço da API é simples; calcular o custo real, nem tanto
A tabela pública mais clara está na página do Muse Spark 1.3 no OpenRouter, não na publicação de lançamento da Meta. O OpenRouter informa tarifas padrão de US$ 1,25 para entrada e US$ 4,25 para saída por milhão de tokens, além de cobranças separadas para leitura de cache e pesquisa na web.
| Uso | Preço listado | O que observar |
|---|---|---|
| Entrada | US$ 1,25 / 1 milhão de tokens | Tokens novos de prompt e contexto |
| Saída | US$ 4,25 / 1 milhão de tokens | Cerca de 3,4 vezes a tarifa de entrada |
| Leitura de cache | US$ 0,15 / 1 milhão de tokens | Útil para contextos repetidos em agentes |
| Pesquisa na web | US$ 2,50 / 1.000 chamadas | Cobrança separada dos tokens |
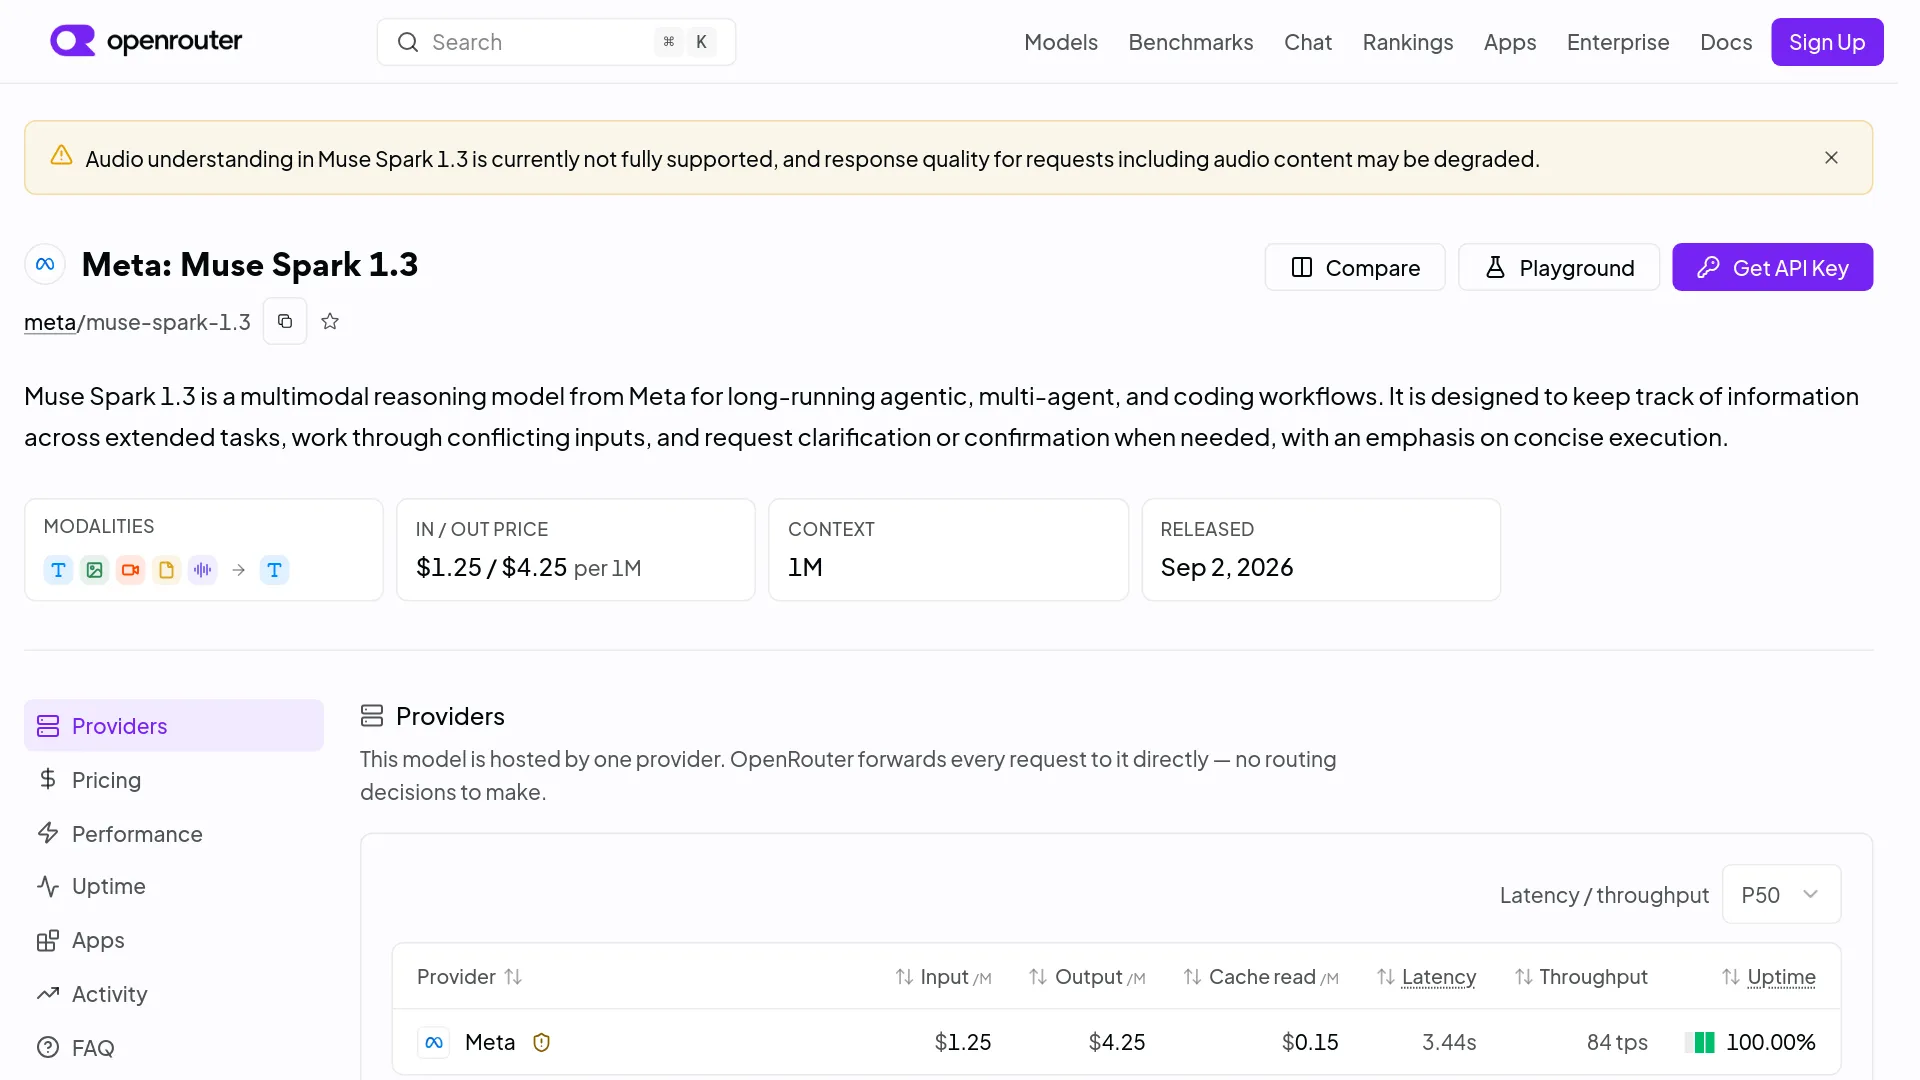
Uma solicitação com 100.000 tokens novos de entrada e 20.000 tokens de saída custa cerca de US$ 0,21, antes das cobranças de cache ou pesquisa na web: US$ 0,125 de entrada mais US$ 0,085 de saída. Loops de agentes, novas tentativas e contextos repetidos elevam o custo de uma tarefa completa.
A Artificial Analysis informa um preço combinado de US$ 0,78 por milhão de tokens, usando uma composição de 7:2:1 entre acertos de cache, entrada e saída. Fluxos com contexto sempre novo ou muita saída custarão mais; use esse valor como estimativa de cenário, não como uma tarifa universal.
Não transfira automaticamente para o Muse Spark 1.3 as premissas de Contributor do guia de preços da API do Muse Spark 1.2. A listagem pública do 1.3 confirma a tarifa padrão acima, mas as fontes consultadas aqui não estabelecem um contrato completo de Contributor para o 1.3, com regras de uso de dados, limites de taxa ou disponibilidade regional. Até que o provedor confirme o contrário, faça o orçamento com base na tarifa padrão.
As evidências apontam para um modelo forte em programação — não para um campeão em tudo
Os dados sustentam a ideia de que o Muse Spark 1.3 é forte em programação e contexto longo, mas não de que seja líder universal. A tabela abaixo usa as pontuações da metodologia de avaliação vinculada pela Meta. As escalas variam entre os benchmarks; portanto, um número maior só pode ser comparado dentro da própria linha.
| Avaliação | Muse 1.3 max | Muse 1.3 xhigh | Muse 1.2 xhigh | GPT-5.6 Sol | Claude Opus 5 | Maior resultado exibido |
|---|---|---|---|---|---|---|
| MRCR 512K–1M | 98.1 | 93.1 | 55.5 | 73.8 | — | Muse 1.3 max |
| DeepSWE v1.1 | 75.4 | — | 55.0 | 73.0 | 74.0 | Muse 1.3 max |
| SWE-Atlas Codebase QnA | 59.4 | 54.0 | 46.2 | 53.5 | 52.7 | Muse 1.3 max |
| Terminal-Bench 2.1 | 88.8 | 89.2 | 82.9 | 88.8 | 86.7 | Muse 1.3 xhigh |
| OSWorld 2.0 | 66.9 | 57.2 | 47.6 | 62.7 | 68.3 | Claude Opus 5 |
| DeepSearchQA | 89.4 | 89.4 | 85.9 | 93.0 | 90.4 | GPT-5.6 Sol |
| GDPVal-AA v2 | 1754 | 1709 | 1615 | 1710 | 1824 | Claude Opus 5 |
O caso mais convincente a favor do Muse Spark 1.3 está na programação com contexto longo: o resultado máximo chega a 98.1 no MRCR com contexto de 512K–1M e a 75.4 no DeepSWE, contra 55.5 e 55.0 do Muse Spark 1.2 xhigh. A mesma tabela mostra alternativas mais fortes em algumas avaliações de trabalho profissional, uso de computador e navegação.
A metodologia da Meta informa que as células podem vir de avaliações da própria Meta, de um leaderboard oficial ou de resultados divulgados pelos provedores. Os testes de programação usaram ferramentas restritas e não tiveram acesso à internet externa. São sinais úteis, mas não equivalem a uma comparação independente refeita do zero.
A Artificial Analysis informa uma pontuação 61 no Intelligence Index, na posição #10 entre 196 modelos comparáveis, contra uma mediana de 36 nesse grupo. A ModelCap mostra um ModelCap Index de 81.7 e a posição #4 no ranking, mas atribui apenas 20% de suporte e uma observação de benchmark público. As diferenças entre os sistemas reforçam uma conclusão: a base de evidências ainda é pequena.
Em um fluxo real, comece testando o Muse Spark 1.3 na exploração de repositórios, em agentes de terminal de longa duração e em perguntas sobre a base de código. Não extrapole esses resultados para qualquer tarefa com muita navegação ou uso profissional do computador.
O paradoxo da velocidade: rápido depois que começa, lento até começar
O Muse Spark 1.3 parece rápido enquanto gera a resposta, mas pode demorar bem mais para mostrar o primeiro resultado. Isso favorece tarefas contínuas ou em lote, em vez de um loop interativo de programação no qual cada rodada precisa começar imediatamente.
A Artificial Analysis registra 181,7 tokens de saída por segundo, contra uma mediana de 68,1 entre modelos comparáveis. A plataforma também aponta 27,51 segundos até o primeiro token, contra uma mediana de 3,04 segundos, e estima 41,26 segundos para uma resposta de 500 tokens em sua carga de trabalho. Na página do provedor, o tempo até o primeiro token da resposta aparece como 38,51 segundos, com um custo de US$ 0,55 por tarefa do Intelligence Index.
O OpenRouter exibe números P50 diferentes: 62 tokens por segundo e 1,83 segundo de latência. As métricas não são diretamente intercambiáveis, porque as páginas usam cargas de trabalho e definições diferentes; além disso, a Artificial Analysis inclui o tempo de raciocínio em sua métrica de primeira resposta. Meça no seu próprio ambiente tanto o tempo até o primeiro token quanto o tempo total da tarefa.
“Como algumas pessoas estão perguntando, minha primeira impressão (estou usando agora) — parece mecânico (excelente para trabalho, não sei para estratégia) e muito capaz. Parece muito rápido.” — u/NewYak4281, r/singularity
Essa primeira impressão, ainda sem controle experimental, combina com o equilíbrio observado nas medições: geração rápida depois de uma espera potencialmente longa, além de um estilo de interação que pode parecer mecânico. É um contexto útil, mas não substitui um teste controlado.
Recursos da API e limites do lançamento para verificar antes de ir para produção
O Muse Spark 1.3 oferece os recursos de integração esperados de um modelo moderno para agentes, mas vários detalhes de produção continuam dependendo dos provedores ou não foram divulgados. As evidências mais sólidas disponíveis hoje vêm da página ativa do modelo no OpenRouter e do monitoramento de provedores da Artificial Analysis, não de uma especificação pública completa da Meta no anúncio de lançamento.
| Recurso ou limite | Evidência atual | Implicação para produção |
|---|---|---|
| Janela de contexto | O OpenRouter e a ModelCap listam 1.048.576 tokens | Confirme o limite efetivo do endpoint |
| Saída máxima | A ModelCap lista 944 mil tokens | Os limites de saída do provedor podem ser menores |
| Entradas | Texto, imagem, vídeo e arquivos; áudio aparece com um aviso | Considere a compreensão de áudio incompleta |
| Saída | Texto | Planeje um fluxo mediado por texto |
| Chamadas de ferramentas | Listadas como compatíveis | Teste schemas e erros de ferramentas no seu SDK |
| Saída estruturada | Formato de resposta com JSON Schema listado | Teste falhas com schema estrito |
| Cobertura de provedores | Um provedor da Meta aparece na página do OpenRouter e no monitoramento da Artificial Analysis | Não presuma redundância para failover |
| Pesos do modelo | Apenas por API; nenhum peso para download listado | Não há um caminho de auto-hospedagem estabelecido |
A ModelCap alerta que um provedor específico pode oferecer um limite de contexto ou saída menor que o máximo publicado. O painel de disponibilidade do OpenRouter mostra 99,97% de uptime em três dias, mas números menores nas visões de 72 e 24 horas. Como são métricas diferentes da página, use os dados de status atuais e seus próprios registros de erro ao direcionar tráfego de produção.
A Meta não divulga, na publicação de lançamento, a quantidade de parâmetros, a arquitetura, limites formais de taxa da API, termos de licenciamento ou resultados detalhados dos testes de segurança. A empresa afirma que o modelo resiste melhor a injeções de prompt e toma decisões melhores diante de ações irreversíveis, mas não apresenta taxas de sucesso contra ataques nem um protocolo reproduzível de red team.
Vale a pena usar o Muse Spark 1.3 agora?
Vale testar o Muse Spark 1.3 agora em programação com contexto longo e agentes que usam muitas ferramentas, especialmente quando o baixo custo por token e a geração contínua são mais importantes que uma resposta inicial imediata. Mas ele ainda não deve ser o único modelo em produção para sistemas sensíveis à latência, dependentes de áudio, preocupados com privacidade ou que exigem redundância.
| Seu cenário | Decisão |
|---|---|
| Repositório grande, perguntas sobre a base de código, tarefa longa no terminal | Teste o Muse Spark 1.3 primeiro |
| Trabalho de agentes em lote, em que a velocidade de saída importa | Bom candidato; meça o custo total da tarefa |
| Programação em dupla e interação em tempo real | Use apenas se a espera pelo primeiro token for aceitável |
| Fluxo baseado em áudio | Aguarde ou escolha um modelo com suporte confirmado a áudio |
| Código de clientes sensível ou dados regulados | Verifique primeiro o contrato de uso de dados |
| Serviço crítico que precisa de failover | Mantenha um segundo modelo e uma rota alternativa |
Um lançamento de baixo risco é mais útil que outra captura de tela de leaderboard:
- Comece com um repositório sem informações sensíveis e de cinco a dez tarefas fixas.
- Limite as permissões de shell, gravação de arquivos, rede e ferramentas destrutivas ao mínimo necessário.
- Registre taxa de conclusão, chamadas de ferramentas, latência até o primeiro token, duração, tokens e custo na fatura.
- Compare as mesmas tarefas com seu modelo atual e mantenha um fallback para timeouts ou edições de baixa confiança.
Coloque o Muse Spark 1.3 atrás de uma flag de experimento nos agentes de programação e tome a decisão com base no teste do repositório, não no ranking do dia do lançamento. O preço e os resultados em contexto longo justificam o teste; a resposta inicial lenta, a pouca oferta de provedores, o suporte incompleto a áudio e a cobertura ainda provisória dos benchmarks desaconselham uma adoção exclusiva.
FAQ sobre a API e os preços do Muse Spark 1.3
O Muse Spark 1.3 foi lançado oficialmente?
Sim. O anúncio da Meta de 2 de setembro de 2026 informa que o Muse Spark 1.3 começou a ser disponibilizado no Muse Code e na Meta Model API. O modo de raciocínio máximo ainda aguardava testes adicionais de segurança.
Onde posso acessar o Muse Spark 1.3?
A Meta cita o Muse Code e a Meta Model API. O OpenRouter também lista meta/muse-spark-1.3; o acesso pode variar conforme o provedor, a conta e a região.
Quanto custa o Muse Spark 1.3?
A listagem do OpenRouter mostra US$ 1,25 por milhão de tokens de entrada, US$ 4,25 por milhão de tokens de saída, US$ 0,15 por milhão de tokens lidos do cache e US$ 2,50 por 1.000 chamadas de pesquisa na web. Considere essas as tarifas citadas do OpenRouter, a menos que seu provedor direto confirme uma tabela própria.
O Muse Spark 1.3 tem uma janela de contexto de um milhão de tokens?
O OpenRouter e a ModelCap listam 1.048.576 tokens, enquanto a Artificial Analysis arredonda o valor para 1 milhão. Confirme os limites efetivos de contexto e saída no endpoint que você utiliza.
Ele é compatível com visão, vídeo, ferramentas e saída em JSON?
O OpenRouter lista entradas de texto, imagem, vídeo e arquivos, além de chamadas de ferramentas e saídas estruturadas com JSON Schema. O áudio também aparece na lista, mas com um aviso de que a compreensão ainda não é totalmente compatível.
O Muse Spark 1.3 é open source ou pode ser hospedado localmente?
Nenhum peso para download ou pacote de auto-hospedagem foi identificado nas fontes consultadas. A Meta descreve os pesos abertos como parte do roteiro futuro, não como um artefato disponível do Muse Spark 1.3.
O modo de raciocínio máximo está disponível?
A Meta informou que os modos de raciocínio existentes seriam disponibilizados primeiro e que o modo máximo viria depois de testes adicionais de segurança. O anúncio não apresentou uma data definida.
Posso presumir que o preço de Contributor do Muse Spark 1.2 vale para o 1.3?
Não. Os termos de Contributor do 1.2 estão documentados separadamente, mas as fontes consultadas aqui não estabelecem um contrato completo de Contributor para o 1.3. Até que seu provedor confirme uma faixa, política de dados e limite de taxa diferentes, faça o orçamento usando a tarifa padrão do 1.3.
Faça um benchmark pequeno, sem dados sensíveis, em um repositório antes de colocar o modelo em produção: compare as mesmas tarefas com seu modelo atual e registre a espera pelo primeiro token, as alterações concluídas, as chamadas de ferramentas e o custo. Isso responderá à questão da implantação com mais confiabilidade que os rankings do dia do lançamento.