 AIREITER
Os embeddings multi-vector passaram a ser um tipo de modelo de primeira classe no Sentence Transformers nesta semana. A versão 6.0, anunciada em 18 de agosto de 2026, adiciona o MultiVectorEncoder ao lado dos modelos densos, esparsos e rerankers. Os benchmarks de lançamento da própria Hugging Face são bem menos eufóricos que o hype: a interação tardia superou sua contraparte densa idêntica em 9 dos 13 datasets NanoBEIR, mas a diferença média foi de cerca de um ponto de NDCG@10. Em compensação, no exemplo calculado pela empresa, o índice bruto chega a ser 42x maior que a base MiniLM de 384 dimensões — e ainda 21x maior que um modelo denso de tamanho equivalente. Se essa troca vale a pena depende quase inteiramente do perfil das suas consultas.
Como funcionam os embeddings multi-vector e a interação tardia
Em vez de resumir todo o documento em um único vetor agregado, um modelo multi-vector mantém um vetor para cada token. Na linha de modelos suportada pela Hugging Face, esses vetores de token normalmente têm 128 dimensões, contra 384, 768 ou 1.024 dimensões de um embedding denso convencional. Na hora de pontuar, o operador MaxSim encontra, para cada token da consulta, o maior produto escalar com qualquer token do documento e soma esses máximos: MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). Como os modelos são normalizados em L2, cada componente fica no intervalo [-1, 1], e a pontuação final cresce conforme o tamanho da consulta.
Na prática, a interação tardia fica entre duas arquiteturas das quais aproveita características:
| Arquitetura | Lado do documento | Pontuação | Perfil de custo |
|---|---|---|---|
| Bi-encoder denso | Um vetor agregado, pré-calculado | Um único produto escalar | Recuperação mais rápida; a agregação descarta detalhes dos tokens |
| Interação tardia | Um vetor por token, pré-calculado | MaxSim entre pares de tokens | Correspondência rica; o índice cresce com o tamanho do documento |
| Cross-encoder | Nada pré-calculado | Passagem forward completa para cada par consulta-documento | Classificado como o mais preciso por par no post de lançamento da Hugging Face; caro demais para a primeira etapa |
O artigo original do ColBERT formalizou essa abordagem como "contextualized late interaction".
O benefício aparece no nível do token. No exemplo da Hugging Face com lightonai/mLateOn, o token "live" da consulta encontrou o token "inhabit" do documento com similaridade de 0,94 — uma correspondência semântica sem qualquer sobreposição lexical.
Em quais cenários o multi-vector faz diferença
Benchmarks de passagens curtas tendem a minimizar os casos em que esses modelos realmente se justificam. Os padrões se repetem nas cinco fontes comparadas neste artigo: o post de lançamento da Hugging Face, a análise da TopK, o artigo técnico da Qdrant, o guia de produção do Data AI Hub e a comparação de busca em produção de Suhas Bhairav:
- Identificadores exatos em uma busca semântica. Códigos de produto, nomes de funções, sobrenomes, strings de erro e números de cláusulas. Um vetor agregado tende a diluí-los; vetores por token os mantêm localizáveis.
- Consultas com vários requisitos. Em algo como "X com Y e Z", cada token da consulta pode encontrar de forma independente o token correspondente no documento. Nenhuma condição se perde na média.
- Documentos longos cuja resposta está em uma passagem secundária. No benchmark multilíngue de documentos longos MLDR, o multi-vector
mLateOnmarcou 77.92, contra 51.59 domDenseOn— uma diferença de ordem de grandeza maior que as médias de passagens curtas. - PDFs, tabelas e páginas digitalizadas. Modelos da família ColPali indexam imagens de páginas diretamente a partir de consultas em texto, dispensando OCR. O post da Hugging Face coloca a recuperação visual de documentos entre os territórios de ponta da interação tardia, e a análise da TopK relata que um recuperador multi-vector compacto superou em +34% de recall no ViDoRe v3 um modelo de vetor único 80x maior; em documentos industriais, o recall saltou de aproximadamente 42% para 76%.
- Vocabulário fora do domínio. O post de lançamento da Hugging Face aponta ganhos em dados fora do domínio, nos quais a compressão aprendida por um modelo denso pode descartar detalhes necessários às consultas de produção.
Os números da Hugging Face ajudam a explicar por que a recuperação visual combina tão bem com essa arquitetura: uma página renderizada gera cerca de 755 vetores de token para colqwen2.5-v0.2, ante aproximadamente 125 em uma passagem de texto média. Quanto mais rica a página — gráficos, layout, tabelas —, mais informação um único vetor agregado precisaria jogar fora.
O ganho de qualidade existe, mas é menor que o discurso de marketing
A evidência mais limpa vem do par equivalente da LightOn: LateOn e DenseOn usam o mesmo backbone ModernBERT de 149M parâmetros e os mesmos dados de treinamento. A única diferença está na cabeça do modelo: vetores de token com 128 dimensões em um caso, um vetor de documento com 768 dimensões no outro.
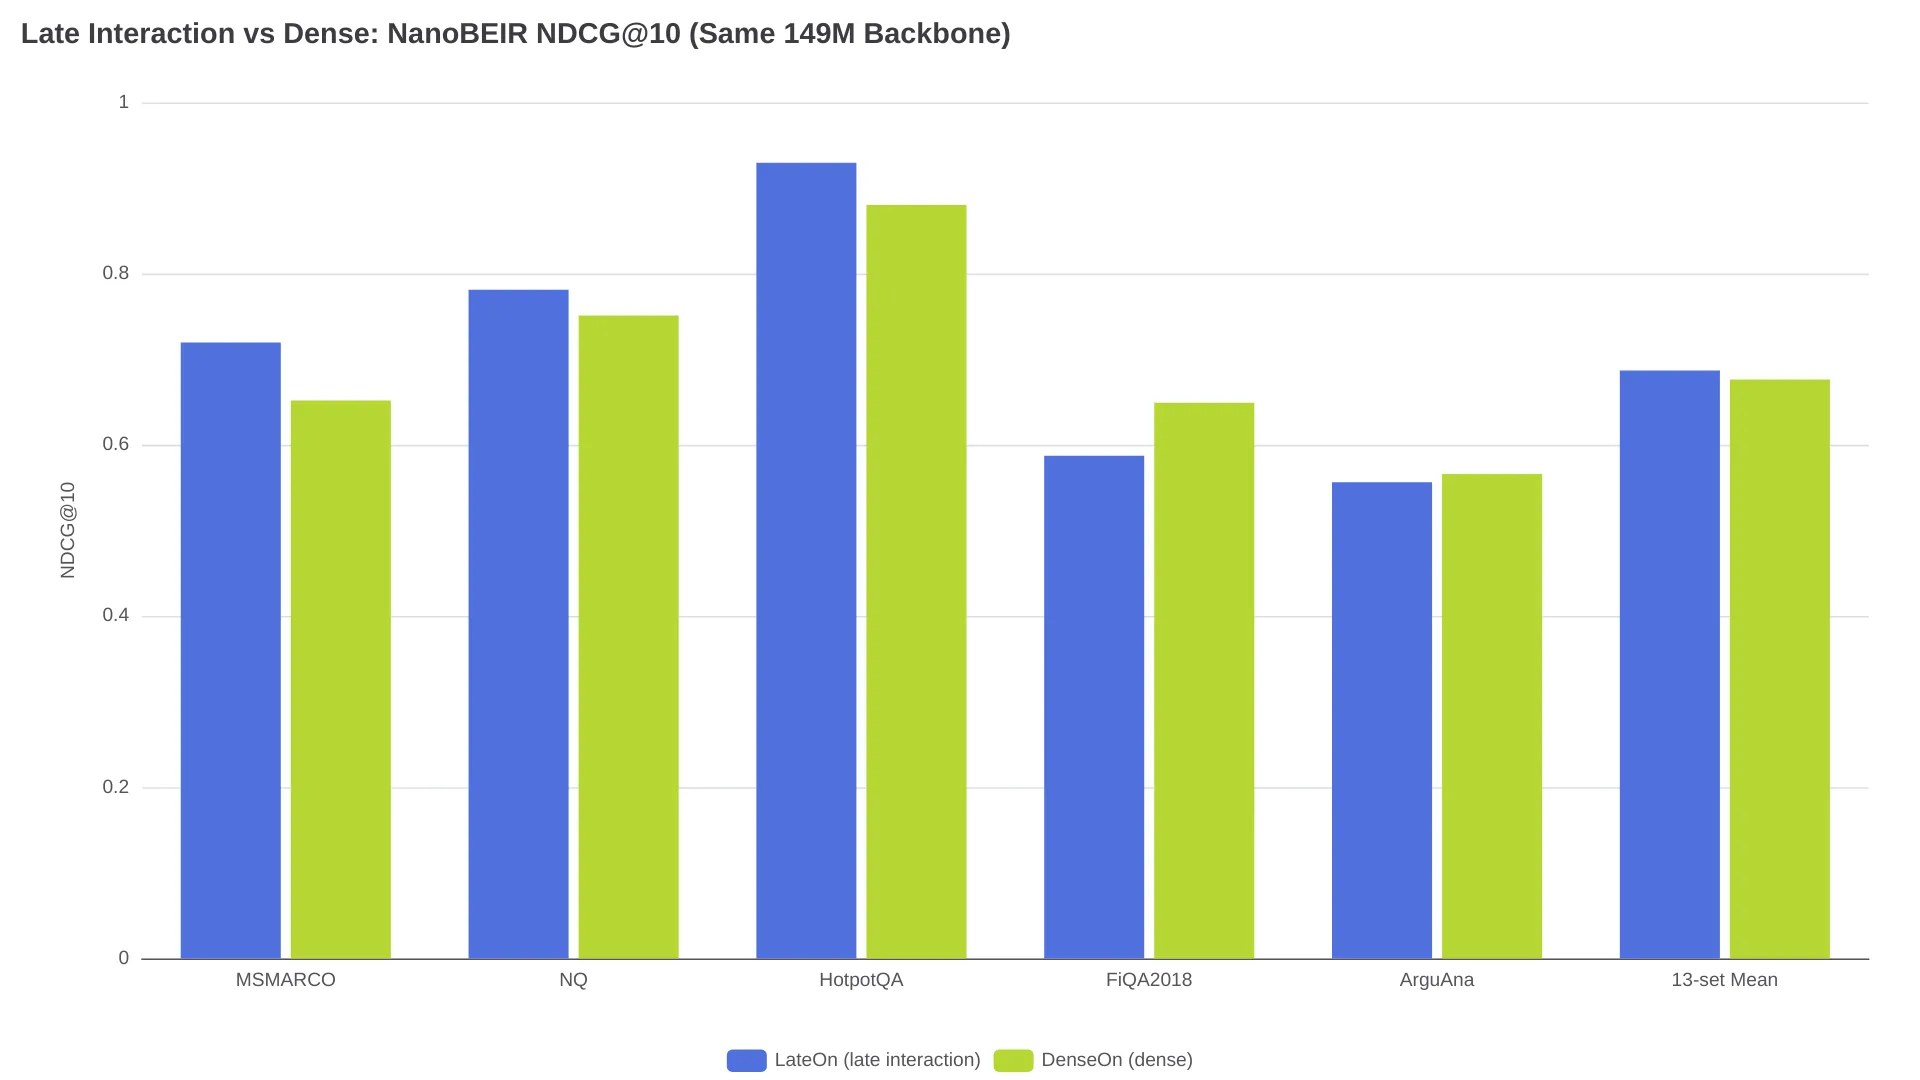
O LateOn vence em 9 dos 13 datasets NanoBEIR e também na média: 0.6868 contra 0.6764 em NDCG@10. No BEIR completo, com 15 datasets, o resultado é 57.22 contra 56.20. O DenseOn ainda vence diretamente em ArguAna, FiQA2018, SCIDOCS e SciFact. Esse é o retrato honesto: um ganho médio relevante com o mesmo tamanho de modelo, não uma mudança de categoria.
Depois que o mantenedor Tom Aarsen anunciou a v6.0, o desenvolvedor @saen_dev fez a pergunta que se repetia entre profissionais: "How does it benchmark against bi-encoders on domain-specific corpora?" (thread). A resposta honesta é cerca de um ponto na média, com os grandes ganhos concentrados em documentos longos. E o próprio post de lançamento da Hugging Face orienta os usuários a avaliarem sua própria tarefa de recuperação, porque os ganhos variam de dataset para dataset.
O custo de armazenamento: 42x antes de comprimir
O exemplo detalhado pela Hugging Face estima um índice sobre 4.874 passagens do Natural Questions. O lightonai/LateOn gera 608.414 vetores de token a partir delas, ou 124.8 vetores por passagem em média.
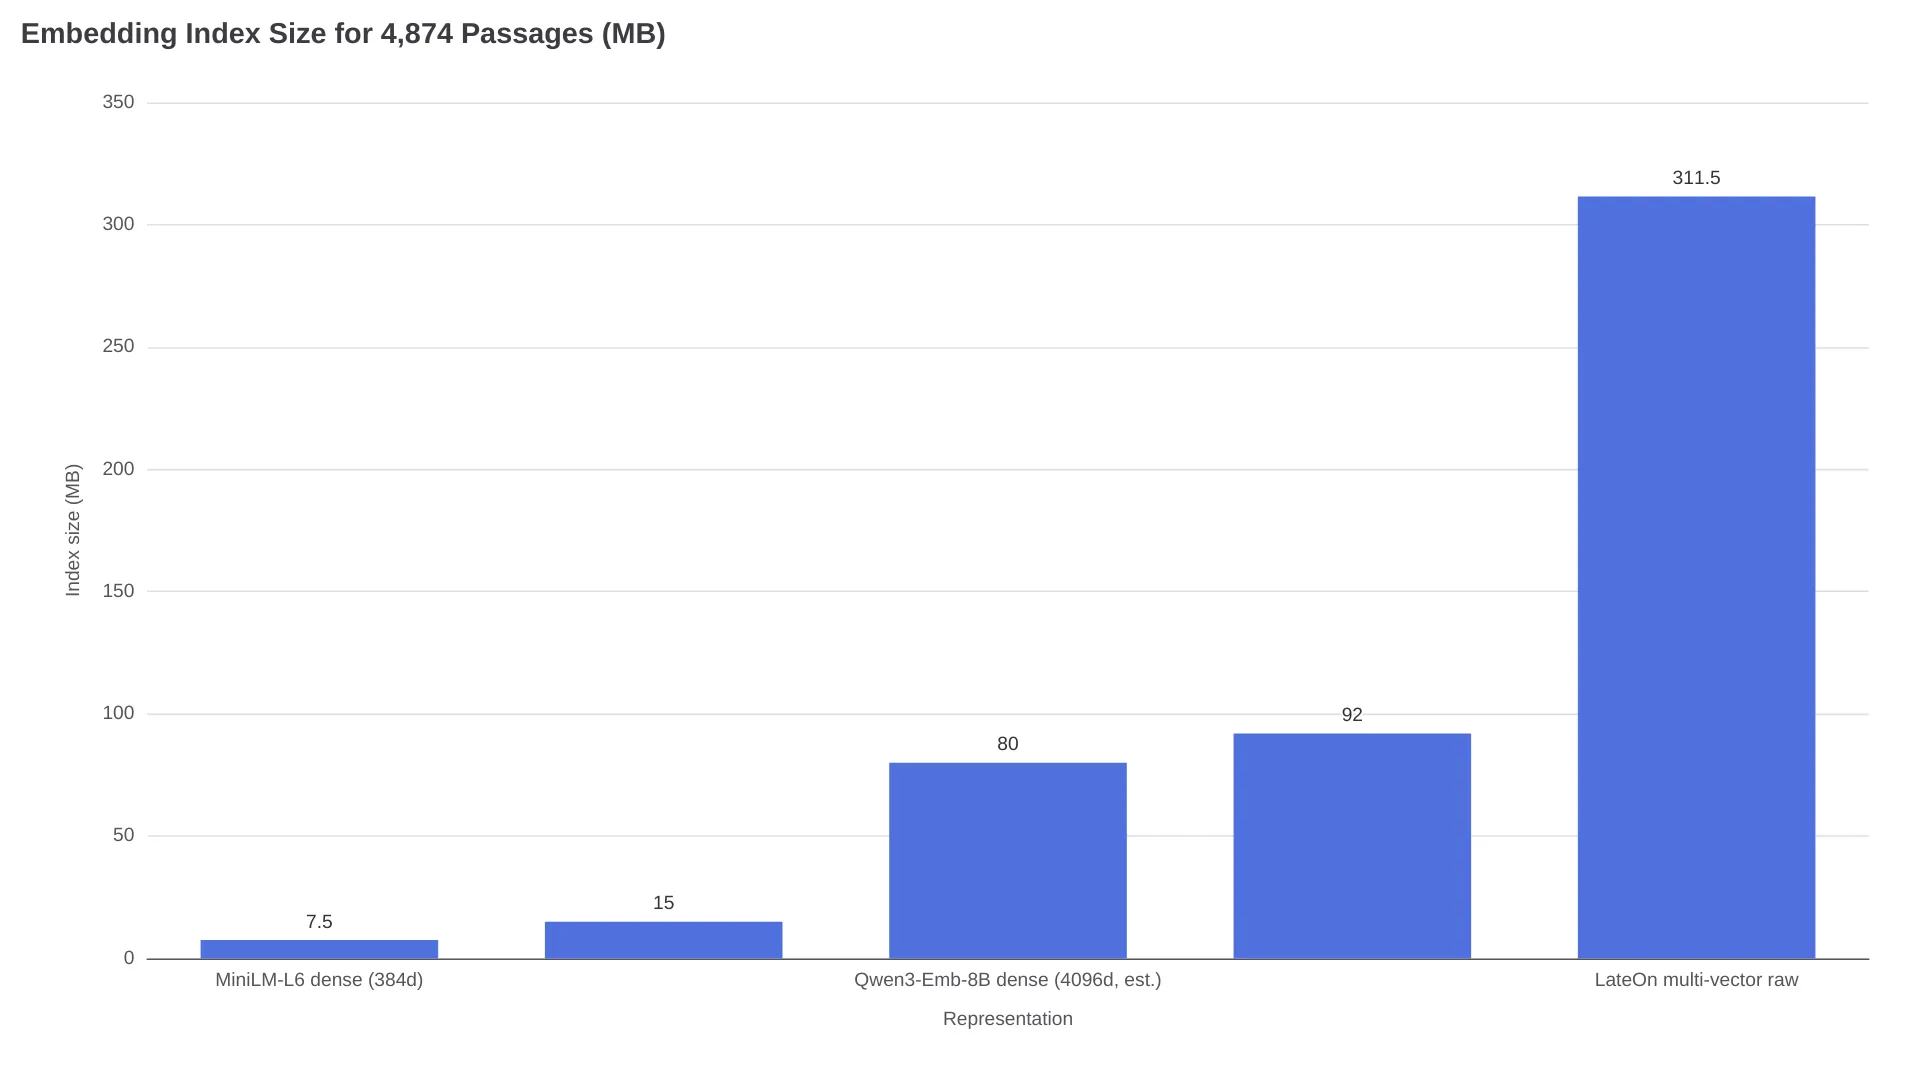
O índice multi-vector bruto em float32 ocupa 311.5 MB. Com as mesmas passagens, o modelo denso all-MiniLM-L6-v2 precisa de 7.5 MB — uma diferença de 42x, ou 62 KiB por passagem. Contra o gte-modernbert-base, um modelo denso de 768 dimensões da mesma classe, a diferença é de 21x (15 MB). A TopK cita uma faixa de 10–100x conforme o tamanho do documento e a precisão, além de estimar milhares de vezes mais trabalho de pontuação por consulta do que em uma comparação de vetor único.
No dia do lançamento, um desenvolvedor resumiu a preocupação de produção de forma direta:
Token pooling is the part that decides if this ships. Late interaction usually dies on index size and memory, not on accuracy. - @JudeJobs on X
Para colocar em escala: um índice denso Qwen3-Embedding-8B de 4.096 dimensões sobre o mesmo corpus ocupa cerca de 80 MB, próximo dos 92 MB do índice de interação tardia comprimido mostrado abaixo.
Três estratégias para reduzir o índice
1. Agrupamento de tokens. O Sentence Transformers v6.0 traz o HierarchicalTokenPooling, que agrupa vetores de tokens do documento com ligação de Ward sobre a distância de cosseno e substitui cada grupo pela sua média. Por padrão, o pooling é aplicado apenas aos documentos, já que as consultas são curtas e mais sensíveis a distorção. No corpus com 608.414 vetores:
| Fator de pooling | Vetores de token | Índice float32 | Retenção de recuperação reportada |
|---|---|---|---|
| 1 (nenhum) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | tendência de ~98% |
O pooling levou cerca de 6 segundos para o corpus inteiro. A variante regularizada da LightOn relata 99.4% de qualidade com compressão de 5x no post da Hugging Face, embora a empresa observe que o treinamento com esse regularizador ainda não estava integrado à biblioteca no lançamento da v6.0.
2. Índices comprimidos. Um índice fast-plaid (Rust PLAID) com os mesmos vetores ocupa 92 MB, foi construído em 5 segundos e respondeu em 11 ms em uma RTX 3090 + i7-13700K. É uma abordagem aproximada: as maiores pontuações caíram de 11.92 para 11.88 no teste da Hugging Face, mas o ranking foi preservado. O MUVERA da Weaviate tornou a ingestão 3x mais rápida e as consultas 1.8x mais rápidas, embora tenha deixado de fora um resultado correto do top 50 no corpus de teste.
3. Quantização e ajustes de inferência. Nos experimentos da Qdrant, a quantização escalar uint8 dos embeddings de token reduziu a memória em 4x, enquanto o NDCG@10 no SciFact passou de 0.70724 para 0.70297 — uma variação desprezível. A Hugging Face informa que fp16 com Flash Attention entrega 2.44x o throughput de codificação em fp32 sem perda de qualidade medida; no CPU, int8 custa cerca de 0.4% de precisão.
Ao combinar pooling com fator 2–3, um índice comprimido e esses ajustes, a diferença efetiva para um modelo denso cai de 42x para um dígito, ao custo de mais dois parâmetros para calibrar.
Para produção, o padrão é usar como reranker
O MaxSim exaustivo pontuou todos os 4.874 documentos em 98 ms (122.7 ms de ponta a ponta) em uma única RTX 3090 — perfeitamente aceitável para alguns milhares de documentos, mas um desastre de custo linear para milhões. Os três guias de implantação comparados aqui chegam à mesma arquitetura: uma primeira etapa barata, densa ou esparsa, recupera candidatos; a interação tardia faz o reranking.
- O exemplo da Hugging Face recupera os 50 melhores resultados densos e então reordena com MaxSim. Os documentos são codificados uma vez em lote e pontuados por multiplicação de matrizes, muito mais barato que a passagem forward por par de um cross-encoder.
- A Qdrant, que oferece suporte nativo a multi-vector desde a v1.10, recomenda a interação tardia principalmente para reranquear algumas centenas de candidatos, não para varreduras completas.
- O guia de produção do Data AI Hub recomenda recuperação híbrida do top 150, reranking por interação tardia até 20 e, opcionalmente, um cross-encoder para os 5 resultados finais enviados ao LLM.
O modelo somente de reranking tem um limite inevitável: ele não consegue recuperar documentos que a primeira etapa deixou passar. E o restante do pipeline está longe de ser consenso:
there is hardly a universally good chunking, retrieval and re-ranking strategy. - u/gamerx88, r/MachineLearning
Quais bancos de dados oferecem suporte — e com que maturidade
O post de lançamento da Hugging Face compara os principais motores no mesmo corpus de 4.874 passagens. Os números abaixo são resultados do teste deles, não material de marketing dos fornecedores:
| Motor | Multi-vector nativo desde | Ingestão / consulta (teste deles) | Ressalvas |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | MAX_SIM exato; servidor recomendado |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA é mais rápido, mas perdeu um resultado correto; não há modo embarcado no Windows |
| Vespa | "for years" | ~80 s / 75 ms aquecido | MaxSim como expressão tensorial; a segunda fase padrão reordena só 100 candidatos e deixou de fora 2 dos 3 resultados corretos do topo |
fast-plaid | - | 5 s / 11 ms | Sem servidor; pontuações aproximadas, ranking preservado |
| LanceDB | v0.15.0 | não testado | MaxSim nativo |
| Milvus | v2.6.4 | não testado | Armazenamento array-of-structs |
| VectorChord | - | não testado | Operador MaxSim para PostgreSQL |
| Elasticsearch / OpenSearch | - | - | Apenas rescore; o recurso do ES é uma prévia técnica no plano Enterprise |
A indexação de interação tardia do turbopuffer aparecia como beta privado na tabela comparativa da Hugging Face.
O que muda com o Sentence Transformers v6.0
Antes de 18 de agosto de 2026, executar modelos da família ColBERT exigia frameworks separados: PyLate, o repositório Stanford ColBERT ou colpali-engine. A versão 6.0 transforma o MultiVectorEncoder no quarto tipo de modelo de primeira classe da biblioteca, com treinamento, inferência e interpretabilidade integrados. Ele carrega checkpoints do Sentence Transformers, PyLate, Stanford ColBERT e ColPali; também aceita um transformer puro, mas usa uma projeção aleatória que exige treinamento. Os requisitos são transformers v5.x, torch 2.2+ e huggingface-hub v1.x.
Três armadilhas da documentação de lançamento:
- Consultas e documentos são assimétricos.
encode_query()eencode_document()aplicam prompts, limites de tamanho e máscaras de pontuação diferentes. Usar oencode()genérico para ambos é a forma mais rápida de degradar os resultados sem perceber. - O truncamento é silencioso. Uma passagem de 662 tokens enviada ao limite de 300 tokens de documento do LateOn produziu 273 vetores; o restante foi descartado. Elevar o limite para 512 funciona, mas afasta o modelo da distribuição de treinamento e aumenta o índice.
- Flash Attention tem exceções. Modelos com expansão de consulta sem atenção, incluindo
colbert-ir/colbertv2.0eanswerai-colbert-small-v1, precisam usar"sdpa".
Segundo os scores publicados pela Hugging Face, o catálogo de modelos suportados cobre duas ordens de magnitude:
| Categoria | Modelo de exemplo (parâmetros) | Score (NDCG@10 médio) |
|---|---|---|
| Texto para edge | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| Texto pequeno | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| Líder em texto | LateOn family (149M) | 0.6868–0.6897 NanoBEIR |
| Documento visual | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
Quando um único vetor denso continua sendo a escolha certa
O erro a evitar é adotar multi-vector em cargas que não precisam disso. Deixe de lado essa abordagem quando as consultas forem amplas e temáticas, como "artigos sobre cadeias de suprimentos"; quando os textos forem curtos, como títulos, pares de FAQ e tweets; quando a tarefa for clusterização, deduplicação ou recomendação — qualquer caso que dependa da similaridade do item inteiro —; ou quando um pipeline denso com reranker já cumpre seus SLOs de recall e a restrição principal é custo. O guia do Data AI Hub acrescenta que checkpoints ColBERT centrados em inglês podem ter desempenho inferior a uma pilha de bi-encoder multilíngue com reranker em corpora multilíngues, e que corpora com muitas escritas e atualizações em tempo real não combinam bem com índices no nível do token.
Perguntas frequentes, com números
É possível usar um modelo denso convencional como modelo multi-vector?
Em alguns casos, e com resultados surpreendentemente bons. Os experimentos da Qdrant usaram os embeddings de token de saída do BAAI/bge-small-en — um modelo denso de 33M — e os pontuaram com MaxSim: 0.73696 de NDCG@10 no SciFact, superando o colbert-ir/colbertv2.0, com 0.69579, e o próprio vetor agregado do bge-small, com 0.68213. No ArguAna, a ordem se inverteu e o denso agregado venceu. É um recurso válido para adicionar uma etapa de reranking sem trocar de modelo, não uma garantia.
Quanto mais rápido é um índice multi-vector comprimido?
No corpus de 4.874 passagens: MaxSim exaustivo em 98 ms, contra 11 ms do fast-plaid, ocupando 92 MB em vez de 311.5 MB.
Modelos multi-vector substituem rerankers cross-encoder?
Do ponto de vista econômico, sim: as representações dos documentos são pré-calculadas e pontuadas por multiplicação de matrizes, em vez de exigir uma passagem forward para cada par consulta-documento. O post de lançamento da Hugging Face ainda classifica o cross-encoder como a opção mais precisa por par, razão pela qual pipelines exigentes o mantêm para os 5–20 resultados finais.
Interação tardia vale a pena para RAG?
Como etapa de reranking sobre candidatos híbridos ou densos, sim — é o padrão recomendado pelos três guias de implantação citados acima. Como recuperador de primeira etapa, só quando o recall medido nessa primeira etapa é a origem do problema e o índice de vetores de token cabe no seu orçamento.
Tabela de decisão
| Sua carga de trabalho | Recomendação |
|---|---|
| Consultas ricas em identificadores ou com várias partes, documentos longos, texto jurídico/técnico | Recuperação ou reranking multi-vector — este é o território dos +26 pontos no MLDR |
| PDFs, páginas digitalizadas, tabelas e gráficos como imagens de página | Multi-vector da família ColPali; não é necessário pipeline de OCR |
| Busca temática ampla, textos curtos, clusterização/deduplicação/sistemas de recomendação | Vetores densos únicos; perdas de agregação são irrelevantes aqui |
| Qualidade quase suficiente, orçamento limitado | Mantenha a primeira etapa densa e adicione reranking MaxSim aos 50–150 melhores |
| Milhões de documentos, com custo como restrição | Denso + reranker cross-encoder, ou interação tardia comprimida (pooling fator 2–3 + fast-plaid) depois de medir |
Permanece em aberto a troca apontada por @JudeJobs: a retenção após compressão é medida em benchmarks, não em corpora de produção desorganizados. Comece com pooling no fator 2 e deixe o recall medido nos seus próprios dados definir até onde avançar na curva de compressão.