 AIREITER
Um contexto de 1 milhão de tokens e uma tarifa de US$ 0,68 por milhão de tokens de entrada fazem o Mistral Large 4 parecer barato demais para um modelo com 1 trilhão de parâmetros. O detalhe é que ainda estamos falando de um preview público: não há uma data clara para o fim do preço promocional, os limites dos gateways variam em relação à especificação divulgada e a licença dos futuros pesos ainda não foi publicada.
A decisão em um minuto
Vale testar o Mistral Large 4 agora se você precisa de uma API barata, com contexto longo, para documentos, repositórios de código ou fluxos de trabalho que usam ferramentas. Ainda é cedo para tratá-lo como substituto estável para implantação própria ou como líder comprovado em benchmarks de programação.
| Necessidade | Decisão |
|---|---|
| Testar documentos longos ou bases de código grandes por uma API | Teste agora, monitorando a taxa de acerto do cache e o custo de saída |
| Precisa de um preço previsível no longo prazo | Espere ou reserve orçamento para a tarifa mais alta de US$ 1,36 na entrada e US$ 4,18 na saída |
| Precisa de implantação privada | Espere pelos pesos, pela licença, pela quantização e pelas orientações de serving |
| Precisa da melhor pontuação em programação | Não escolha apenas com base nos números do lançamento; rode o mesmo harness nas suas tarefas |
Esta é uma decisão sobre uma API em preview público, não um veredito definitivo sobre o modelo. A Mistral anunciou o preview em 6 de outubro de 2026, e seus materiais públicos dizem que os pesos estão planejados para o fim de outubro. (Anúncio da Mistral)
O que está disponível de fato em 6 de outubro
O Mistral Large 4 está disponível como API em preview público por meio do Mistral Studio. A Mistral o descreve como um modelo multimodal nativo, baseado em mixture of experts, com 1,05 trilhão de parâmetros totais e 49 bilhões de parâmetros ativos por token. O anúncio oficial também menciona chamadas de função, saídas estruturadas, perguntas e respostas sobre documentos, processamento em lote, agentes e ferramentas integradas.
O modelo também aparece listado como mistralai/mistral-large-4-0 na OpenRouter. Portanto, o acesso pela OpenRouter já não é apenas um rumor do dia do lançamento. Limites, latência, cobrança e política de fallback podem variar conforme a rota.
A API está ativa, mas os pesos para download e a licença final ainda não estão disponíveis. “Open weight” não deve ser interpretado como código aberto comercial irrestrito até que a Mistral publique o model card e os termos de uso.
O preço aparece em dois níveis — e há um motivo
As tarifas atuais do preview, exibidas na documentação do modelo da Mistral, são bastante atraentes:
| Tipo de token | Tarifa do preview | Possível tarifa pós-preview exibida nos materiais de lançamento |
|---|---|---|
| Entrada | US$ 0,68 / 1 milhão de tokens | US$ 1,36 / 1 milhão de tokens |
| Entrada em cache | US$ 0,07 / 1 milhão de tokens | US$ 0,14 / 1 milhão de tokens |
| Saída | US$ 2,09 / 1 milhão de tokens | US$ 4,18 / 1 milhão de tokens |
Os valores mais baixos são apresentados como preços promocionais de 50% durante o preview na página do gateway da Vercel e em outras páginas de acesso ao modelo, mas nenhuma data de encerramento é informada. Considere US$ 0,68 e US$ 2,09 como as tarifas atuais, não como um contrato permanente.
Em uma carga de trabalho com 500.000 tokens de entrada sem cache e 100.000 tokens de saída, a cobrança do preview fica em aproximadamente US$ 0,55: US$ 0,34 pela entrada mais US$ 0,209 pela saída. Se a entrada estiver em cache, o total cai para cerca de US$ 0,244: US$ 0,035 pela entrada em cache mais US$ 0,209 pela saída. Antes de migrar tráfego de produção, avalie o reaproveitamento do cache, o volume de saída e a durabilidade do desconto.
Contexto e recursos dependem da rota usada
A documentação do modelo da Mistral descreve uma janela de contexto de 1 milhão de tokens. Essa é uma especificação do modelo, não necessariamente o limite exposto por todos os gateways.
A página do AI Gateway da Vercel lista atualmente uma janela de contexto compartilhada de 524 mil tokens e uma saída máxima de 262 mil tokens para seu provedor Mistral. A página também informa tempo P50 até o primeiro token de 0,9 segundo, 38 tokens por segundo e uma taxa de acerto de cache de 74%, com base no tráfego do gateway.
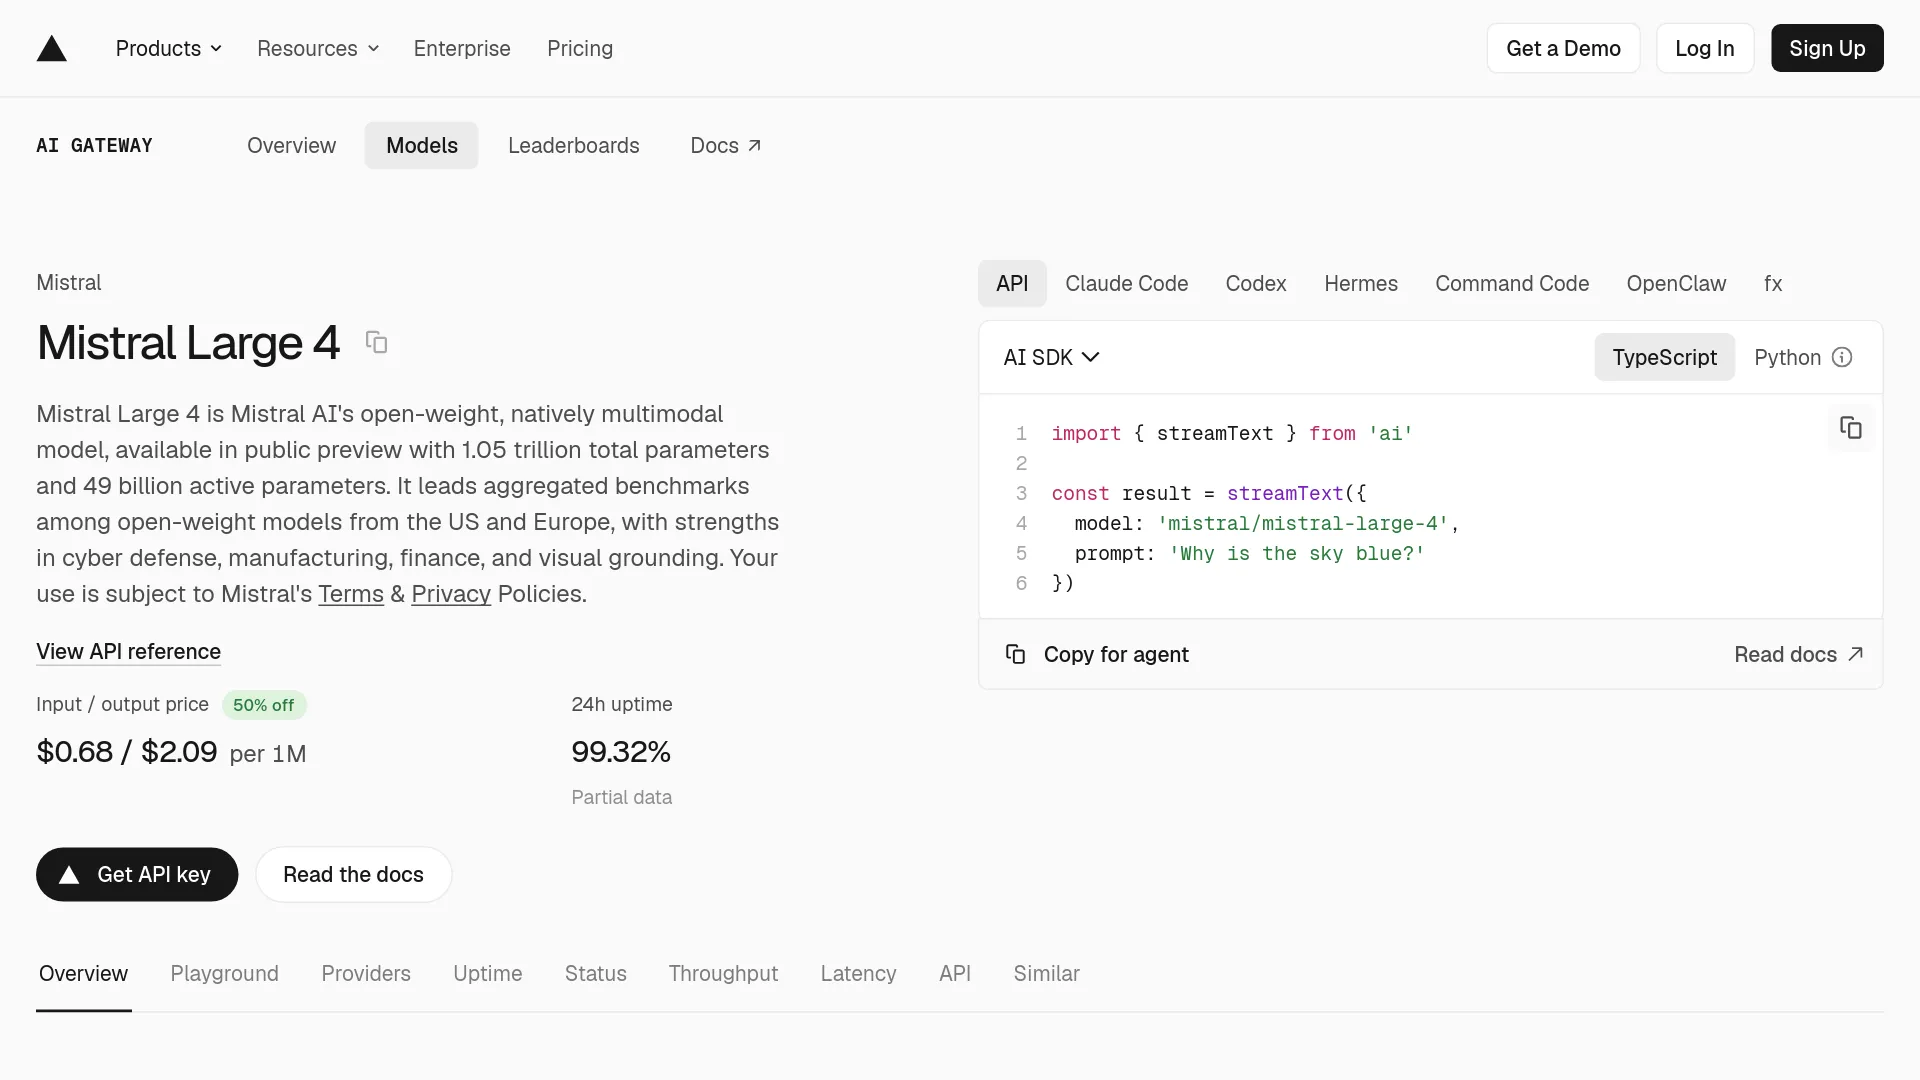
Esses são números específicos da rota, não garantias universais do modelo. A página documenta entrada de imagens, chamadas de ferramentas, APIs Chat Completions e Responses compatíveis com a OpenAI e acesso Messages compatível com a Anthropic. O ID do gateway é mistral/mistral-large-4, diferente do identificador qualificado do provedor usado pela OpenRouter.
Em uma integração, confirme o contexto compartilhado do endpoint, o limite de saída, o cálculo de imagens e tokens, o comportamento das ferramentas, a política de cache, o roteamento entre provedores e as regras de fallback. A marca de 1 milhão de tokens é útil para uma triagem inicial, mas não basta para dimensionar uma aplicação.
O que as evidências dos benchmarks permitem concluir
A análise de lançamento da TechsCurrent relata os números divulgados pela Mistral: 61,7% no DeepSWE v1.1, 28,3% no Terminal-Bench 4 e 59,9% no AutomationBench. A comparação de lançamento da CellCog cita 74,2 para o DeepSeek V4.1 Flash no DeepSWE e 61,7 para o Mistral Large 4, enquanto o número do Mistral no AutomationBench é superior ao das linhas usadas na comparação. São sinais divulgados pelo fornecedor ou reunidos de fontes diferentes, não resultados de um único ranking padronizado.
Antes de usar o modelo em agentes de produção, faça uma avaliação controlada:
- Use o mesmo repositório, prompt, ferramentas e tempo limite para o Mistral Large 4 e o modelo atual.
- Meça conclusão das tarefas, erros nos argumentos das ferramentas, novas tentativas, latência, tokens de saída e custo.
- Inclua casos de recuperação em contexto longo nos quais a resposta apareça no meio e perto do fim da entrada.
- Repita o teste com contexto em cache e sem cache.
- Mantenha os resultados do preview separados dos resultados obtidos após o futuro lançamento dos pesos.
Quem já pode usar o modelo
Equipes API-first com contexto recorrente e volumoso: Testem o Mistral Large 4 agora. A tarifa de US$ 0,07 por milhão de tokens de entrada em cache pode fazer diferença quando um agente envia repetidamente o mesmo prefixo de política, repositório ou documento. Defina um teto de gastos para o experimento, porque a tarifa mais alta continua sendo uma possibilidade real.
Equipes que desenvolvem fluxos de documentos com imagens: Testem a entrada de imagens e a extração de documentos na rota que pretendem usar em produção. O modelo aceita imagens, mas os limites de arquivos e os detalhes de cobrança específicos da rota ainda precisam ser verificados.
Equipes de agentes de programação: Tratem o modelo como candidato, não como vencedor automático. Os benchmarks divulgados são mistos, e a confiabilidade real depende das chamadas de ferramentas, das novas tentativas e da taxa de conclusão.
Equipes preocupadas com privacidade ou interessadas em hospedar o modelo: Esperem pelos pesos e pela licença. O número de 49 bilhões de parâmetros ativos não significa que o checkpoint completo seja pequeno; o modelo total ainda precisará ser armazenado e servido. Hardware, quantização, throughput e direitos de redistribuição continuam sem definição.
FAQ sobre a API do Mistral Large 4
O Mistral Large 4 já é open source?
Não. No lançamento, a licença final e os pesos para download ainda não estavam disponíveis. A Mistral planejava liberar os pesos até o fim de outubro de 2026, mas o termo “open weight”, por si só, não define os direitos comerciais ou de redistribuição.
O preço de US$ 0,68 é permanente?
Não há uma data de encerramento informada. Faça os testes considerando as tarifas atuais de US$ 0,68 na entrada e US$ 2,09 na saída, mas modele também os valores de US$ 1,36 e US$ 4,18.
A janela de contexto é de 1 milhão ou 524 mil tokens?
A Mistral documenta um contexto de 1 milhão de tokens para o modelo; a Vercel lista 524 mil tokens de contexto compartilhado em sua rota de gateway. Confirme o limite do provedor e do formato de API que você pretende chamar.
O modelo já está na OpenRouter?
Sim. A OpenRouter lista atualmente o modelo mistralai/mistral-large-4-0. Consulte a página atualizada antes da implantação, pois o roteamento de um preview pode mudar.
Ele processa imagens e usa ferramentas?
A documentação oficial e a do gateway descrevem entrada de imagens e chamadas de ferramentas. Teste o formato da requisição, os limites de imagem, o cálculo de tokens e o comportamento diante de chamadas de ferramentas malformadas na rota escolhida.
Devo hospedar o modelo quando os pesos forem liberados?
Não automaticamente. Espere pela licença, pelos formatos dos checkpoints, pelas opções de quantização, pelos requisitos de memória, pelos dados de throughput e por uma configuração de serving de referência.
O próximo teste que vale a pena fazer
Monte uma avaliação com 20 tarefas antes de direcionar tráfego real: cinco tarefas de recuperação em contexto longo, cinco alterações de código, cinco perguntas sobre imagens e documentos e cinco tarefas de chamada de ferramentas. Registre a taxa de sucesso, as novas tentativas, o tempo até o primeiro token, a latência total, os tokens de entrada, cache e saída e o custo efetivo por tarefa concluída.
Fontes: documentação do modelo da Mistral, anúncio da Mistral, Vercel AI Gateway, página do modelo na OpenRouter, TechsCurrent, CellCog.