 AIREITER
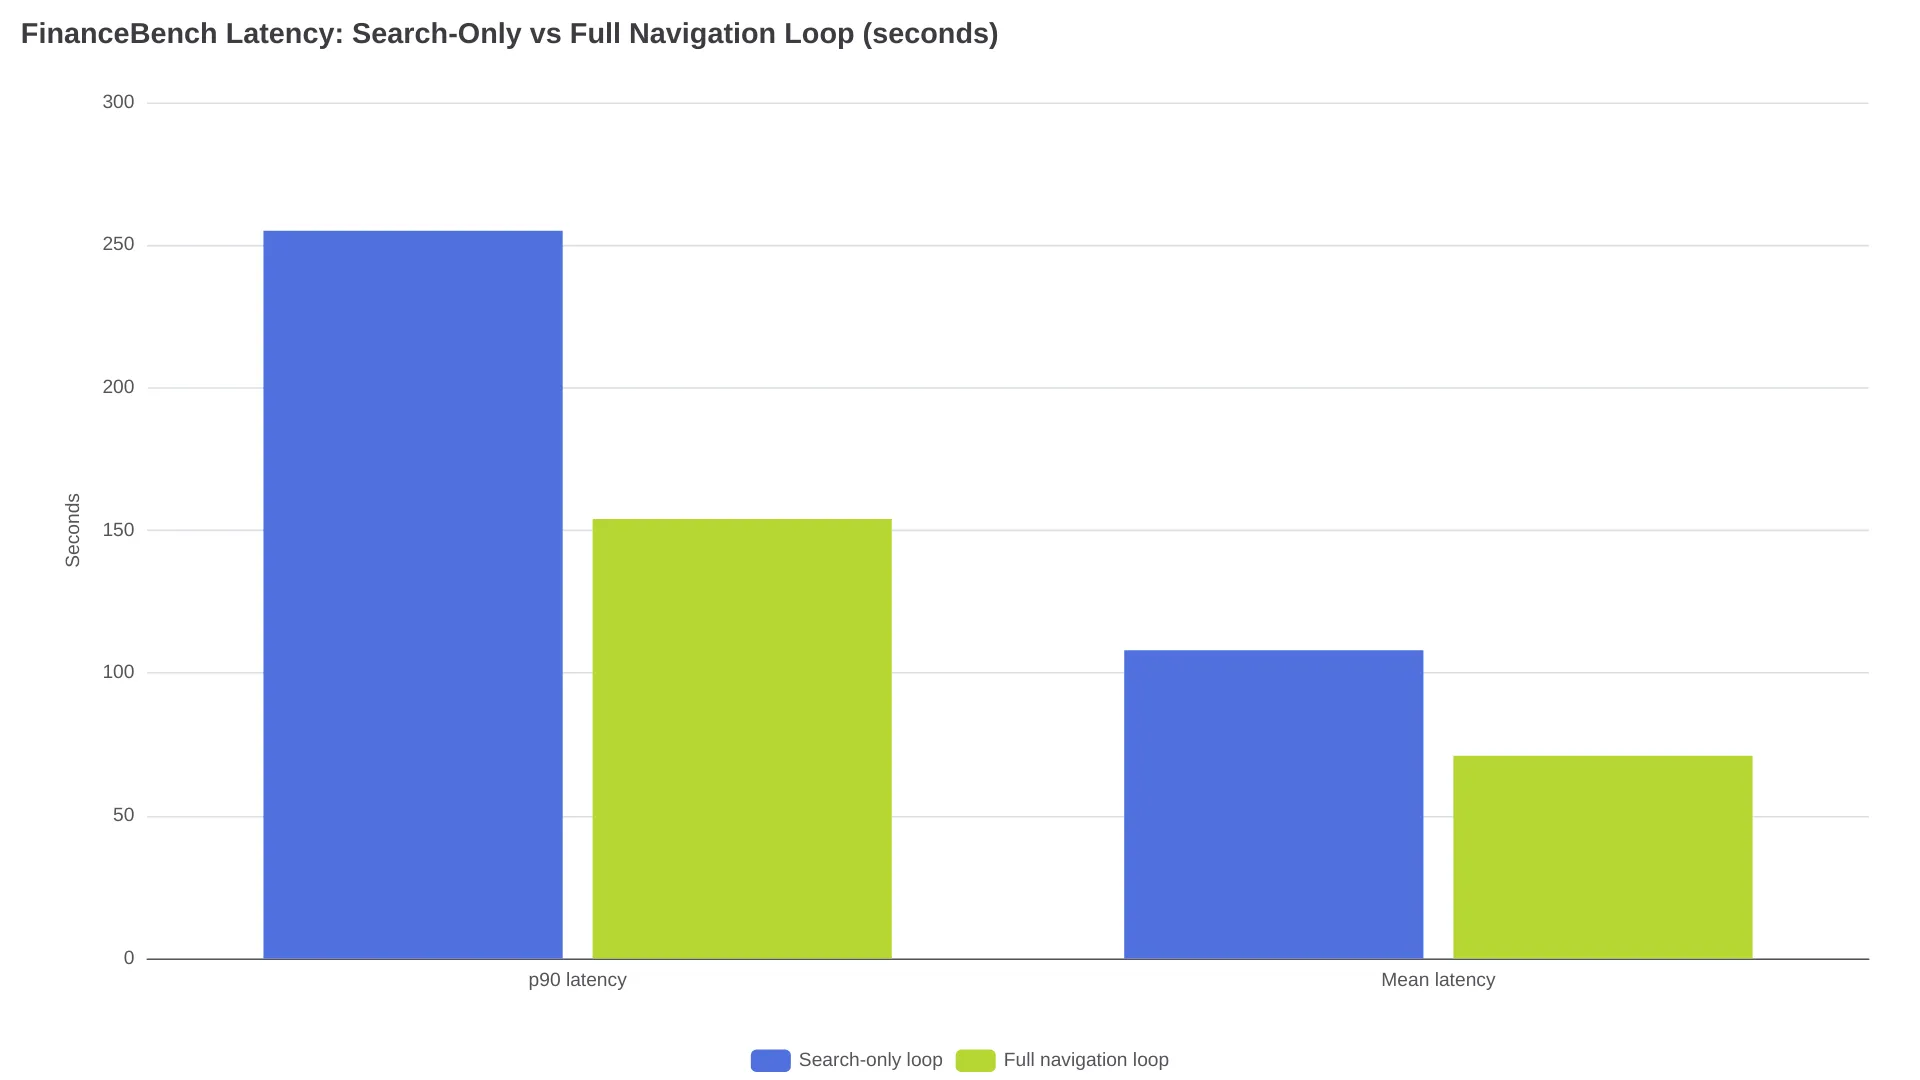
No FinanceBench, que reúne 368 documentos da SEC, cerca de 53.900 páginas e 150 perguntas, a Mistral afirma que sua nova camada Agentic Search elevou a precisão das respostas em 47 a 53 pontos percentuais sobre o RAG de passagem única usando um ciclo apenas de busca. Com o ciclo completo de navegação, o ganho chega a 59 pontos e o consumo de tokens cai em até um terço. O custo aparece na latência: o ciclo completo ainda leva 154 segundos no p90 e 71 segundos, em média.
Anunciado em 20 de agosto de 2026, o Mistral Agentic Search é uma camada de recuperação voltada a acervos corporativos difíceis, como documentos regulatórios, contratos e PDFs digitalizados. Não se trata de uma melhoria para busca na web. A espera de minutos é o preço cobrado pela maior precisão.
Como funciona o Mistral Agentic Search
Lançado em 20 de agosto de 2026, o Mistral Agentic Search adiciona um ciclo de múltiplas etapas a um índice já existente. Ele usa cinco ferramentas: search, open, navigate, read e grep. Está disponível no Mistral Search Toolkit e integrado às Libraries do Studio e do Vibe. O índice continua sendo seu, sem necessidade de fine-tuning; o ciclo agêntico assume as perguntas que a recuperação de chunks, sozinha, não consegue resolver.
O ciclo de cinco ferramentas na prática
O exemplo da própria Mistral ajuda a visualizar o processo: os gastos de defesa nacional dos Estados Unidos no ano-calendário de 1953. Uma única chamada de busca encontrou os números de janeiro a junho, mas deixou de fora o período entre julho e dezembro. No caminho agêntico, foram feitas duas buscas, o documento treasury_bulletin_1954_02.pdf foi identificado e, em seguida, a página 15, Tabela 3, foi lida. O resultado trouxe os valores dos doze meses, totalizando 44.463 milhões de dólares no ano.
| Ferramenta | Função |
|---|---|
search | Consulta o índice em busca das fontes mais prováveis |
open | Abre um documento localizado |
navigate | Vai até páginas, tabelas ou seções dentro do documento |
read | Extrai o conteúdo daquele ponto |
grep | Localiza padrões de tokens, códigos ou identificadores exatos |
O RAG de passagem única recupera um conjunto fixo de chunks e precisa responder de uma vez; se a recuperação for fraca, ele não consegue pedir outro documento. Já o ciclo pode comparar fontes, seguir referências em notas de rodapé e tabelas e se recuperar de resultados parciais. Segundo a Mistral, a troca envolve menos tentativas e interações desperdiçadas, não mais.
O que os benchmarks mostram de fato
O anúncio traz duas suítes de benchmark, ambas reportadas pela fornecedora e executadas com as configurações padrão do Search Toolkit, sem ajustes. Nas palavras da Mistral, “estes resultados são pisos, não tetos”. O FinanceBench (Islam et al., 2023; lançamento aberto no GitHub) reúne 368 documentos 10-K, 10-Q e 8-K da SEC, com cerca de 147 páginas cada segundo a contagem da Mistral, e 150 perguntas. Na configuração da empresa, as respostas são avaliadas por um LLM calibrado com rótulos humanos.
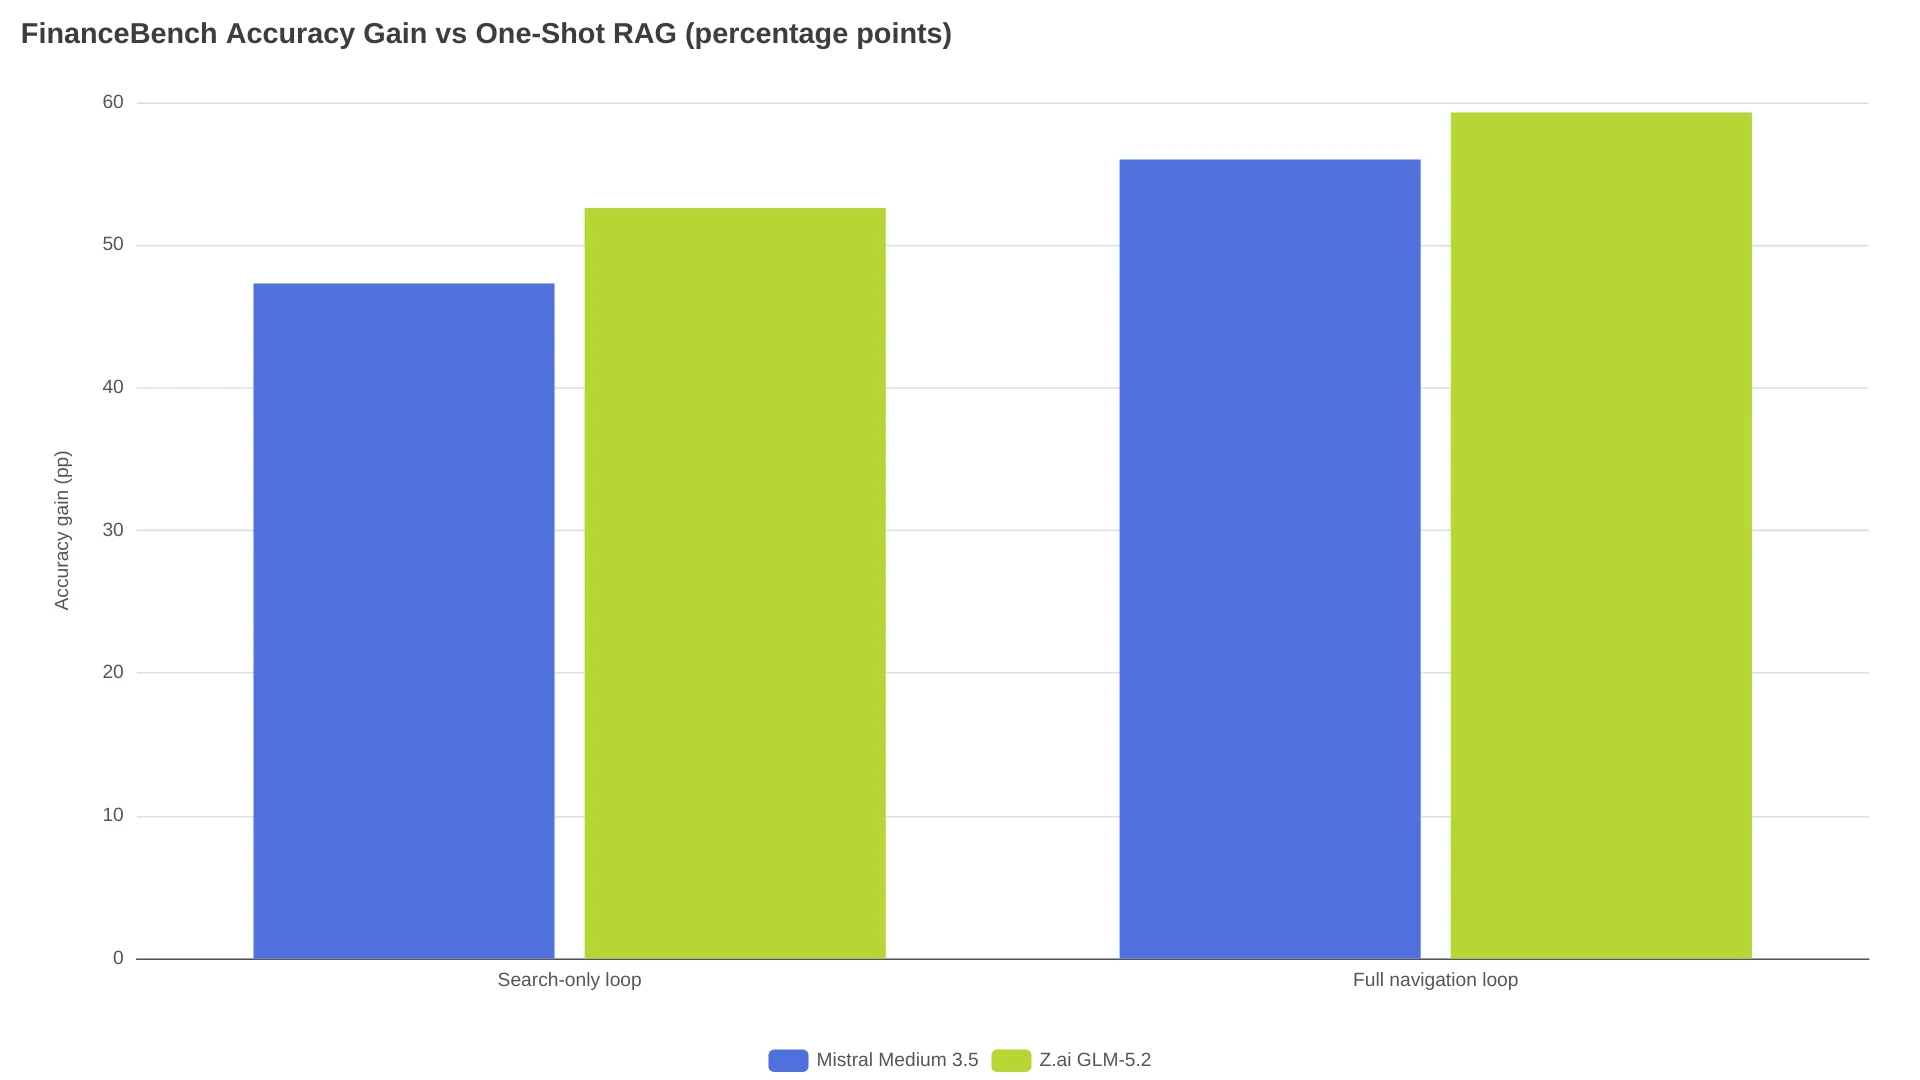
Incluir as ferramentas de navegação — open, navigate, read e grep — sobre o ciclo somente de busca acrescentou mais 8,7 p.p. para o Mistral Medium 3.5 e 6,7 p.p. para o GLM-5.2. Em relação ao ciclo agêntico apenas de busca, o ciclo completo de navegação consumiu 23,9% menos tokens com o Mistral Medium 3.5 e 33,7% menos com o GLM-5.2. A latência também melhora: o p90 cai de 255 para 154 segundos, e a média, de 108 para 71 segundos. Vale destacar a base de comparação: a redução de tokens é medida contra o ciclo agêntico somente de busca, não contra o RAG de passagem única.
O OfficeQA Pro é a suíte mais difícil: são 696 edições históricas dos Treasury Bulletins dos Estados Unidos, cerca de 89.000 páginas de PDFs governamentais digitalizados e repletos de tabelas, além de 133 perguntas. Com o ciclo completo, o GLM-5.2 alcançou 51,9% de precisão, um salto de 45,6 p.p. que implica uma base de 6,3% em passagem única; o Mistral Medium 3.5 melhorou 27,1 p.p. A navegação também reduziu em até 7,0% o número de interações.
A Mistral avaliou seu próprio Mistral Medium 3.5 e o Z.ai GLM-5.2, de terceiros, e ambos apresentaram ganhos no mesmo padrão. O anúncio também cita uma pesquisa da Kimi segundo a qual o GLM-5.2 obtém 41,4% no OfficeQA Pro sob uma infraestrutura Claude Code, contra 51,9% na infraestrutura da Mistral. Não há link para uma fonte primária da Kimi; portanto, essa diferença de 10,5 p.p. entre infraestruturas é uma caracterização da Mistral. A conclusão da empresa — “a qualidade da recuperação escala com a capacidade do modelo” — é que o gargalo está na infraestrutura, não no modelo.
Quando o RAG de passagem única continua sendo melhor
A própria Mistral diz que a recuperação indexada segue sendo a base, e que o ciclo agêntico entra em cena quando os resultados iniciais não bastam. A decisão depende principalmente do formato dos documentos e do orçamento de latência:
| Seu tipo de carga | Melhor ponto de partida |
|---|---|
| Consultas diretas em documentos curtos e limpos | RAG de passagem única |
| Recuperação semântica ou por palavras-chave em alto volume | RAG de passagem única |
| Respostas em locais já conhecidos | RAG de passagem única |
| Documentos regulatórios, contratos e manuais com tabelas e notas de rodapé | Agentic Search |
| PDFs digitalizados e com muitas tabelas | Agentic Search |
| Respostas distribuídas entre vários documentos que exigem conciliação | Agentic Search |
| Exigência de latência interativa, em segundos | RAG de passagem única |
Se um p90 de 154 segundos inviabiliza seu produto, nenhum ganho de precisão resolve o problema. Para análise em lote de demonstrações financeiras, a história é outra.
Agentic Search não é a ferramenta web_search
Ao pesquisar esse produto, o Google exibe a documentação de websearch da Mistral — mas é outra coisa. As ferramentas web_search e web_search_premium pertencem à Agents API e fazem recuperação na web ao vivo, com citações. Elas custam, respectivamente, US$ 30 e US$ 50 por 1.000 chamadas na página de preços da API da Mistral, além dos tokens do modelo. O Agentic Search segue na direção oposta: investiga seu próprio acervo indexado e não consulta a web aberta. São problemas diferentes, e apenas um deles tem preço publicado; não há valores para o Agentic Search no anúncio.
Dois caminhos para começar
- Search Toolkit. Módulos abertos para ingestão, embeddings e indexação, implantáveis em nuvem ou em ambientes on-premises, com parsers, chunking, modelos de embedding, esquemas Vespa, perfis de ranking e recuperação híbrida configuráveis.
- Libraries no Studio e no Vibe. A opção gerenciada. Um Search Starter App pode criar um índice local sobre seu acervo usando a configuração padrão, o caminho mais rápido para reproduzir o setup do benchmark antes de ajustar qualquer coisa.
Independentemente do caminho, passe as mesmas perguntas representativas pelo RAG de passagem única e pelo ciclo completo. Compare a qualidade das respostas, o uso de tokens e a latência p90 antes de se comprometer.
O que ainda não está claro no lançamento
A Mistral não publicou preços do Agentic Search, e os resultados dos benchmarks foram reportados pela própria fornecedora; não havia uma replicação prática independente disponível no lançamento. As primeiras reações públicas ainda são impressões iniciais:
“a mistral acabou de adicionar busca agêntica à api e esse é o caminho certo. colocar uma busca no estilo Perplexity dentro de uma ferramenta nativa de agente nos poupa de escrever pipelines frágeis de web scraping e gerenciar rotação de proxies por conta própria.” — @AbdoKerdawy, desenvolvedor de produtos de IA (X)
As alegações sobre tokens já receberam críticas que o anúncio da Mistral não responde por completo:
“A ferramenta de recuperação com busca agêntica da Mistral afirma reduzir falhas de busca em passagem única em mais de 40%. Se ela evita consultas ao banco de dados, isso reduz o número de tokens que você precisa gastar?” — @therawlogs, blogueiro independente (X)
A resposta oficial é a redução de 24–34% em tokens em relação ao ciclo somente de busca. Saber se isso se mantém fora dos acervos de benchmark é justamente o que uma execução independente no conjunto aberto FinanceBench poderia esclarecer.
Produtos próximos enfrentam a mesma limitação física: o modo de busca agêntica Toast-1 da Mixedbread limita seu ciclo a quatro rodadas e oito chamadas de recuperação paralelas, e a própria documentação afirma claramente que ele é mais lento que uma única busca. Latência é o imposto que os fornecedores dessa categoria pagam por precisão.
Respostas diretas
O Mistral Agentic Search está disponível pela Agents API?
Não. Ele é oferecido pelo Mistral Search Toolkit e pelas Libraries no Studio e no Vibe; a ferramenta web_search da Agents API é um produto separado para web ao vivo, com preços próprios.
O Agentic Search realmente reduz o uso de tokens?
Segundo os benchmarks oficiais, o ciclo completo de navegação usou 23,9–33,7% menos tokens que um ciclo agêntico somente de busca no FinanceBench; uma replicação independente ainda não foi publicada.
Quais modelos funcionam com o Agentic Search?
A Mistral testou o Mistral Medium 3.5 e o Z.ai GLM-5.2, com ganhos consistentes, e descreve a camada como agnóstica a modelos, sem necessidade de fine-tuning.
Quanto custa o Mistral Agentic Search?
Não há preço publicado para o Agentic Search em si. O valor de US$ 30 por 1.000 chamadas na página de preços da Mistral pertence à ferramenta agêntica web_search, mais antiga.
A troca em aberto é simples: aqui, precisão é comprada com minutos. Para trabalho em lote sobre documentos regulatórios, contratos e registros governamentais digitalizados, um salto de 45 a 59 p.p. em precisão — nos resultados de ciclo completo do OfficeQA Pro e do FinanceBench, respectivamente — e uma redução de um terço nos tokens frente a um ciclo mais lento podem ser uma troca racional. Para qualquer uso voltado ao usuário final, 71 segundos de latência média ainda desclassificam a solução. E, até que alguém fora da Mistral repita o FinanceBench, os números mais fortes desta página seguem sendo os da própria fornecedora.
Leituras relacionadas: o guia da API GLM-5.2 e a análise do GLM-5.2 abordam o segundo modelo de benchmark usado nos testes da Mistral.