 AIREITER
Em 19 de agosto de 2026, a Liquid AI colocou um segundo arquivo Q4_0 de 1,59 GB ao lado do antigo no repositório do LFM2.5-2.6B. O tamanho é o mesmo, o nome é quase igual, mas o modelo é bem diferente. O QAD, sigla em inglês para destilação com consciência de quantização, recupera boa parte do que a quantização de 4 bits costuma sacrificar nesses checkpoints — e os números de retenção são fortes. Se você baixar o arquivo errado, estará usando a versão sem essa correção.
O que o QAD muda por dentro
QAD significa destilação com consciência de quantização. A Liquid AI treinou os quatro modelos — LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct e LFM2.5-2.6B — já levando em conta o arredondamento do Q4_0. Durante o treinamento, um modelo professor de alta precisão destila conhecimento para o aluno quantizado. Assim, os pesos “enxergam” o erro de quantização antes que ele aconteça e aprendem a compensá-lo.
Os arquivos Q4_0 antigos presentes nos mesmos repositórios usam quantização pós-treinamento, ou PTQ: um modelo BF16 pronto é arredondado depois, sem qualquer etapa para corrigir o erro introduzido. Segundo o post de lançamento da Liquid AI, os quatro checkpoints QAD “chegam a aproximadamente 97% das médias em BF16” em uma bateria que cobre raciocínio, seguimento de instruções, uso de ferramentas e comportamento agêntico, calculada como a média de cinco execuções. O QAD é uma mudança no treinamento, não um novo formato de arquivo. O resultado continua sendo um GGUF Q4_0 padrão, compatível com o llama.cpp.
A armadilha dos nomes — e os comandos corretos
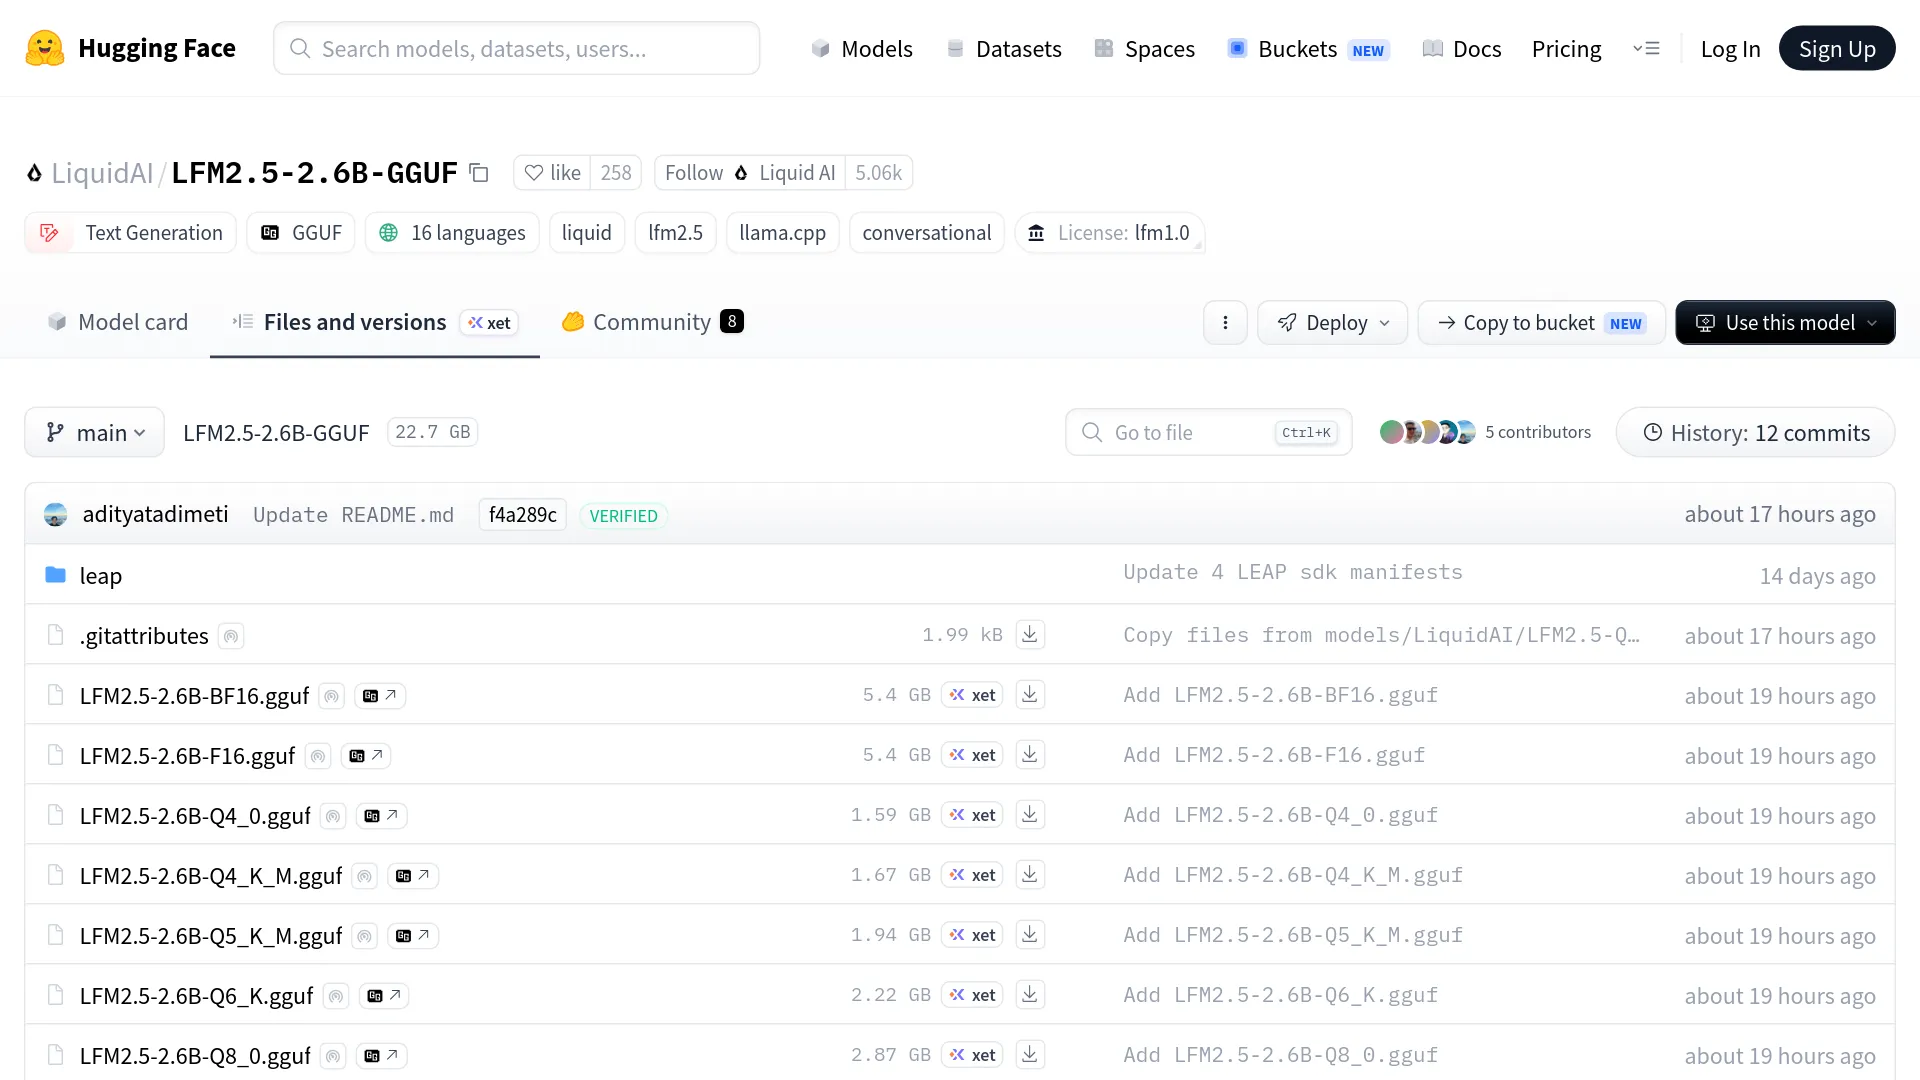
O repositório do LFM2.5-2.6B traz LFM2.5-2.6B-Q4_0.gguf e LFM2.5-2.6B-QAD-Q4_0.gguf, ambos listados com 1,59 GB. Os comandos padrão do repositório apontam para o Q4_K_M, não para o QAD. Portanto, copiar e colar o comando padrão não baixa nenhum dos dois arquivos QAD. É preciso informar o nome exato.
A confusão apareceu poucas horas depois do lançamento:
“Onde faço o download? Estou vendo o arquivo no Hugging Face, mas não sei se é a versão normal ou a QAD. Podem explicar?” — @Chitacc72 no X
Um dos primeiros usuários, @MarMarLabs, comparou os arquivos do repositório e descobriu que as versões Q4_0 antiga e nova diferem em cerca de 4 KB — uma diferença impossível de perceber em um gerenciador de arquivos. A solução é passar o nome exato do arquivo QAD em --hf-file:
# exemplo oficial do post de lançamento da Liquid AI
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B, com as opções de amostragem do model card oficial
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
O mesmo padrão com --hf-file vale para os repositórios do 230M e do 1.2B-Instruct. Para uso como servidor, @nicolasembleton publicou a forma abreviada que funcionou depois de constatar que os comandos gerados pelo Hugging Face estavam incompletos: llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. É o identificador depois dos dois-pontos que seleciona a versão QAD.
O que os números oficiais mostram — e o que fica de fora
A tabela de benchmarks da Liquid AI indica que cada checkpoint QAD preserva entre 96,5% e 97,4% do desempenho de referência em BF16. A bateria inclui GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF e BFCLv4, além do GSM8K nos dois modelos menores e do AIME25 nos dois maiores, sempre com média de cinco execuções.
| Checkpoint | Qualidade preservada do BF16 | Afirmação de qualidade | Velocidade de decodificação |
|---|---|---|---|
| LFM2.5-230M | 97,1% | equivale ao Q5_K_M dentro da variação | +4–33% vs Q5_K_M |
| LFM2.5-350M | 96,5% | equivale ao Q5_K_M dentro da variação | +4–33% vs Q5_K_M |
| LFM2.5-1.2B-Instruct | 97,4% | equivale ao Q4_K_M | +3–14% vs Q4_K_M |
| LFM2.5-2.6B | 96,6% | equivale ao Q4_K_M | +3–14% vs Q4_K_M |
A velocidade foi medida em quatro plataformas: MacBook Pro e NucBox EVO-X2 usando GPU, além do Samsung Galaxy S26 Ultra e do Raspberry Pi 5 com CPU Arm. Para os modelos 230M e 1.2B, a Liquid AI também afirma que o QAD Q4_0 iguala o UD-Q4_K_XL da Unsloth, descrito no post como um forte checkpoint PTQ externo.
O post não informa pontuações individuais por benchmark, tokens por segundo brutos em cada dispositivo, tamanhos de arquivo, consumo de RAM ou barras de variação. Há apenas faixas percentuais e afirmações de equivalência. A comunidade rapidamente fez as contas de tamanho:
“Então vocês estão dizendo que posso trocar meu LFM2.5-2.6B local de F16 para QAD Q4_0 e sair de: 5,4 GB → 1,6 GB, 21 → 64 tok/s … mantendo cerca de 97% do desempenho do BF16?” — @firedUp_Neyu, interpretando os gráficos de lançamento da Liquid
A parte do tamanho confere: o F16 tem 5,4 GB e o QAD Q4_0 tem 1,59 GB no repositório oficial. Já os valores em tok/s são uma interpretação dos gráficos feita pelo usuário, não números publicados em texto pela Liquid AI.
O que o post de lançamento não explica
Há três pontos importantes para quem está decidindo se vale a pena migrar para esses arquivos.
A cobertura se limita a quatro checkpoints. Até o lançamento, não havia versões QAD para o LFM2.5-VL-450M nem para o LFM2.5-8B-A1B, e usuários pediram à Liquid AI uma versão de 8B na discussão do lançamento no X. Se o seu dispositivo usa um desses modelos, o QAD não muda nada por enquanto.
A questão do imatrix continua em aberto. Os arquivos QAD foram treinados para Q4_0, mas gerados sem uma matriz de importância. Observadores da área de quantização destacaram isso imediatamente:
“O GGUF QAD Q4_0 foi criado sem imatrix, algo que também teria ajudado na qualidade dos modelos treinados com QAD.” — u/Chromix_, r/LocalLLaMA
Um modelo com menos de 3B continua sendo um modelo com menos de 3B. Recuperar qualidade na quantização não aumenta o teto de capacidade do modelo, e a discussão no LocalLLaMA deixa isso claro. Um usuário de NPU relatou:
“Acabei de implementar o LFM2.5 2.6B na minha NPU para resumos de reuniões e, embora seja impressionante para o tamanho, os resumos são muito piores do que os produzidos por modelos maiores.” — u/DerDave
Esse limite vem do modelo, não da quantização: o relatório de quantização da KikoCis registrou 0/6 instâncias resolvidas no SWE-bench Verified com Q8_0. Usuários do 1.2B também relatam que a qualidade varia conforme o runtime — respostas sem sentido em 9 de 10 prompts em uma configuração do Ollama, mas operação produtiva abaixo de 5 W em um computador de placa única em outra. Se a qualidade de ponta for importante para determinada tarefa, compare a saída local com um modelo grande por meio de uma API de LLM de baixo custo; um conjunto completo de testes custa centavos.
QAD Q4_0 ou Q4_K_M: qual arquivo baixar
Para implantações com pouca RAM no llama.cpp usando esses quatro checkpoints, o QAD Q4_0 é a opção padrão de 4 bits recomendada pelo fabricante e deve ser a primeira a ser testada. Ele ocupa os mesmos 1,59 GB do Q4_0 comum, mas foi treinado para igualar a qualidade do Q4_K_M nos modelos 1.2B e 2.6B, ou do Q5_K_M nos modelos 230M e 350M, com decodificação de 3–14% ou 4–33% mais rápida, respectivamente. Se você já usa Q4_K_M e tem RAM sobrando, não há motivo para trocar: 80 MB não é o problema que essa migração resolve.
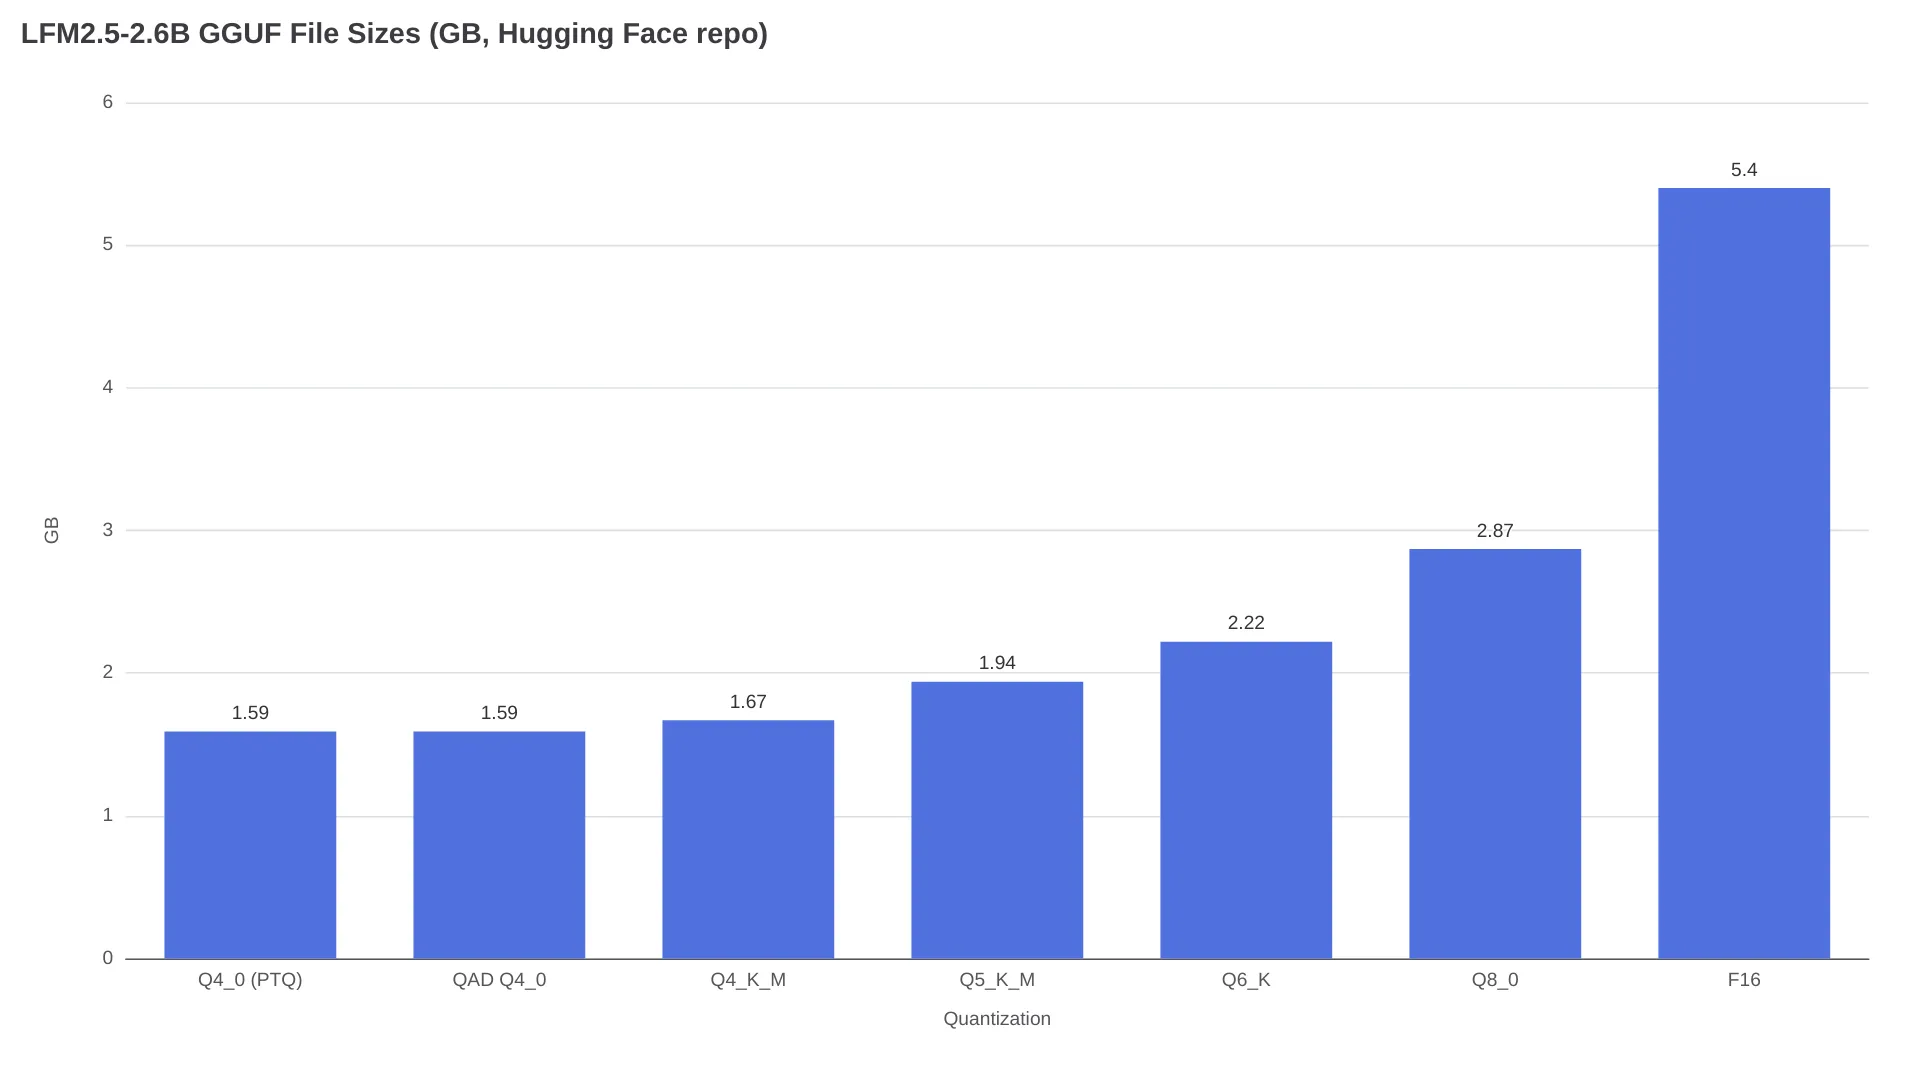
| Arquivo (2.6B) | Tamanho | Posicionamento | Escolha quando |
|---|---|---|---|
| Q4_0 (PTQ antigo) | 1,59 GB | base sem correção | evite, o QAD já existe |
| QAD Q4_0 | 1,59 GB | 96,6% do BF16, equivalente ao Q4_K_M | orçamento de 3–4 GB de RAM, decodificação via CPU, celulares, Pi |
| Q4_K_M | 1,67 GB | opção padrão da documentação da Liquid | se o seu runtime não consegue selecionar o arquivo QAD |
| Q5_K_M | 1,94 GB | 91,4% de top-1 contra F16, segundo a KikoCis | 6 GB ou mais de RAM |
| Q6_K / Q8_0 | 2,22 / 2,87 GB | quase sem perdas | 8 GB ou mais, prioridade máxima para qualidade |
Para contextualizar essas afirmações de equivalência: a escala de PTQ da KikoCis mediu concordância de tokens top-1 de 84,36% para o Q4_K_M contra o F16 neste modelo, ante 95,07% no Q6_K e 98,23% no Q8_0. A Liquid afirma que o QAD fecha essa diferença de fidelidade do 4 bits mantendo a mesma quantidade de bytes — são números da própria empresa, obtidos em cinco execuções, ainda sem replicação independente. Uma ressalva importante da discussão no dia do lançamento:
“Não é que ‘Q4_0 seja melhor que as K-quants’. É que esses quatro checkpoints foram treinados para Q4_0.” — @MarMarLabs
Não generalize esse resultado. Os arquivos Q4_0 de outros modelos continuam sendo PTQ comum.
Quanto à memória, o post de lançamento não traz números de RAM. Por isso, use os cálculos do repositório da KikoCis: o cache KV do 2.6B consome cerca de 16 KB por token em f16, o que dá aproximadamente 0,54 GB em um contexto de 32K e 2,15 GB na janela nativa de 128K. Esses valores caem pela metade com --cache-type-k q8_0 --cache-type-v q8_0. Os pesos QAD Q4_0 de 1,59 GB mais uma janela de 32K somam cerca de 2,13 GB antes do overhead do runtime; em 128K, o consumo passa de 3,7 GB. Considere 4 GB uma margem apertada e confirme a alocação no runtime do seu dispositivo.
Perguntas frequentes
O QAD Q4_0 é melhor que o Q4_K_M?
Para esses quatro checkpoints, os números da Liquid AI indicam que o QAD Q4_0 iguala a qualidade do Q4_K_M — ou do Q5_K_M nos dois modelos menores — em um arquivo menor e com maior velocidade de decodificação. Portanto, quando a RAM é o fator limitante, sim. Os números foram obtidos pela própria empresa, em cinco repetições, e ainda não há replicação independente.
O Ollama ou o LM Studio detecta o arquivo QAD automaticamente?
Não. O caminho documentado pelo Ollama é ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M, conforme a página oficial do repositório. Os comandos padrão do Hugging Face também apontam para o Q4_K_M. Qualquer runtime compatível com GGUF consegue carregar o arquivo QAD, mas você precisa selecioná-lo pelo nome explícito ou pelo identificador :QAD-Q4_0.
Quanta RAM o LFM2.5-2.6B QAD Q4_0 precisa?
Os pesos ocupam 1,59 GB. Os cálculos da KikoCis estimam o cache KV em f16 em aproximadamente 0,54 GB para um contexto de 32K e 2,15 GB em 128K. A soma de pesos e cache chega perto de 2,13 GB em 32K e 3,74 GB em 128K, antes do overhead do runtime. A quantização Q8_0 do cache KV reduz o custo do cache pela metade.
Quais modelos LFM2.5 têm checkpoints QAD?
Até 19 de agosto de 2026, somente LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct e LFM2.5-2.6B. As variantes VL-450M e 8B-A1B não têm versões QAD, embora usuários tenham pedido à Liquid AI um build QAD de 8B na discussão do lançamento.
Posso usar os checkpoints QAD do LFM2.5 comercialmente?
Os repositórios estão marcados com a LFM Open License v1.0. Repositórios da comunidade resumem os termos como permissão para uso comercial por entidades com receita anual inferior a US$ 10 milhões, com uma licença comercial separada da Liquid AI exigida a partir desse limite (resumo da KikoCis). Leia o texto da licença antes de colocar o modelo em produção.
A afirmação de 97% foi verificada de forma independente?
Ainda não. Os números de retenção de 96,5–97,4% são médias de cinco execuções calculadas pela própria Liquid AI e publicadas com o lançamento. Até a publicação deste texto, não havia benchmark de terceiros dos arquivos QAD, e a questão do imatrix continuava em aberto no r/LocalLLaMA.
Faça seu próprio teste A/B hoje
O que importa é a taxa de erro na sua tarefa, não a média de um benchmark. Separe dez prompts reais — JSON de chamadas de ferramentas, seu esquema de extração e seu idioma — e execute os dois arquivos com configurações idênticas:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
Conte falhas de parsing e escolhas erradas de ferramentas em cada arquivo — não avalie apenas pela impressão geral. O equilíbrio ainda não está resolvido: na média, a qualidade por gigabyte favorece o QAD Q4_0 no papel, mas os problemas da sua implantação — respostas vazias quando o raciocínio consome o orçamento de tokens ou desvios de formato em determinada temperatura — dependem do runtime e da tarefa. Só os seus dez prompts conseguem colocar um preço nessa diferença.