 AIREITER
Em uma comparação de sessões do Codex com volume praticamente idêntico, o GPT-5.6 Sol consumiu mais que o dobro dos tokens do GPT-5.5 — apesar de ambos terem o mesmo preço por token. Foram 16.45 million tokens por sessão em 1,715 sessões, contra a média de 7.30 million do GPT-5.5 em uma janela comparável de 1,667 sessões, segundo os dados compilados. E há outro agravante: uma falha documentada na Responses API aparentemente infla em 6x ou mais os output_tokens cobrados do Sol. Se a sua fatura do GPT-5.6 parece errada, é bem possível que esteja mesmo.
Quanto o GPT-5.6 Sol consome por sessão
O desenvolvedor Vincent Schmalbach acompanhou o consumo de tokens em dois períodos de 14 dias de uso do Codex. A comparação colocou o GPT-5.5 xhigh frente ao GPT-5.6 Sol xhigh, com quantidades de sessões quase iguais:
| Métrica | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| Sessões | 1,667 | 1,715 |
| Total de tokens | 12.17B | 28.22B |
| Tokens por sessão | 7.30M | 16.45M |
O número de sessões cresceu 2.9%, mas a quantidade de tokens por sessão subiu 125%. O consumo total saltou de 12.17 bilhões para 28.22 bilhões: um aumento de 2.32x para praticamente a mesma carga de trabalho.
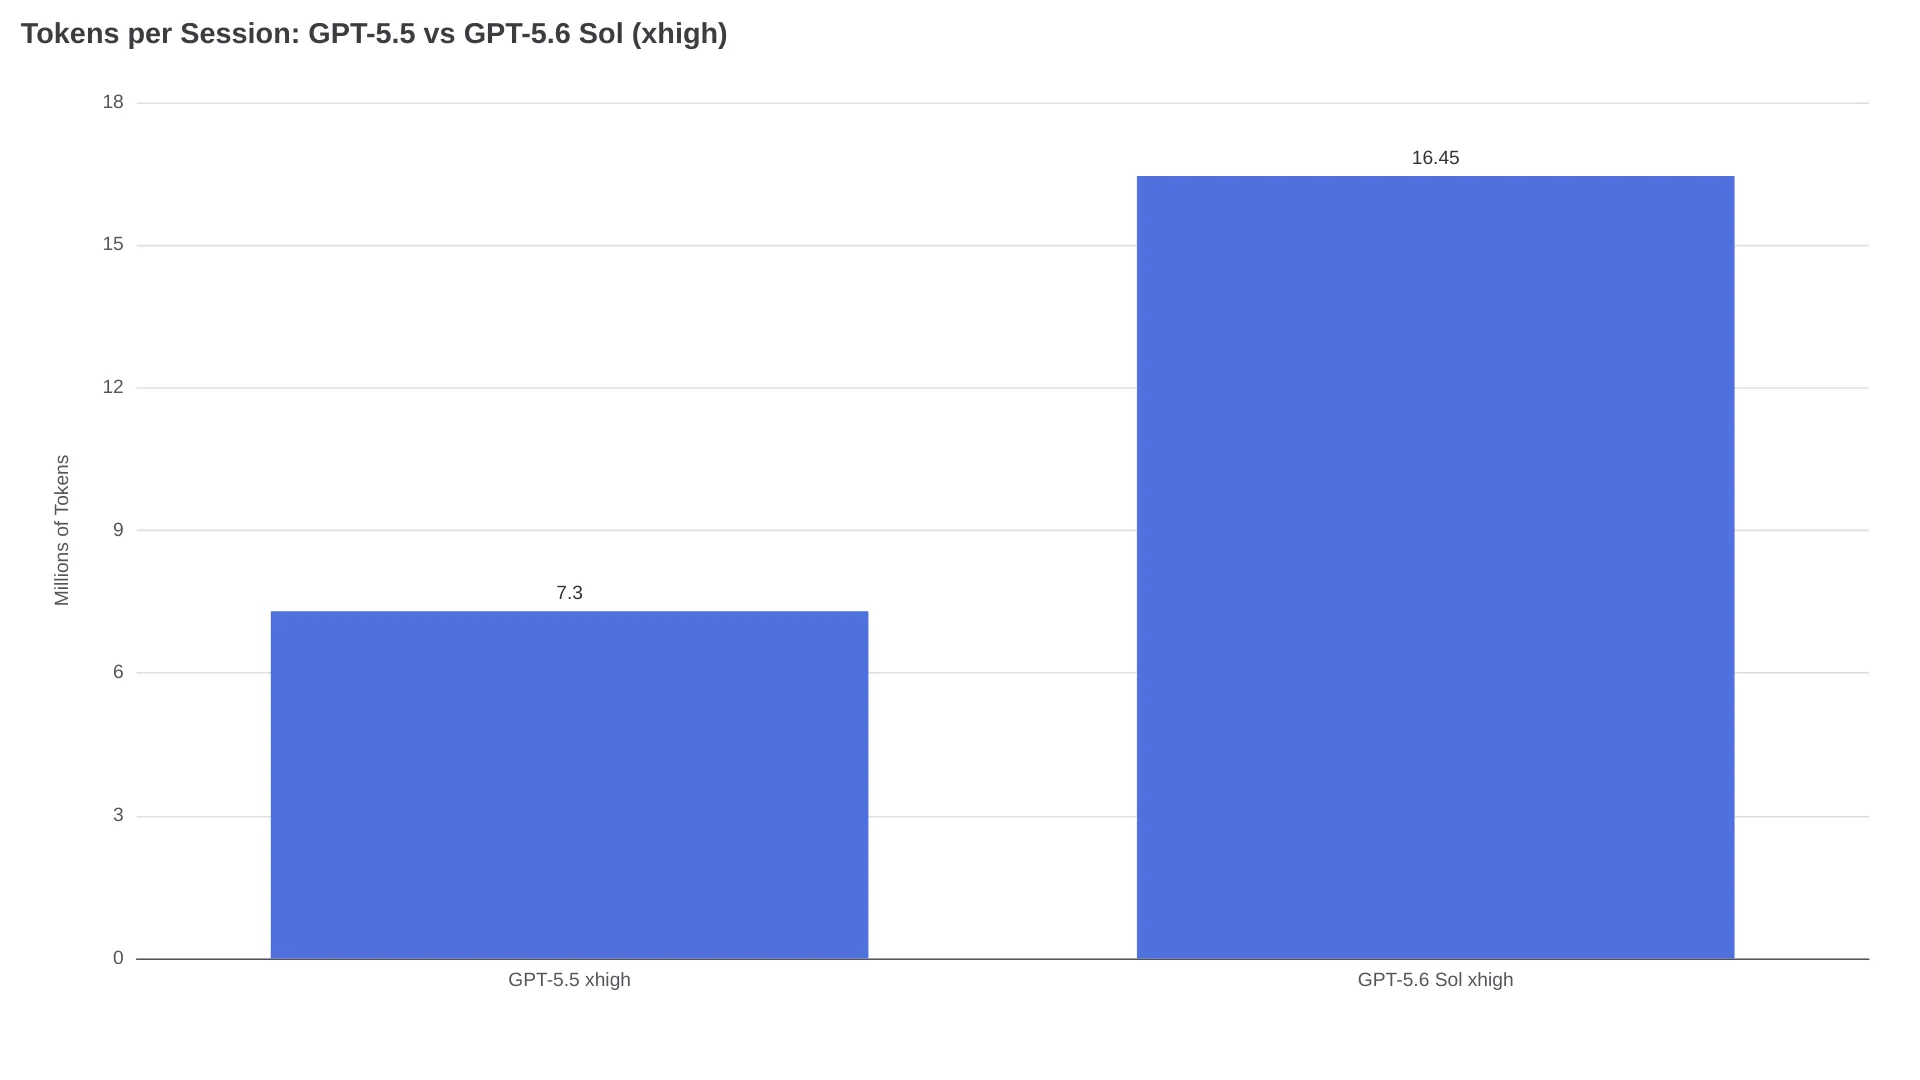
A página de preços da OpenAI lista o GPT-5.6 Sol por $5/1M de tokens de entrada e $30/1M de saída, exatamente os mesmos valores do GPT-5.5. Com a mesma tarifa, 2.25x mais tokens significa um custo por tarefa de aproximadamente 2.25x maior. O GPT-5.6 Sol também trouxe uma cobrança adicional por escrita em cache, equivalente a 1.25x a tarifa de entrada — algo que não existia no GPT-5.5.
"O GPT 5.6 Sol é uma fornalha de tokens. Mesmo o Sol em medium ou high parece devorar tokens. O 5.6 será usado apenas para planejamento complexo ou bugs difíceis." — usuário do r/codex
As três assinaturas de Schmalbach, que antes duravam uma semana de trabalho intenso, agora se esgotam em cerca de um dia de uso moderado.
Por que o Sol gasta mais tokens
O Sol é mais eficiente por ponto de benchmark do que os concorrentes. No Artificial Analysis Coding Agent Index, ele usa menos tokens de saída que o Claude Fable 5 para alcançar pontuações equivalentes. Nas sessões reais, porém, o Sol raciocina de forma mais agressiva: planeja, volta atrás, valida resultados e explora alternativas. A contrapartida é gastar mais tokens por tarefa, ainda que cada token gere mais trabalho útil.
Falha reportada pode inflar os tokens de saída cobrados
Além do consumo real mais alto, uma falha de contabilização documentada na Responses API aparentemente infla o campo output_tokens, que é a base do cálculo de cobrança. A OpenAI está investigando o caso, mas ainda não confirmou publicamente a causa raiz.
Um desenvolvedor documentou o problema em 710 chamadas do GPT-5.6 e 22,922 chamadas de raciocínio no total. O GPT-5.6 é a primeira família de modelos a emitir vários itens de reasoning por resposta — mediana de k=9 no Sol e k=4 no Terra. Durante a geração, um acumulador da API soma o total progressivo de raciocínio uma vez para cada item de raciocínio, além de incluir a contagem final correta.
A fórmula é:
output_tokens ≈ R × (k + 3) / 2Nela, R representa os tokens reais de raciocínio e k é o número de itens de raciocínio. Para o Sol, com k=9 na mediana, a contagem cobrada é inflada em aproximadamente 6x. Para o Terra, com k=4, em cerca de 3.6x.
Um exemplo extremo em uma cobrança real
O caso documentado mais grave foi uma única chamada ao GPT-5.6 Terra que retornou uma resposta de quatro caracteres, d1d4, mas foi cobrada por 466,818 tokens de saída, embora tenha usado apenas 21,064 tokens reais de raciocínio.
| O que a API informou | Valor |
|---|---|
output_tokens (cobrado) | 466,818 |
reasoning_tokens (real) | 21,064 |
| Saída visível | d1d4 (4 caracteres) |
| Itens de raciocínio (k) | 41 |
Com k=41, a fórmula prevê R × (41+3)/2 = 21,064 × 22 = 463,408, uma diferença de apenas 0.7% em relação ao valor cobrado. O autor do relato conferiu os números no painel de cobrança: ao somar os output_tokens da API e aplicar as tarifas publicadas, o resultado reproduziu as cobranças do painel até a décima parte de um centavo. Considerando todas as chamadas ao GPT-5.6, cerca de ~$284 dos ~$320 cobrados eram cobrança excedente.
O problema já existia antes do GPT-5.6
Quando k=1 — um único item de raciocínio, que é o comportamento dos modelos anteriores ao 5.6 — a fórmula se reduz a R × 4/2 = 2R: uma cobrança excedente fixa de 2x. O autor do relato confirmou isso usando a exportação de uso da própria OpenAI referente a maio de 2026:
| Modelo | Tokens de saída cobrados | Contagem real | Proporção |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini (controle) | 12,054,680 | 9,160,567 | 1.01x |
O GPT-5.6 não criou a falha. Ele é apenas o primeiro modelo a dividir o raciocínio em muitos itens, transformando uma cobrança extra discreta de 2x em um multiplicador muito maior. O motivo é que o raciocínio é emitido em blocos de ~512 tokens, de modo que k ≈ ceil(R/512). Ao substituir isso na fórmula, chega-se a output_tokens ≈ R²/1024 + 3R/2. Em outras palavras, a cobrança excedente cresce quadraticamente com o tamanho do raciocínio: dobrar o tempo de reflexão pode, aproximadamente, quadruplicar a conta.
Até o momento desta publicação, em agosto de 2026, funcionários da OpenAI responderam ao relato do bug pedindo dados adicionais, mas nenhuma correção ou ajuste de cobrança foi confirmado publicamente.
Preços atuais do GPT-5.6 após o corte de 30 de julho
Em 30 de julho de 2026, a OpenAI reduziu o preço do Luna em 80% e o do Terra em 20%. O preço do Sol permaneceu inalterado. Estas são as tarifas atuais da página de preços da OpenAI:
| Modelo | Entrada (curta) | Entrada em cache | Escritas em cache | Saída (curta) | Saída (longa) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
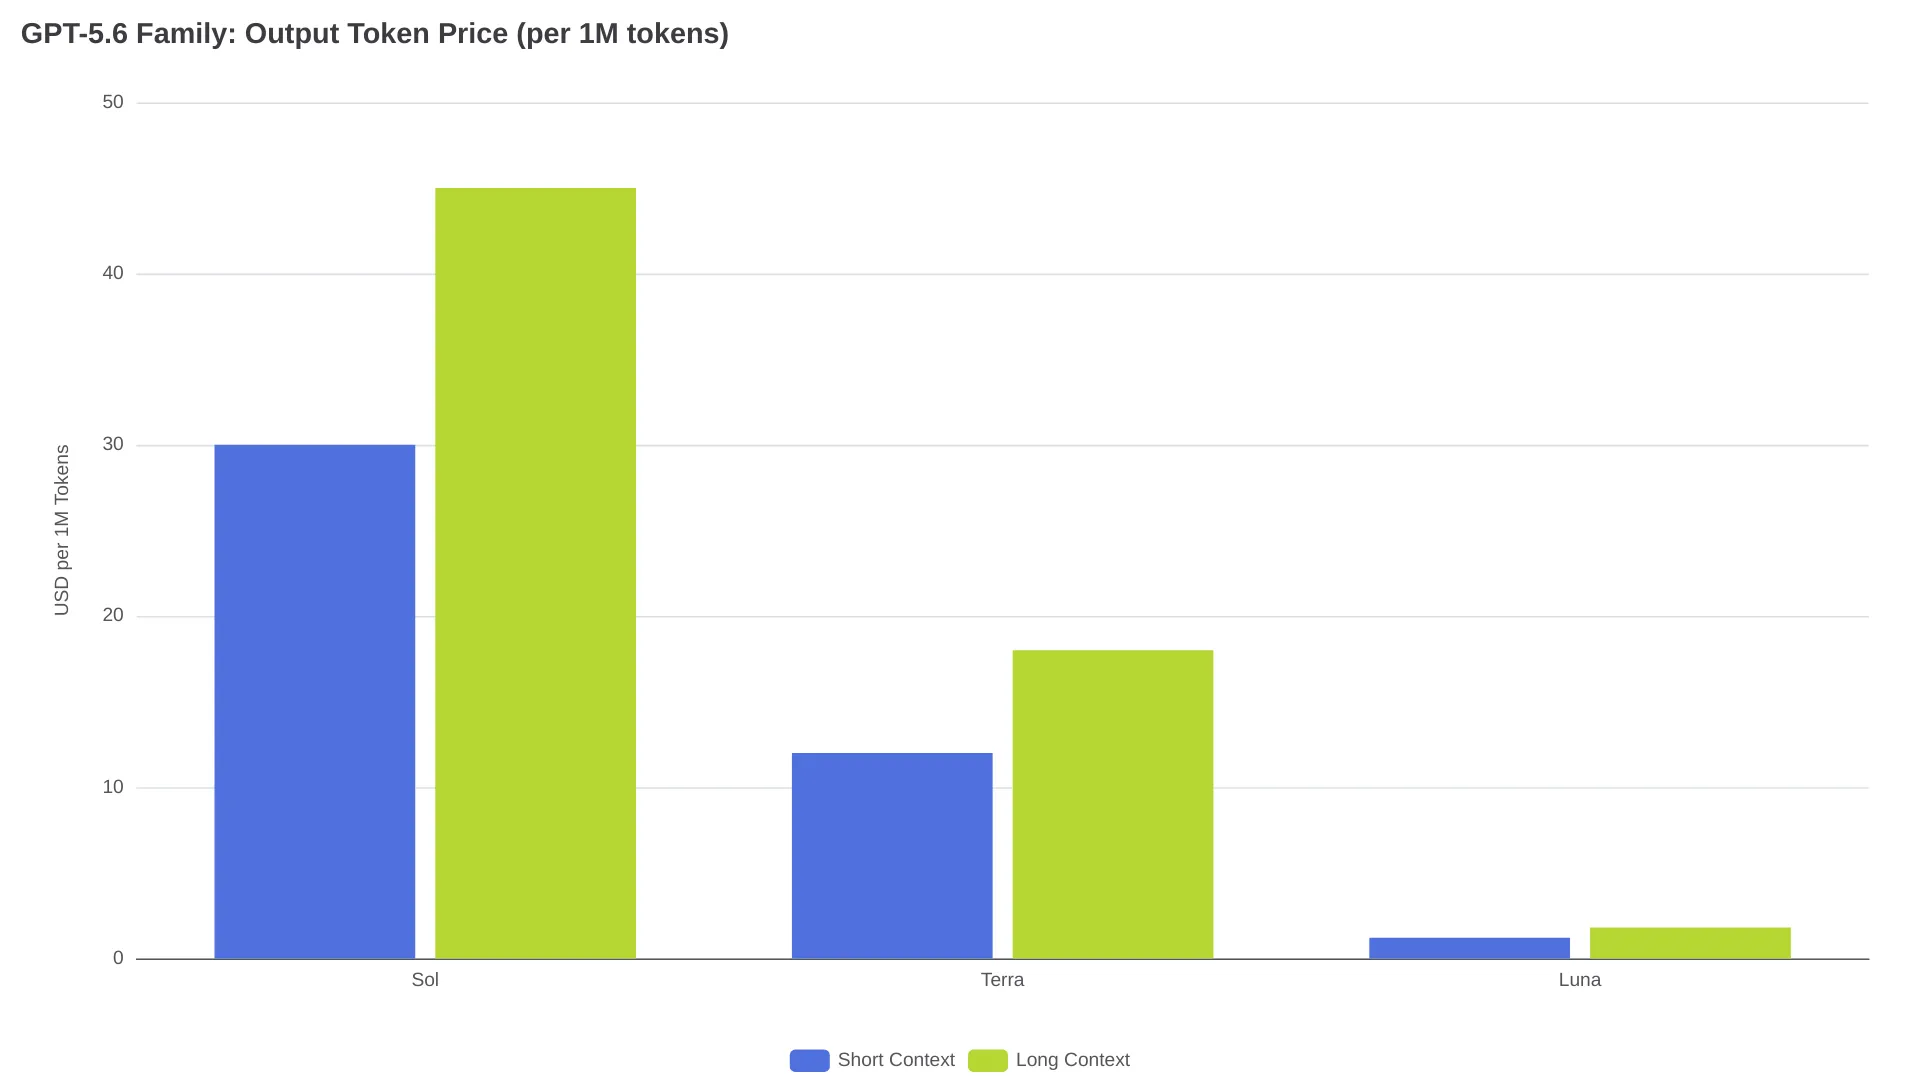
O Sol custa o mesmo por token que o GPT-5.5, mas usa 2.25x mais tokens por tarefa. Na prática, seu custo efetivo por tarefa aproximadamente dobra.
Escritas em cache são uma cobrança nova. O GPT-5.6 cobra 1.25x a tarifa de entrada pelas escritas em cache ($6.25/1M no Sol). O GPT-5.5 não tinha essa taxa. Se a sua carga de trabalho tem uma taxa baixa de acertos de cache, isso acrescenta uma sobretaxa de 25% aos custos de entrada que antes não existia.
O Luna agora custa menos que o GPT-5.4 nano. Com $0.20/$1.20, contra os $0.20/$1.25 do nano, o Luna passou a ser, após o corte, o modelo mais barato da linha da OpenAI.
Três maneiras de reduzir sua conta de tokens do GPT-5.6
Use o Terra nas tarefas rotineiras
A tarifa de saída do Terra é $12/1M, 60% menor que os $30/1M do Sol. No Artificial Analysis Coding Agent Index, o Terra fica ligeiramente acima do Claude Fable 5. Após o corte de preço de 20% em julho, os valores de $2.00/$12.00 do Terra também ficaram abaixo da antiga tarifa do GPT-5.5.
Quando o Sol ainda vale a pena? Em sessões de depuração com várias etapas, planejamento de arquitetura em grandes bases de código e análise de segurança. Essas tarefas se beneficiam de cadeias de raciocínio mais longas. Para programação, análise e geração de conteúdo convencionais, o Terra entrega resultados comparáveis com uma fração do consumo de tokens.
Reduza o nível de esforço
O parâmetro reasoning.effort define quantos tokens de raciocínio o modelo gera, e a falha de cobrança reportada escala diretamente com a quantidade de itens de raciocínio (k). Em medium, o Sol emite menos itens de raciocínio que em xhigh, por isso a inflação na cobrança também cai proporcionalmente.
"Eu uso o Terra Ultra, e o consumo de tokens de fato parece muito mais eficiente do que no GPT 5.5." — usuário do r/codex
O comportamento de fornalha de tokens se concentra no Sol com níveis altos de esforço. Trocar reasoning.effort de xhigh ou max para medium ou high é a mudança isolada com maior potencial de impacto.
Aumente os acertos de cache
O GPT-5.6 introduziu pontos de interrupção explícitos para cache e uma duração mínima de cache de 30 minutos. Leituras de cache recebem 90% de desconto, reduzindo o custo de entrada do Sol de $5.00 para $0.50 por 1M. Já as escritas em cache custam 1.25x a tarifa de entrada, ou $6.25/1M no Sol.
Estruture os prompts para que a mensagem de sistema e o contexto estático apareçam antes de um ponto de interrupção de cache. O ponto de equilíbrio depende da sua carga de trabalho: o adicional de escrita em cache corresponde a 25% da tarifa de entrada, enquanto a economia nas leituras é de 90%. Portanto, você precisa de uma taxa de acertos em que a economia nas leituras supere a sobretaxa das escritas. Em workloads nos quais a maior parte das requisições compartilha um prompt de sistema longo, isso tende a se tornar vantajoso rapidamente.
Perguntas frequentes
A OpenAI reconheceu a falha de cobrança?
Um funcionário da OpenAI, Mark G., respondeu ao relato no fórum da comunidade em 12 de julho de 2026, solicitando IDs de requisição e timestamps para investigação. Até agosto de 2026, nenhuma correção ou ajuste retroativo de cobrança havia sido confirmado publicamente.
Como verificar se a falha afeta minha conta?
Em qualquer resposta que contenha vários itens de raciocínio, some usage.output_tokens_details.reasoning_tokens aos tokens visíveis da conclusão. Se usage.output_tokens exceder essa soma em mais do que alguns por cento, o comportamento de ressoma cumulativa documentado no relato do fórum provavelmente está afetando sua cobrança. Baixe o CSV de uso no painel da OpenAI e faça a verificação por modelo.
Devo trocar o Sol pelo Terra?
Para a maioria das cargas de trabalho na API, o Terra custa menos e tem desempenho competitivo nos benchmarks de programação. A vantagem do Sol aparece nas tarefas mais difíceis: os benchmarks da própria OpenAI mostram que o Sol supera mais o Terra em raciocínio com múltiplas etapas e pesquisa de segurança, cenários em que um tempo de reflexão maior traz o melhor retorno.