 AIREITER
Em 30 de julho de 2026, a OpenAI reduziu o preço da API do GPT-5.6 Luna em cerca de 80%. O modelo saiu dos $1/$6 cobrados no lançamento para $0.20 de entrada / $1.20 de saída por milhão de tokens. Com isso, Luna passou a custar aproximadamente 73% menos que o GPT-5.4 mini ($0.75/$4.50), embora tenha respondido no mesmo nível do mini nos prompts de código e raciocínio que testamos. O mini ainda leva vantagem em um ponto: respondeu cerca de duas vezes mais rápido. Por isso, cargas de trabalho sensíveis à latência continuam sendo o único caso claro para escolher o modelo menor mais antigo.
O corte de 30 de julho mudou completamente a comparação
O GPT-5.6 Luna entrou em disponibilidade geral em 9 de julho de 2026, custando $1/$6 por milhão de tokens. Ele foi apresentado como a faixa mais econômica da família GPT-5.6, mas ainda custava bem mais que o barato gpt-5.4-mini da OpenAI ($0.75/$4.50). Cerca de três semanas depois, em 30 de julho, a OpenAI cortou o preço do Luna em aproximadamente 80%, para $0.20/$1.20, e reduziu o GPT-5.6 Terra em cerca de 20%, para $2/$12. Agora, Luna ocupa a mesma faixa do gpt-5.4-nano ($0.20/$1.25): preço de nano com um cérebro da geração atual.
Se você viu o Luna cotado a $1/$6, aquele preço de lançamento deixou de valer em 30 de julho de 2026. O preço atual da camada Standard é $0.20/$1.20, verificado em 31 de julho de 2026.
Preço de tabela: Luna contra mini
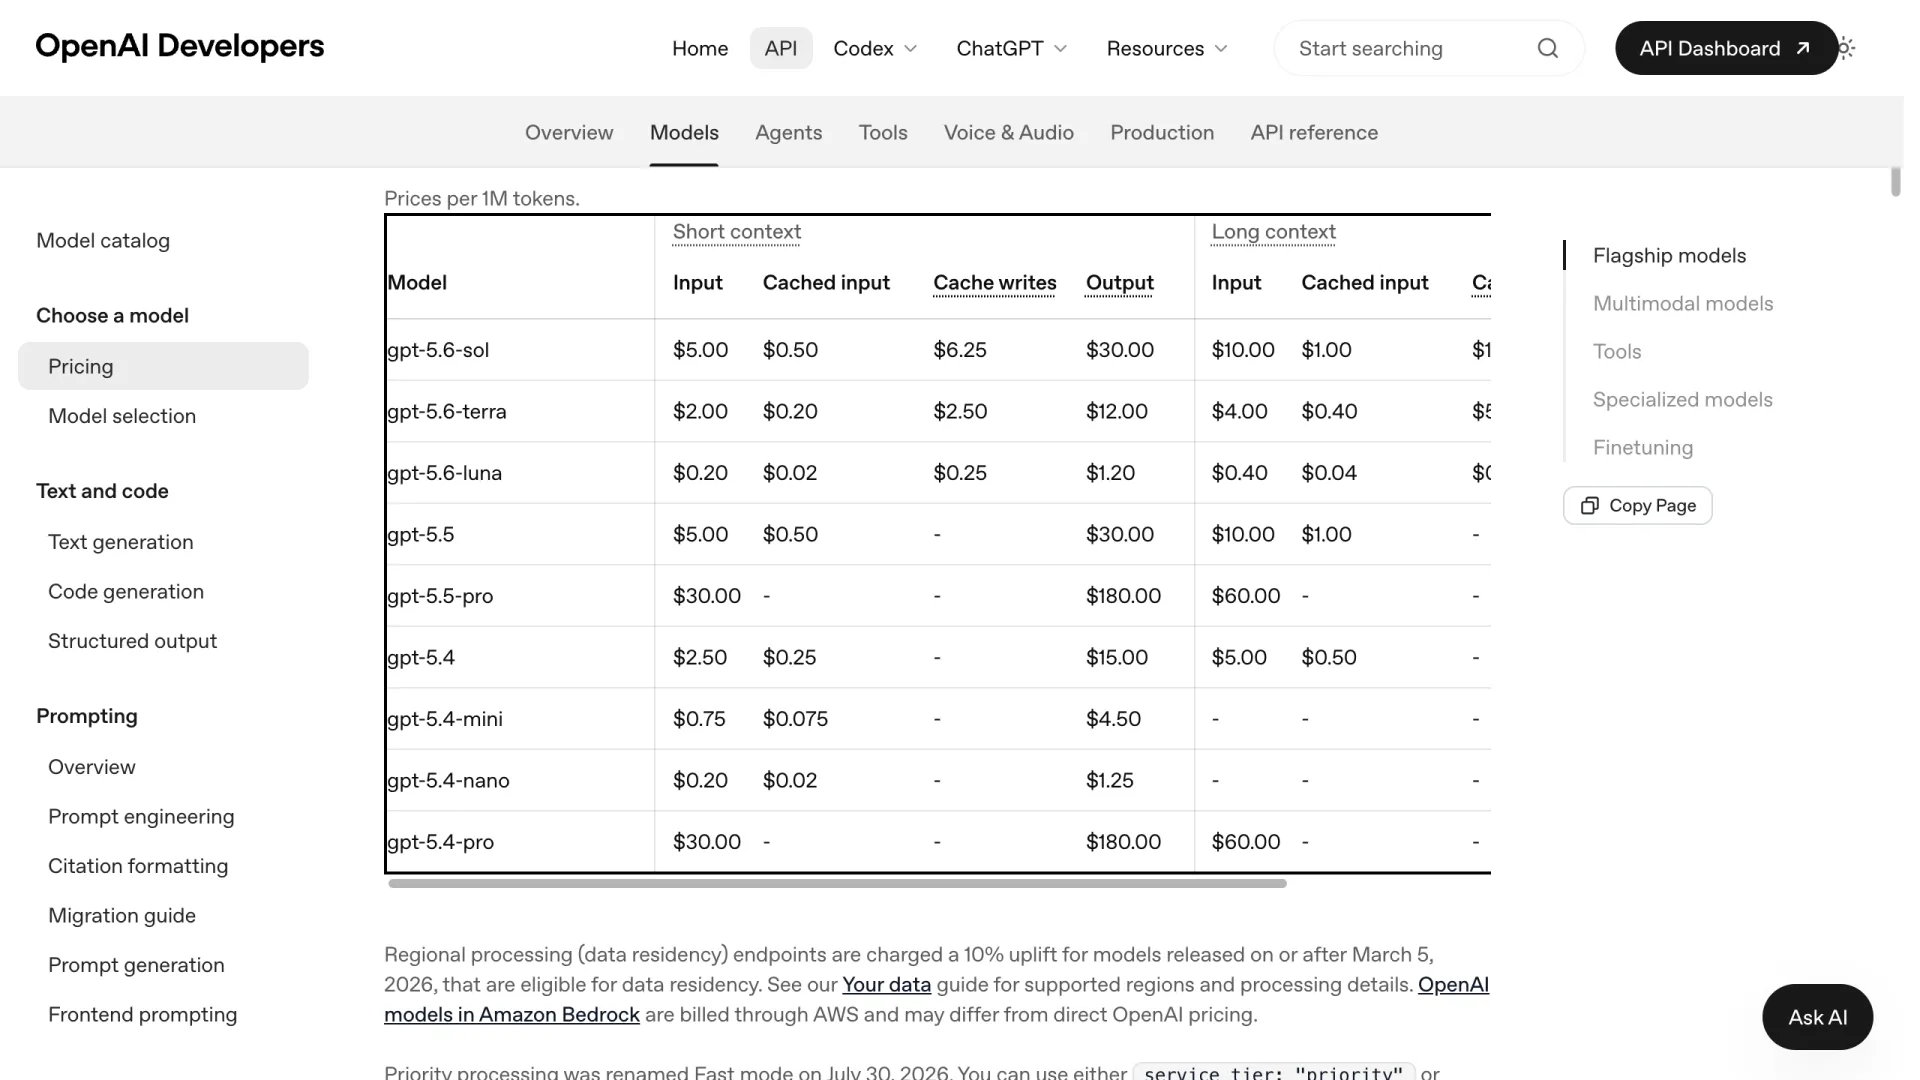
Nos preços atuais da camada Standard, Luna custa menos que mini tanto na entrada quanto na saída. A diferença se mantém para prompts curtos ou longos. Luna também oferece uma janela de contexto de 1,050K, ante 400K do mini.
| Modelo (Standard, por 1M de tokens) | Entrada | Entrada em cache | Saída | Contexto |
|---|---|---|---|---|
| gpt-5.6-luna (contexto curto) | $0.20 | $0.02 | $1.20 | 1,050K |
| gpt-5.6-luna (contexto longo, >200K) | $0.40 | $0.04 | $1.80 | 1,050K |
| gpt-5.4-mini | $0.75 | $0.075 | $4.50 | 400K |
Fonte: developers.openai.com/api/docs/pricing, verificado em 2026-07-31. Como referência, o gpt-5.4-nano custa $0.20/$1.25, a mesma faixa de preço em que Luna agora se encontra.
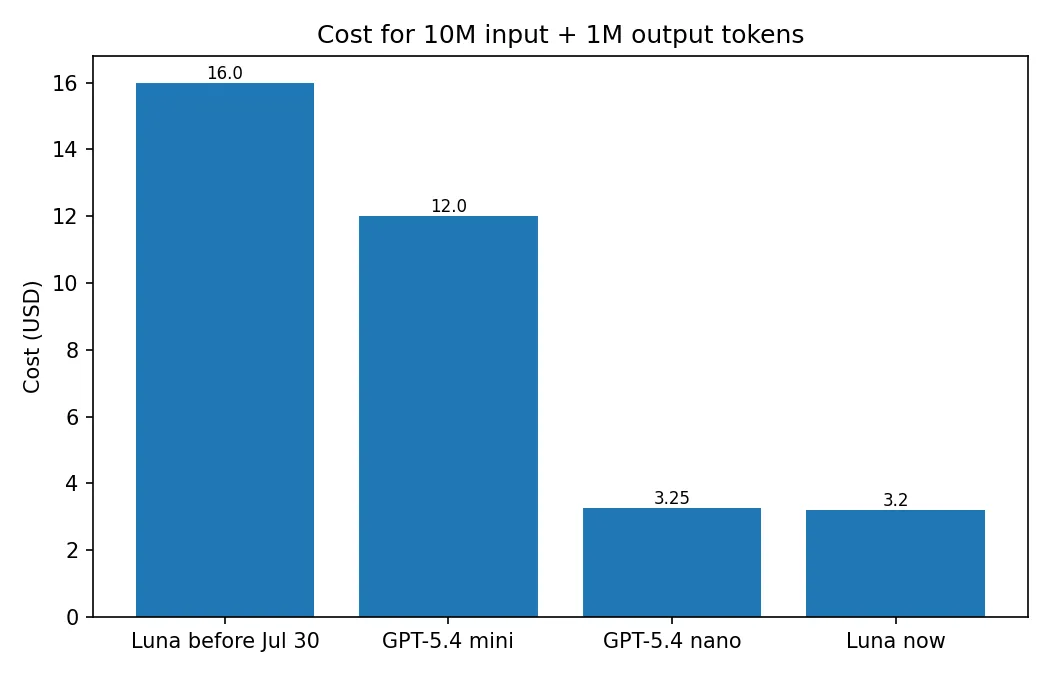
Em uma carga moderada de 10M de tokens de entrada mais 1M de saída, Luna custa $3.20, contra $12.00 do mini; o nano fica em $3.25. Em 1M mais 1M, são $1.40 contra $5.25. Luna cobra o dobro quando a entrada ultrapassa 200K tokens — sua tarifa de contexto longo é $0.40/$1.80 —, mas ainda assim fica abaixo da taxa fixa de $0.75/$4.50 do mini. O mini sequer tem uma faixa para contexto longo: sua janela de 400K usa uma única faixa de preço de contexto curto. Para ver uma análise mais detalhada dos preços de toda a família, consulte o guia de preços do GPT-5.6.
Mesmo prompt, dois modelos: qualidade, tokens e velocidade
Enviamos prompts idênticos aos dois modelos pelo mesmo endpoint de API: uma tarefa de programação — retornar o tamanho da maior substring de parênteses válidos — e uma tarefa de raciocínio — o problema do caracol no poço, executado três vezes. Ambos acertaram as duas tarefas, gerando o mesmo algoritmo baseado em pilha para o problema dos parênteses e respondendo "28 days" para o caracol em cada uma das três execuções. A diferença apareceu na velocidade e na verbosidade, não na precisão.
Qualidade e precisão das respostas
No prompt de programação, Luna e mini produziram soluções O(n) funcionalmente idênticas, baseadas em pilha e com índice-base sentinela; nenhum dos dois errou. No problema de raciocínio, ambos chegaram corretamente a 28 dias e observaram que o caracol escapa no dia 28 antes de poder escorregar de volta. Nessas duas tarefas básicas, os modelos ficaram efetivamente empatados; não submetemos o raciocínio mais complexo a testes de estresse.
Velocidade e latência
O mini foi aproximadamente duas vezes mais rápido de ponta a ponta. Nas três execuções de raciocínio, o mini teve média de ~2.8s, contra ~5.5s do Luna; na única execução de programação, foram 4.0s para o mini e 4.6s para o Luna. O tempo extra do Luna acompanha sua resposta mais detalhada: 168 tokens, contra 76 do mini na tarefa de raciocínio. Ele prioriza respostas completas em vez de retornos imediatos.
"É basicamente tão rápido quanto o 5.4 mini se você usar medium thinking e raciocina muito bem, tipo acima do nível 5.4." — r/codex, tópico "GPT-5.6 Luna is really underrated"
Com as configurações padrão, mini é a opção mais rápida.
Custo por tarefa
A maior verbosidade do Luna é mais do que compensada pelo preço unitário menor. No prompt de raciocínio, Luna gerou em média 168 tokens de saída, contra 76 do mini, mas, nos preços atuais, essa resposta custou cerca de $0.001 no Luna, contra $0.004 no mini. São valores abaixo de um centavo e baseados em uma amostra de um único dígito — teste executado em 2026-07-31 via AIReiter API, usando gpt-5.6-luna e gpt-5.4-mini, esforço padrão, endpoint dos EUA; os tempos são de relógio de ponta a ponta para a resposta completa, e as contagens de tokens são os tokens de conclusão informados pela API. Portanto, trate os números como indicativos, não como benchmark. Ainda assim, a direção é inequívoca: por resposta correta, Luna é mais barato.
Por que a disputa de benchmarks sobre "qual é mais inteligente" compara configurações diferentes
Nos números brutos dos scorecards, Luna supera mini em programação e raciocínio: SWE-Bench Pro 62.7 contra 54.4, GPQA Diamond 92.3 contra 88.0 e Toolathlon 53.4 contra 42.9, segundo os scorecards de modelos da OpenAI. O resultado mais citado que inverte o veredito vem do Artificial Analysis e seu Intelligence Index, no qual GPT-5.4 marca 51, contra 46 do Luna. Porém, o índice compara Luna executado com esforço alto contra GPT-5.4 executado com esforço xhigh. Ou seja, cada lado recebe um orçamento de raciocínio diferente — não é uma comparação equilibrada.
| Benchmark | GPT-5.6 Luna | GPT-5.4 mini | Observação |
|---|---|---|---|
| SWE-Bench Pro | 62.7 | 54.4 | Luna acima |
| GPQA Diamond | 92.3 | 88.0 | Luna acima |
| MMMU Pro | 78.4 | 76.6 | Próximos |
| Toolathlon | 53.4 | 42.9 | Luna acima |
| Terminal-Bench | 84.7 (v2.1) | 60.0 (v2.0) | Versões diferentes |
| OSWorld | 45.6 (v2.0) | 72.1 (Verified) | Protocolos diferentes |
Pontuações compiladas dos scorecards de modelos publicados pela OpenAI e conferidas com docsbot.ai.
Há duas ressalvas importantes ao interpretar esses dados. A primeira é a faixa de esforço: mini expõe um controle detalhado com None / Low / Medium / High / XHigh, enquanto Luna usa por padrão uma faixa alta de raciocínio. Portanto, elevar o mini a xhigh e compará-lo ao Luna na configuração padrão infla a manchete do mini. A segunda é que as linhas não são estritamente equivalentes. O docsbot.ai sinaliza que os números de Terminal-Bench e OSWorld misturam versões e protocolos de benchmark. É assim que os 72.1 do mini em OSWorld podem parecer superiores aos 45.6 do Luna, embora estejam medindo algo sutilmente diferente.
Além das pontuações, Luna tem corte de conhecimento em fevereiro de 2026, contra agosto de 2025 do mini, e uma janela de contexto de 1.05M, ante 400K.
O tópico que dizia que Luna custa 96% mais agora está desatualizado
Um teste da comunidade OpenAI amplamente compartilhado concluiu que Luna custava 96% mais que mini por conversa de seis turnos. O número é real, mas foi medido antes do corte de preço: o teste aconteceu em 11 de julho, quando Luna ainda custava $1/$6 no lançamento. Além disso, a maior parte da diferença veio de um bug de invalidação de cache no app de teste, e não do modelo em si. Quando o autor deixou de alterar as instruções de nível superior a cada turno, o sobrepreço do Luna caiu para 16.7%, e Luna ficou 9.9% mais rápido, com nota de qualidade maior em avaliação cega, 4.80 contra 4.28.
No preço atual de $0.20/$1.20, Luna já é mais barato que mini antes mesmo de o cache entrar na conta. Por isso, o argumento de cache não muda mais a decisão entre Luna e mini. Ainda vale entender o mecanismo para ajustar custos: a OpenAI cobra gravações em cache a 1.25× a tarifa de entrada — $0.25/M para Luna agora — e leituras em cache têm desconto de 90%, com vida mínima de cache de 30 minutos. Se seu app reescreve o prompt de sistema a cada turno, o prefixo em cache é invalidado e você paga a tarifa de gravação em vez da de leitura. Essa foi a armadilha que gerou o número de 96%.
Qual modelo escolher
Para a maioria das cargas de trabalho, a resposta agora é Luna: ele é mais barato nas duas faixas de contexto, empata ou supera o mini em qualidade, traz um corte de conhecimento mais recente e uma janela 2.6× maior. Escolha o mini quando latência for uma restrição rígida ou quando você precisar do controle de esforço que Luna não expõe.
| Se você quer… | Escolha | Por quê |
|---|---|---|
| Menor custo por resposta correta | Luna | $0.20/$1.20, ~73% abaixo do mini |
| Menor latência | mini | ~2× mais rápido de ponta a ponta (~2.8s vs ~5.5s em raciocínio) |
| Controle detalhado de esforço None/XHigh | mini | Luna opera apenas na faixa alta |
| Prompts com mais de 400K tokens | Luna | Janela de 1.05M; mini limita em 400K |
| Respostas mais concisas | mini | Gerou ~metade dos tokens em tarefas equivalentes |
Uma divisão prática de roteamento: use mini como padrão quando sua vantagem de latência importar e Luna como modelo de escalonamento e para contexto longo, quando qualidade e tamanho da janela forem prioritários. Ambos podem ser chamados por uma API unificada como gpt-5.6-luna e gpt-5.4-mini, por exemplo no endpoint AIReiter GPT-5.6 Luna. Um cuidado no roteamento: o flagship Sol custa $5/$30, cerca de 25× o Luna. Se o seu endpoint associar um ID genérico gpt-5.6 ao Sol, fixe o ID completo gpt-5.6-luna.
Perguntas frequentes
GPT-5.6 Luna é mais barato que GPT-5.4 mini?
Sim, cerca de 73% mais barato nos preços atuais. Após o corte de 30 de julho de 2026, Luna custa $0.20 de entrada / $1.20 de saída por milhão de tokens, contra $0.75 / $4.50 do mini, tanto na entrada quanto na saída.
GPT-5.6 Luna é mais rápido ou mais lento que 5.4 mini?
Mais lento, por aproximadamente 2× em nosso teste com os mesmos prompts: mini teve média de ~2.8s contra ~5.5s do Luna em raciocínio. Luna troca velocidade por um raciocínio mais completo; reduzir seu esforço diminui essa diferença.
GPT-5.6 Luna substitui a faixa mini?
Não. Luna é a faixa econômica da geração GPT-5.6; gpt-5.4-mini é um modelo pequeno, separado e mais antigo, que continua à venda e com suporte.
GPT-5.4 nano vs Luna: qual é mais barato?
Na prática, empatam. Luna custa $0.20/$1.20, contra $0.20/$1.25 do nano. Luna é ligeiramente mais barato na saída e pertence a uma geração mais nova, com corte de conhecimento posterior.
Quando Luna e mini foram lançados?
Luna foi lançado em 9 de julho de 2026 e teve o preço reduzido para o valor atual em 30 de julho de 2026. GPT-5.4 mini foi lançado em 17 de março de 2026.
Fontes
- Preços atuais, verificados em 2026-07-31: developers.openai.com/api/docs/pricing
- Lançamento do GPT-5.6, faixas da família e política de gravação em cache: openai.com/index/gpt-5-6/
- Teste controlado de custo em múltiplos turnos, antes do corte: community.openai.com
- Agregados de benchmarks e capacidades: artificialanalysis.ai, docsbot.ai