 AIREITER
Nos três prompts idênticos que usamos, GPT-5.6 Luna e DeepSeek V4 Pro acertaram todos. Na prática, portanto, capacidade bruta provavelmente não será o fator decisivo entre eles. O que pesa é a combinação de preço e latência — especialmente porque a própria DeepSeek já alerta oficialmente que vem aí um aumento significativo de preços. Veja o que medimos em 10 de agosto de 2026 e como escolher entre os dois.
Teste com os mesmos prompts nas duas APIs
Em 10 de agosto de 2026, enviamos três tarefas idênticas ao GPT-5.6 Luna e ao DeepSeek V4 Pro pela mesma pipeline de API, com os dois modelos nas configurações padrão: uma correção de bug em Python com uma instrução deliberadamente curta ("responda apenas com a função corrigida"), um problema de agendamento de caminhões em três docas com uma única resposta correta (10:10) e uma extração em JSON estrito com campo anulável. Os dois acertaram as três.
| Tarefa | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Correção de bug em Python em merge_intervals | Correto (correção com max()), 10.7s | Correto (correção com max()), 16.1s |
| Raciocínio de agendamento de docas | Correto (10:10), 8.0s | Correto (10:10), 27.2s |
| Extração em JSON estrito | Válido, exato ao schema, 3.0s | Válido, exato ao schema, 7.6s |
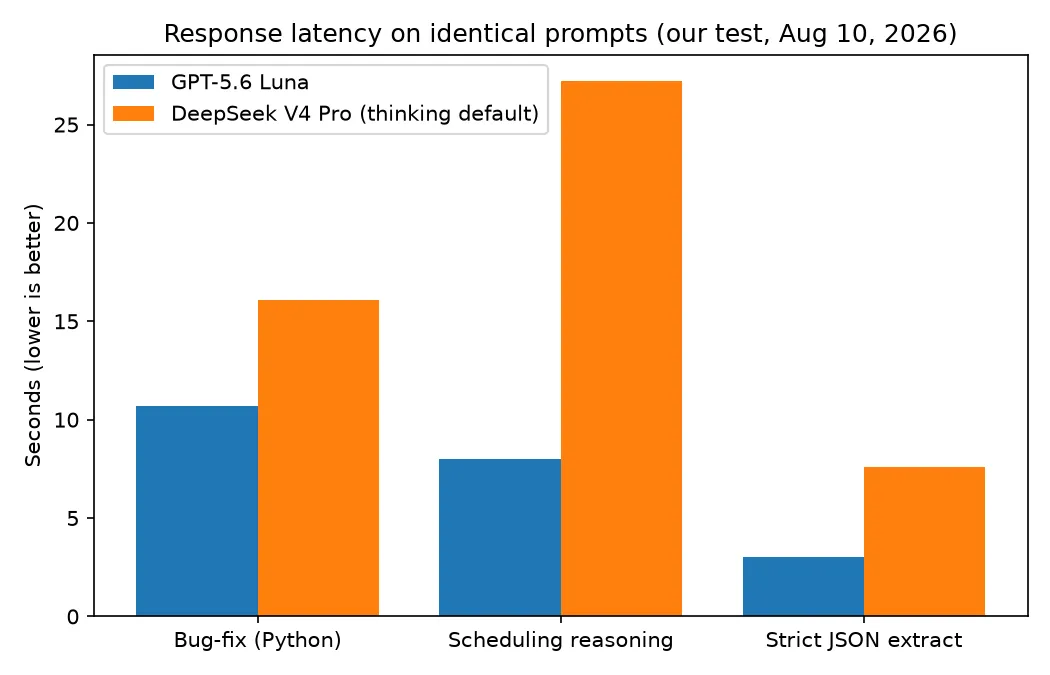
Há duas ressalvas e dois detalhes importantes. Este foi um teste pontual de três tarefas, não um benchmark. O V4 Pro usa o modo de raciocínio por padrão, o que explica boa parte da diferença de latência de 2–3x observada aqui; é possível desativá-lo por requisição, com algum custo em raciocínio mais difícil. Na adesão à instrução, Luna devolveu somente a função, como pedido, enquanto o V4 Pro a envolveu em um bloco de código Markdown. Em uma janela de chat, isso é inofensivo; em uma pipeline, acrescenta uma etapa de parsing. Reexecutamos uma vez a tarefa de agendamento para verificar a estabilidade: ambos responderam 10:10 novamente.
Preços oficiais conferidos — e o aumento que a DeepSeek já sinalizou
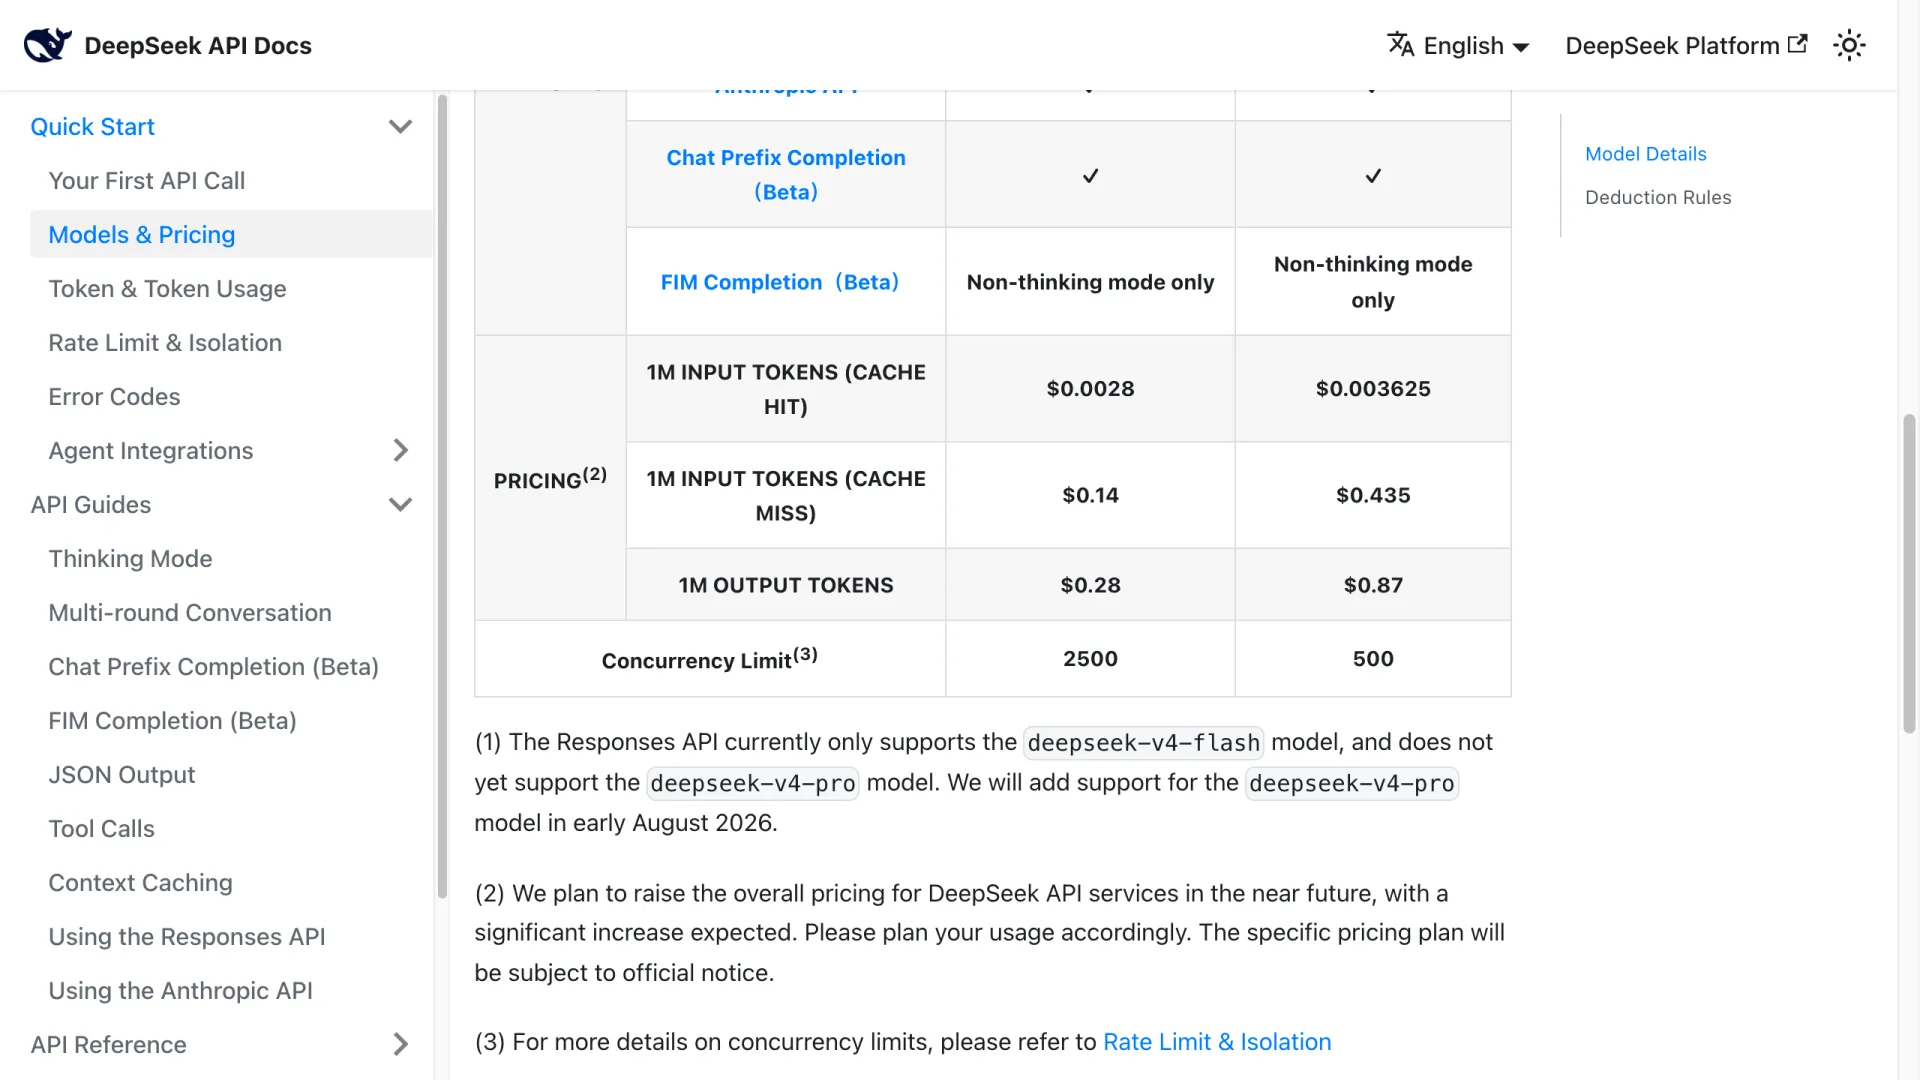
Valores verificados nas páginas oficiais das duas empresas em 10 de agosto de 2026: GPT-5.6 Luna custa $0.20 por milhão de tokens de entrada, $0.02 em cache e $1.20 de saída (página do modelo da OpenAI); DeepSeek V4 Pro custa $0.435 por milhão de tokens de entrada em cache miss, $0.003625 em cache hit e $0.87 de saída (página de preços da DeepSeek).
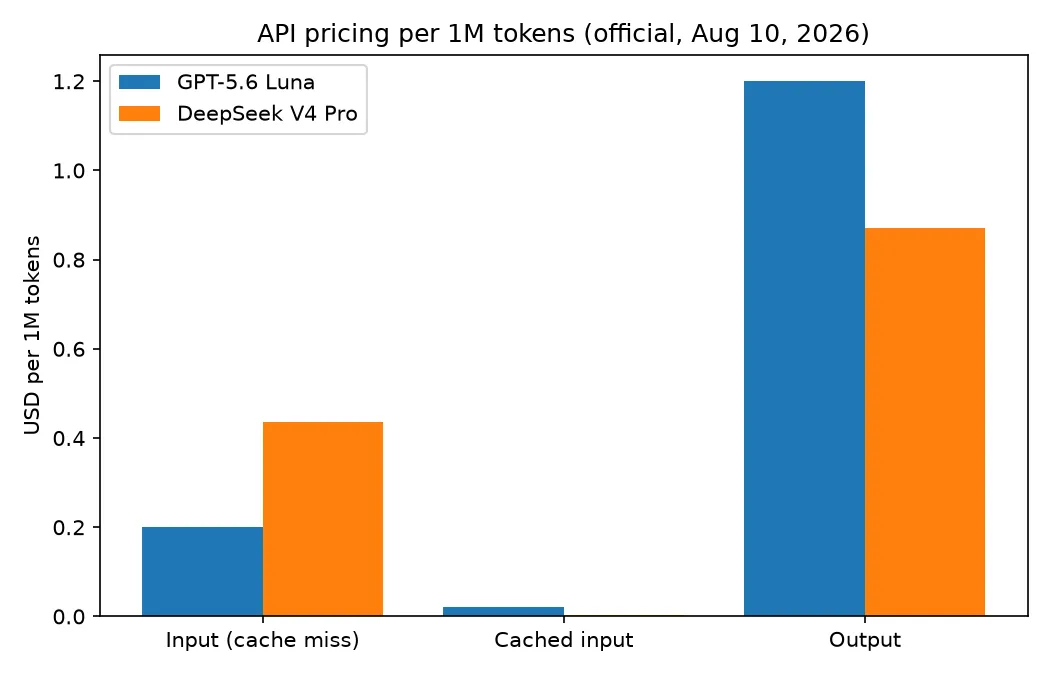
Não existe, portanto, um modelo universalmente "mais barato": a entrada sem cache do Luna custa 54% menos; a saída do V4 Pro custa 27% menos; e os cache hits do V4 Pro são 5.5x mais baratos que os do Luna. O resultado depende da composição de tokens do seu uso:
- Chat interativo (1K de entrada + 500 de saída por chamada): Luna $0.0008 vs V4 Pro $0.00087, na prática um empate.
- Revisão de repositório (50K de entrada nova + 3K de saída): Luna $0.0136 vs V4 Pro $0.0244, com Luna 44% mais barato.
- Loop de agente (200K em cache + 20K de entrada nova + 10K de saída por iteração): Luna $0.020 vs V4 Pro $0.018. O V4 Pro sai na frente neste cenário, e a vantagem aumenta a cada iteração adicional com cache.
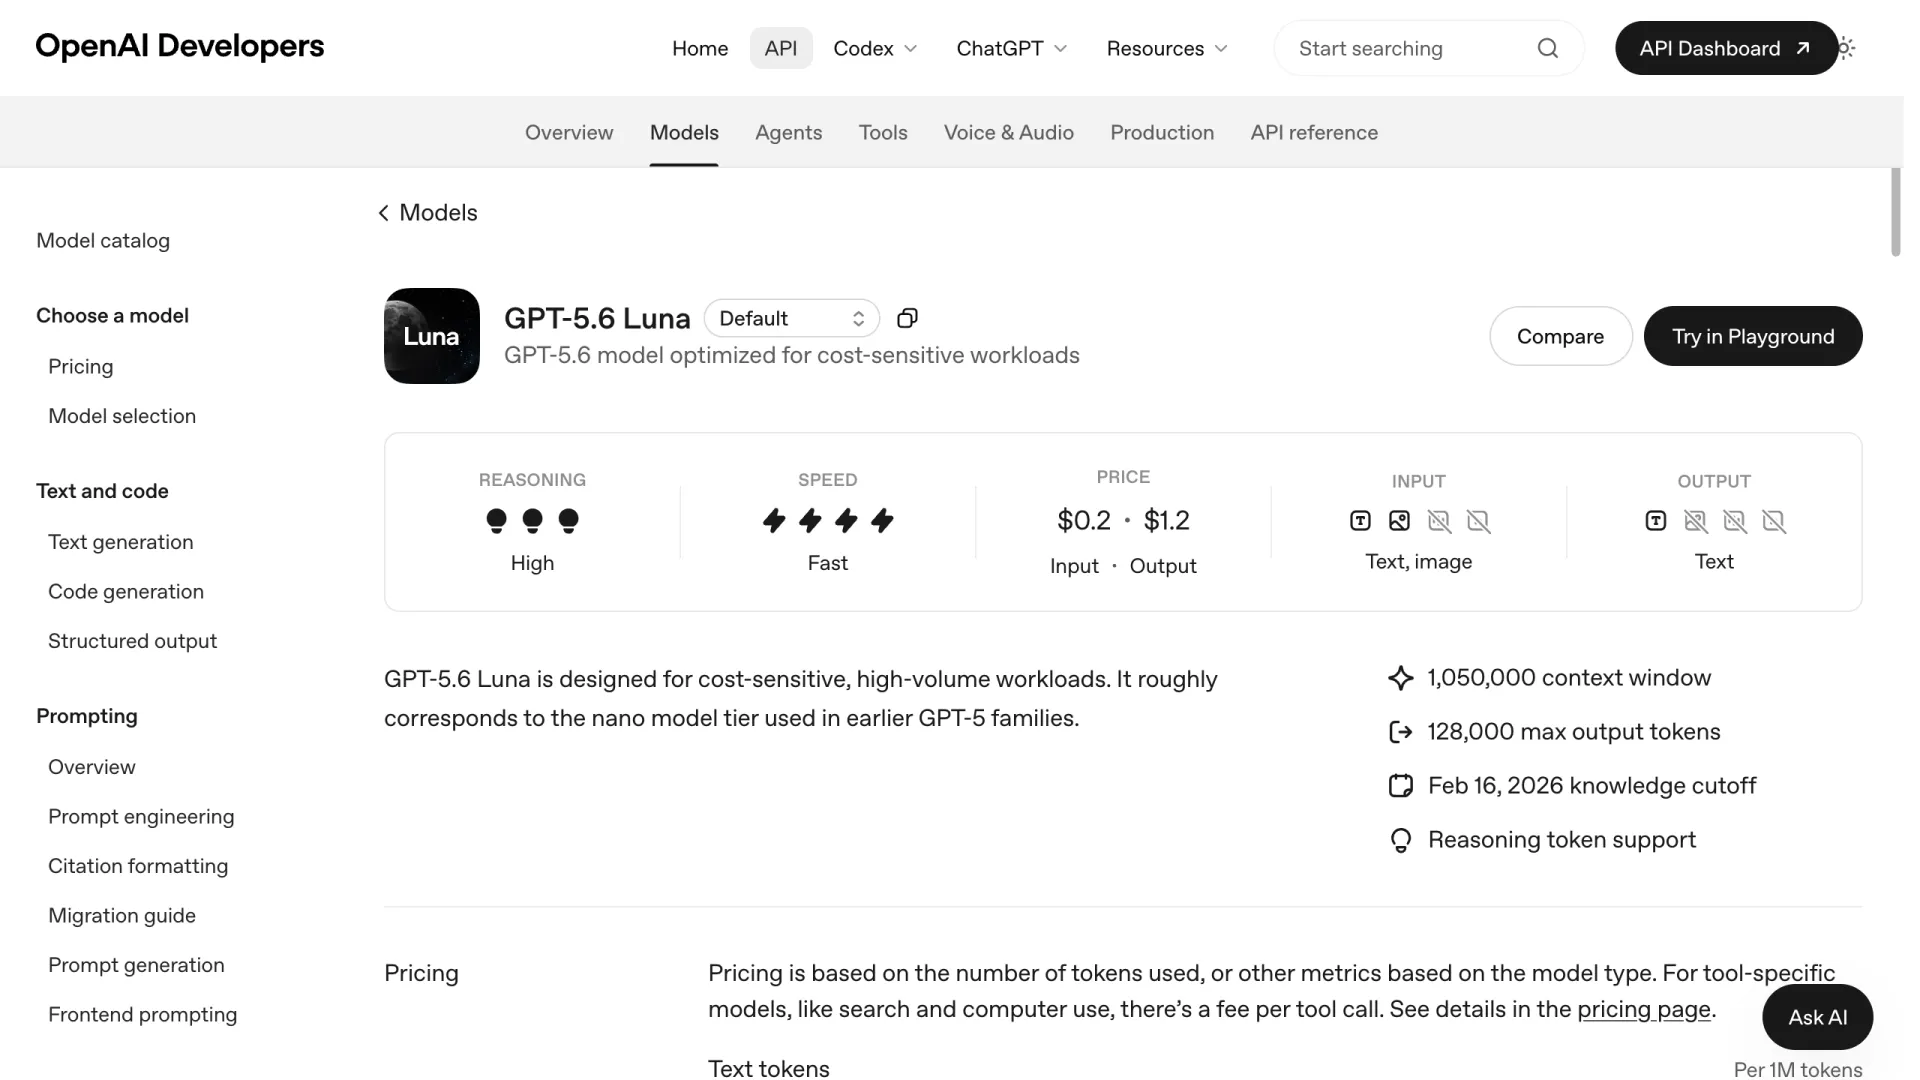
Há mais um fato que limita a durabilidade dessa conta. A nota de rodapé 2 da página de preços da DeepSeek diz: "We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected." Não há data nem valores. Mas, se a justificativa para usar o V4 Pro depende de preço, ela já vem com um aviso oficial de validade. A trajetória de preços do Luna é a oposta: ele chegou junto com o corte de preços da OpenAI para GPT-5.6 em agosto.
Cache: o cenário em que o V4 Pro leva vantagem
O DeepSeek V4 Pro cobra $0.003625 por milhão de tokens de entrada em cache, contra $0.02 do Luna — uma diferença de 5.5x que domina o custo de cargas com agentes, em que cada iteração relê um prefixo longo e inalterado. Desenvolvedores que rodam agentes já notaram isso:
DeepSeek v4 Pro & MiMo v2.5 Pro ... são incrivelmente baratos para trabalho orientado por agentes por causa dos preços baixíssimos de entrada em cache ($0.0036/mtok). No Luna, o preço de entrada em cache ... a página de preços o coloca em $0.02/mtok, & isso é 5x mais caro. — comentarista do Hacker News, no tópico de lançamento do GPT-5.6
Também vale observar a sobretaxa de escrita de cache do Luna: gravações no cache são cobradas a 1.25x a tarifa de entrada sem cache (página do modelo da OpenAI), e prompts com mais de 272K tokens de entrada são cobrados a 2x a entrada e 1.5x a saída na requisição inteira. Se o contexto do seu agente passa regularmente de 272K tokens, o preço efetivo do Luna praticamente dobra justamente onde o cache do V4 Pro se torna mais vantajoso.
Antes de projetar custos, confira a documentação oficial
Durante a pesquisa desta comparação, encontramos números publicados por terceiros que variavam de $0.435 a $1.74 por milhão de tokens de entrada para o V4 Pro, além de janelas de contexto do Luna listadas entre 400K e 1.05M. Três verificações levam menos de um minuto: consulte preços apenas nas duas páginas oficiais linkadas acima, confirme a string da versão do modelo (a API atual serve DeepSeek-V4-Pro; Flash está fixado em -0731) e veja se o "preço de entrada" citado é a tarifa de cache hit ou cache miss; no V4 Pro, a diferença entre elas é de 120x.
Especificações que definem o melhor uso
Além do preço, quatro diferenças de especificação determinam qual modelo se encaixa melhor: limite de saída, modalidade, abertura e superfície de API. Ambos anunciam uma janela de contexto de cerca de 1M tokens (Luna: 1,050,000 tokens; V4 Pro: 1M), então o contexto, por si só, não separa os dois.
| Especificação (verificada em 10 de agosto de 2026) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| Janela de contexto | 1,050,000 | 1M |
| Máximo de tokens de saída | 128K | 384K |
| Modalidade de entrada | Texto + imagem | Somente texto |
| Controle de raciocínio | Níveis de esforço (baixo→máximo) | Thinking ligado (padrão) / desligado |
| Pesos abertos | Não | Sim (pode ser hospedado localmente) |
| Responses API | Sim | Ainda não (oficial: início de agosto de 2026) |
| Limite de concorrência | Baseado na camada de uso | 500 |
| Corte de conhecimento | 16 de fevereiro de 2026 | Não informado na página de preços |
O teto de 384K tokens de saída do V4 Pro é 3x maior que os 128K do Luna. Isso faz diferença para geração de codebases em uma só chamada, traduções extensas ou extração estruturada em massa, casos em que dividir o trabalho em blocos cria novos modos de falha. Já a entrada de imagem do Luna resolve outra necessidade — e usuários da DeepSeek a mencionam espontaneamente:
Minha única reclamação de verdade é que eles não conseguem lidar com imagens, o que limita a capacidade de depurar autonomamente alguns tipos de problema. — comentarista do Hacker News, sobre usar DeepSeek em projetos pessoais
Pesos abertos mudam a balança no outro sentido: o V4 Pro pode ser baixado e hospedado localmente, tornando-se a única opção aqui para exigências de residência de dados — com a ressalva de que servir um modelo desse porte exige hardware robusto com múltiplas GPUs, não é um projeto de fim de semana.
Nos benchmarks, o modo de esforço pesa mais que a escolha do modelo
Os resultados publicados para GPT-5.6 Luna e DeepSeek V4 Pro podem inverter o vencedor conforme o modo de esforço usado nos testes. Os mesmos dois modelos marcam 33.3 vs 44.3 (vitória do V4 Pro) em um tracker que roda Luna em esforço baixo contra V4 Pro no máximo, e 52 vs 45 (vitória do Luna) no Artificial Analysis, que executa ambos no máximo. Nenhum dos dois está errado: eles medem configurações diferentes.
A mesma armadilha aparece nos números de latência. O Artificial Analysis informa 132 segundos para o tempo até o primeiro token de resposta do Luna no esforço máximo: nesse modo, Luna raciocina por aproximadamente dois minutos antes de responder. No nosso teste com configurações padrão, Luna respondeu em 3–10.7 segundos. Os dois números são reais; apenas um se parece com a sua configuração de produção. Uma vez que começa a gerar, o Luna vence com folga em throughput: 202 tokens/s contra 78 (Artificial Analysis).
Os modos de esforço também alteram muito as notas de um mesmo modelo: o V4 Pro marca 90.1% no GPQA Diamond com thinking no máximo, mas 72.9% com thinking desligado. Em benchmarks compartilhados de esforço máximo, Luna lidera o SWE-Bench Pro por 62.7% a 55.4%, e os dois empatam no BrowseComp (83.3 vs 83.4). Antes de confiar em qualquer placar, faça três perguntas: qual modo de esforço foi usado, o número de latência inclui o tempo de raciocínio e as versões do benchmark são idênticas? A diferença de 84.7 vs 67.9 no Terminal-Bench de um tracker, por exemplo, compara v2.1 com v2.0.
Qual deles você deve usar?
Escolha GPT-5.6 Luna para produtos voltados ao usuário: ele foi 2–3x mais rápido nas três tarefas do nosso teste com configurações padrão, sua entrada sem cache custa metade do preço do V4 Pro e ele aceita imagens. Escolha DeepSeek V4 Pro para loops de agentes com muito cache, saídas acima de 128K tokens ou qualquer caso que precise rodar em seu próprio hardware — mas inclua o alerta oficial de aumento de preços em qualquer compromisso de longo prazo. Ambos ficam a uma simples troca de endpoint no GPT-5.6 Luna e no DeepSeek V4 Pro, então você pode repetir nossos três prompts na sua própria carga de trabalho antes de decidir.
| Sua carga de trabalho | Escolha | Fato decisivo |
|---|---|---|
| Chatbots e apps voltados ao usuário | Luna | Latência de 3.0–10.7s vs 7.6–27.2s no nosso teste; 202 vs 78 tok/s |
| Processamento de alto volume com entrada nova | Luna | $0.20 vs $0.435 por 1M de entrada sem cache |
| Loops de agentes sobre contexto estável | V4 Pro | $0.003625 vs $0.02 por 1M de entrada em cache |
| Saídas longas em uma única chamada | V4 Pro | 384K vs 128K de saída máxima |
| Visão (capturas de tela, PDFs como imagem) | Luna | V4 Pro aceita somente texto |
| Hospedagem própria / residência de dados | V4 Pro | Pesos abertos; Luna é somente API |
| Previsibilidade de orçamento até 2027 | Luna | Aviso oficial da DeepSeek sobre aumento de preços |
Perguntas frequentes
Qual é mais barato: GPT-5.6 Luna ou DeepSeek V4 Pro?
Nenhum dos dois em todos os cenários. A entrada sem cache do Luna é 54% mais barata ($0.20 vs $0.435 por 1M de tokens); a entrada em cache do V4 Pro é 5.5x mais barata ($0.003625 vs $0.02), e sua saída custa 27% menos ($0.87 vs $1.20). Agentes que usam muito cache saem mais baratos no V4 Pro; cargas com muita entrada nova custam menos no Luna.
Os dois modelos oferecem janela de contexto de 1M tokens?
Sim: Luna oferece 1,050,000 tokens, e V4 Pro oferece 1M. Vale lembrar que requisições do Luna acima de 272K tokens de entrada são cobradas a 2x na entrada e 1.5x na saída para a requisição inteira.
DeepSeek V4 Pro é open source e pode ser hospedado localmente?
Sim. O V4 Pro disponibiliza pesos abertos e pode ser hospedado localmente, ao contrário do Luna, que é somente API. Mas planeje usar hardware de serving com múltiplas GPUs, não uma única estação de trabalho.
GPT-5.6 Luna aceita entrada de imagem?
Sim, Luna aceita texto e imagem como entrada. DeepSeek V4 Pro aceita apenas texto. Os próprios usuários citam a falta de suporte a visão como a principal limitação para fluxos de depuração autônoma.
Qual é o máximo de tokens de saída de cada modelo?
DeepSeek V4 Pro pode gerar até 384K tokens por resposta; GPT-5.6 Luna é limitado a 128K. Para gerar documentos longos ou arquivos de código grandes em uma única chamada, o teto do V4 Pro é 3x maior.
Leituras relacionadas
- DeepSeek V4 Pro vs GPT-5.6 Sol: o mesmo flagship da DeepSeek contra a camada intermediária da OpenAI
- Review do GPT-5.6 Luna: Luna analisado por seus próprios méritos, além deste comparativo
- DeepSeek V4 Flash vs V4 Pro: caso o risco de preço do V4 Pro faça você considerar uma categoria abaixo