 AIREITER
Os US$ 0,15 por milhão de tokens de entrada são só o começo da conta do GLM-5.3-Flash. Acertos de cache, tokens de saída, raciocínio obrigatório e um checkpoint com cerca de 320B de parâmetros definem se a API ou os pesos abertos fazem mais sentido em uma implantação real.
Qual é o preço vigente de fato
A página oficial de preços da Z.AI informa US$ 0,15 por 1 milhão de tokens de entrada, US$ 0,03 por 1 milhão de tokens de entrada em cache e US$ 0,50 por 1 milhão de tokens de saída para o GLM-5.3-Flash. Há ainda uma promoção temporária de 50%, válida até 24:00 de 9 de setembro de 2026 no fuso UTC+8, horário de Singapura.
| Cobrança do GLM-5.3-Flash | Preço de tabela / 1M de tokens | Promoção / 1M de tokens |
|---|---|---|
| Nova entrada | US$ 0,15 | US$ 0,075 |
| Entrada em cache | US$ 0,03 | US$ 0,015 |
| Saída | US$ 0,50 | US$ 0,25 |
| Armazenamento de entrada em cache | Gratuito por tempo limitado | Gratuito por tempo limitado |
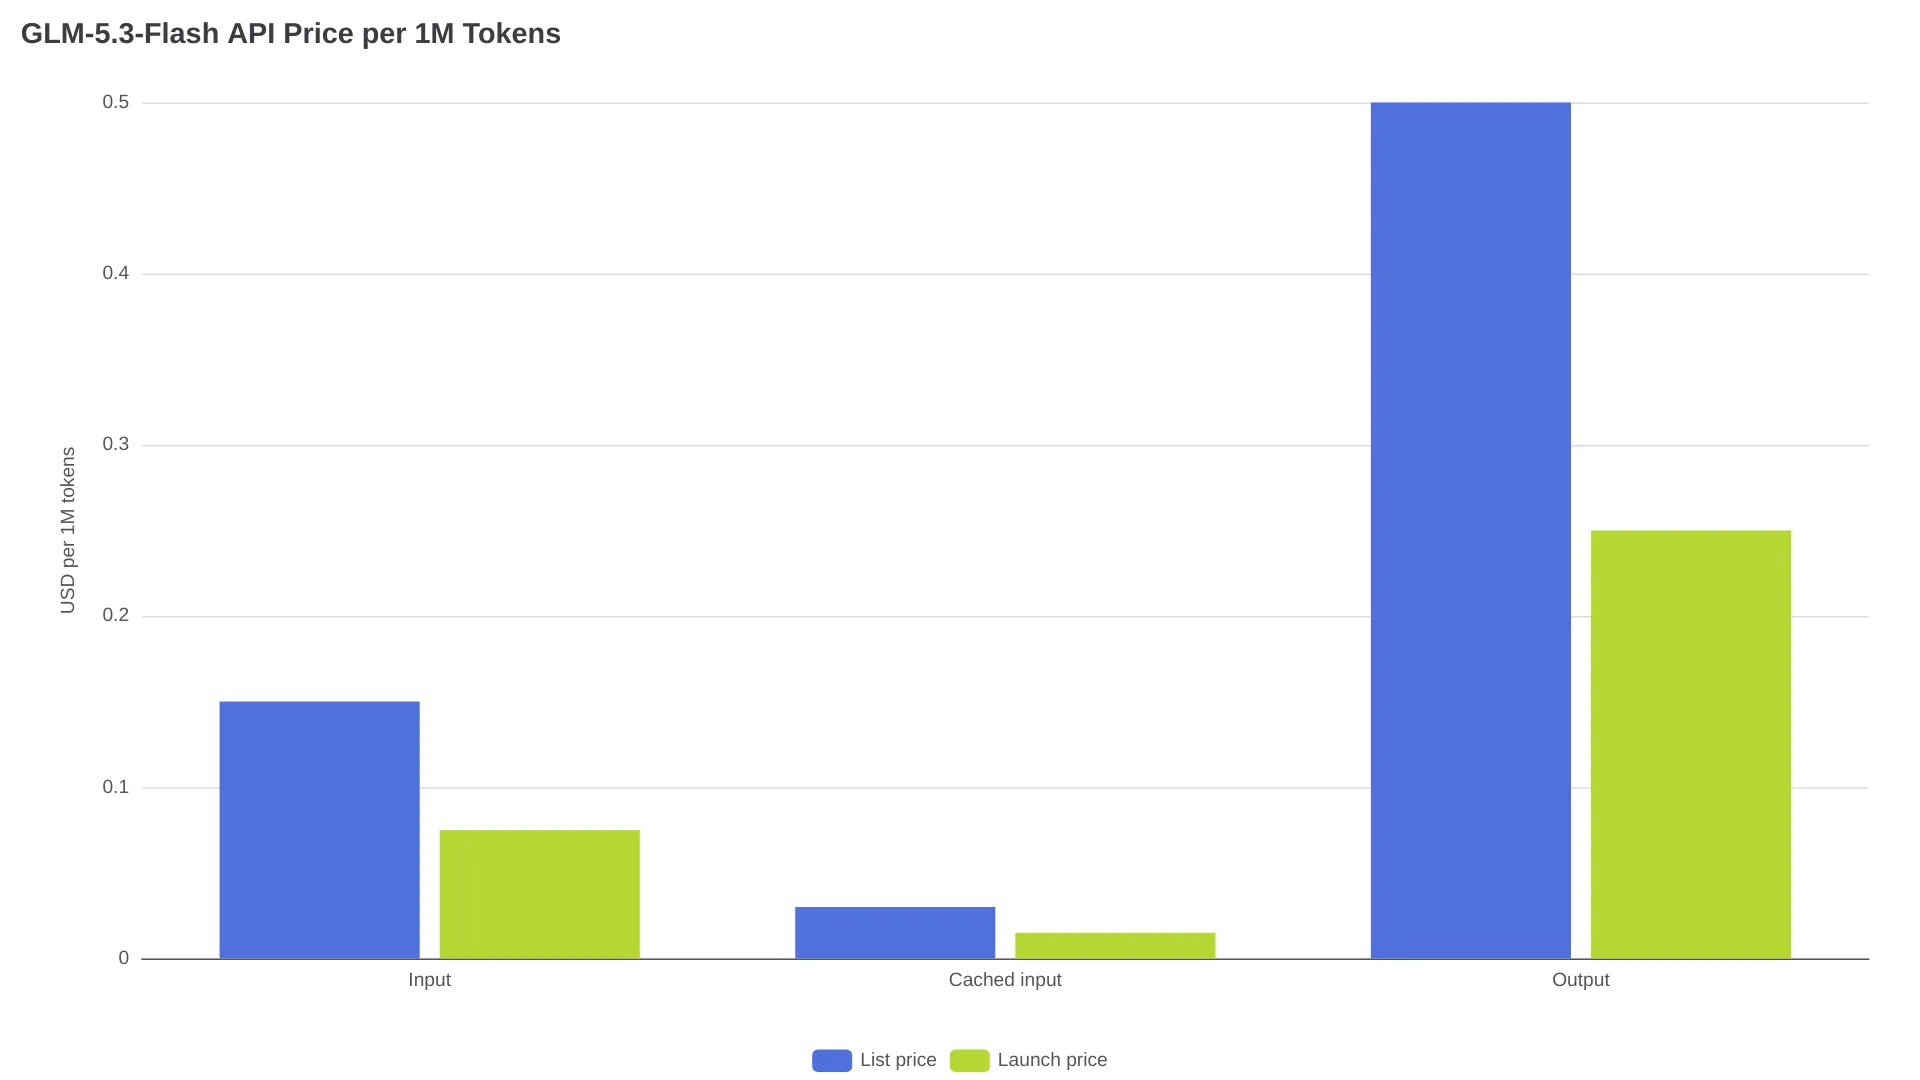
Considere o corte de 50% como preço promocional temporário, e não como base para o orçamento de produção. No anúncio de lançamento, a Z.AI identifica ox-alpha como a identidade anterior de prévia.
A mesma tabela oficial traz o GLM-5.3 padrão a US$ 1,40 para entrada, US$ 0,26 para entrada em cache e US$ 4,40 para saída por 1 milhão de tokens. Pelos preços de tabela, o Flash custa cerca de 89% menos tanto na entrada quanto na saída. Isso é uma comparação de preço, não uma afirmação de que os dois modelos entregam a mesma qualidade, latência ou comportamento operacional.
O que a API entrega — e o que ela não entrega
O GLM-5.3-Flash é um modelo multimodal de pesos abertos, licenciado sob MIT, com 320B de parâmetros totais e 18B de parâmetros ativos por token. O model card oficial no Hugging Face documenta o checkpoint público zai-org/GLM-5.3-Flash e caminhos de execução local. Nos materiais de lançamento, a Z.AI descreve uma janela de contexto de 1 milhão de tokens e entrada de texto, imagem e vídeo.
Os “18B ativos” representam a computação dos especialistas selecionados, não a memória total exigida. Os pesos completos, o cache KV, a sobrecarga de runtime, o processamento multimodal e o tamanho do contexto continuam determinando a viabilidade local.
| Forma de acesso | O que oferece | Principal limitação |
|---|---|---|
| API da Z.AI | Inferência hospedada, cobrada por tokens de entrada, entrada em cache e saída | Limites da conta e latência de raciocínio |
| Checkpoint oficial | Pesos sob licença MIT para auto-hospedagem ou adaptação | Infraestrutura com muita memória, conforme a precisão e a quantização |
| Build quantizado da comunidade | Arquivos menores para alguns runtimes locais | Qualidade do build, suporte a modalidades, velocidade e compatibilidade variam |
Token barato e hospedagem barata são alegações diferentes: usuários com tráfego irregular pagam pela API conforme as requisições chegam, enquanto a auto-hospedagem reserva capacidade de serviço até nos períodos ociosos.
Como a cobrança aparece em cargas reais
O custo do GLM-5.3-Flash depende da combinação de entrada nova, entrada reconhecida no cache e saída gerada:
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
No preço de tabela, 10 milhões de tokens de entrada nova mais 2 milhões de tokens de saída custam US$ 2,50: US$ 1,50 pela entrada e US$ 1,00 pela saída. Durante a promoção, o mesmo volume custa US$ 1,25.
| Carga de trabalho | Cálculo no preço de tabela | Total no preço de tabela | Total promocional |
|---|---|---|---|
| 10M de entrada nova + 2M de saída | US$ 1,50 + US$ 1,00 | US$ 2,50 | US$ 1,25 |
| 2M de entrada nova + 8M de entrada em cache + 2M de saída | US$ 0,30 + US$ 0,24 + US$ 1,00 | US$ 1,54 | US$ 0,77 |
| 100K de entrada nova + 10K de saída | US$ 0,015 + US$ 0,005 | US$ 0,020 | US$ 0,010 |
O valor combinado de US$ 0,10 por milhão exibido pela Artificial Analysis considera uma composição definida de 7:2:1 entre acertos de cache, entrada e saída. Ele serve para comparar uma carga de trabalho equivalente, não como tarifa universal do GLM-5.3-Flash.
A economia do cache só existe quando há um acerto efetivo. O schema de resposta do Chat Completion da Z.AI expõe usage.prompt_tokens_details.cached_tokens. Por isso, a contabilização em produção deve registrar esse campo, em vez de pressupor desconto para prompts que apenas parecem repetidos. Um usuário do r/opencodeCLI resumiu a economia no lançamento assim:
“There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f...” — u/CriteriumA, discussão no Reddit
A data do desconto é confirmada pela tabela de preços da Z.AI; a comparação e a experiência relatada são a opinião desse comentarista. Um contexto repetido e estável pode melhorar o reaproveitamento de cache, mas não elimina custos de saída, tentativas, ferramentas ou limites da conta.
Uma planilha simples para projetar o orçamento
Projete quatro linhas separadas: entrada nova, entrada em cache, saída e ferramentas pagas. A Z.AI cobra US$ 0,01 por uso do Web Search, portanto buscas recorrentes de agentes podem ultrapassar uma estimativa baseada apenas em tokens.
| Premissa de uso mensal | Fórmula no preço de tabela | Custo mensal |
|---|---|---|
| 100M de entrada nova + 20M de saída | 100 × US$ 0,15 + 20 × US$ 0,50 | US$ 25,00 |
| 20M de entrada nova + 80M de entrada em cache + 20M de saída | 20 × US$ 0,15 + 80 × US$ 0,03 + 20 × US$ 0,50 | US$ 23,40 |
| 100 chamadas de Web Search | 100 × US$ 0,01 | US$ 1,00 |
São exemplos aritméticos, não uma cota. Some separadamente as tentativas e execuções abandonadas de agentes. Se o volume de saída for alto, definir um valor realista de max_tokens e usar um reasoning_effort menor quando apropriado pode ter mais impacto do que otimizar um pequeno prefixo do prompt.
Limitações da API da Z.AI antes de migrar
A API oficial da Z.AI usa https://api.z.ai/api/paas/v4/ como URL-base geral e https://api.z.ai/api/paas/v4/chat/completions para conclusões de chat. A autenticação é feita com uma chave de API Bearer. Na introdução à API, a Z.AI documenta padrões de cliente compatíveis com OpenAI em Python, Node.js e Java por meio de uma URL-base personalizada.
A atual referência do Chat Completion menciona GLM-5.3-FLASH nas descrições de thinking e reasoning, mas o enum de modelos renderizado não exibe glm-5.3-flash. A página oficial de preços e os materiais de lançamento, por sua vez, listam o SKU Flash. Teste o ID exato do modelo hospedado com uma requisição pequena antes de redirecionar o tráfego de produção.
| Detalhe da integração | Limitação verificada |
|---|---|
| ID do modelo hospedado para testar | glm-5.3-flash; confirme a aceitação no schema ativo da conta |
| Endpoint hospedado | https://api.z.ai/api/paas/v4/chat/completions |
| Autenticação | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH usa thinking ativado; a profundidade é controlada com reasoning_effort |
| Esforço de raciocínio | low, high ou max |
Máximo de max_tokens | 131,072 na referência atual de parâmetros |
| Coding Plan | Chave, endpoints e sistema de créditos separados; não é um saldo de API de uso geral. Veja o guia de início rápido do Coding Plan da Z.AI |
A Z.AI define max como esforço de raciocínio padrão. A tarifa por token não muda conforme o nível de esforço, mas o raciocínio pode alterar o consumo de saída e o tempo de espera. Para limites de conta, a Z.AI direciona usuários a um painel de limites de taxa específico da conta; sua orientação pública não informa um teto numérico universal para todas as contas de API.
Pesos abertos ou API hospedada?
O model card oficial traz receitas de execução local com Transformers, vLLM, SGLang, TokenSpeed e KTransformers, mas elas não comprovam uma implantação prática em GPUs de consumo.
Use a API hospedada para tráfego intermitente ou quando não houver hardware de inferência com muita memória disponível. Considere uma implantação distribuída ou local quando a utilização for contínua, ou quando o controle sobre o tratamento dos dados justificar o custo operacional. Um build de texto com precisão reduzida pode não reproduzir a configuração multimodal oficial.
Em que ponto a auto-hospedagem passa a valer a pena
Uma estimativa da GetDeploying indica cerca de 192 GB de memória de GPU para uma implantação em 4 bits, aproximadamente 384 GB em 8 bits e 768 GB em BF16. Ela estima uma configuração MI300X a US$ 2,90 por hora em cerca de US$ 2.088 por mês em execução contínua, com paridade entre API e auto-hospedagem próxima de 14 milhões de tokens por hora em uma proporção de 5:1 entre entrada e saída.
Essas são estimativas de terceiros, não garantias de hardware da Z.AI. A configuração de 192 GB em 4 bits é classificada como apertada; cache KV, sobrecarga de runtime, processamento multimodal, batching e tempo ocioso podem deslocar o ponto de equilíbrio. Antes de escolher a inferência local, compare custo de infraestrutura por hora, utilização, tokens efetivos por hora, taxa de acertos de cache e custo por tarefa concluída.
GLM-5.3-Flash ou GLM-5.3: onde está a diferença
Flash e GLM-5.3 padrão têm tabelas de preço e posicionamentos de implantação distintos.
| Pergunta | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Preço de tabela da entrada | US$ 0,15 / 1M | US$ 1,40 / 1M |
| Entrada em cache no preço de tabela | US$ 0,03 / 1M | US$ 0,26 / 1M |
| Preço de tabela da saída | US$ 0,50 / 1M | US$ 4,40 / 1M |
| Promoção temporária | 50% de desconto até 9 de setembro de 2026 UTC+8 | Nenhuma promoção equivalente do Flash é exibida |
| Checkpoint de pesos abertos | Checkpoint oficial sob licença MIT listado | Listagem de modelo separada; não presuma pesos idênticos |
| Posicionamento multimodal | Multimodal nativo; entrada de imagem e vídeo descrita pela Z.AI | Trate a cobertura do GLM-5.3 padrão separadamente |
| Implantação local | Exige checkpoint grande e serviço com muita memória | Use a documentação específica de modelo e implantação |
Comece pelo Flash quando custo por token, entrada multimodal ou uma alternativa com pesos abertos forem importantes, e a aplicação puder tolerar raciocínio obrigatório e limitações do provedor. Escolha o GLM-5.3 padrão somente depois de medir se sua tarifa maior compra uma diferença de capacidade ou confiabilidade relevante para a aplicação.
Perguntas frequentes
Qual é o preço atual da API GLM-5.3-Flash?
As tarifas oficiais de tabela são US$ 0,15 para entrada, US$ 0,03 para entrada em cache e US$ 0,50 para saída por 1M de tokens. A tabela de tarifas acima mostra os preços temporários com 50% de desconto.
A entrada em cache usa a tarifa de US$ 0,03?
Sim, quando a Z.AI reconhece os tokens como armazenados em cache. O armazenamento de entrada em cache aparece separadamente como gratuito por tempo limitado, portanto o status de armazenamento e a cobrança por acerto de cache não devem ser confundidos.
O GLM-5.3-Flash é open source?
A descrição precisa é a de um checkpoint de pesos abertos sob licença MIT. A licença permite uso amplo, mas o modelo de 320B de parâmetros totais ainda exige muita memória, software compatível e capacidade de serviço.
Posso rodar o GLM-5.3-Flash em um notebook comum?
Não como uma implantação prática em precisão total. Mesmo estimativas de terceiros para 4 bits ficam em torno de 192 GB de memória de GPU, e os 18B de parâmetros ativos não eliminam o custo de armazenamento e execução do checkpoint completo.
O GLM-5.3-Flash é mais rápido que o GLM-5.3?
“Flash” é sustentado como posicionamento de custo e computação ativa, não como garantia universal de latência. A Artificial Analysis informa 48,7 tokens de saída por segundo via Z.AI e 42,57 segundos até o primeiro token de resposta em sua configuração medida; o tempo de raciocínio e o formato da carga de trabalho podem dominar o tempo de resposta percebido.
O Coding Plan oferece o mesmo saldo da API?
Não. O guia de início rápido do Coding Plan da Z.AI documenta uma chave exclusiva do Coding Plan, endpoints separados e acesso limitado a ferramentas e produtos oficialmente compatíveis. Uma assinatura do Coding Plan não deve ser convertida diretamente em um orçamento de API pública em dólares por token.
A API é a alternativa de menor risco quando o tráfego é intermitente e o hardware ainda não foi pago; servir o modelo localmente é uma decisão econômica diferente, que depende de utilização contínua, memória e requisitos de controle dos dados.