 AIREITER
O Google anunciou o Gemini 4 Carbon em 28 de outubro de 2026 como seu modelo mais poderoso até agora. Ele lidera o Artificial Analysis Intelligence Index v5.0, com pontuação 59. O problema é conseguir usá-lo: nesta semana, apenas especialistas em defesa cibernética previamente avaliados terão acesso pelo Fairwind Program, e ainda não existe um ID público de modelo para a API.
Antes do anúncio, rastreadores ainda tratavam o Carbon como um vazamento não confirmado. Agora, o Google divulgou benchmarks e preços. Este guia reúne essas informações com a avaliação independente da Vals.ai e um plano da Argon para começar a desenvolver imediatamente.
Dá para chamar o Gemini 4 Carbon hoje?
Não. Em 28 de outubro de 2026, o Gemini 4 Carbon foi anunciado, mas ainda não está disponível de forma geral para desenvolvedores, empresas ou consumidores. O Google diz que um grupo seleto de especialistas em defesa cibernética terá acesso durante a semana do anúncio. Depois, o acesso será ampliado para parceiros confiáveis pelo Fairwind Program. A disponibilidade mais ampla virá assim que possível, mas não há uma data definida.
Essa liberação gradual permite testes de cibersegurança sem as proteções habituais, além do trabalho de segurança pré-lançamento realizado com testes do governo dos Estados Unidos enquanto o Google aprimora seus mecanismos de proteção. Não foram divulgados ID público de modelo, listagem no AI Studio ou limites de requisição.
Isso muda o cenário da semana passada. Antes de 28 de outubro, a documentação para desenvolvedores do Google listava apenas gemini-4-argon como modelo da API Gemini 4, e os rastreadores afirmavam corretamente que não existia um ID do Carbon. A informação estava certa naquela época e agora ficou desatualizada: o Carbon existe como produto anunciado, mas ainda não como endpoint que possa ser chamado.
Se algum provedor já listar gemini-4-carbon, trate a oferta como não verificada até que ele documente o modelo de origem, o tipo de rota — pública, restrita, experimental ou alias — e as permissões necessárias. Uma listagem, sozinha, não prova que o Google direcionou aquele checkpoint para o solicitante.
Qual é o foco real do Carbon
O Gemini 4 Carbon foi projetado para trabalhos de engenharia contínuos, que podem durar vários dias, e não para conversas de uma única rodada. Segundo o Google, equipes internas observaram o modelo trabalhando por dias, persistindo mesmo diante de becos sem saída em tarefas como investigar bugs sutis, corrigi-los em bases de código extensas e atuar em sistemas de baixo nível.
Esse posicionamento nasceu do feedback de usuários em programação, tarefas agênticas, trabalhos científicos, desenvolvimento web full-stack e compreensão multimodal. O único ranking externo citado pelo Google neste contexto é o WebDev Arena: o Carbon ganhou 89 pontos Elo, chegou a 1768 e ficou em #4. A empresa atribui o resultado à melhor qualidade das respostas e dos artefatos gerados.
O Google também afirma que o Carbon oferece um ganho superior a 2x na taxa interna de sucesso de geração de código seguro em relação ao Gemini 4 Argon. O multiplicador não vem acompanhado dos valores absolutos — não há linha de base, tamanho do conjunto de dados ou divisão por linguagem —, portanto ele indica uma direção, não uma justificativa suficiente para migração. A afirmação da equipe do Chrome de que o modelo gera mais de 10x patches de alta qualidade do que o grande modelo de fronteira de outro laboratório sofre do mesmo problema: o concorrente não foi identificado e a métrica não foi definida.
O Argon foi lançado em meados de outubro de 2026; o Carbon ocupa o topo da mesma linha e da mesma camada de segurança.
O placar de cibersegurança — e o que os números não mostram
O principal diferencial do Carbon é cobrir todo o ciclo de cibersegurança: encontrar vulnerabilidades, validar se elas podem ser exploradas e corrigir suas causas. O Google informa que as três avaliações externas foram executadas sem mecanismos de proteção. Portanto, elas medem a capacidade bruta do modelo, e não necessariamente o que um endpoint de produção protegido permitirá fazer.
| Etapa | Benchmark | Pontuação do Carbon | O que testa |
|---|---|---|---|
| Encontrar | SEC-bench Pro | 88,2% | Encontrar autonomamente falhas reais em software real |
| Explorar | ExploitGym | 54,8% | Validar se as falhas podem de fato ser exploradas |
| Corrigir | CWE-bench | 71,0% | Corrigir as causas com código funcional |
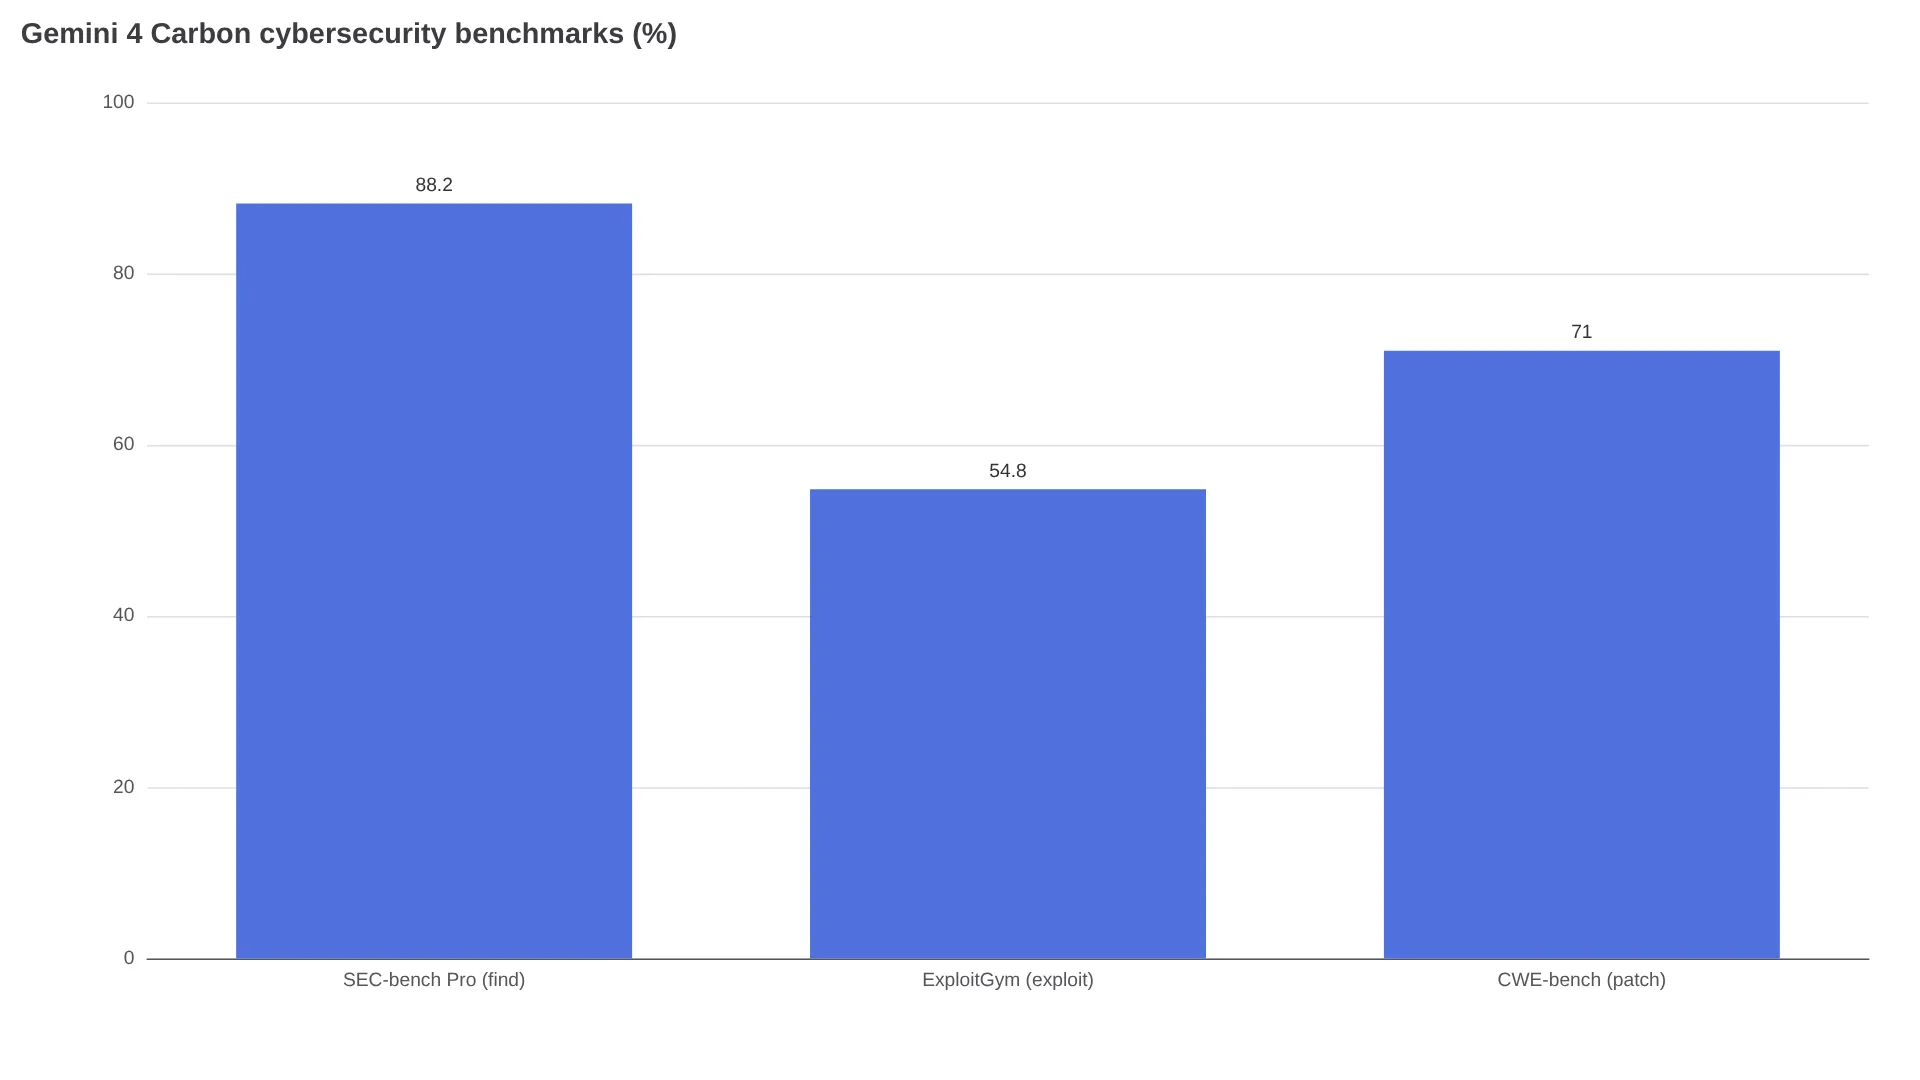
Três ressalvas são mais importantes do que as porcentagens. Primeiro, não multiplique 88,2% x 54,8% x 71,0% para obter uma taxa de sucesso de ponta a ponta: cada resultado vem de um conjunto de tarefas diferente. Segundo, descobrir vulnerabilidades (88,2%) normalmente é mais fácil de automatizar do que remediá-las com segurança (71,0%), enquanto explorar as falhas (54,8%) exige mais planejamento. A queda gradual é esperada, não um defeito. Terceiro, a afirmação do Google e da Wiz sobre liderança em testes de intrusão web, vinculada à iniciativa Scan for Good, não informa nome nem pontuação do benchmark e não pode ser comparada.
A leitura prática é a seguinte: o Carbon parece mais promissor como assistente de triagem e correção para equipes com grandes filas de vulnerabilidades do que como red team autônomo. A capacidade de exploração também explica por que o acesso está restrito desde o início.
Segurança e integridade: 0% de trapaça, 0% de prompt injection
A segunda grande promessa do Carbon é manter a confiabilidade sob pressão, com números bastante específicos. O Google relata 0,0% de trapaças bem-sucedidas e 0,4% de tentativas de trapaça no Terminal-Bench 4.0, enquanto a precisão geral também aumentou. Os alertas de desalinhamento de alta gravidade caíram quase 80% em ambientes internos de programação ao vivo.
A resistência a prompt injection também melhorou no benchmark Gray Swan Indirect Prompt Injection. O resultado anterior de liderança do Argon era uma taxa de sucesso de ataque de 0,7%; o Carbon registra 0,0%, sem nenhum ataque bem-sucedido na avaliação divulgada. O Google acrescenta 26% menos extrapolação de escopo e 29% menos atendimento insuficiente em comparação com a linha de base anterior, apresentando o resultado como uma execução multitarefa mais confiável dentro dos limites definidos.
Cada melhoria, porém, não informa o denominador necessário para reproduzi-la. O Google não revela quantos ataques estão por trás do índice de 0,0%, qual era a taxa de alertas antes da queda de quase 80%, qual é a rubrica usada para medir extrapolação e atendimento insuficiente, nem como a detecção de trapaças foi conduzida. A direção é animadora para implantações com agentes, mas mantenha seus próprios registros de chamadas de ferramentas e proteções de branch. A camada interna do Google — treinamento, defesas contra uso indevido em tempo real, resistência a prompt injection e monitoramento de cadeia de raciocínio — não é transferida automaticamente para o seu framework.
A checagem independente: Vals.ai coloca o modelo em #2, não em #1
Benchmarks do próprio fornecedor precisam de uma segunda fonte, e a Vals.ai publicou uma em 28 de outubro de 2026. No Vals Index geral, o Carbon aparece em #2 entre 29 modelos, com 70,36% (±0,97), atrás do Claude Sonnet 5.5, com 70,85%, e à frente do Claude Opus 5.5, com 70,18%. O teste custou US$ 10,51 e teve latência de avaliação de 47 minutos e 45 segundos, usando alto esforço de raciocínio.
O detalhamento é mais útil do que a posição geral. O Carbon ficou em #1 entre 87 no Legal Research Bench e em #1 entre 33 no Vals Finance Index, em #2 entre 35 no EMB v1.1 e em #4 entre 57 no Terminal-Bench 4.0, com 63,13%. Seu resultado mais fraco entre os listados foi 17,50% no HLAB-Vals-1.1 (#6 entre 30). Já os 89,06% no Vibe Code Bench v1.1 renderam apenas a posição #8 entre 121 — uma pontuação bruta forte em um campo concorrido.
A vantagem do Carbon se concentra em pesquisa, finanças e tarefas com agentes jurídicos, além de uma boa atuação em programação; não é uma liderança uniforme. A Vals informa uma janela de contexto de 1 milhão de tokens, pesos privados e preços de US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída, após o período introdutório. Os valores coincidem com os preços padrão do Google apresentados abaixo. A Vals alerta que alguns benchmarks podem usar provedores ou parâmetros diferentes, então confira as configurações de cada teste antes de citar um número isolado.
Os rastreadores anteriores ao anúncio foram publicados antes da atualização de preços e da Vals; uma análise detalhada ainda afirma que nenhum preço havia sido divulgado.
Quanto ele vai custar quando a API abrir
O Google divulgou os preços do Carbon no anúncio, com as mesmas tarifas introdutórias do Argon. Não há data de encerramento para o período promocional, nem uma tabela de assinatura ou limites de requisição.
| Tipo de token | Preço introdutório | Preço padrão |
|---|---|---|
| Entrada | US$ 2,00 / 1M | US$ 4,00 / 1M |
| Saída | US$ 10,00 / 1M | US$ 20,00 / 1M |
| Entrada em cache (95% de desconto na entrada) | ~US$ 0,10 / 1M | ~US$ 0,20 / 1M |
O cálculo da entrada em cache é derivado, não apresentado diretamente: 95% de desconto sobre US$ 2 resulta em US$ 0,10, e 95% de desconto sobre US$ 4 resulta em US$ 0,20. Agentes com contexto longo e código repetido são os que mais se beneficiam do desconto, mas os tokens de saída ainda dominam a conta, custando 5x mais do que os de entrada.
Não faça o orçamento olhando apenas o preço da tabela. Meça o custo por resultado aceito: o gasto total, incluindo novas tentativas, saídas descartadas, contexto repetido e chamadas de reparo, dividido pelo número de resultados aprovados. Uma rota mais barata que precisa de três rodadas de correção costuma sair mais cara do que uma rota premium que acerta de primeira. O Google não divulgou dados de latência ou throughput do Carbon, então comparações de tokens por segundo seriam especulação.
Leituras relacionadas sobre a conta atual: preços e disponibilidade da API do Gemini 4 Argon e o que sabemos sobre o Gemini 4.
Por que os primeiros testadores estão irritados
Os testadores de pré-lançamento relatam a mesma troca na compilação de 23 de outubro da TestingCatalog: geração 3D visivelmente melhor que a do Argon, mas respostas muito mais lentas e a persistência de resultados fracos em frontend e interfaces. Um dos testadores estimou respostas aproximadamente 2 a 4 vezes mais lentas, dependendo da tarefa.
A frustração com o acesso domina as discussões de usuários reais mais do que qualquer benchmark:
eu realmente não entendo a estratégia de lançamento de modelos do Google. o gemini 4 carbon parece impressionante nos benchmarks, mas, mais uma vez, as pessoas não podem usá-lo. o acesso está inicialmente limitado, sem data para o lançamento geral.
O padrão de reclamações se repete em vários tópicos: o consumo de cota parece imprevisível no Argon, sessões de cinco minutos atingem os limites por hora e há uma fragmentação entre as edições do Gemini App, AI Studio e Antigravity. Outro testador resume o problema de verificação:
Apenas especialistas em defesa cibernética previamente avaliados terão acesso nesta semana; o lançamento mais amplo virá “em breve”. Minha opinião: um resultado de leaderboard executado dentro do framework do próprio fabricante vale metade. Espere alguém rodá-lo em um ambiente neutro.
O que desenvolver nesta semana
Não pare o desenvolvimento esperando pelo Carbon. O caminho mais prático é colocar o produto no ar com um modelo confirmado e manter o novo modelo como candidato substituível.
- Desenvolva hoje com
gemini-4-argonusando a API documentada e mantenha a URL base, a chave de API e o ID do modelo fora da lógica de negócio. - Congele um conjunto de avaliação com 30 a 50 tarefas do seu próprio repositório — correções de bugs, refatorações e revisões de segurança — e registre taxa de aprovação, tempo de revisão e custo por resultado aceito antes da chegada do Carbon.
- Adicione agora as proteções que agentes em execuções de vários dias precisarão de qualquer forma: trabalho baseado em branches, limites de gastos, registros de auditoria das chamadas de ferramentas, checkpoints e etapas de aprovação humana.
- Quando uma rota do Carbon for documentada para sua conta, adicione-a como candidata, repita o mesmo conjunto de testes e compare qualidade, latência, custo e suporte a recursos — streaming, imagens, chamadas de função e saída estruturada — antes de redirecionar o tráfego. Inicie novas sessões em vez de trocar de modelo no meio de uma tarefa.
Equipes com grandes filas de AppSec também devem registrar cada chamada de ferramenta e testar, no próprio repositório, formas de trapaça semelhantes às dos benchmarks, como saídas codificadas e alterações nos arquivos de teste. O índice de 0,0% do Google é um resultado do fornecedor em seu próprio framework, não uma garantia no seu.
| Situação | O que fazer nesta semana |
|---|---|
| Precisa lançar um agente ou auxiliar de segurança | Use o Argon pela API e instrumente custo e latência |
| Está bloqueado apenas pelas pontuações de cibersegurança do Carbon | Não há um caminho público de solicitação documentado; acompanhe o anúncio da Fairwind pelo Google |
| Está escolhendo entre Carbon, Opus 5.5 e GPT-6.1 Terra | Espere novas execuções neutras; atualmente, a Vals coloca o Sonnet 5.5 à frente no geral e o Opus 5.5 logo atrás do Carbon |
| Trabalho com contexto longo e orçamento sensível a preço | Projete o sistema para usar entrada em cache desde o primeiro dia; o tamanho da saída define a conta |
Gemini 4 Carbon: perguntas frequentes
O Gemini 4 Carbon está disponível pela API?
Não publicamente. Durante a semana do anúncio, o acesso é limitado a especialistas em cibersegurança e depois será ampliado para parceiros confiáveis da Fairwind. Desenvolvedores, empresas e consumidores não têm uma data definida. Desenvolva com o Argon e mantenha o ID do modelo configurável.
Qual é o ID do modelo Gemini 4 Carbon?
O Google ainda não publicou um. Não presuma que gemini-4-carbon funciona. Use apenas um identificador que o provedor documente explicitamente, com endpoint, permissões e preços.
Quanto custa o Gemini 4 Carbon?
O preço introdutório é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com entrada em cache 95% mais barata (~US$ 0,10). Depois, o preço padrão será de US$ 4 para entrada e US$ 20 para saída (~US$ 0,20 em cache). Não foi informado quanto tempo durará o período introdutório.
Como o Carbon se compara ao Argon?
O Google afirma um ganho superior a 2x na geração de código seguro, 26% menos extrapolação de escopo, 29% menos atendimento insuficiente e taxa de sucesso contra prompt injection de 0,0%, contra 0,7% do modelo anterior. Os dados independentes da Vals cobrem apenas o Carbon; trate as diferenças em relação ao Argon como internas do fornecedor até que surjam novos testes neutros.
O Carbon supera o Claude Opus 5.5 ou o GPT-6.1 Terra?
Isso ainda não foi comprovado em uma comparação direta. Uma impressão de um funcionário antes do lançamento, relatada pelo GetAICodingAgent, dizia que o Carbon parecia o Opus 5.5 em programação. No ranking geral da Vals, o Carbon (70,36%) aparece ligeiramente acima do Opus 5.5 (70,18%), mas abaixo do Sonnet 5.5 (70,85%). Não há um resultado controlado comparando Carbon e Terra.
Quando chega a disponibilidade geral?
O Google diz que será assim que possível após as fases com especialistas em defesa e parceiros, mas não informa uma data. Acompanhe o blog oficial da DeepMind e o catálogo de modelos do seu provedor, não os tópicos de vazamentos.