 AIREITER
Um cardápio de café com quatro preços parece simples até o modelo trocar um deles. A MOSS Image acerta esse tipo de texto com uma frequência surpreendente para o seu tamanho, mas exige estrutura no prompt e uma revisão final com olhar de designer.
É justamente esse equilíbrio que esta análise coloca à prova: um modelo de texto para imagem com 5 bilhões de parâmetros, licença Apache 2.0, suporte a prompts de até 4.096 tokens e caixas delimitadoras opcionais em JSON para textos e objetos. O time da OpenMOSS lançou o modelo em 16 de outubro de 2026, com os checkpoints Base e SFT; a API hospedada na plataforma MOSI entrou no ar em 20 de outubro. Para pôsteres, menus, rótulos e infográficos com texto exato, vale fazer um teste. Já para consistência de personagens ou edição de fotos, continue com um modelo fechado.
As primeiras imagens definem o veredito: o texto sobrevive, mas a beleza nem sempre
A MOSS Image chama atenção principalmente pela capacidade de lidar com textos longos e exatos, não por uma estética universalmente superior. O LongLongTextBench da própria empresa registra cobertura média de texto de 96,3 no indicador Mean-6 — 97,1 para textos longos em inglês e 92,4 para textos longos em chinês, em 240 tarefas com média de aproximadamente 1.340 caracteres. Para comparação, o resultado foi 99,0 para GPT Image 2 e 96,6 para Nano Banana Pro. Como são números produzidos pela própria empresa em um benchmark criado por ela, trate-os como uma alegação a ser verificada, não como garantia.
A obediência ao layout é o segundo número importante. O relatório técnico detalhado nesta análise aponta 0,88 de mIoU e 0,70 de Layout AUC no teste 7Bench de seguimento de caixas — aproximadamente o dobro do Ideogram 4, com 0,44 e 0,20, e bem acima do GPT Image 2, com 0,30 e 0,16, no mesmo relatório. No RealLayoutArena — 61 tarefas avaliadas às cegas entre pôsteres, infográficos e interfaces — o sistema MOSS completo, com aprimoramento de prompt, alcança 1.698,70 Elo, atrás apenas do GPT Image 2, com 1.844,35. Quando todos os geradores recebem o mesmo prompt aprimorado, o backbone sozinho fica em primeiro. Mais uma vez: são resultados da própria empresa, ainda aguardando replicação independente.
Um teste controlado curto deixa a diferença mais clara. O time por trás do mossimage.run comparou a MOSS Image SFT com a FLUX.1 dev uma vez por prompt, no mesmo canvas de 1024x1024 e com as mesmas seeds, sem escolher apenas os melhores resultados — as falhas também permaneceram no conjunto. Eu não repeti o teste de latência da MOSI hospedada nesta análise; os resultados da tabela são as primeiras imagens geradas por aquele time usando endpoints fal. A API da MOSI foi avaliada a partir da documentação e do status da janela gratuita de cobrança:
| Teste | O que o prompt exigia | Primeira saída da MOSS Image SFT | Primeira saída da FLUX.1 dev |
|---|---|---|---|
| Cardápio de café | MORNING MENU mais Espresso 3.50, Flat White 4.20, Butter Croissant 3.80, Avocado Toast 8.50 alinhados à direita | Os quatro itens e preços apareceram como escritos | Layout claro, mas 3.80 virou 3.60 |
| Rótulo de mel | WILDFLOWER HONEY, Raw & Unfiltered, Net Wt. 12 oz (340 g) acompanhando a curva do rótulo | As três linhas apareceram como escritas | Título e peso corretos; a linha do meio virou Raw & Unfilterelrd |
| Pôster bilíngue | 周末市集 / WEEKEND MARKET, Sat 10:00–18:00, Riverside Park, Free entry / 免费入场 | Detalhes em chinês e inglês como escritos | Composição forte, mas chinês ilegível e 10.00–178.00 |
As configurações foram 50 steps e CFG 3 para a MOSS, contra 28 steps e guidance 3.5 para a FLUX, usando fal-ai/moss-image e fal-ai/flux/dev. Três exemplos não são suficientes para declarar um vencedor, como a própria página observa. Mas o padrão de falha é o ponto principal: uma imagem convincente com um preço ou horário alterado é pior do que uma imagem obviamente quebrada.
"A MOSS Image lidou bem com o layout estruturado e com o texto em inglês para um modelo de 5B. Não acerta todos os detalhes pequenos, mas o fluxo finalmente pareceu controlável." — @Olaemmy1200, em um vídeo mostrando o fluxo completo para criar um pôster
O que a API realmente entrega: gerador compacto, leitor grande
A MOSS Image é um transformer de difusão de fluxo único com 42 camadas, treinado do zero. Os 5B de parâmetros correspondem apenas ao gerador. Ao redor dele estão um encoder de texto Qwen3.5-9B congelado, responsável por interpretar o prompt, e uma VAE FLUX.2 de decoder pequeno, que transforma o resultado em pixels. Essa divisão explica tanto a força do modelo quanto a exigência de hardware: a compreensão de textos longos e bilíngues vem de um leitor de 9B, não do denoiser de 5B.
A janela de contexto é a vantagem mais prática. Linguagem natural, sequências de tags e layouts em JSON compartilham o limite de até 4.096 tokens — espaço suficiente para escrever cada linha de um pôster, em vez de resumir tudo em uma legenda curta. A documentação da API MOSI descreve o limite hospedado como texto longo de até 4.000 caracteres, com renderização de texto, prompts negativos e geração de layout. As saídas recomendadas ficam na faixa de 1 a 2 megapixels, com extrapolação de 512x512 até 2K e dimensões divisíveis por 16.
Dois checkpoints definem o tipo de resultado que você vai obter:
- MOSS-Image-SFT é a versão Base refinada por supervised fine-tuning com dados selecionados. A equipe OpenMOSS recomenda esse checkpoint para geração direta, com agrupamento de texto mais organizado e layouts mais limpos. A API hospedada usa
moss-image-sft-1.0por padrão, com o snapshot fixomoss-image-sft-1.0-2026-10-09para garantir reprodutibilidade. - MOSS-Image-Base não passa pelo pós-treinamento nem pela destilação de CFG, preservando o sinal bruto do treinamento. O guia oficial recomenda essa versão para quem vai fazer fine-tuning e sugere congelar o encoder de texto. Escolha a Base ao treinar uma LoRA ou buscar uma distribuição de estilos diferente — não quando você precisa de um pôster pronto hoje.
Os dois pesos e o código de inferência incluído são publicados sob a licença Apache 2.0, segundo o model card no Hugging Face e a página oficial do projeto. Isso permite uso comercial e fine-tuning, mas não libera automaticamente todos os personagens, logotipos ou rostos gerados para uma campanha. Em projetos comerciais, mantenha o arquivo de licença e a revisão exata do modelo. O código está no repositório OpenMOSS no GitHub.
O layout em JSON é o motivo para aceitar esse fluxo de trabalho
A linguagem natural continua funcionando, mas é a sintaxe de layout que realmente desperta o interesse de designers. O prompt estruturado descreve a cena geral e, depois, atribui a cada texto ou objeto uma legenda e uma caixa próprias. Essas caixas orientam a geração; não são camadas vetoriais nem oferecem garantia de precisão pixel a pixel.
O sistema de coordenadas costuma confundir quase todo mundo na primeira tentativa. Com bbox_coord_space: "abs_centralized" e bbox_format: "yxyx", cada caixa segue o formato [y_min, x_min, y_max, x_max], em pixels relativos ao centro do canvas. Em uma imagem de 1024x1024, cada eixo vai de -512 a +512. Não cole coordenadas convencionais com origem no canto superior esquerdo, nem um layout comunitário de 0 a 1000, sem fazer a conversão para esse esquema.
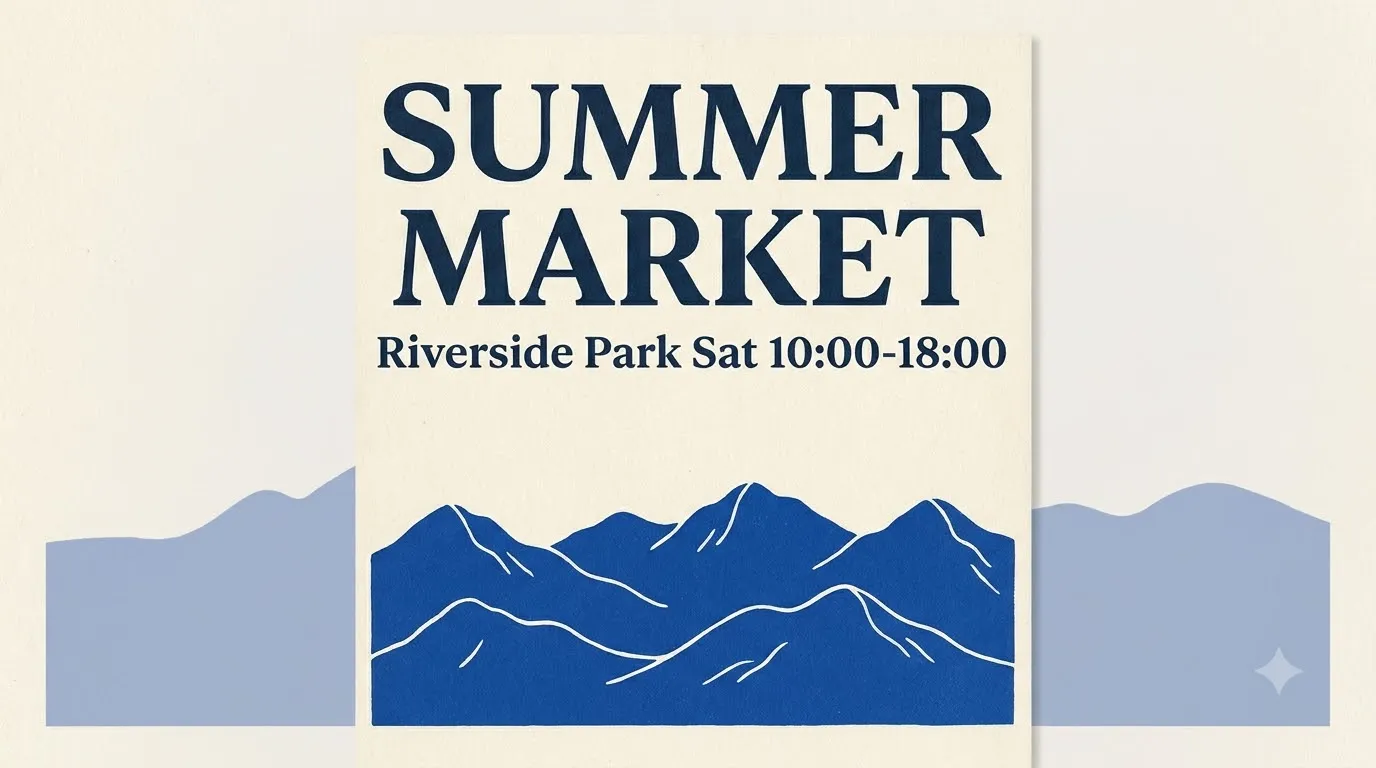
Uma estrutura mínima fica assim — título em cima e ilustração abaixo:
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Ninguém vai escrever manualmente essas caixas para um infográfico com 20 elementos. O fluxo que vem sendo usado pelos primeiros usuários é pedir a um LLM com visão que monte o JSON a partir de um briefing ou esboço e, depois, corrigir as coordenadas antes de gerar. O testador japonês @chimolog7 resumiu bem: o formato bbox é difícil demais para humanos, então ele o gerou com Opus — e descobriu que a renderização em japonês apresentava apenas cerca de 1% de erros percebidos, enquanto a Krea 2 ainda errava com frequência (post).
O segundo truque é a regeneração controlada. Como o modelo trabalha apenas de texto para imagem e não aceita uma imagem de referência, não dá para fazer img2img de uma foto e preservá-la. O que você pode fazer é alterar o texto ou a posição de uma caixa, manter a mesma seed e gerar novamente: o restante do layout tende a permanecer. O usuário @li9292 demonstrou isso na capa de um relatório semanal com milhares de caracteres chineses e 20 caixas, editando apenas uma delas com a mesma seed enquanto o restante do layout ficou intacto (post). Para trabalhos com texto exato, esse ciclo de alterar uma caixa e repetir a seed é mais importante do que qualquer preset de estilo.
Para um contexto mais amplo sobre renderização de texto, nosso teste dos melhores modelos de imagem para renderizar texto em 2026 mostra por que essa categoria precisava de uma opção orientada primeiro ao layout.
Como chamar a API — e quanto o “grátis” realmente custa
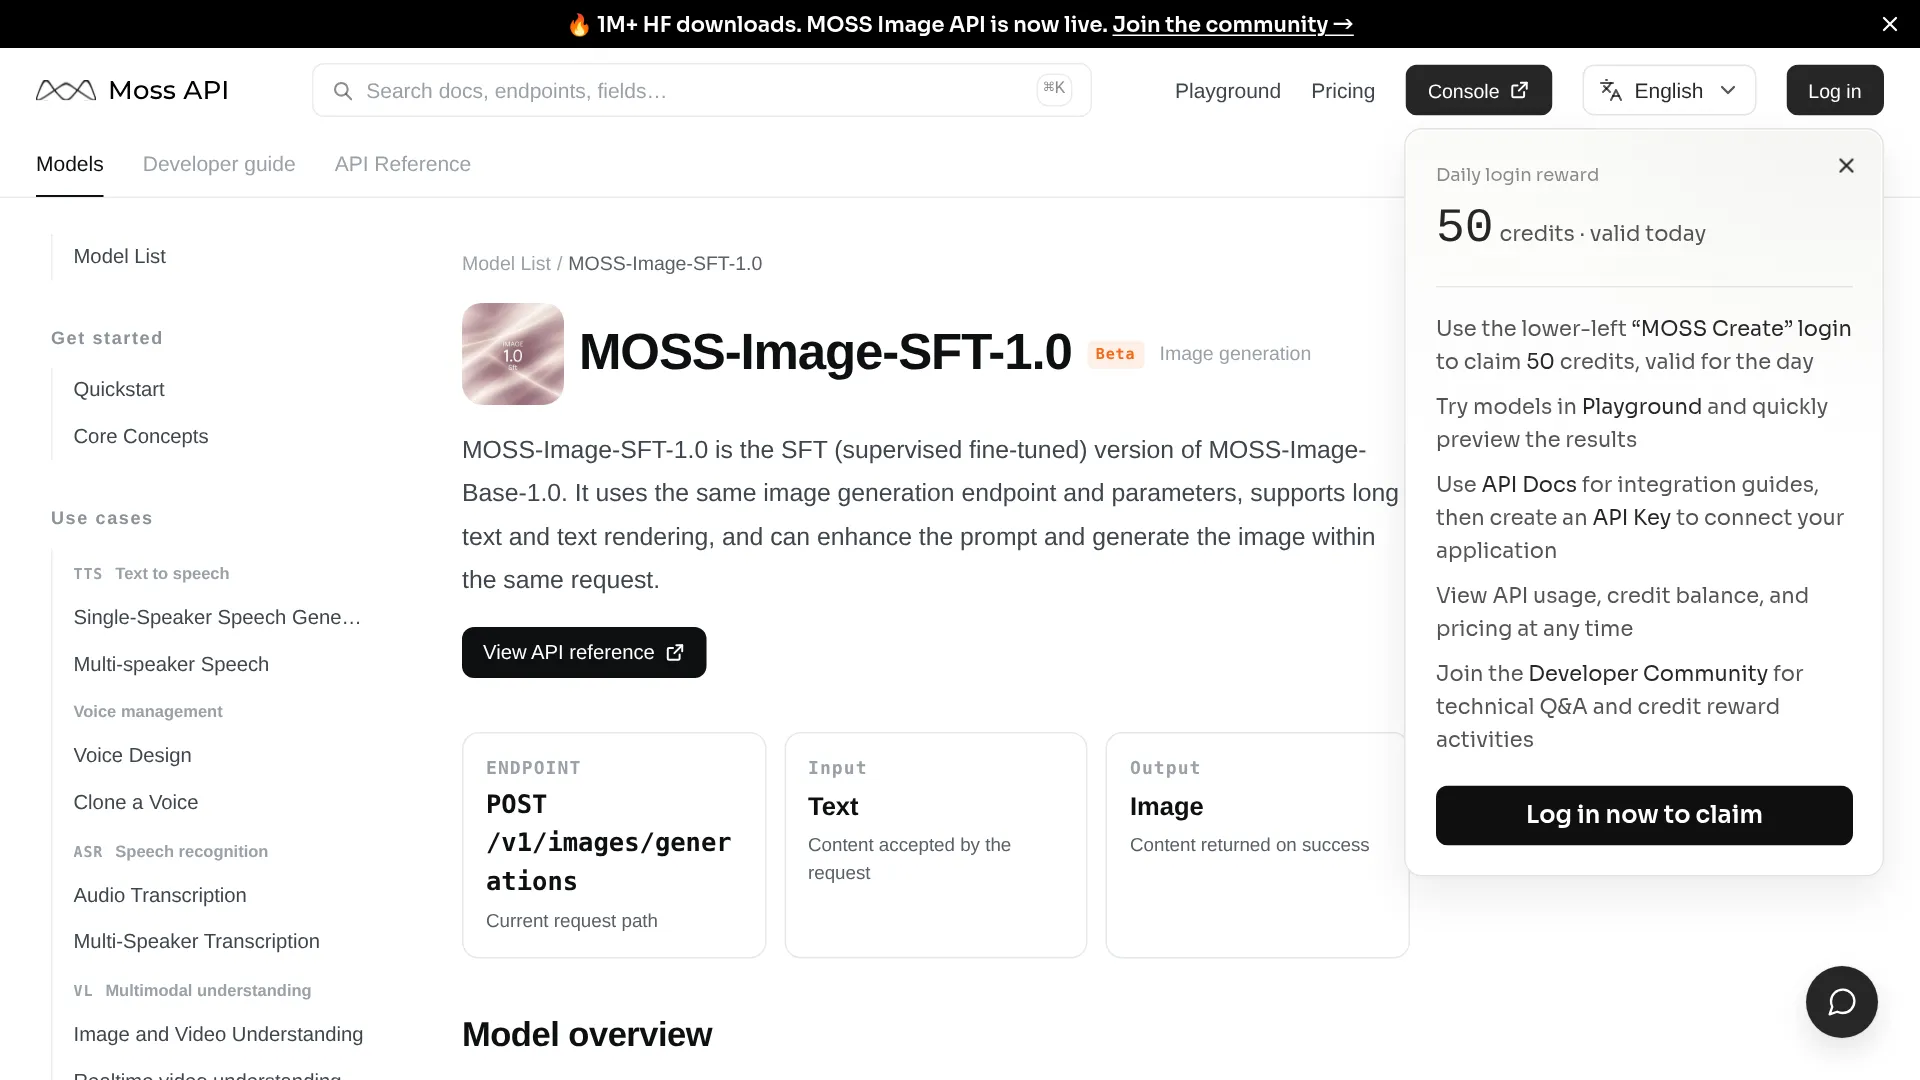
O caminho hospedado usa um único endpoint. A documentação da API MOSI lista POST /v1/images/generations para moss-image-sft-1.0, recebendo texto e devolvendo apenas a imagem. Não há entrada de imagem, áudio ou vídeo, nem API de streaming ou de tarefas assíncronas. O aprimoramento de prompt vem integrado, mas desativado por padrão; ative-o com prompt_enhance: true. A versão do aprimorador é escolhida no lado do servidor.
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
Quando precisar de controle por caixa, envie a string completa do layout em JSON no campo prompt. A versão em linguagem natural acima é a chamada mais simples para copiar e colar.
No momento da consulta, a cobrança aparecia como Free for a limited time, com 0 credits, acompanhada de um link para os preços completos posteriores. O guia sobre Base e SFT observa a mesma lacuna: o playground está ativo desde 20 de outubro, mas ainda não havia um preço duradouro por imagem publicado. Faça o orçamento levando isso em conta: janela gratuita para prototipagem e, depois, a tarifa do provedor somada ao custo das tentativas rejeitadas por erros de ortografia.
A inferência local elimina a cobrança por imagem, mas traz uma conta de hardware considerável. A listagem de arquivos da Comfy-Org consultada em 20 de outubro totaliza cerca de 29,72 GB de pesos BF16 antes do ambiente e do cache: aproximadamente 10,16 GB para o backbone, 19,31 GB para o encoder de texto e 0,25 GB para a VAE pequena. O INT8 ConvRot reduz aproximadamente pela metade o espaço do transformer — backbone com cerca de 5,41 GB e encoder com 9,75 GB —, enquanto uma opção de encoder GPTQ W4A8 fica perto de 7,34 GB.
| Configuração | O que baixar | Observação prática |
|---|---|---|
| BF16 completo | 29,72 GB de pesos + memória de trabalho | Fica apertado até em 32 GB sem offload; a RAM do sistema e o tamanho do prompt fazem diferença |
| INT8 quantizado | Classe de ~15 GB + offload | Caminho documentado com 12 GB em ~1 MP, uma imagem por lote (~9,7 GB de pico no teste comunitário citado aqui); é por onde começar em placas de 8 a 12 GB |
| DMD comunitário de 8 steps / 4 steps | Adaptador + fluxo compatível | ~24 segundos contra ~137 segundos no mesmo relatório com RTX 3060 e 1 MP, mas os primeiros adaptadores perderam nuances — estabeleça primeiro a referência de 50 steps |
A configuração oficial de amostragem usa Euler, 50 steps, CFG 3.0, shift 5.0 e skip-layer guidance na camada 22, em 1024x1024. O suporte nativo à ComfyUI foi integrado em 16 de outubro (anúncio aqui). Atualize a ComfyUI, procure os templates por MOSS-Image e use o fluxo correspondente à Base ou à SFT com os arquivos da Comfy-Org, em vez de misturar um grafo de plugin com um carregador nativo.
Se você estiver comparando custos de provedores de forma mais ampla, nosso guia sobre a API de geração de imagens mais barata é uma boa referência para calcular tempo de GPU e rejeições.
Onde os modelos fechados ainda levam vantagem
As limitações são claras e precisam ser respeitadas antes de colocar uma arte importante nesse fluxo. O lançamento é exclusivamente de texto para imagem. Não há edição de imagem nem entrada de imagem de referência; a geração baseada em referência aparece como trabalho futuro. Se preservar uma foto enviada ou manter um personagem idêntico em várias cenas for essencial, use um modelo nativo de edição, como o Qwen Image 2.1 para edição em produção.
Pessoas e refinamento estético formam a segunda grande lacuna. Com 5B, os rostos podem parecer genéricos, as proporções variam e as mãos repetem os problemas de sempre.
"Ela também não lida bem com proporções de personagens. E tampouco é boa nos típicos problemas de 'mãos ruins' e semelhantes." — @SlipperyGem
Os testes práticos citados reforçam a necessidade de conferir tudo antes de publicar: prompts curtos, personagens nomeados, tags de artistas e restrições exatas continuam inconsistentes; textos pequenos exigem uma revisão manual, e idiomas fora do benchmark de inglês e chinês precisam de verificações adicionais. A configuração oficial de 50 steps pesa em hardware modesto, enquanto os adaptadores rápidos trocam nuances de iluminação e seguimento de restrições por velocidade. Para cada resultado aprovado, registre checkpoint, encoder, VAE, precisão, prompt, seed e o tempo total, incluindo a codificação.
A geração local focada em velocidade conta a mesma história pelo lado do hardware. A Lucebox mediu 2,7 segundos para 1024x1024 em 8 steps, CFG 1, usando uma Radeon AI PRO R9700 com seus próprios kernels — 1,8 vez mais rápido de ponta a ponta do que a ComfyUI em uma DGX Spark nas mesmas configurações. Mas a avaliação visual da própria empresa encontrou 4 de 8 imagens deformadas em CFG 1, contra 1 de 8 em CFG 2.5, que levou 5,2 segundos. Mais velocidade não significa automaticamente mais utilidade.
Perguntas frequentes sobre a MOSS Image API
A MOSS Image é gratuita para uso comercial?
Os pesos e o código incluído são distribuídos sob a Apache 2.0, que permite uso comercial e fine-tuning sem taxa de licenciamento. Os endpoints hospedados definem seus próprios preços e regras de conteúdo, enquanto quantizações e LoRAs de terceiros seguem seus próprios termos.
Base ou SFT — qual versão a API deve usar?
A API hospedada usa a SFT (moss-image-sft-1.0), checkpoint refinado que a equipe recomenda para geração. Baixe a SFT para pôsteres e gráficos informativos agora; escolha a Base para fine-tuning ou treinamento de uma LoRA.
Ela roda com 12 GB de VRAM?
Há uma configuração documentada de 12 GB que funciona com um fluxo quantizado, offload para a CPU, cerca de 1 MP e uma imagem por lote.
Ela edita uma foto ou mantém um personagem idêntico?
Não. O backbone lançado não aceita imagens de referência como condicionamento. Reutilizar uma seed com um JSON editado orienta a regeneração, mas não preserva uma fotografia enviada nem garante a identidade do personagem.
Quem deveria testar a MOSS Image agora
| Seu trabalho | Use a MOSS Image quando | Use outra coisa quando |
|---|---|---|
| Pôster, menu, slide ou mockup de interface com texto exato | Texto bilíngue longo e posicionamento por caixas importam mais do que pessoas fotorrealistas | Você precisa apenas de slogans curtos — um modelo fechado será mais rápido de orientar |
| Pipeline de e-commerce ou editorial | É possível adicionar uma etapa de LLM para gerar o JSON e uma revisão final, e você quer pesos Apache 2.0 para hospedar ou ajustar por conta própria | Você precisa de img2img, inpainting ou personagens presos a uma referência agora |
| Desenvolvedor local com orçamento limitado | 12 GB com quantização são suficientes, ou a janela gratuita da MOSI cobre o protótipo | Você precisa de throughput garantido, streaming ou tarefas assíncronas — a API hospedada ainda não oferece nenhum dos três |
Para trabalhos de design carregados de texto e com layout especificável, a MOSS Image é um dos raros modelos abertos em que o sistema de restrições é o próprio produto. Para tudo que exige que um rosto continue sendo exatamente o mesmo rosto, trate-a como um motor de tipografia ao lado de um modelo de imagem fechado, não como substituta.