 AIREITER
Para a maioria das tarefas cotidianas, o Gemini 3.5 Flash é a escolha mais eficiente: ele gera 2,6x mais tokens de saída por segundo que o Gemini 3.1 Pro, custa 25% menos por token e fica à frente no Intelligence Index da Artificial Analysis, com 50 pontos contra 46. Mas o Pro continua superior em raciocínio abstrato no ARC-AGI-2, por 77,1% a 72,1%, e o desempenho do Flash em recuperação com contexto longo cai de 84,9% para 77,3% depois de 128k tokens. Na prática, a escolha depende do trabalho: Flash prioriza throughput e baixa latência em chamadas de ferramentas; Pro privilegia raciocínio profundo em várias etapas. Um benchmark agregado transforma essas prioridades em uma nota só — e pode esconder justamente o critério mais importante para a sua carga de trabalho.
Benchmarks: em quais testes cada modelo realmente vence
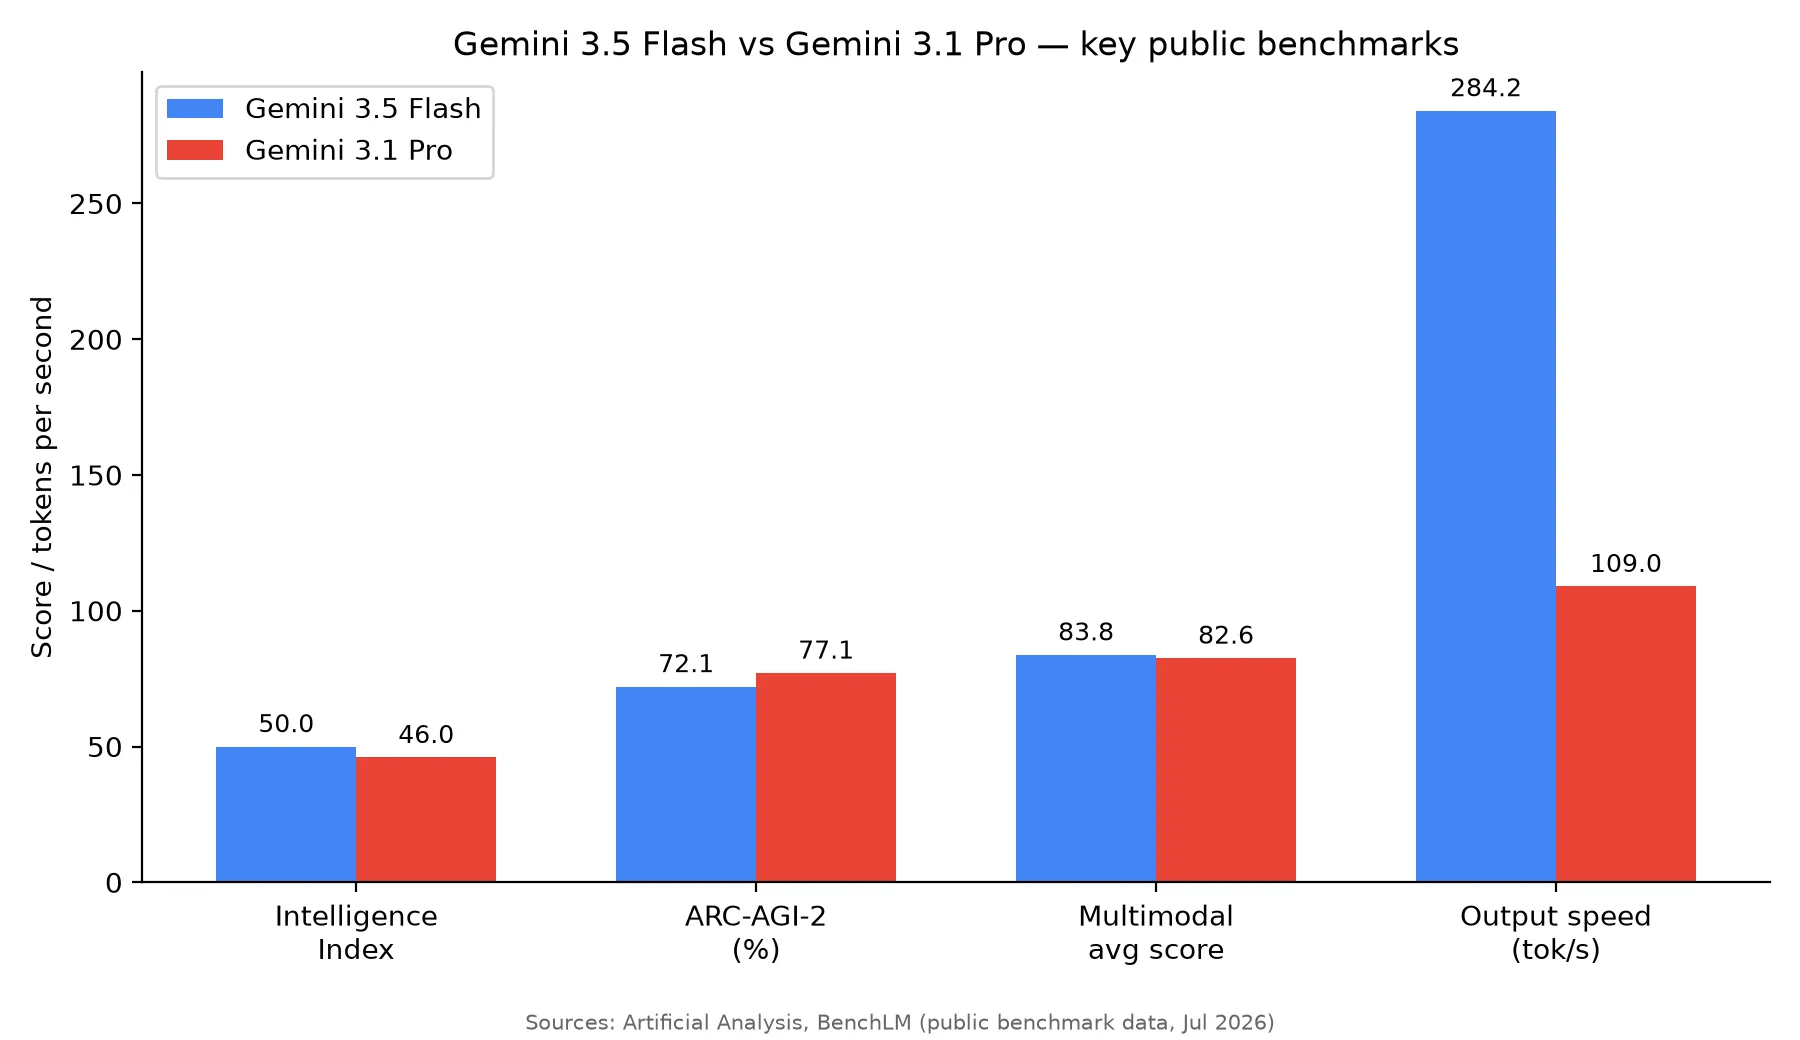
| Métrica | Gemini 3.5 Flash | Gemini 3.1 Pro | Vencedor |
|---|---|---|---|
| Intelligence Index (Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2, raciocínio abstrato (BenchLM) | 72,1% | 77,1% | Pro |
| MRCR v2 com contexto de 128k (nxcode) | 77,3% (queda ante 84,9% em contextos menores) | não divulgado publicamente para o mesmo tamanho | Dados insuficientes |
| Pontuação média multimodal (BenchLM) | 83,8 | 82,6 | Flash |
| Velocidade de saída (BenchLM) | 284,2 tok/s | 109 tok/s | Flash (2,6x) |
| GDPval-AA Elo, tarefas de agentes do mundo real (apiyi) | 1656 | 1314 | Flash |
O Flash vence nas métricas voltadas a throughput e execução de tarefas gerais. O Pro tem uma vantagem clara e documentada em profundidade de raciocínio no ARC-AGI-2. Já em recuperação com contexto longo, há uma regressão documentada no Flash acima de 128k tokens, mas não existe um resultado público equivalente para o Pro. Portanto, esse ponto é inconclusivo — não uma vitória comprovada do Pro. Essa divisão se conecta diretamente ao tipo de tarefa em execução e é mais útil do que olhar apenas para o número agregado do Intelligence Index.
Há uma ressalva metodológica importante na própria comparação da BenchLM: entre cerca de 34 benchmarks com resultados publicados para os dois modelos, apenas 3 categorias permitem comparação direta. O Pro tem resultados exclusivos em 14 benchmarks, enquanto o Flash os tem em 17, e as configurações de orçamento de pensamento nem sempre são iguais. Considere a tabela acima confiável como indicação de direção. As diferenças em ARC-AGI-2 e MRCR v2 são grandes o bastante para inspirar confiança, mas uma distância de 1 ou 2 pontos em uma métrica compartilhada não deve ser tratada como decisiva.
Os cenários em que a vantagem do Flash desaparece
A diferença de 5 pontos no ARC-AGI-2 é a maior variação em uma única categoria identificada pela comparação da BenchLM. Como o ARC-AGI-2 foi criado especificamente para resistir a atalhos de reconhecimento de padrões, uma margem de 5 pontos nele diz mais sobre profundidade de raciocínio do que uma diferença semelhante em um benchmark mais convencional. O resultado de MRCR v2 da nxcode acrescenta outro indício na mesma direção: a precisão de recuperação do próprio Flash cai de 84,9% para 77,3% à medida que o contexto se aproxima de 128k tokens. A pontuação do Pro nesse mesmo tamanho não foi divulgada publicamente. Isso não documenta uma derrota direta do Pro, mas registra uma regressão do Flash que a tabela de benchmarks do Pro não revela.
Observação anedótica, não evidência de benchmark: uma discussão no Reddit r/GeminiAI perguntou qual modelo os usuários preferem para tarefas difíceis, e alguns comentários descreveram o Flash como superior ao Pro “em tudo, exceto contexto longo e raciocínio abstrato”. São poucas opiniões, não dados. Ainda assim, elas apontam exatamente para as duas exceções vistas nos benchmarks, o que funciona como uma checagem de plausibilidade modesta — não como prova independente.
Preços e cache: onde está o custo de verdade
Na tabela base, a diferença de preço é menor do que parece à primeira vista:
- Gemini 3.5 Flash: US$ 1,50 / milhão de tokens de entrada, US$ 9 / milhão de tokens de saída
- Gemini 3.1 Pro: US$ 2 / milhão de tokens de entrada, US$ 12 / milhão de tokens de saída
No papel, o desconto é de 25%, não a diferença de 4-8x que o Flash já teve em relação a modelos Pro mais antigos. O fator com maior impacto é o cache:
- As gravações de cache do Flash são gratuitas; a entrada em cache custa US$ 0,15/milhão de tokens
- As gravações de cache do Pro custam US$ 0,38/milhão de tokens; a entrada em cache custa US$ 0,50/milhão de tokens — mais de 3x a tarifa de entrada em cache do Flash
Em fluxos que reenviam o mesmo prompt de sistema ou contexto de documentos ao longo de várias interações — agentes de chat, assistentes de programação com contexto persistente do código ou bots de suporte multiturno — essa diferença de cache se acumula rapidamente. Em uma única requisição, ela quase não aparece; em uma sessão de agente com mil turnos, aparece.
A distância também não é fixa. A análise de preços da apiyi observa que, depois de aproximadamente 200k tokens de contexto, a diferença de preço entre os modelos se reduz para 25-50%, porque a economia por token de ambos converge nessa escala. Se sua carga é dominada por documentos muito longos processados em uma única chamada, e não por chamadas curtas e repetidas, o argumento de preço a favor do Flash perde força.
Um exemplo concreto: imagine um bot de suporte que envia 1M de tokens de entrada em cache e gera 500K tokens de saída por dia. No Flash, o custo é US$ 0 pela gravação do cache, mais US$ 0,15 x 1 (entrada em cache) + US$ 9 x 0,5 (saída) = US$ 4,65/dia. No Pro, a mesma carga custa US$ 0,38 (gravação do cache, uma única vez) + US$ 0,50 x 1 (entrada em cache) + US$ 12 x 0,5 (saída) = aproximadamente US$ 6,88/dia no primeiro dia, caindo para US$ 6,50/dia após a primeira gravação. Em um mês, isso representa cerca de US$ 140 contra US$ 195 — antes de considerar o raciocínio mais profundo do Pro em requisições que realmente precisem dele.
Loops de agentes: Flash vence em velocidade, mas nem sempre em confiabilidade
O benchmark de loops de agentes da nxcode executou um loop de agente com 8 etapas. O Flash completou toda a sequência em aproximadamente 25 segundos, contra 100 segundos do Pro — uma diferença de 4x que se multiplica a cada passo adicional. No GDPval-AA, benchmark focado em tarefas de agentes de trabalho intelectual do mundo real, o Elo do Flash, de 1656, supera os 1314 do Pro por 342 pontos: a maior diferença de toda a tabela de benchmarks.
A ressalva é que essa vantagem de velocidade e pontuação pressupõe um loop funcionando sem desvios. As diferenças em ARC-AGI-2 e MRCR v2 observadas em tarefas de raciocínio e contexto longo são uma base razoável para esperar que o Flash também seja menos tolerante quando uma chamada de ferramenta retorna algo inesperado no meio do loop e o agente precisa replanejar. Essa é uma inferência baseada nos dados de profundidade de raciocínio acima, não uma conclusão medida em benchmark separado. Se o agente opera com supervisão humana, com alguém validando a saída entre etapas, a velocidade do Flash é quase uma vitória sem custo. Se ele trabalha sem supervisão por muitas etapas, sem uma pessoa no circuito, a margem de raciocínio do Pro é a aposta mais segura até que sejam publicados dados de taxa de falhas para ambos.
Qual usar? Matriz de decisão por tarefa
| Tipo de tarefa | Modelo recomendado | Motivo |
|---|---|---|
| Programação do dia a dia (testes, revisão de PR, tradução entre linguagens) | Flash | Vence em velocidade e custo; profundidade de raciocínio não é o gargalo |
| Refatorações profundas, criação de algoritmos inéditos | Pro | A diferença no ARC-AGI-2 aparece diretamente em raciocínio lógico de várias etapas |
| Recuperação em documentos longos (contratos, acervos de pesquisa acima de 128k tokens) | Pro | O Flash tem uma regressão documentada no MRCR v2 nesse tamanho; a pontuação do Pro não foi publicada, mas o padrão mais seguro é usar o modelo sem um ponto fraco conhecido |
| Geração em lote de alto volume | Flash | Gravações de cache gratuitas e throughput 2,6x maior têm mais peso em escala |
| Fluxos de agentes supervisionados, com pessoa conferindo a saída | Flash | Vantagem de velocidade sem o risco de confiabilidade em operação não supervisionada |
| Cadeias de agentes não supervisionadas e de alto risco | Pro | A margem em profundidade de raciocínio é a aposta mais segura sem uma pessoa para detectar erros no meio do loop |
| Chamadas multiturno frequentes que reutilizam o mesmo contexto | Flash | O preço da entrada em cache é aproximadamente um terço do cobrado pelo Pro |
Uma regra simples cobre a maior parte da matriz: envie as requisições ao Flash, a menos que uma de três condições seja verdadeira — o contexto ultrapassa 128k tokens e a precisão de recuperação importa; a tarefa exige raciocínio abstrato ou em várias etapas, como algoritmos inéditos, síntese jurídica ou de pesquisa; ou o agente opera sem supervisão por mais que algumas etapas. Qualquer uma delas inclina a decisão para o Pro. Sem nenhuma dessas condições, a velocidade e o preço de cache do Flash fazem dele a opção padrão mais barata.
Perguntas frequentes
Gemini 3.5 Flash é melhor que o 3.1 Pro?
Em velocidade, custo e benchmarks de uso geral, sim. Em raciocínio abstrato, no ARC-AGI-2, o Gemini 3.1 Pro ainda lidera por 5 pontos. Em recuperação com contexto longo acima de 128k tokens, o Flash apresenta uma regressão documentada e a pontuação equivalente do Pro não foi publicada. Portanto, essa comparação continua em aberto, não é uma vitória confirmada do Pro. O modelo “melhor” depende da categoria em que sua tarefa se encaixa.
Quanto o Gemini 3.5 Flash é mais barato que o 3.1 Pro?
Cerca de 25% mais barato na precificação base de entrada e saída: US$ 1,50/US$ 9 contra US$ 2/US$ 12 por milhão de tokens. A economia maior aparece no cache: as gravações de cache do Flash são gratuitas, e a entrada em cache custa aproximadamente um terço da tarifa do Pro. Isso pesa sobretudo em cargas multiturno ou de alto volume.
Gemini 3.5 Flash é bom para programação?
Sim, para o trabalho cotidiano: geração de testes, revisão de PR e tradução de código entre linguagens. Para refatorações profundas ou criação de algoritmos inéditos, a vantagem do Pro em benchmarks de raciocínio abstrato tende a aparecer na qualidade da saída.
Gemini 3.5 Flash lida bem com contexto longo?
Em contextos menores, sim: a precisão de recuperação no MRCR v2 se mantém em 84,9%. Depois de 128k tokens, ela cai para 77,3%, uma diferença relevante em tarefas como análise de contratos com vários documentos. A pontuação do Gemini 3.1 Pro no mesmo tamanho não foi publicada, então trate isso como uma limitação conhecida do Flash, não como uma vantagem confirmada do Pro.
Conclusão
O Gemini 3.5 Flash é a melhor escolha padrão para a maioria dos trabalhos cotidianos e de alto volume: é mais rápido, mais barato em cache e suficientemente próximo nos benchmarks gerais para que a troca raramente importe. O Gemini 3.1 Pro justifica seu custo maior em raciocínio abstrato e cadeias de agentes sem supervisão. Em documentos acima de 128k tokens, os próprios números do Flash revelam um ponto fraco que os dados do Pro não confirmam nem descartam; nesse caso, vale testar você mesmo antes de se comprometer com qualquer um dos dois.
Esta comparação foi elaborada a partir de dados públicos de benchmarks — Artificial Analysis, BenchLM, nxcode e apiyi —, não de testes diretos de API. O Gemini 3.1 Pro foi lançado com um posicionamento focado em raciocínio, distinto do foco do Flash em velocidade. Até o momento desta publicação, o Gemini 3.5 Pro ainda não foi lançado — reportagens apontam para um lançamento em julho de 2026. Portanto, encare esta análise como um retrato do momento: os dois modelos, e esta comparação, precisarão ser revistos quando a próxima versão do Pro chegar.