 AIREITER
A escolha padrão depende da carga de trabalho. O Claude Opus 5 é o ponto de partida mais seguro para a maioria das tarefas delimitadas e intensivas em geração, enquanto o Claude Fable 5.1 é o especialista que vale testar em agentes de longa duração e contextos excepcionalmente grandes e reutilizáveis. A principal economia prometida pelo Fable 5.1 vem das leituras de cache, não de preços menores para entrada ou saída.
Fable 5.1 vs Opus 5: a decisão começa pela sua carga de trabalho
Para a maioria das equipes, o melhor caminho é começar com o Opus 5, aumentar o nível de esforço quando a tarefa exigir mais raciocínio e encaminhar ao Fable 5.1 apenas os casos difíceis que já tenham sido validados. A documentação do Fable 5.1 da Anthropic segue a mesma orientação geral: comece com o Opus 5 na maioria das cargas e migre para o Fable 5.1 quando as avaliações do Opus em níveis mais altos de esforço não atenderem ao requisito.
| Se sua principal restrição é… | Comece com… | Por quê |
|---|---|---|
| Solicitações curtas ou delimitadas | Opus 5 | As tarifas de entrada e saída são metade das cobradas pelo Fable 5.1. |
| Tráfego de produção com muita geração | Opus 5 | A tarifa menor de leitura de cache do Fable não reduz o preço dos tokens gerados. |
| Programação em vários arquivos com especificação definida | Opus 5 | O custo menor facilita absorver novas tentativas e níveis de esforço mais altos. |
| Agentes de longa duração que usam ferramentas | Fable 5.1—após uma avaliação | O Fable lidera as comparações publicadas pela Anthropic em tarefas agentivas e uso de ferramentas. |
| Contexto grande reutilizado repetidamente entre turnos | Fable 5.1—após modelar os custos | O preço da leitura de cache é metade do cobrado pelo Opus 5. |
| Um roteador de produção sensível a fallback | Opus 5 primeiro | O Fable 5.1 altera o comportamento dos blocos de raciocínio e do histórico de conversas. |
A comparação é entre usar o Opus 5 no nível de esforço e custo adequados e usar o Fable 5.1 com o formato de contexto e o limite de confiabilidade corretos.
O que realmente muda entre o Fable 5.1 e o Opus 5?
O Claude Fable 5.1 é o modelo de categoria superior da Anthropic para raciocínio exigente e tarefas agentivas de longa duração. Já o Claude Opus 5 é apresentado como uma opção mais barata para programação séria, agentes e trabalho profissional. Os dois oferecem janela de contexto de 1 milhão de tokens e saída máxima de 128.000 tokens. Portanto, o diferencial do Fable está na execução prolongada, e não em um limite de contexto publicado maior.
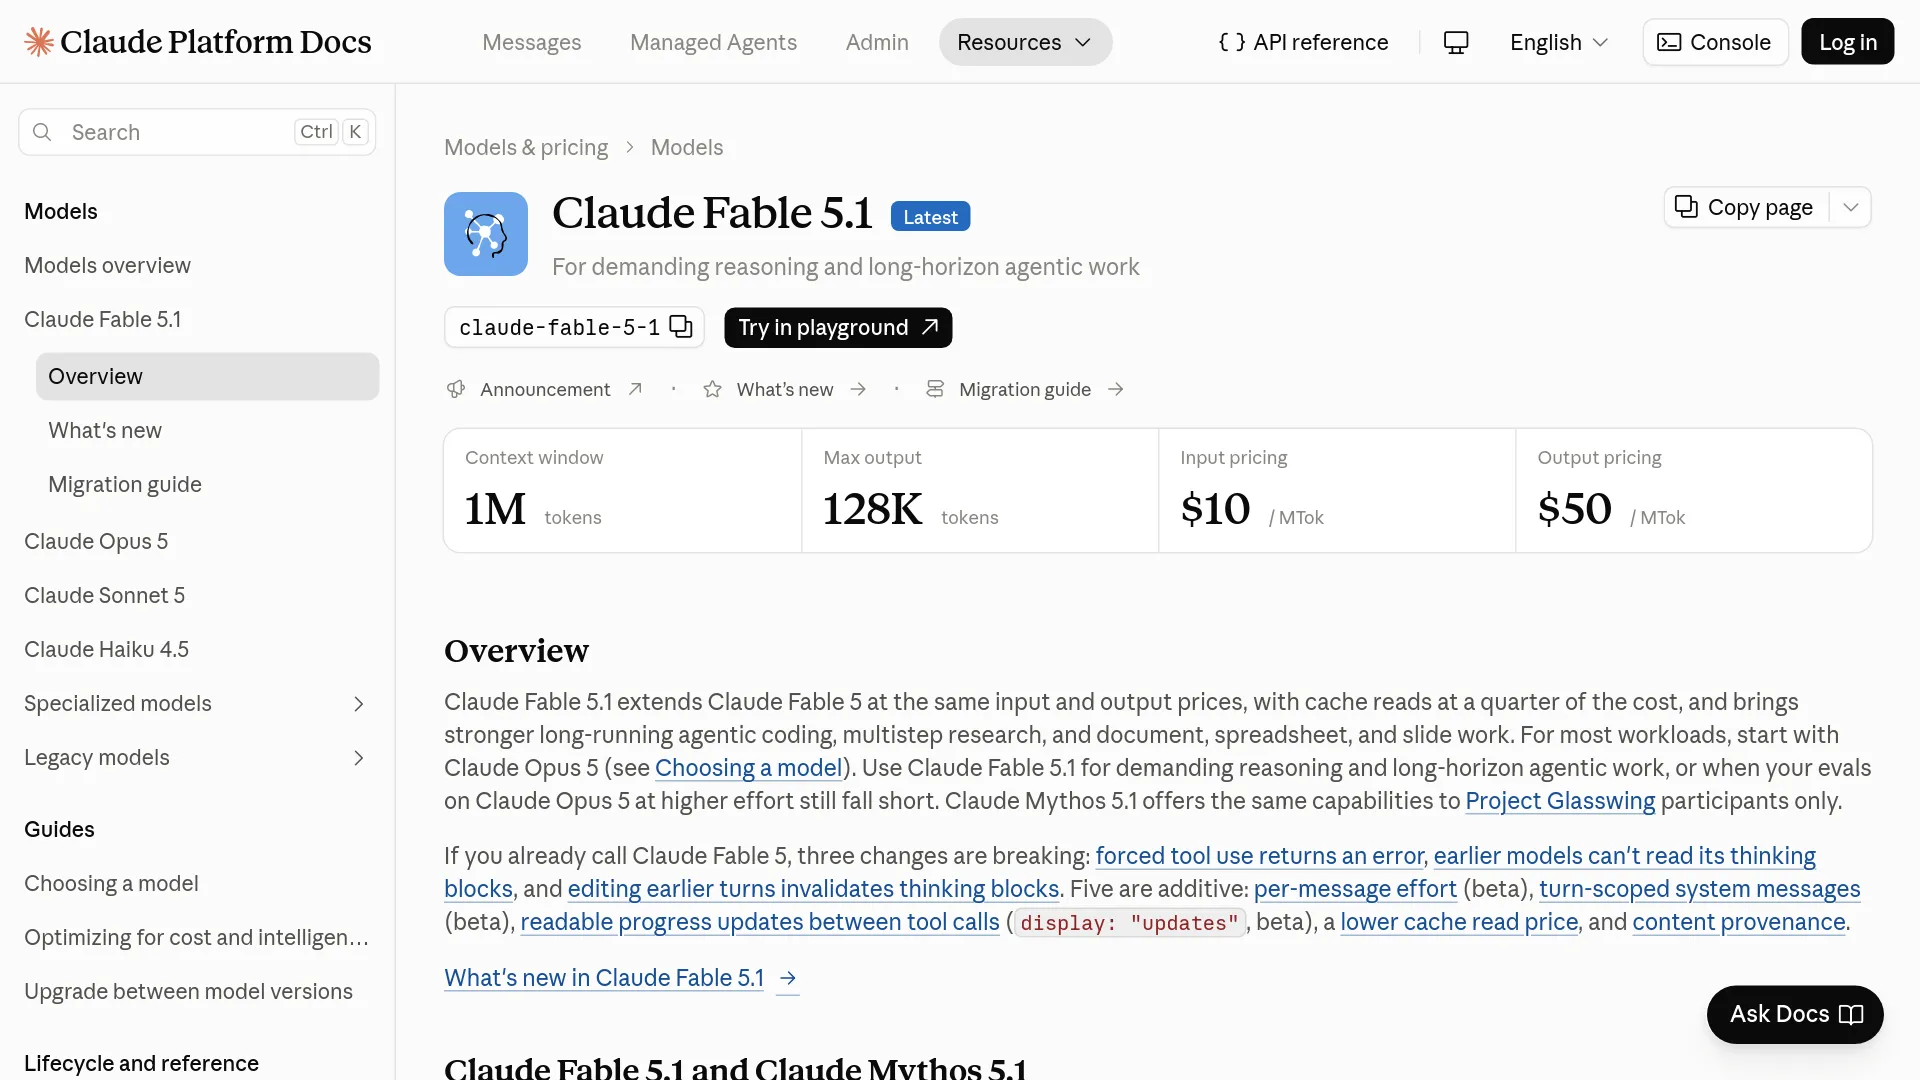
| Especificação | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| ID do modelo na API | claude-fable-5-1 | claude-opus-5 |
| Janela de contexto | 1 milhão de tokens | 1 milhão de tokens |
| Saída máxima | 128.000 tokens | 128.000 tokens |
| Modalidades de entrada | Texto e imagens | Texto e imagens |
| Modalidade de saída | Texto | Texto |
| Raciocínio | Adaptativo, sempre ativado | Raciocínio controlado por esforço |
| Controles de esforço | low, medium, high, xhigh, max | Níveis de esforço configuráveis |
| Posicionamento da Anthropic | Raciocínio exigente e agentes de longa duração | Maioria das cargas de trabalho e programação séria |
| Status de lançamento | Ativo/mais recente; lançado em 1º de setembro de 2026 | Modelo Opus ativo; lançado em 24 de julho de 2026 |
Para consultar IDs de modelo e disponibilidade específicos de cada implantação, use a página do modelo Fable 5.1 e a página do produto Claude Opus 5.
O resultado do benchmark favorece o Fable 5.1, mas não em todos os cenários
A tabela de benchmarks publicada pela Anthropic coloca o Fable 5.1 à frente do Opus 5 em todas as linhas listadas nas quais os dois modelos foram avaliados. Como a tabela foi produzida pelo próprio fornecedor, os resultados são evidências úteis sobre a avaliação de lançamento, mas não representam uma garantia de desempenho em produção.
| Avaliação da Anthropic | Fable 5.1 | Opus 5 | Vantagem do Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6% | 29,0% | 23,6 pontos |
| Terminal-Bench 4.0 | 55,8% | 52,3% | 3,5 pontos |
| GDPval-AA v2 | 1.853 Elo | 1.824 Elo | 29 Elo |
| OSWorld 2.0, estrito | 41,7% | 39,6% | 2,1 pontos |
| Humanity’s Last Exam, com ferramentas | 65,0% | 63,6% | 1,4 ponto |
| AutomationBench | 31,4% | 26,9% | 4,5 pontos |
| CursorBench 3.2.0 | 73,4% | 70,0% | 3,4 pontos |
A Anthropic afirma que as proteções usadas em produção estavam ativadas e que algumas intervenções poderiam gerar pontuação zero ou encaminhar o trabalho para modelos de fallback. A empresa também informa um erro padrão de aproximadamente 3,5–4,5 pontos percentuais por modelo no Terminal-Bench-Science 0.1. Por isso, uma diferença de 23,6 pontos é mais significativa do que uma diferença de 1,4 ponto no Humanity’s Last Exam.
Uma avaliação independente da CodeRabbit, realizada com 45 tarefas contendo 105 pontos de problemas conhecidos, encontrou recall de 61,0% e precisão de 37,3% para o Fable 5.1, contra recall de 55,2% e precisão de 39,3% para o Opus 5. Os dois modelos produziram 166 comentários processados, mas os autores alertam que as configurações dos testes eram diferentes.
“O Fable 5.1 é um revisor especialista.” — descrição da CodeRabbit para o resultado de sua avaliação (CodeRabbit)
O preço da API muda a conta na prática
O Fable 5.1 custa o dobro do Opus 5 em entrada e saída sem cache, mas suas leituras de cache custam metade. Isso cria um ponto de virada para sessões longas e repetitivas de agentes; não significa que toda solicitação ao Fable 5.1 ficará mais barata.
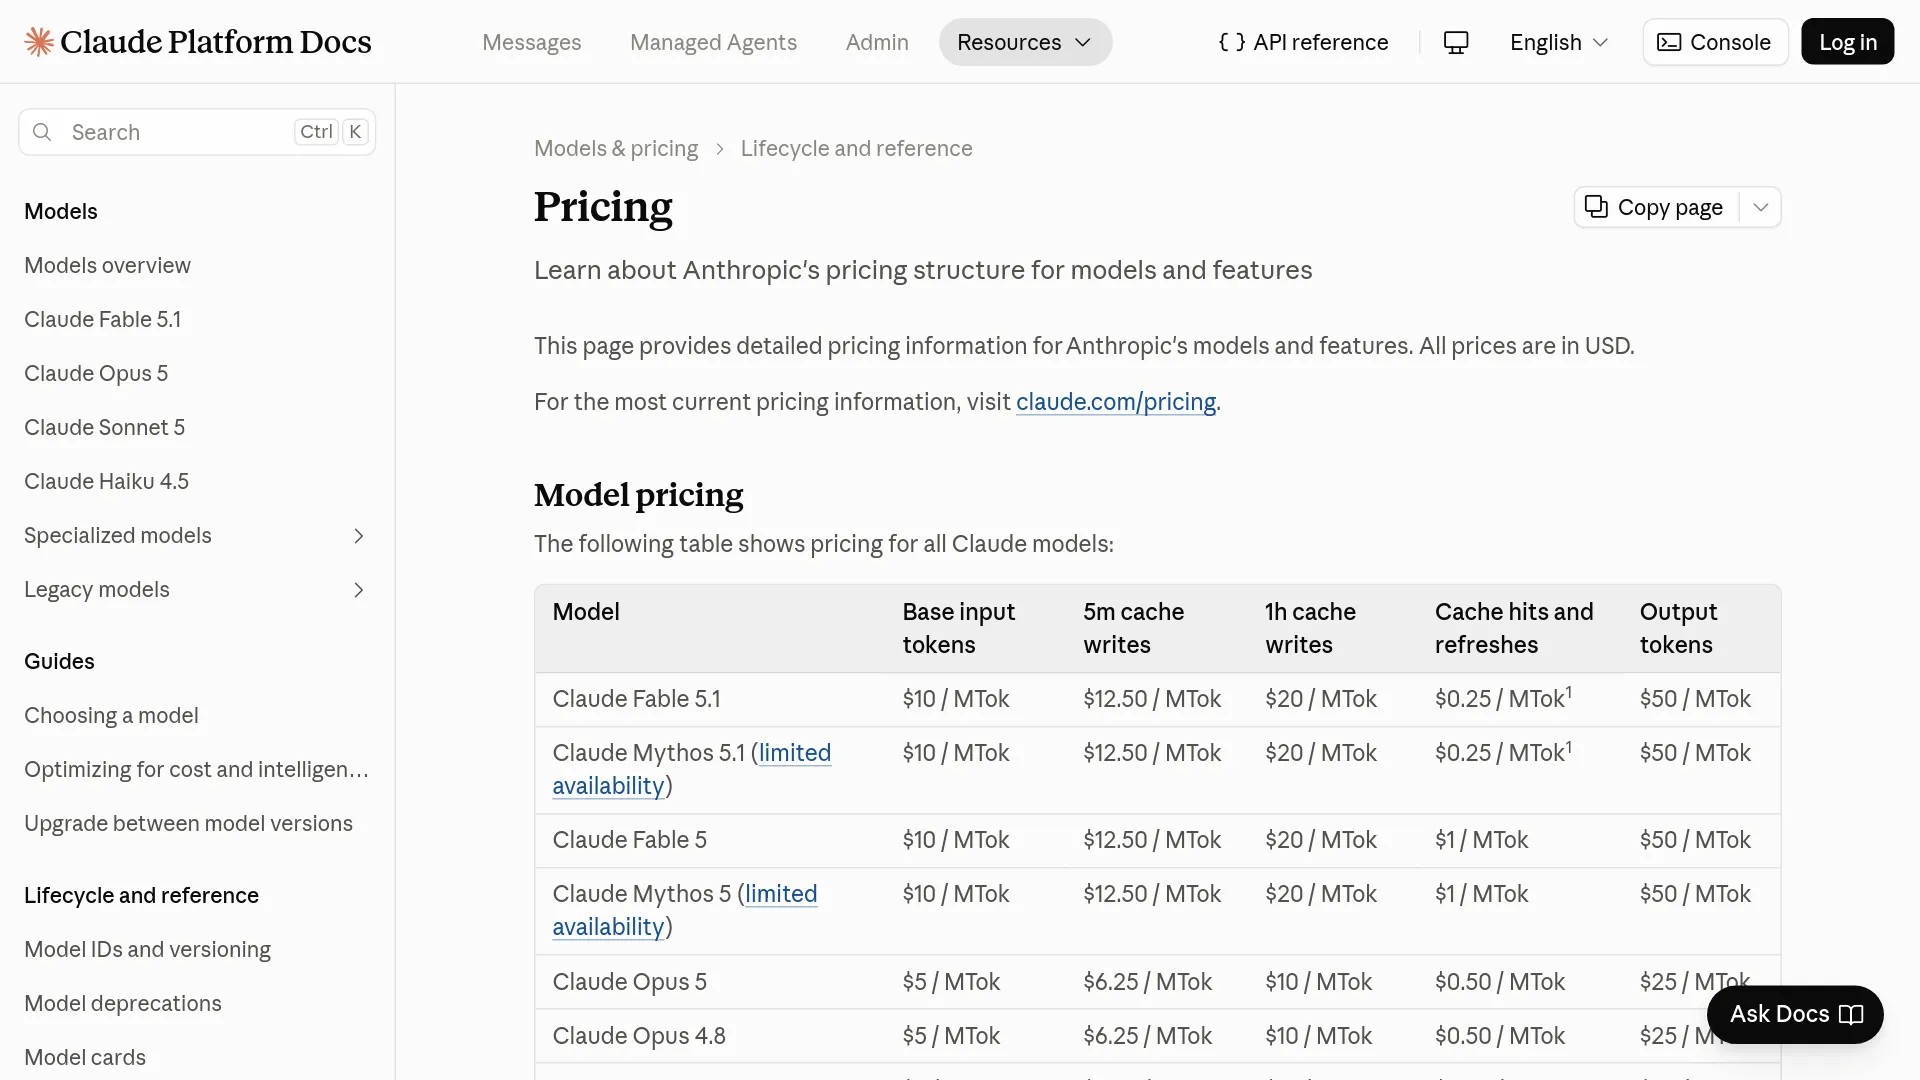
As tarifas a seguir vêm da documentação atual de preços da API da Anthropic, em USD por milhão de tokens.
| Item de cobrança | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Entrada básica | $10.00 | $5.00 |
| Gravação de cache de 5 minutos | $12.50 | $6.25 |
| Gravação de cache de 1 hora | $20.00 | $10.00 |
| Leitura de cache | $0.25 | $0.50 |
| Saída | $50.00 | $25.00 |
| Entrada / saída em lote | $5.00 / $25.00 | $2.50 / $12.50 |
Os preços de entrada e saída do Fable 5.1 não mudaram em relação ao Fable 5. A alteração responsável pela economia anunciada está na tarifa de leitura de cache: $0.25 por milhão de tokens, contra $1.00 no Fable 5. A Anthropic estima um custo típico cerca de 25% menor e uma redução de até aproximadamente 45% em cargas altamente agentivas, mas essas são estimativas por carga de trabalho, não um desconto universal.
Uma conta por turno ajuda a visualizar melhor a troca. Considere C como o contexto armazenado em cache, I como a entrada nova e O como a saída, todos medidos em milhões de tokens. Ignorando as cobranças de gravação do cache, o Fable 5.1 custa 10I + 0.25C + 50O; o Opus 5 custa 5I + 0.50C + 25O.
A leitura de cache mais barata do Fable só compensa as tarifas maiores de entrada nova e saída quando:
0.25C > 5I + 25O
Em um prompt novo de 2.000 tokens e uma resposta de 1.000 tokens, I = 0.002 e O = 0.001. O contexto armazenado em cache precisa superar aproximadamente 140.000 tokens para que a conta, considerando apenas as leituras, favoreça o Fable. Quando os custos de gravação do cache entram na equação, o ponto de virada fica ainda mais distante.
É por isso que chamadas curtas de extração, classificação, reescrita e programação pontual não devem ser migradas para o Fable 5.1 por motivos de preço. Há pouco ou nenhum prefixo reutilizável para receber desconto, e cada token gerado é cobrado pelo dobro da tarifa do Opus 5.
Onde cada modelo se encaixa nos fluxos de trabalho reais
A divisão prática está entre execução delimitada e persistência de longa duração. O Opus 5 é mais fácil de justificar quando a tarefa está claramente especificada ou exige muita geração. O Fable 5.1 ganha interesse quando o agente precisa manter um plano, usar ferramentas repetidamente, se recuperar de falhas e carregar um contexto grande por muitos turnos.
Agentes de programação: escolha pelo trabalho concluído, não pela posição no benchmark
O Opus 5 é o primeiro modelo a testar em tarefas comuns de repositório: correções de bugs com escopo definido, refatorações delimitadas, revisão de código e situações em que o custo menor permite repetir tentativas ou aumentar o esforço. O Fable 5.1 merece um piloto em alterações que envolvem vários arquivos, migrações, depuração em nível de sistema e sessões assíncronas de programação nas quais uma falha no fim do processo custa mais do que uma resposta lenta.
Os relatos da comunidade apontam para dois riscos operacionais diferentes. Em uma grande discussão no r/ClaudeCode, o usuário u/CyCoCyCo escreveu:
“A única forma como consegui obter bons resultados foi pedir que ele criasse prompts de objetivo e executasse tudo de ponta a ponta.” — u/CyCoCyCo no Reddit
Isso é evidência de uma reclamação sobre prompting e fluxo de trabalho, não uma prova de que o Opus 5 falha em todos os codebases. Outros usuários na mesma discussão relataram problemas em tarefas mais longas e dependentes de contexto, incluindo perda de aderência às instruções e correções que introduziram novos defeitos.
O Fable 5.1 apresenta um perfil de reclamações diferente. Em uma discussão sobre o lançamento, usuários relataram consumo incomumente rápido de tokens ou cota. O relato é anedótico e não comprova a existência de um limite universal de assinatura, mas justifica acompanhar o uso durante um piloto, em vez de avaliar o modelo apenas pela qualidade das respostas.
Um piloto sensato de agente de programação deve registrar:
- Tarefas concluídas sem intervenção humana.
- Bugs reabertos ou regressões depois que o modelo informa que terminou.
- Total de tokens de entrada, entrada em cache e saída.
- Tempo de execução e número de chamadas de ferramentas.
- Tempo gasto em correções humanas e custo das execuções que falharam em etapas avançadas.
Pesquisa e trabalho com muitos documentos: o caso do Fable é mais claro
O Fable 5.1 é o candidato mais forte quando o trabalho envolve um conjunto muito grande de documentos, chamadas repetidas de ferramentas, gráficos visuais, pesquisa em várias etapas ou um material que precisa passar por várias rodadas de revisão. A Anthropic posiciona o modelo especificamente para documentos, planilhas, apresentações, diagramas, tabelas e pesquisas de longa duração.
O Opus 5 tem a mesma capacidade de contexto de 1 milhão de tokens e também é descrito pela Anthropic como capaz de lidar com documentos complexos e agentes sofisticados. Se o trabalho for uma única análise com uma quantidade substancial de texto gerado, a tarifa menor do Opus pode pesar mais do que a vantagem de cache do Fable. Faça um teste com uma amostra representativa antes de transformar a liderança do Fable no benchmark em requisito de produção.
Uso do computador e automação empresarial: teste a trajetória completa
O Fable 5.1 supera o Opus 5 nas linhas de OSWorld e AutomationBench da Anthropic, mas essas tarefas medem uma sequência de ações, e não uma resposta isolada. Em um agente para navegador ou processos empresariais, avalie se o modelo chega ao estado final correto, com que frequência precisa se recuperar e se uma ação malsucedida compromete o restante da execução.
A unidade relevante é o custo por resultado concluído, e não apenas o custo por milhão de tokens. Um modelo que evita novas tentativas em um fluxo longo pode ser econômico mesmo com uma tarifa maior; já um modelo que consome o orçamento de uso antes de chegar ao estado final não é.
Detalhes de integração para conferir antes de trocar de modelo
A documentação de migração do Fable 5.1 descreve mudanças no uso forçado de ferramentas, nos blocos de raciocínio e na validação do histórico de conversas. Equipes que dependem de um roteador próprio de mensagens devem testar esses pontos antes de alterar o modelo padrão.
| Mudança | O que pode acontecer | Ação de migração |
|---|---|---|
| Uso forçado de ferramentas | tool_choice: {"type":"any"} ou uma escolha de ferramenta nomeada pode retornar HTTP 400. | Use auto com instruções claras para as ferramentas ou, quando apropriado, use saídas estruturadas. |
| Portabilidade dos blocos de raciocínio | Modelos anteriores não conseguem ler os blocos de raciocínio do Fable 5.1; turnos de fallback podem descartá-los. | Audite a troca de modelos e os caminhos de fallback. |
| Edição de conversas | Editar uma mensagem anterior, o prompt de sistema ou a lista de ferramentas pode invalidar blocos de raciocínio posteriores. | Trate o histórico como somente leitura ou use controles compatíveis por turno. |
| Configuração do raciocínio | O Fable 5.1 usa raciocínio adaptativo e não permite desativá-lo da mesma forma que o Opus 5. | Controle os gastos com as configurações de esforço e teste novamente o uso de tokens. |
Esse detalhe de fallback é importante em roteadores que misturam modelos. Uma solicitação ao Fable 5.1 pode continuar usando seu contexto de raciocínio, mas um fallback para o Opus 5 não consegue consumir os blocos de raciocínio do Fable 5.1. Se o roteador os descartar silenciosamente, o fallback poderá refazer o planejamento, aumentando a latência e o consumo de tokens. Teste tanto o caminho de sucesso quanto o de falha com históricos semelhantes aos de produção.
Uma avaliação pequena vale mais do que uma grande promessa de modelo
Use os mesmos prompts, ferramentas, contexto, política de esforço e testes de aceitação nos dois modelos. Caso contrário, a comparação pode acabar medindo o harness, e não o modelo.
- Faixa delimitada: execute correções de bugs com escopo definido, extração, textos estruturados e revisão de código. Registre a utilidade da saída, o tempo de correção e o custo.
- Faixa de longa duração: execute uma funcionalidade em vários arquivos, uma migração, uma tarefa de pesquisa ou um fluxo no navegador. Registre o sucesso no estado final, as recuperações, as regressões e o tempo de execução.
- Faixa com muito cache: repita um prompt de sistema, um conjunto de ferramentas e um prefixo estável de repositório ou documento. Acompanhe a proporção de acertos de cache e a fatura total, incluindo gravações de cache e saída.
Comece o teste do Opus 5 no nível de esforço que você realmente usaria em produção. Depois, avalie níveis mais altos de esforço no Opus antes de transferir a tarefa para o Fable 5.1. No Fable, teste pelo menos medium e high; não presuma que o nome de um nível de esforço tenha exatamente o mesmo efeito nos dois modelos. A Anthropic afirma que essas configurações controlam o equilíbrio entre profundidade e custo, enquanto testes de terceiros descobriram que um raciocínio mais intenso não melhorou automaticamente os resultados agregados de revisão de código.
Fable 5.1 vs Opus 5: perguntas frequentes
Qual modelo é melhor para programação?
O Fable 5.1 lidera o Opus 5 nos resultados publicados pela Anthropic para Terminal-Bench e CursorBench, mas o Opus 5 é o melhor ponto de partida para a maioria das tarefas de programação com escopo definido e sensíveis a custo. Use uma avaliação com um repositório representativo para descobrir se a maior qualidade de conclusão do Fable compensa seu preço e sua latência.
O Fable 5.1 vale o dobro do preço da API?
Não como regra. Suas tarifas de entrada e saída são o dobro das do Opus 5, enquanto as leituras de cache custam metade. O Fable passa a ser financeiramente interessante quando a carga reutiliza repetidamente um contexto grande e gera uma quantidade relativamente pequena de saída.
O Fable 5.1 tem uma janela de contexto maior?
Não. A Anthropic lista uma janela de contexto de 1 milhão de tokens e uma saída máxima de 128.000 tokens para os dois modelos. A diferença do Fable está no posicionamento para raciocínio de longa duração e trajetórias agentivas, não em uma janela publicada maior.
Devo aumentar o esforço do Opus 5 antes de trocar de modelo?
Sim. As orientações da Anthropic recomendam avaliar o Opus 5 em níveis mais altos de esforço antes de migrar para o Fable 5.1. Compare o custo adicional em tokens com o ganho de qualidade, em vez de executar todas as solicitações no esforço máximo.
Posso usar o Opus 5 como fallback do Fable 5.1 com segurança?
É possível criar esse fallback, mas não presuma que o estado da conversa será portátil. Modelos anteriores não conseguem ler os blocos de raciocínio do Fable 5.1, e a validação do histórico do Fable 5.1 pode expor roteadores que editam turnos anteriores. Teste o fallback com esquemas reais de ferramentas e históricos de mensagens.
Onde os desenvolvedores podem acessar o Fable 5.1 e o Opus 5?
A Anthropic lista os dois modelos nos planos do Claude e no acesso para desenvolvedores por meio de sua plataforma e de integrações com marketplaces de nuvem. Os IDs exatos dos modelos e a disponibilidade podem variar conforme o provedor. Por isso, confirme o identificador específico da implantação na documentação do Fable 5.1 ou na página do produto Opus 5.
A escolha prática é uma regra de roteamento, não uma atualização permanente
| Decisão | Use o Opus 5 | Use o Fable 5.1 |
|---|---|---|
| Modelo padrão para tráfego misto | Sim | Apenas após uma avaliação |
| Chamadas curtas e pontuais | Sim | Não há justificativa de preço |
| Geração com muita saída | Sim | Geralmente não |
| Prefixos grandes em cache | Compare com cuidado | Possível vantagem de custo |
| Programação autônoma de longa duração | Faça um piloto primeiro | Forte candidato |
| Refatorações estritamente delimitadas | Geralmente | Se o Opus não passar nos testes de aceitação |
| Automação no navegador ou em várias etapas | Faça um piloto primeiro | Forte caso nos benchmarks |
| Roteador de fallback personalizado | Base mais simples | Exige testes de migração |
Mantenha o Opus 5 como referência, execute os dois modelos no mesmo conjunto de tarefas delimitadas e de longa duração e encaminhe para o Fable 5.1 apenas quando ele melhorar a quantidade de trabalho concluído por dólar.
Para detalhes específicos sobre os custos dos modelos, consulte preços da API do Claude Fable 5.1; para uma referência mais ampla sobre os modelos, veja Claude Opus 5.