 AIREITER
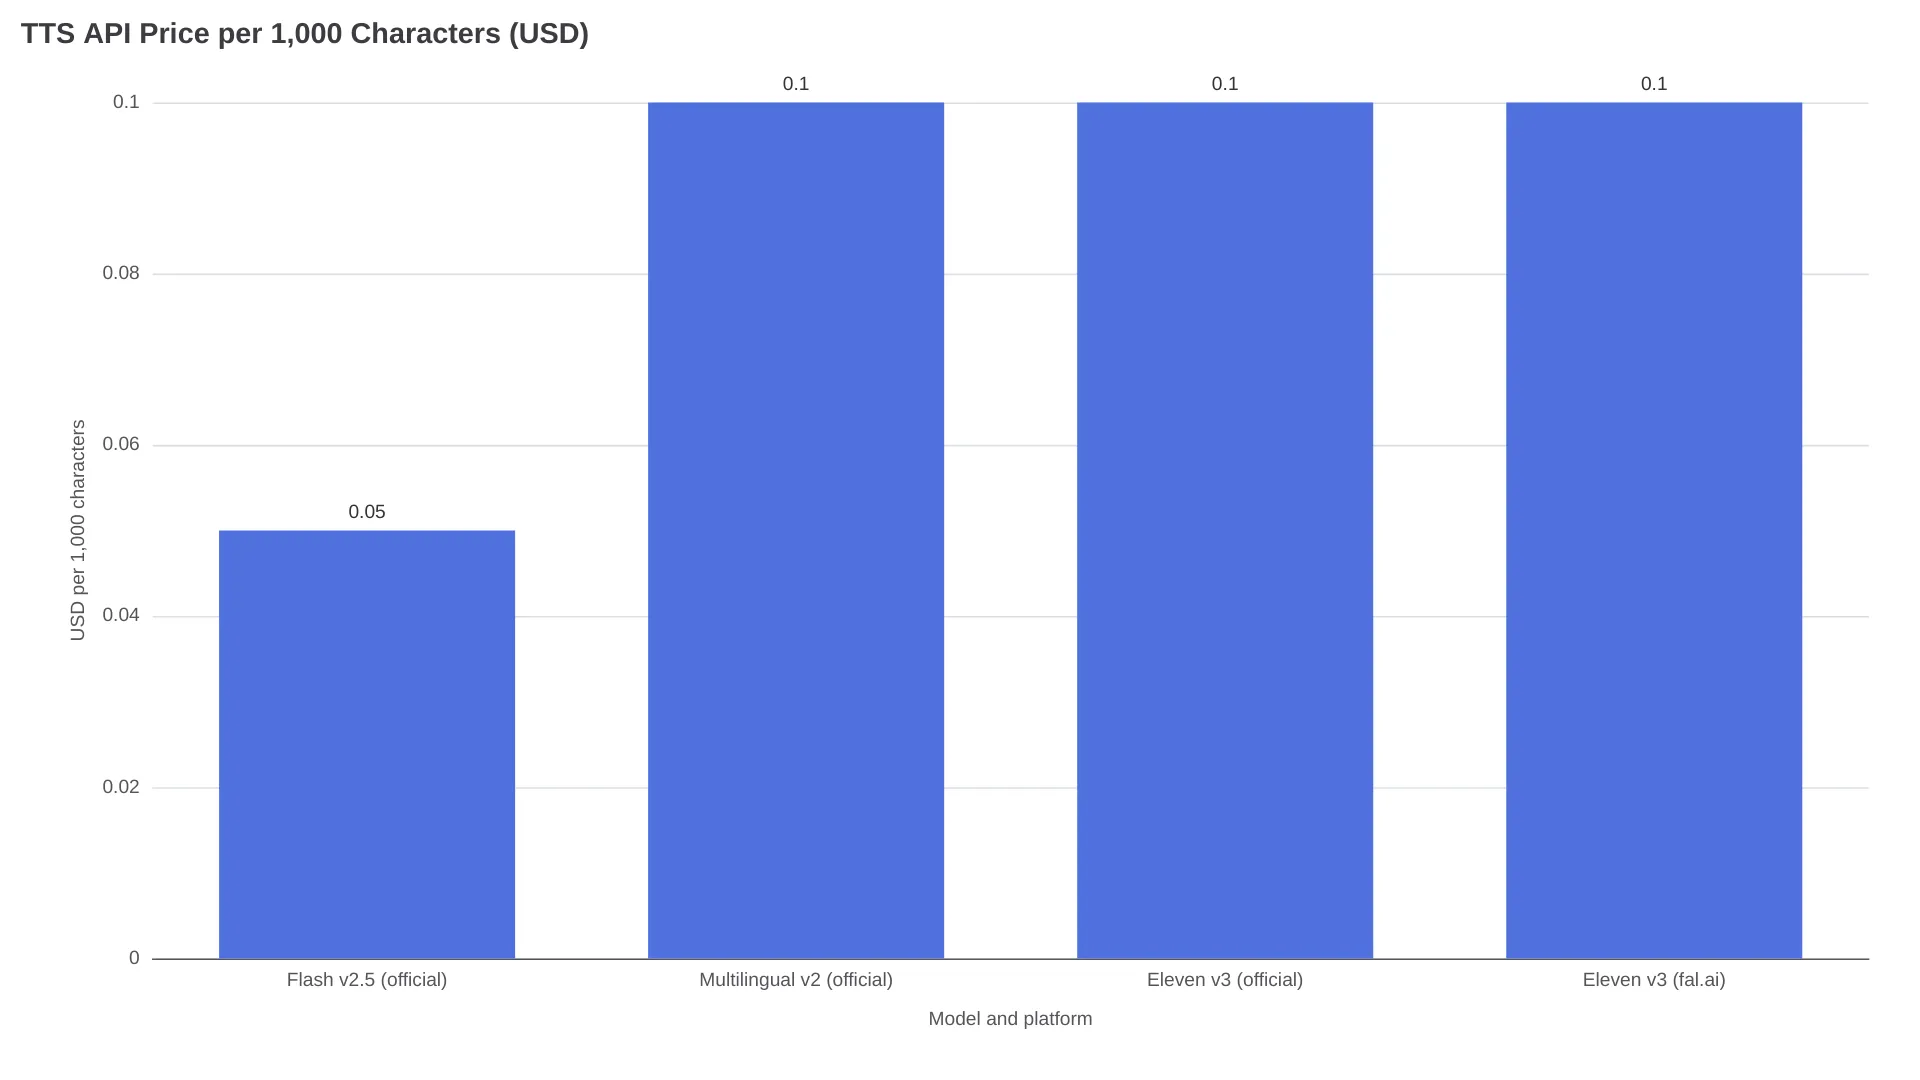
O Eleven v3 saiu do alpha em 2 de fevereiro de 2026, e o ID que seu código deve chamar na API da ElevenLabs é eleven_v3. Tanto a ElevenLabs quanto a fal.ai cobram US$ 0,10 por 1.000 caracteres, então o preço unitário não resolve essa escolha: o que pesa é o modelo de cobrança, a concorrência e o acesso a vozes. O GA também corrigiu problemas relevantes. Segundo o anúncio de GA, os erros em texto estruturado caíram de 15,3% para 4,9% em um benchmark de 27 categorias e 8 idiomas. Só planeje a integração levando em conta dois limites rígidos: 5.000 caracteres por requisição e um modelo que a própria criadora considera inadequado para uso em tempo real.
O que a API do ElevenLabs Eleven v3 oferece
A API do Eleven v3 tem quatro frentes: gerar fala, gerar fala em streaming e endpoints separados para criar e transmitir diálogos com múltiplos locutores. O modelo fala mais de 70 idiomas, aceita tags de áudio inseridas no texto para controlar emoção e interpretação e, no GA, alcançou uma estabilidade suficiente para que os próprios testes da ElevenLabs o preferissem à versão alpha em 72% das vezes.
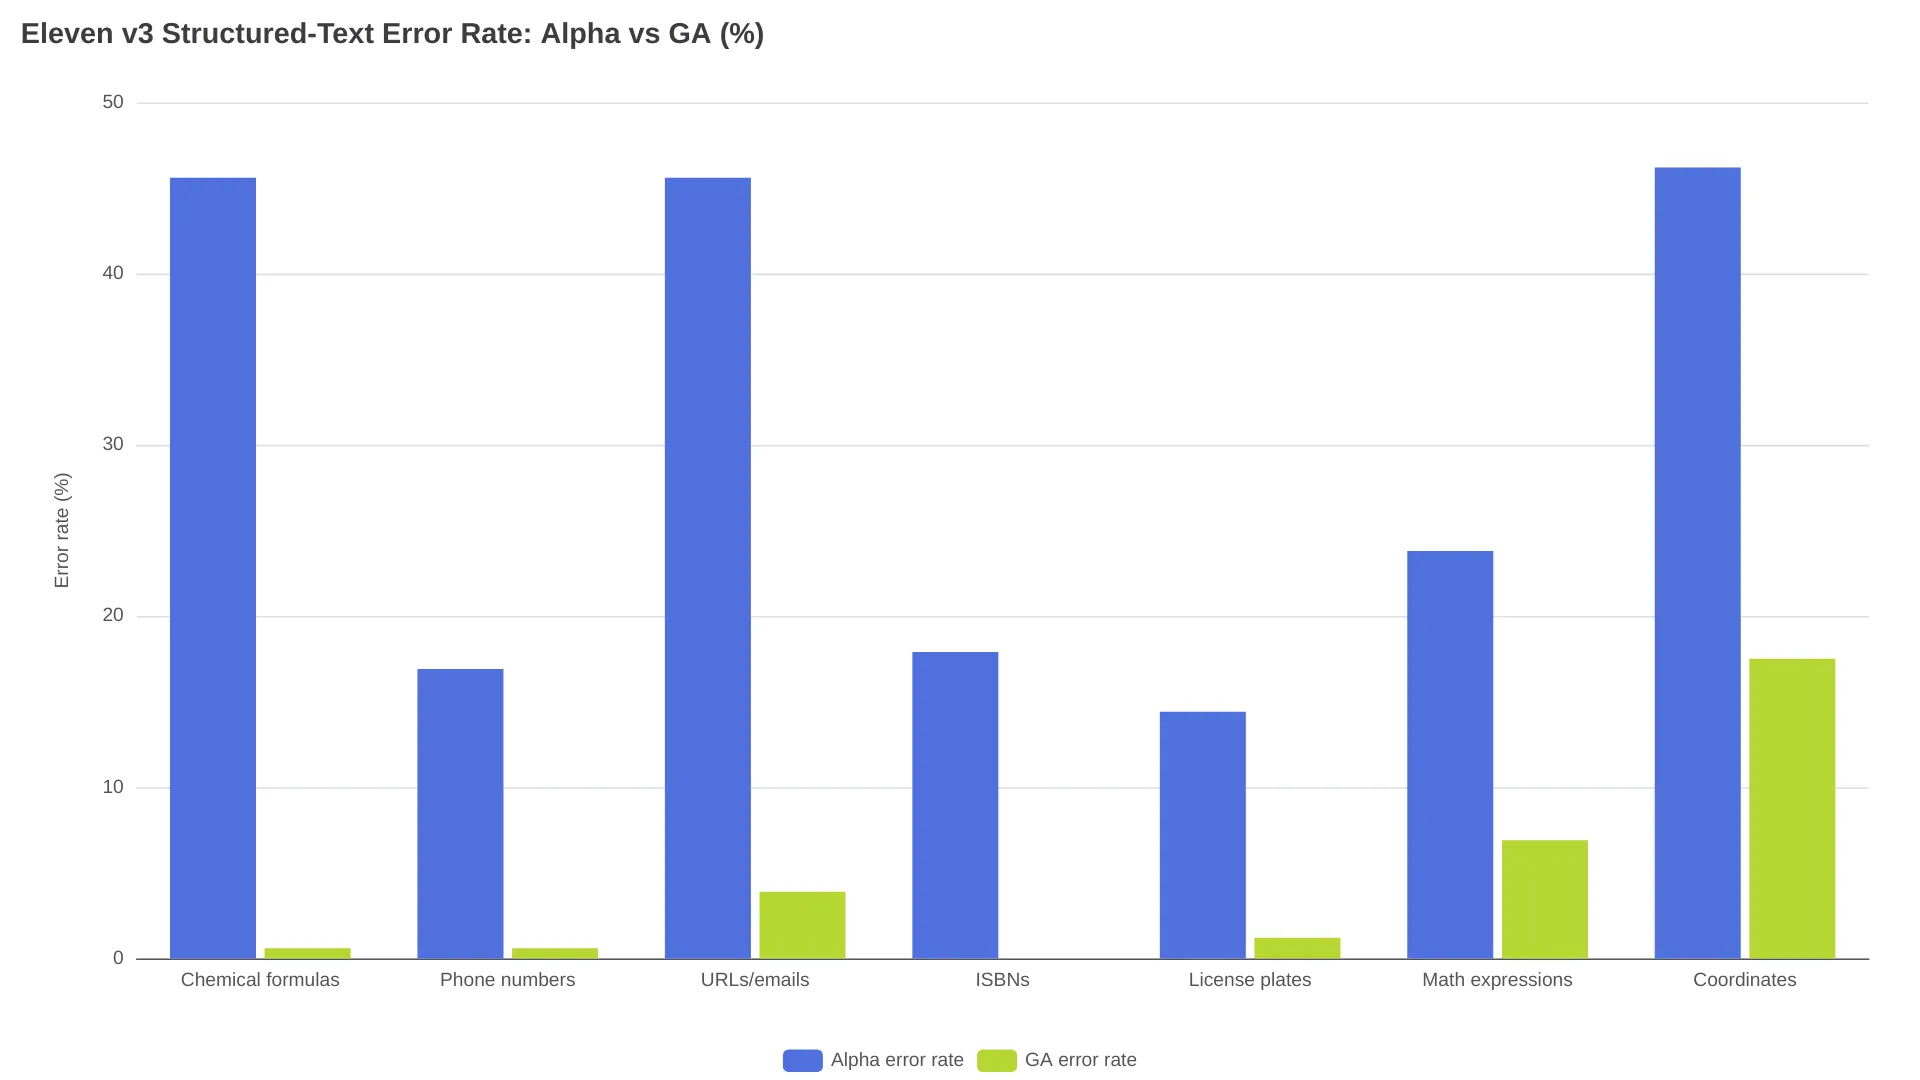
Antes de confiar textos estruturados ao v3, vale olhar os dados por categoria nesse benchmark: fórmulas químicas saíram de 45,6% de erro para 0,6%; números de telefone, de 16,9% para 0,6%; e ISBNs chegaram a zero. Coordenadas geográficas continuam sendo o ponto fraco, com 17,5%, enquanto expressões matemáticas ficam em 6,9% — aceitável para narração, mas arriscado em conteúdo carregado de coordenadas.
A tabela abaixo posiciona o v3 entre os modelos da família, segundo a referência oficial de modelos:
| Modelo | ID do modelo | Idiomas | Máx. de caracteres/requisição | Latência informada | Preço / 1.000 caracteres |
|---|---|---|---|---|---|
| Eleven v3 | eleven_v3 | 70+ | 5.000 (~5 min) | ~250–300 ms (tier) | US$ 0,10 |
| Eleven v3 Conversational | via Text-to-Dialogue WebSocket | 70+ | n/a | ~280 ms | US$ 0,10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10.000 (~10 min) | ~250–300 ms | US$ 0,10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40.000 (~40 min) | ~75 ms | US$ 0,05 |
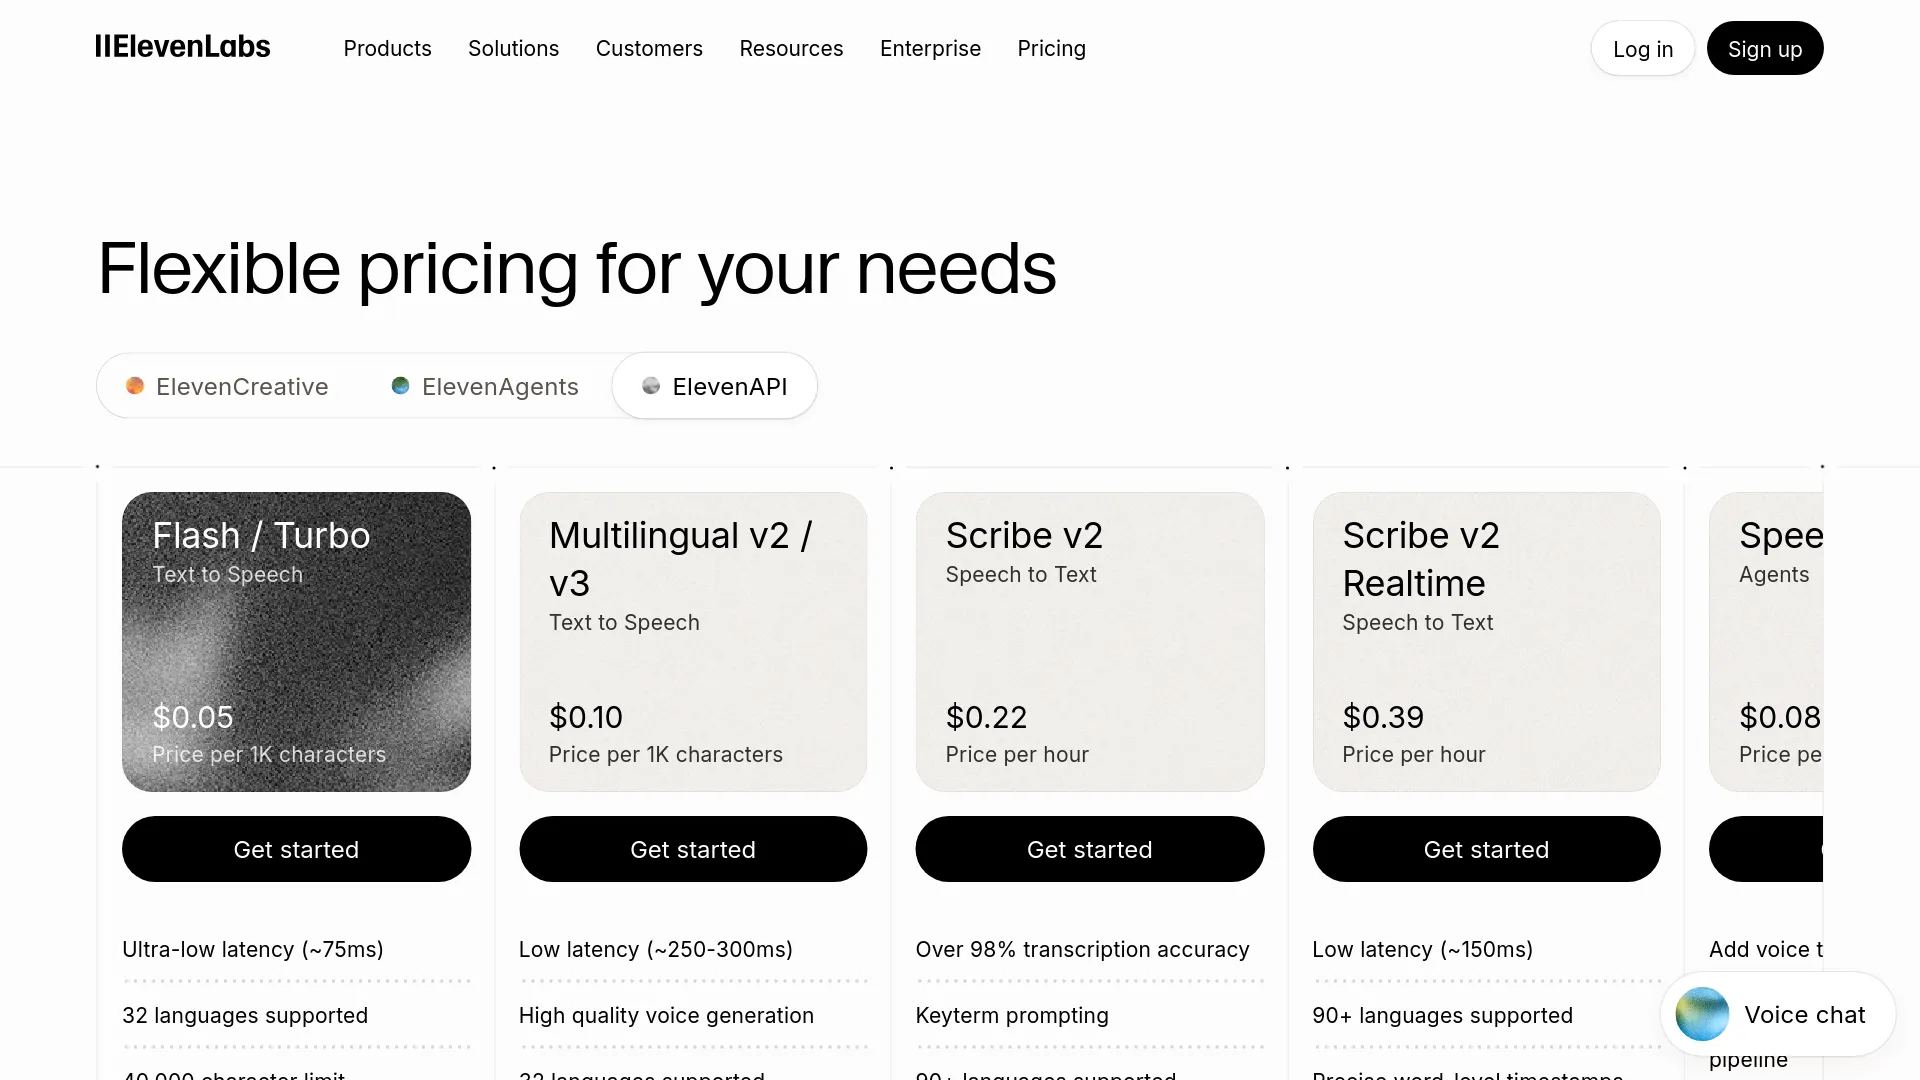
Há uma divergência importante na documentação: a página de preços agrupa "Multilingual v2/v3" em uma faixa com limite de 40.000 caracteres, mas a referência de modelos limita o Eleven v3 a 5.000 caracteres por requisição. Para o v3, considere 5.000 como o número real: ele é o limite específico do modelo, e pipelines longos que assumirem 40 mil vão falhar.
Preço: ElevenLabs oficial ou fal.ai?
O valor unitário é o mesmo nos dois serviços, US$ 0,10 por 1.000 caracteres. Dentro dessa família, apenas o Flash v2.5 custa menos, a US$ 0,05 por 1.000. A diferença prática está na cobrança e no paralelismo:
| ElevenLabs oficial | fal.ai | |
|---|---|---|
| Preço unitário (Eleven v3) | US$ 0,10 / 1.000 caracteres | US$ 0,10 / 1.000 caracteres |
| Cobrança | Planos de assinatura com créditos incluídos ou pagamento conforme o uso | 100% por uso; "sem licenças por assento, sem assinaturas, sem mínimos" |
| Plano gratuito | 10 mil caracteres Multilingual/mês (20 mil Flash) | Nenhum informado na página do modelo |
| Exemplo de plano | Creator US$ 22/mês (US$ 11 no primeiro mês), 220 mil caracteres Multilingual | n/a |
| Plano mais alto | Business US$ 990/mês, 9,9 milhões de caracteres Multilingual | n/a |
| Concorrência | Por plano: 2 requisições Multilingual simultâneas no Free, 15–30 no Scale/Business e limites personalizados no Enterprise | Fila serverless; a página do modelo não documenta limite por conta |
| Impacto da fila | Ao exceder o limite, as requisições entram na fila, adicionando "normalmente" ~50 ms | API de fila com webhooks para trabalhos em lote |
| Controles (schema documentado, além de relatos de usuários) | Voz por ID; estabilidade (usuários relatam 3 posições no v3) | Voz, stability, similarity_boost, speed, language_code, apply_text_normalization, seed, timestamps, output_format |
| Programa para startups | 12 meses grátis, 33 milhões de caracteres e maior concorrência | n/a |
No caminho oficial, a concorrência é precificada por faixa de plano: uma chave Free fazendo chamadas paralelas ao v3 fica limitada a 2 requisições simultâneas, o que restringe bastante o trabalho em lote. A fal direciona todos os jobs para uma fila serverless, com callbacks por webhook justamente para esse cenário. A documentação de preços de nenhuma das plataformas informa se espaços em branco ou tags de áudio entre colchetes entram na contagem faturável; no orçamento, trate-os como se entrassem.
Se você só precisa do v3 ocasionalmente e já usa outros modelos via fal, nosso review da fal.ai cobre o caso da plataforma.
Tags de áudio: como dirigir a interpretação no próprio texto
Tags de áudio são instruções entre colchetes, inseridas diretamente no texto. O modelo as interpreta como direção de atuação, e não como palavras a serem faladas. Veja um exemplo mínimo da página do modelo na fal:
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| Categoria | Exemplos que funcionam |
|---|---|
| Emoções | [happy], [sad], [excited], [angry], [sarcastically], [nervous], [happily] |
| Interpretação | [whispers], [shouting], [shouts], [slowly], [quickly], [softly] |
| Sons não verbais | [laughs], [chuckles], [sighs], [gasps], [coughs], [gulps], [clears throat], [applause] |
| Sotaques | [british accent], [southern accent], [strong canadian accent] |
Três regras da documentação oficial de prompting orientam o comportamento das tags: não existe uma lista canônica delas — são instruções em linguagem natural, e a ElevenLabs diz que provavelmente há tags mais eficazes além dos exemplos publicados, portanto testar é melhor do que decorar. Tags de quebra SSML não são compatíveis; o ritmo vem de pontuação, reticências e quebras de linha. Por fim, a eficácia varia conforme a voz e o contexto. É nesse último ponto que surgem os problemas:
"V3 is amazing, certainly the most human sounding" "it still feels like a Beta release to me" — u/ConcertNeat8147, ambas as frases no mesmo post, relato de campo sobre o v3 no r/ElevenLabs
Na mesma thread, u/poundingCode, engenheiro de software com duas décadas de experiência, relata que acrescentar tags emocionais pode ocasionalmente mudar por completo o sotaque do locutor. Uma conta de funcionários da ElevenLabs respondeu que "these are all things we're currently working on."
Contornos relatados por criadores nessa mesma thread — experiência da comunidade, não orientação oficial:
- Use uma frase de aquecimento. Coloque antes uma frase descartável para definir o tom e a altura da voz, depois corte-a na pós-produção; as vozes costumam se "assentar" alguns segundos depois do início da geração.
- Acrescente
end.ao final. Depois do texto, adicione uma quebra de linha e a palavra "end.", para evitar cortes nas palavras finais; em seguida, corte isso do áudio. - Termine frases com reticências. Segundo relatos, cortes de amostras no fim das palavras diminuem quando as frases terminam em "...".
- Leve a estabilidade ao máximo. O controle de estabilidade do v3 tem três posições; a mais alta reduz a deriva da voz no começo das gerações.
Limites que definem a integração
- O teto de 5.000 caracteres é o principal. Uma requisição chega a cerca de 5 minutos de áudio, então pipelines de audiobooks e conteúdos longos precisam dividir o texto: faça os cortes em limites de frase ou parágrafo, nunca no meio de uma oração, e mantenha as tags no mesmo bloco do trecho que elas dirigem. O Multilingual v2 permite 10.000 caracteres caso você precise de chamadas maiores e menos frequentes.
- Na API oficial, concorrência é recurso de plano. Conforme a referência de modelos, chaves Free recebem 2 requisições simultâneas da faixa Multilingual (4 Flash); Scale e Business recebem 15–30; e o Enterprise negocia limites personalizados. Passar do limite adiciona "normalmente" ~50 ms por causa da fila. A mesma página traz a heurística de capacidade da ElevenLabs: um limite de concorrência de 5 suporta aproximadamente 100 transmissões de áudio simultâneas em uma carga conversacional. A penalidade é pequena por chamada, mas se torna brutal em lote quando há subdimensionamento.
- A fal não documenta tamanho máximo de entrada algum. Sua página do Eleven v3 especifica endpoint, parâmetros e formatos, mas não um teto de texto, retenção de fila ou comportamento de novas tentativas. Nada impede o envio de textos longos; nada o garante também.
- Os timestamps diferem entre as plataformas. O schema de entrada da fal tem um booleano
timestamps, que devolve dados de alinhamento por palavra, úteis para legendas e lip-sync. Na API oficial, a saída de diálogo do v3 não inclui timestamps, uma lacuna apontada publicamente por desenvolvedores (r/ElevenLabs: "v3 API, no timestamps?"); hoje, o parâmetro da fal é a rota documentada para dados de alinhamento.
- Tempo real continua fora de cogitação. A ElevenLabs afirma que o v3 não é adequado para uso em tempo real e conversacional devido à latência mais alta e à consistência variável. As opções recomendadas são Flash v2.5, com ~75 ms para agentes, ou Eleven v3 Conversational, com ~280 ms via WebSocket quando a expressividade precisa ser mantida em um contexto interativo. Uma variante do v3 em tempo real está no roadmap ("we're working on a real-time version"), mas ainda não havia sido lançada quando do anúncio de GA.
- Uso comercial. Durante o alpha, desenvolvedores perguntaram publicamente se a saída do v3 podia ser usada comercialmente. O anúncio de GA liberou o modelo em todas as plataformas, e a fal classifica seu endpoint explicitamente para uso comercial.
Primeira requisição: SDK oficial e cliente da fal
O caminho oficial, reproduzido do quickstart:
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)Na fal, use fal-client contra o endpoint fal.run:
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URLAs duas plataformas alertam explicitamente para não enviar chaves de API em código client-side; encaminhe as requisições pelo seu próprio servidor. Para streaming, a API oficial oferece um endpoint de fala em streaming, e a fal disponibiliza fal.stream, além de uma API de fila com webhooks para jobs em lote.
Qual endpoint você deve chamar?
| Sua situação | Use |
|---|---|
| Você precisa de vozes clonadas próprias (PVC/IVC) ou vozes criadas por design, identificadas por ID | Oficial: vozes personalizadas são referenciadas pelo ID no seu workspace; a página da fal documenta apenas nomes de vozes predefinidas |
| Você já paga um plano ElevenLabs com créditos incluídos | Oficial: os caracteres incluídos já são custo afundado, enquanto cada chamada na fal gera um novo gasto |
| Jobs em lote de audiobook ou dublagem, sem assinatura e com webhooks na conclusão | fal: sua fila por uso e fluxo de webhooks miram exatamente esse caso |
| Uma única chave de API para modelos de imagem, vídeo e TTS no mesmo stack | fal: o v3 usa o mesmo cliente que o restante dos seus modelos fal |
| Agentes de voz ou qualquer cenário limitado por latência | Nenhum endpoint TTS do v3: use Flash v2.5 (~75 ms) ou Eleven v3 Conversational (~280 ms) |
| Demandas enterprise (SOC 2, HIPAA BAA, limites de taxa personalizados, allowlisting de IP) | Oficial: recursos do plano Enterprise documentados na página de preços; a página do modelo na fal não informa quais certificações cobrem seu endpoint |
Perguntas frequentes
Qual é o ID de modelo do Eleven v3?
eleven_v3, passado como model_id nos endpoints padrão de texto para fala. Diálogos com múltiplos locutores usam endpoints Text-to-Dialogue separados, e não um parâmetro de modelo.
A API do Eleven v3 oferece streaming?
Sim. A API oficial oferece um endpoint de fala em streaming, que retorna áudio enquanto ele é gerado, e a fal expõe fal.stream para o mesmo modelo. O streaming não torna o v3 seguro para tempo real: a orientação oficial continua destinando o uso conversacional ao Flash v2.5 ou ao Eleven v3 Conversational.
Qual é o limite de caracteres do Eleven v3?
5.000 caracteres por requisição, cerca de 5 minutos de áudio, segundo a referência oficial de modelos. O valor de 40.000 caracteres na página de preços se aplica ao agrupamento da faixa Multilingual, não especificamente ao v3.
Quanto custa a API do Eleven v3?
US$ 0,10 por 1.000 caracteres nas duas rotas: US$ 1,00 para uma história de 10.000 caracteres e US$ 100 para um audiobook de 1 milhão de caracteres. Créditos de plano reduzem o custo na rota oficial — o Creator, de US$ 22/mês, inclui 220 mil caracteres Multilingual —, enquanto a fal não tem assinatura.
Posso usar vozes clonadas com o Eleven v3?
Na API oficial, sim: vozes profissionais, clonadas e criadas por design são referenciadas por ID de voz. Na prática, a compatibilidade varia; usuários do r/ElevenLabs relatam que Professional Voice Clones existentes às vezes soam como locutores diferentes no v3, enquanto PVCs cujos criadores indicam compatibilidade com V3 tendem a se sair melhor. O schema da fal aceita um nome ou ID de voz, mas documenta somente vozes predefinidas; portanto, IDs privados de voz da ElevenLabs são território não documentado ali.
O Eleven v3 é bom para agentes de voz em tempo real?
Não. A ElevenLabs lista explicitamente o uso em tempo real e conversacional como inadequado para o v3, por causa da latência mais alta e da consistência variável. Use Flash v2.5 (~75 ms, 32 idiomas) ou Eleven v3 Conversational (~280 ms, 70+ idiomas e controle por tags de áudio).
Por que o Eleven v3 soa diferente na API e no site?
As prévias de voz não representam necessariamente o resultado com seu próprio texto, uma reclamação recorrente nos relatos de campo do r/ElevenLabs, e a saída do v3 varia de forma perceptível entre gerações. Antes de decidir, teste cada voz candidata com um trecho real do roteiro e na configuração de estabilidade que será usada em produção.
Leitura relacionada: guia da API Qwen Audio 3 TTS · preços e alternativas ao Replicate · review da fal.ai em 2026