 AIREITER
Rodar 145 bilhões de parâmetros em um notebook a 80 tokens por segundo parece promissor, mas o Edge0-145B exige bem mais do que a chamada de lançamento sugere. Os pesos estão disponíveis para download, porém a configuração prática envolve uma máquina NVIDIA com CUDA 13 e cerca de 105 GB livres no SSD.
Nesta análise do Edge0-145B, confronto as promessas de lançamento com o blog de lançamento, a documentação do modelo e o card do Q3_K, além dos primeiros testes da comunidade. A ideia é descobrir se vale rodar o modelo localmente ou simplesmente chamar uma API antes de começar o download.
O que foi lançado em 12 de novembro: pesos, mecanismo e limitações
A Edge0 lançou o Edge0-145B e o Edge0-120B em 12 de novembro de 2026, com os pesos disponíveis em Edge0-145B-q3k e Edge0-145B-NVFP4, além do mecanismo edge0-strata no repositório Edge0-AI/Edge0. O Edge0-145B é um modelo de texto com arquitetura Mixture-of-Experts latente, contexto de 256K, derivado do Qwen3.8-Flash-Next e treinado nativamente em 4 bits. Cerca de 10.12B parâmetros são ativados por token — portanto, os 145B totais não precisam ficar todos na VRAM.
O total é dividido em cerca de 84.6B parâmetros de especialistas, uma tabela PLE de 51.2B que é mapeada da SSD para a memória, uma cabeça de rascunho de 1.26B para decodificação especulativa e um esqueleto de 6GB. O Q3_K traz 40.81 GiB de pesos dentro de um repositório de 105.4GB; o NVFP4 ocupa 47.79 GiB em um repositório de 112.9GB. Os especialistas roteados ficam em um pacote personalizado chamado experts.bin, e não em um GGUF portátil.
A promessa de 29GB não cabe em 29GB
O blog fala em um pico de 29GB em uma seção e 28GB em outra, junto de mais de 1.100 tokens por segundo no prefill, mais de 80 na decodificação e consumo de 120W. Já o card do Q3_K registra 23.14 GiB de VRAM mais 31.28 GiB de RAM do sistema em uma RTX 5090 D; no NVFP4, são 23.25 GiB mais 38.27. A biblioteca de especialistas ocupa cerca de 40GB de RAM, enquanto aproximadamente 48GB de vocabulário são transmitidos a partir da SSD.
Os especialistas mais acessados ficam na VRAM, os que estão em uso intermediário vão para a RAM e a tabela PLE de 51.2GB é lida sob demanda na SSD. A residência ativa pode chegar perto dos 29GB em uma definição bastante restrita, mas o armazenamento e o streaming continuam exigindo o repositório completo.
| O que o número representa | Tamanho | Onde fica |
|---|---|---|
| Valor de pico divulgado no blog | 28-29GB | Residência ativa, sem metodologia documentada |
| Download do repositório Q3_K | 105.4GB | SSD NVMe, 51.2GB de PLE + 40.1GB de experts.bin |
| Download do repositório NVFP4 | 112.9GB | SSD NVMe, 51.2GB de PLE + 47.6GB de experts.bin |
| Residência medida do Q3_K na 5090 D | 23.14 GiB de VRAM + 31.28 GiB de RAM | VRAM + RAM do sistema durante a inferência |
| Residência medida do NVFP4 na 5090 D | 23.25 GiB de VRAM + 38.27 GiB de RAM | VRAM + RAM do sistema durante a inferência |
O que você realmente precisa para rodar o Edge0-145B
O Edge0-145B funciona no Linux ou no Windows com uma GPU NVIDIA e CUDA 13 por meio do edge0-infer. O llama.cpp original, o Ollama e o LM Studio não têm um caminho de carregamento para os arquivos lançados: o GGUF do esqueleto não inclui os pesos dos especialistas roteados, e a Edge0 documenta apenas o edge0-infer (consulte as instruções do repositório). Por isso, o fluxo do guia do llama.cpp v1.0 não se aplica aqui. O blog cita macOS e MacBook Pro como suporte desde o primeiro dia, mas a tabela de plataformas lista apenas Linux e Windows com CUDA 13 para o 145B e o 120B.
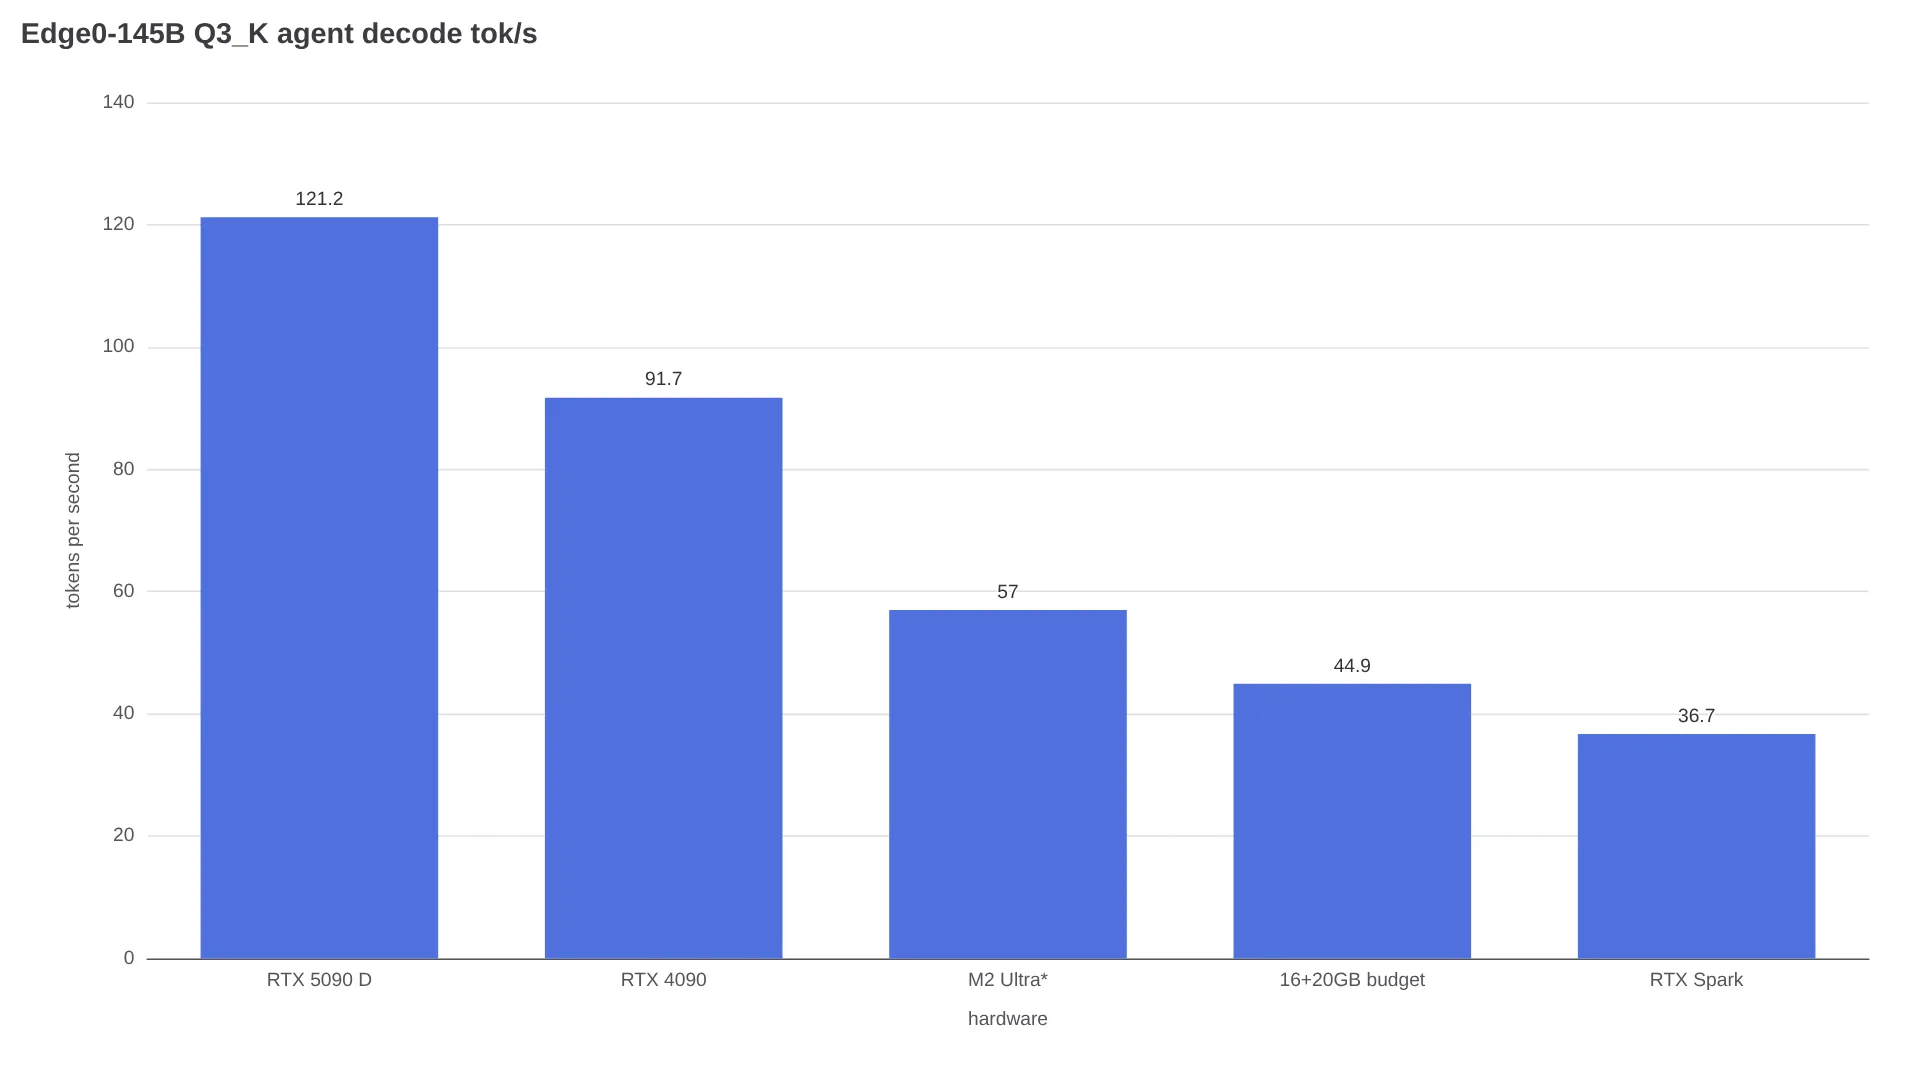
O mínimo testado é de 16 GiB de VRAM mais 20 GiB de RAM, atingindo 44.9 tokens por segundo na decodificação de agente com o Q3_K. A configuração recomendada é uma placa NVIDIA de 24GB, 32GB de RAM — 48GB deixam tudo mais confortável —, 120GB livres em uma NVMe, CUDA 13, CMake, Ninja e uv. Para compilar e iniciar o servidor, siga as instruções do repositório:
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Quem usa Windows pode baixar o aplicativo Edge0 Chat v0.2.0 na página de releases do GitHub. No caso da AMD, é preciso fazer ajustes manuais: u/UghrUghr relata cerca de 35 alterações no build e no tempo de execução em uma RX 7900 XTX com Windows 11, conforme este tópico no r/LocalLLaMA. Os kernels fundidos de CUDA são substituídos por um caminho alternativo mais lento.
Q3_K ou NVFP4: qual arquivo baixar
O Q3_K, com 105.4GB, é a opção padrão e alcança 121.2 tokens por segundo na decodificação de agente em uma 5090 D, segundo a tabela da Edge0. O NVFP4 ocupa 112.9GB e mira a aceleração Blackwell, chegando a 98.3 na mesma placa. Sem hardware Blackwell, comece pelo Q3_K.
Qual é a velocidade em placas reais
Os números abaixo são reportados pela Edge0 para o Q3_K, com prefill de 16K, salvo indicação em contrário. A linha da M2 Ultra é uma medição em Metal e não comprova a existência de uma versão para macOS.
| Hardware | Decodificação de chat | Decodificação de agente | Prefill de 16K |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| Orçamento de 16 GiB de VRAM + 20 GiB de RAM, Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
Um usuário de RTX 3090 relata 20.1 segundos até o primeiro token, prefill de 1,583 e decodificação de 56.2 no Q3_K — um ritmo abaixo do observado nas placas topo de linha:
Acabei de testar na minha configuração com uma 3090 — 20.1s de TTFT, 1583 tok/s de prefill e 56.2 tok/s de decodificação para o Edge0-145B Q3_K.
— u/LightBrightLeftRight, tópico no r/LocalLLM
Na configuração AMD mencionada acima, u/UghrUghr relata cerca de 40 na decodificação, aproximadamente 54 com ROUTE_TAIL_SKIP=7 e ROUTE_PRIOR=1.5, além de cerca de 320 no processamento do prompt. São resultados de uma única sessão, não reproduções controladas, ficando aproximadamente entre metade e dois terços do ritmo da 5090 D.
Benchmarks: duas vitórias e quatro ressalvas
A tabela da Edge0 mistura testes internos do Edge0, Qwen, DeepSeek e Claude com números de terceiros para os demais modelos, conforme a documentação do modelo. O Edge0-145B lidera nos dois testes de agentes de programação, mas fica atrás de sua base Qwen nos testes de conhecimento e instruções. Não encontrei nenhuma reprodução independente vinculada até 13 de novembro de 2026, e as pontuações se referem ao modelo completo, não aos downloads quantizados.
| Benchmark | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
A média é de 72.8 para o Edge0-145B, contra 71.7 do Qwen3.8-Flash-Next e 70.1 do DeepSeek-V4-Flash nos cálculos da Edge0; o 120B fica em 68.9. Minha conclusão: como os dois tamanhos têm promessas de pico semelhantes, escolha o 145B, a menos que o espaço em disco seja um problema.
Licença: pesos abertos não significam código aberto
O framework está sob Apache 2.0 e a base Strata usa MIT, mas os pesos são distribuídos sob a Edge0 Community Model License 1.0, com os termos do Qwen também aplicáveis. É permitido usar os resultados para fins pessoais, de pesquisa, internos e comerciais. Já vender ou empacotar o modelo, operar um serviço pago ou distribuir um assistente comercial de programação ou escritório exige autorização escrita separada.
Vale baixar ou é melhor chamar uma API?
Baixe se você tem o hardware necessário e precisa manter o código no dispositivo. Para um teste pontual, compare antes os preços de uma API hospedada com o custo de comprar hardware. Quem estiver avaliando inferência hospedada pode consultar a página da API DeepSeek V4.1 Flash antes de comprometer 105GB do disco.
| Seu cenário | Escolha |
|---|---|
| NVIDIA de 24GB + 32-48GB de RAM + NVMe de 120GB, Linux/Windows | Baixe o Q3_K e sirva com o edge0-infer |
| Placa Blackwell, com preferência pelo caminho NVFP4 | Baixe a versão NVFP4 |
| Apenas Mac, notebook com 8-16GB ou necessidade de Ollama/LM Studio | Não baixe ainda; use uma API hospedada |
| Distribuição de uma API ou assistente pago baseado nos pesos | Pare e obtenha autorização escrita; use uma API |
| Quer os resultados sem lidar com a operação local | Use APIs da classe Qwen ou de modelos de ponta; reavalie depois de novas reproduções |
O ponto central é o equilíbrio entre procedência e praticidade: o streaming de especialistas reduz a exigência de VRAM para modelos com mais de 100B de parâmetros, mas a ideia de rodar em notebook, no macOS e com apenas 29GB está à frente do código lançado. Além disso, a tabela publicada pela Edge0 não traz números de qualidade separados para o Q3_K.
FAQ
O Edge0-145B roda em um notebook?
Apenas em um notebook NVIDIA de alto desempenho, com cerca de 24GB de VRAM, pelo menos 32GB de RAM e 120GB de NVMe, usando Linux ou Windows com CUDA 13. Um ultrabook com 8GB ou 16GB não consegue rodar a versão 145B, que exige um download de 105.4GB e residência de mais de 23 GiB na VRAM.
O Edge0-145B funciona no Mac?
Não há uma versão compatível com macOS na tabela de plataformas até 13 de novembro de 2026. Os números da M2 Ultra são apenas medições em Metal.
Ele funciona com Ollama, llama.cpp ou LM Studio?
Não. As versões originais não conseguem carregar pacotes personalizados experts.bin, e o GGUF do esqueleto não tem os pesos dos especialistas roteados. Use edge0-infer serve ou o aplicativo Chat para Windows.
O Edge0-145B é melhor que o Qwen3.8-Flash-Next?
Ele fica à frente no DeepSWE, com 64.6 contra 58.7, e no Terminal-Bench, com 86.52 contra 83.3, nos testes da Edge0. Por outro lado, fica atrás no HLE, com 35.4 contra 35.9, e no GPQA-Diamond, com 90.4 contra 91.7. Testes independentes ainda são aguardados.
Posso usar o Edge0-145B comercialmente?
Os resultados, sim. Porém, vender o modelo, operar um serviço pago ou distribuir um assistente comercial de programação ou escritório exige autorização escrita separada sob a licença comunitária; os termos do Qwen também se aplicam.