 AIREITER
"Sonnet 5 está próximo do Opus 4.8, mas é mais barato" é a própria proposta da Anthropic. Queríamos saber em que ponto isso deixa de ser verdade, então executamos quatro tarefas idênticas em ambos os modelos via a CLI do Claude Code e registramos o custo real, a duração e as contagens de chamadas de ferramenta de cada resposta da API. A que mais importou: aumentar o esforço do Sonnet 5 para xhigh a fim de igualar o que o Opus 4.8 faz por padrão, e a diferença de preço que medimos quase desapareceu — enquanto o Opus 4.8 terminou em cerca da metade do tempo.
Sonnet 5 vs Opus 4.8 em Resumo
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
Lançamento | 30 de junho de 2026 | |
Janela de contexto | 1M tokens | 1M tokens |
Saída máxima | 128K tokens | 128K tokens |
Preço (entrada/saída por 1M tokens) | $5/$25 | |
Modo rápido | Não suportado | Suportado (prévia de pesquisa), até ~2.5x de velocidade de saída com preço premium |
Níveis de esforço | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
Posicionamento | Modelo da categoria Sonnet mais barato, focado em agentic | Produto principal da Anthropic, opção de maior precisão |
Janela de contexto e saída máxima são idênticas — não há diferenciação aqui. Uma coisa que há: o Sonnet 5 roda em um novo tokenizer que, segundo a Anthropic, produz "aproximadamente 30% mais tokens" do que o Sonnet 4.6 para o mesmo texto, então um orçamento de max_tokens ou estimativa de custo herdado do Sonnet 4.6 não será traduzido diretamente.
Comparação Oficial de Benchmark
Segundo as próprias divulgações da Anthropic, compiladas junto com análises de terceiros por llm-stats.com, o padrão é consistente: o Sonnet 5 vence ou empata em alguns benchmarks, e o Opus 4.8 lidera na maioria dos outros, geralmente por margens de um dígito.
Benchmark | Sonnet 5 | Opus 4.8 | Diferença |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (with tools) | 57.4% | 57.9% | Quase empate |
Humanity's Last Exam (no tools) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
Duas coisas se destacam. A maior vantagem do Opus 4.8 está em matemática difícil (USAMO), não em programação — as diferenças em programação (SWE-bench, Terminal-Bench) são todas de um dígito, e o Sonnet 5 vence uma delas de forma direta. Em raciocínio geral com uso de ferramentas (HLE com ferramentas), os dois estão próximos o suficiente para ser considerado um empate.
Há também um número de segurança que vale destacar, embora não seja um benchmark de capacidade: conforme as mesmas divulgações, em cenários de uso no navegador sem salvaguardas adicionais, a taxa medida de sucesso de ataques por prompt injection do Sonnet 5 foi de 0,93%, contra 31,5% do Opus 4.8. A Anthropic não publicou uma explicação detalhada para essa diferença específica. Se você estiver construindo qualquer coisa agentic que navegue na web aberta sem supervisão, vale testar suas próprias salvaguardas em vez de assumir que o modelo carro-chefe é automaticamente a opção padrão mais segura.
Nós mesmos realizamos quatro testes lado a lado
A maior parte do que existe por aí no momento ou compila a tabela oficial de benchmarks acima ou compartilha impressões subjetivas de um único modelo. Não encontramos uma comparação controlada de custo e latência com o mesmo prompt, então fizemos a nossa própria.
Metodologia: quatro tarefas, executadas em 2026-07-01, a mesma solicitação enviada para claude-sonnet-5 e claude-opus-4-8 em cada vez via o Claude Code CLI (claude -p --model <id> --effort <level> --output-format json). Custo, duração e contagens de turnos são lidos diretamente da resposta da API de cada execução, não estimados a partir de contagens de tokens. Cada configuração de modelo/effort foi executada uma vez por tarefa — números reais de uma única execução, não uma amostra com média estatística. Considere o tamanho de cada diferença como indicativo, e não exato; a direção foi consistente em todos os testes que executamos.
Teste 1: A Verificação de Reversão de Custo
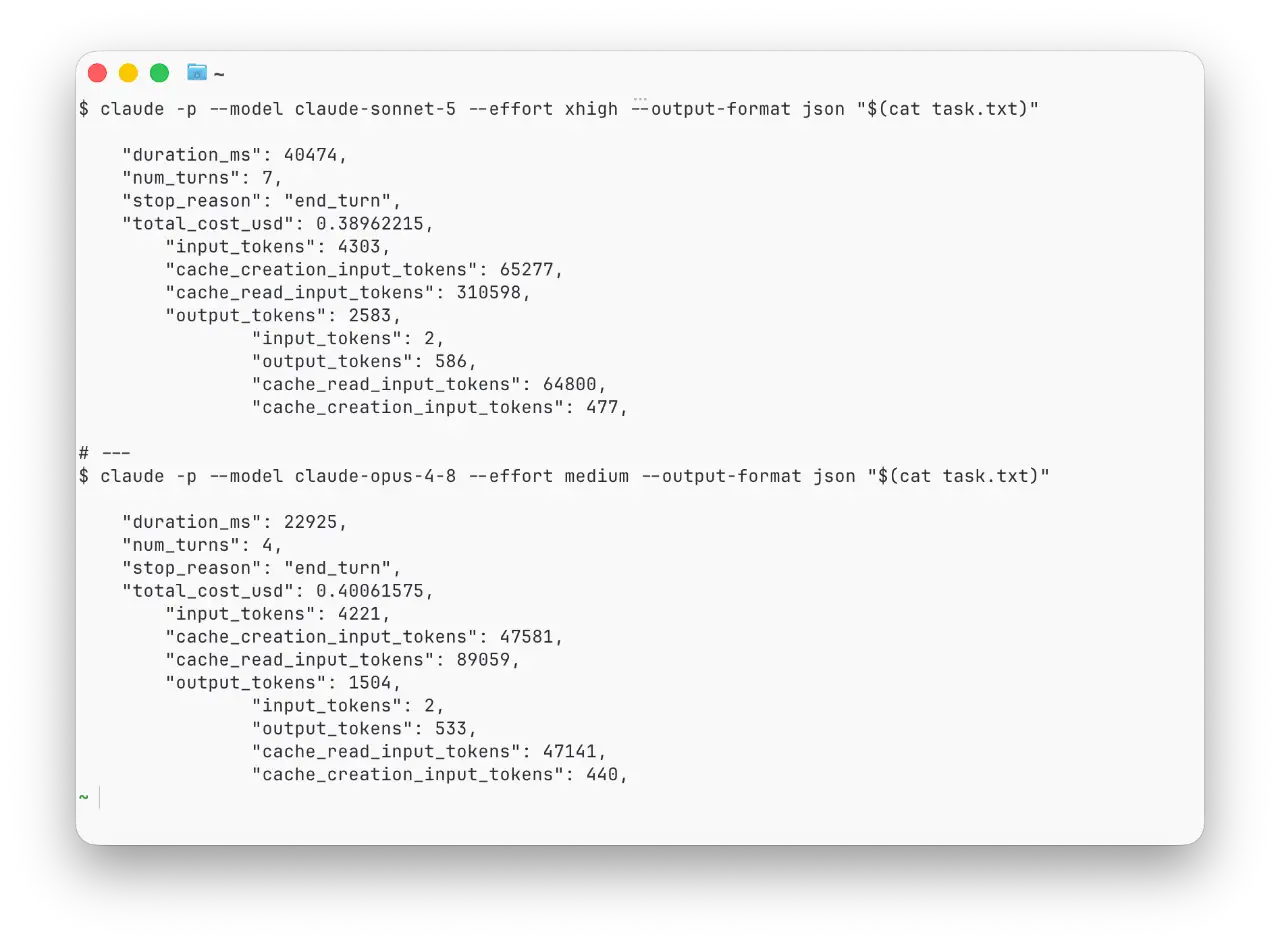
A pergunta que mais queríamos responder: o Sonnet 5 continua mais barato quando você aumenta seu nível de esforço para compensar uma tarefa mais difícil? Executamos a mesma tarefa de programação do Teste 2 (abaixo) com o Sonnet 5 xhigh contra o Opus 4.8 medium.
Configuração | Custo | Duração | Turnos | Resultado |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
Uma diferença de custo de 3% — essencialmente um empate — e o Opus 4.8 em sua configuração de esforço mais baixa concluiu em 57% do tempo, usando quase metade das interações. Ambos produziram código correto e funcional. Isso está alinhado com o que as pessoas já estão apontando no Hacker News: um comentarista lá estimou o Opus 4.8 custando cerca de US$ 0,45 em raciocínio médio, contra o Sonnet 5 a cerca de US$ 0,52 em xhigh/max para um trabalho comparável.
Teste 2: Tarefa de Programação com Esforço Correspondente
Mesmo prompt, ambos os modelos com esforço high: escreva uma função eficiente para encontrar a substring palindrômica mais longa, gere casos de teste cobrindo os casos extremos, execute-os e corrija qualquer coisa que falhar.
Configuração | Custo | Duração | Turnos | Resultado |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
Ambos chegaram à mesma abordagem de expansão a partir do centro e passaram em todos os testes na primeira execução. O Opus 4.8 chegou lá mais rápido e em menos turnos, por cerca de 16% a mais de custo. Quando a qualidade é idêntica, este ponto vai para o Opus apenas pela velocidade.
Teste 3: Escrita / Trabalho de Conhecimento
Um prompt de julgamento empresarial sem uma única resposta correta: aconselhe uma empresa SaaS de 12 pessoas sobre se deve gastar 3-4 semanas migrando para uma segunda região da AWS para recuperação de desastre, seis semanas antes do fechamento da Série A.
Configuração | Custo | Duração | Turnos |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
Ambos deram essencialmente a mesma recomendação — pular a migração completa e, em vez disso, entregar um backup/runbook leve — com qualidade de raciocínio comparável. O Sonnet 5 chegou lá em cerca de dois terços do tempo e custou 14% menos. Este é o único teste em que “Sonnet 5 se sai bem em trabalho de conhecimento” ficou claro.
Teste 4: Agentic Lookup — O Sonnet 5 realmente "pensa demais"?
Alguns tópicos do Reddit descrevem o Sonnet 5 como mais propenso a pensar demais em solicitações simples do que o Opus 4.8. Testamos uma realmente simples: somar o tamanho em bytes de cada arquivo .py em uma árvore de diretórios e informar qual subdiretório tem a maior quantidade deles.
Configuração | Custo | Duração | Turnos |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
Ambos chegaram à mesma resposta correta. O custo teve uma diferença desprezível, mas o Sonnet 5 precisou de uma etapa extra de chamada de ferramenta e levou cerca de 50% mais tempo. Esse é um dado real, ainda que modesto, para a crítica de “pensar demais” — e isso está alinhado com o Teste 1: o Sonnet 5 tende a dar mais passos para chegar ao mesmo resultado.
Então, qual você realmente deve usar?
Escolha Opus 4.8 para tarefas de programação em que a velocidade importa, fluxos de trabalho agentic com muitas chamadas de ferramentas, ou qualquer situação em que você ficaria tentado a aumentar o esforço do Sonnet 5 além de
highpara confiar na saída — essa é exatamente a situação em que a vantagem de custo do Sonnet 5 desaparece.Escolha Sonnet 5 para trabalhos de alto volume, sensíveis a orçamento, e tarefas gerais de conhecimento/escrita, mas mantenha-o em
mediumouhighde esforço. Não aumente automaticamente paraxhigh"só por segurança" — é aí que a história de preços desmorona.Ambos funcionam para consultas simples e solicitações de turno único; a diferença prática que medimos foi um turno extra e alguns segundos, não uma resposta errada.
FAQ
O Claude Sonnet 5 é realmente mais barato que o Opus 4.8?
Em níveis de esforço equivalentes, sim — de forma perceptível. Mas levar o Sonnet 5 para xhigh para compensar uma tarefa mais difícil pode reduzir a diferença para alguns por cento, enquanto o Opus 4.8 em um ajuste de esforço mais baixo conclui mais rápido. Verifique qual nível de esforço você realmente está usando antes de assumir que está economizando dinheiro. Para a lista completa de preços de Haiku, Sonnet e Opus, veja nosso guia de preços da API do Claude.
E quanto ao Claude Sonnet 5 vs Sonnet 4.6?
Uma atualização geracional, não uma escolha de nível de modelo — e o custo também não segue na mesma direção. O Sonnet 5 supera o Sonnet 4.6 em dois dígitos no Terminal-Bench, mas, em nossos próprios testes de custo lado a lado, o Sonnet 5 ficou mais caro do que o Sonnet 4.6 em todos os níveis de esforço que testamos, principalmente devido ao novo tokenizer. Testes completos e números em Sonnet 5 vs Sonnet 4.6: Ele é realmente mais barato?
A comparação entre Claude Sonnet 5 e Opus 4.6 é justa?
Na verdade, não — o Opus 4.6 está uma geração atrás do Opus 4.8. Se você está decidindo o que usar hoje, compare com o Opus 4.8, não com seu predecessor.
A janela de contexto difere entre os dois?
Não — ambos oferecem uma janela de contexto de 1M tokens e saída máxima de 128K.
Por que a taxa de prompt injection do Opus 4.8 é tão mais alta no uso do navegador?
De acordo com as divulgações da Anthropic, 31,5% sem proteções adicionais contra 0,93% do Sonnet 5, especificamente em cenários de uso de navegador sem supervisão. A Anthropic não publicou uma explicação detalhada. Trate isso como um motivo para testar suas proteções específicas, em vez de assumir que o modelo principal é automaticamente a opção padrão mais segura.
Apêndice: Prompts Exatos e Saída Bruta
Para quem quiser reproduzir isso, aqui estão os prompts exatos que enviamos para cada teste (o Teste 1 e o Teste 2 usaram o mesmo prompt de programação, apenas em níveis de esforço diferentes).
Testes 1 & 2 — prompt de programação:
Escreva uma função Python `longest_palindromic_substring(s: str) -> str` que retorne
a substring palindrômica mais longa de s, usando uma abordagem mais eficiente do que
força bruta O(n^3) (por exemplo, expandir a partir do centro ou o algoritmo de Manacher). Salve-a
em solution.py.

Depois, escreva test_solution.py com pelo menos 6 casos de teste cobrindo: string vazia,
um único caractere, todos os caracteres iguais, nenhum palíndromo maior que 1,
um palíndromo de comprimento par e um palíndromo de comprimento ímpar.

Execute os testes com pytest e certifique-se de que todos passem. Se algum falhar, corrija o
código e execute novamente até que todos passem. Informe a saída final do pytest.
Teste 3 — prompt de escrita/trabalho intelectual:
Você está aconselhando uma pequena empresa SaaS (12 funcionários, US$ 80 mil de MRR, atualmente em uma única região da AWS) sobre expandir para uma segunda região da AWS para recuperação de desastres antes de sua captação da Série A, que será encerrada em 6 semanas.

A engenharia estima que a migração leva de 3 a 4 semanas e consumiria a maior parte da capacidade da equipe durante essa janela, adiando dois recursos solicitados por clientes.

Escreva uma recomendação executiva de ~350 palavras: eles devem fazer isso agora, adiar, ou encontrar um caminho intermediário? Justifique com trade-offs. Sem preâmbulo, apenas a recomendação.
Teste 4 — prompt de consulta agentic:
Na árvore de diretórios atual, encontre todos os arquivos com extensão .py, some seu
tamanho total em bytes e me diga qual único subdiretório (filho imediato do
diretório de trabalho) contém a maior quantidade de arquivos .py por contagem. Apenas os dois
números/resposta, sem necessidade de escrever nenhum arquivo novo.
Aqui está a resposta real da API para a execução do Sonnet 5 (xhigh) do Teste 1, reduzida aos campos relevantes para custo e tempo:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
Esse é o total_cost_usd, duration_ms e as contagens de tokens sem edição que o Claude Code CLI retornou para essa execução — os números na tabela do Teste 1 acima vêm diretamente de campos como estes, uma resposta JSON por execução.