 AIREITER
Rodar um modelo de 27 bilhões de parâmetros no celular já não é só uma demonstração de laboratório. O Bonsai 27B, da PrismML, é uma versão do Qwen3.6 27B com quantização ternária cuja promessa principal se confirma: a variante de 3,9GB roda em um iPhone 17 Pro a cerca de 11 tokens por segundo. Os pesos são gratuitos sob licença Apache 2.0, e a versão ternária preserva mais de 95% da pontuação de benchmark em precisão total. Há, porém, uma ressalva: essa retenção de qualidade não é uniforme. Matemática e código ficam próximos do original, enquanto chamadas de ferramentas e visão perdem mais desempenho. Na prática, o Bonsai 27B é uma boa opção local para raciocínio e programação, mas ainda inspira menos confiança em tarefas agentivas muito dependentes de ferramentas. Veja como essa compressão funciona, como interpretar os números, quatro maneiras de executar o modelo e para quem ele faz sentido.
Como a PrismML fez um modelo de 27B caber no celular
Um modelo convencional de 27B em FP16 exige aproximadamente 54GB de memória, muito além do que qualquer celular oferece. O Bonsai 27B fica abaixo de 6GB ao substituir pesos em precisão total por valores discretos muito menores.
Na variante ternária, cada peso fica limitado a um de três valores: -1, 0 ou +1. Em teoria, isso representa cerca de 1,58 bits de informação por peso. A PrismML acrescenta escalonamento FP16 por grupo, armazenando um fator de escala em precisão total para cada grupo de pesos, de modo que os valores reduzidos mantenham a magnitude adequada. Com isso, o custo real chega a aproximadamente 1,71 bits efetivos por peso. A variante binária de 1 bit é ainda mais agressiva: remove o zero e mantém somente -1 e +1, chegando perto de 1,125 bits efetivos.
Dois pontos são importantes. Primeiro, a compressão é aplicada de ponta a ponta: embeddings, atenção, blocos MLP e a cabeça do modelo de linguagem são todos quantizados, sem componentes em precisão total servindo de apoio. Segundo, a base é o Qwen3.6 27B, um modelo causal de atenção híbrida com 27,8B de parâmetros. Por isso, o Bonsai herda a janela de contexto de 262K tokens e a entrada multimodal do modelo original.
Versão ternária ou de 1 bit: qual baixar?
A PrismML disponibiliza duas versões. Escolher a errada pode significar desperdiçar memória ou abrir mão de qualidade sem necessidade. A troca é direta: arquivo menor, precisão menor.
| Versão | Bits efetivos/peso | Tamanho | Qualidade preservada | Melhor para |
|---|---|---|---|---|
| Ternária (-1, 0, +1) | ~1.71 | 5.9GB | >95% do FP16 | Desktop, trabalhos sensíveis à qualidade |
| Binária de 1 bit (-1, +1) | ~1.125 | 3.9GB | >90% do FP16 | Celulares, pouca memória disponível |
Para usar no celular, a versão de 1 bit é a que cabe na margem de memória de um iPhone 17 Pro. Em um notebook ou desktop com mais folga, a versão ternária recupera alguns pontos de precisão por 2GB extras. Vale a pena sempre que a qualidade da resposta importar mais do que a ocupação de espaço.
O que os benchmarks mostram — e onde a qualidade cai
Os números oficiais referem-se à versão ternária, que obtém média de 80.49 em 15 benchmarks no modo de raciocínio. Os destaques são expressivos:
| Benchmark | Pontuação | O que mede |
|---|---|---|
| MATH-500 | 99.20 | Matemática de nível escolar a competições |
| AIME 2025 | 90.84 | Matemática difícil de competição |
| HumanEval+ | 93.90 | Geração de código |
| BFCL v3 | 74.41 | Chamadas de funções/ferramentas |
O perfil do Bonsai 27B fica claro quando esses resultados são vistos em conjunto. Matemática e código chegam à faixa dos 90 pontos; chamadas de ferramentas ficam na casa dos 70. Essa diferença é o principal fator a considerar antes de depender do modelo: a quantização preserva raciocínio e programação muito melhor do que o comportamento estruturado e de múltiplas etapas exigido por fluxos agentivos.
Como os dados são da própria PrismML, é melhor tratá-los como ponto de partida, não como conclusão definitiva, até que surjam mais benchmarks independentes. Vale observar os sinais que uma média de 80.49 esconde: confira as pontuações por tarefa e os modos de falha encontrados no uso real. Testadores iniciais relataram que a versão ternária ocasionalmente entra em loops de raciocínio, e uma quantização tão extrema costuma afetar a estabilidade em contextos longos mais do que uma pontuação isolada deixa transparecer. Antes de confiar nele, vale fazer um teste rápido com seus próprios prompts.
Velocidade de execução e hardware compatível
Uma compressão tão agressiva só importa se a inferência for rápida o bastante para uso prático. Em hardware capaz, ela é. Estes são os números divulgados pela PrismML:
| Dispositivo | 1 bit | Ternária |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
Os 11 tokens por segundo no celular são utilizáveis para chat e raciocínios curtos, embora não sejam exatamente velozes. No M5 Max, 87 tokens por segundo é rápido o suficiente para que a inferência local possa superar uma chamada de API na nuvem em prompts curtos, quando se considera a ida e volta da rede. A PrismML também apresenta o resultado pela métrica de densidade de inteligência, isto é, pontuação de benchmark por gigabyte. Nela, o Bonsai chega a cerca de 0.53, aproximadamente dez vezes a referência em precisão total.
Quatro formas de rodar o Bonsai 27B agora
Como os pesos são abertos, não existe um único caminho de instalação. Estas são quatro opções que já funcionam, da mais simples à que oferece maior controle.
No iPhone
O aplicativo Locally AI para iOS executa a versão de 1 bit e 3.9GB diretamente no aparelho, sem conta ou servidor. É o caminho que realmente entrega a promessa de um modelo de 27B no celular e funciona totalmente offline depois que os pesos são baixados.
No navegador
A PrismML publica kernels WebGPU capazes de rodar o modelo de 1 bit em uma aba do navegador, sem instalação. É a maneira mais rápida de testar o Bonsai 27B antes de reservar espaço em disco, desde que sua máquina tenha uma GPU compatível com WebGPU.
Na sua própria máquina
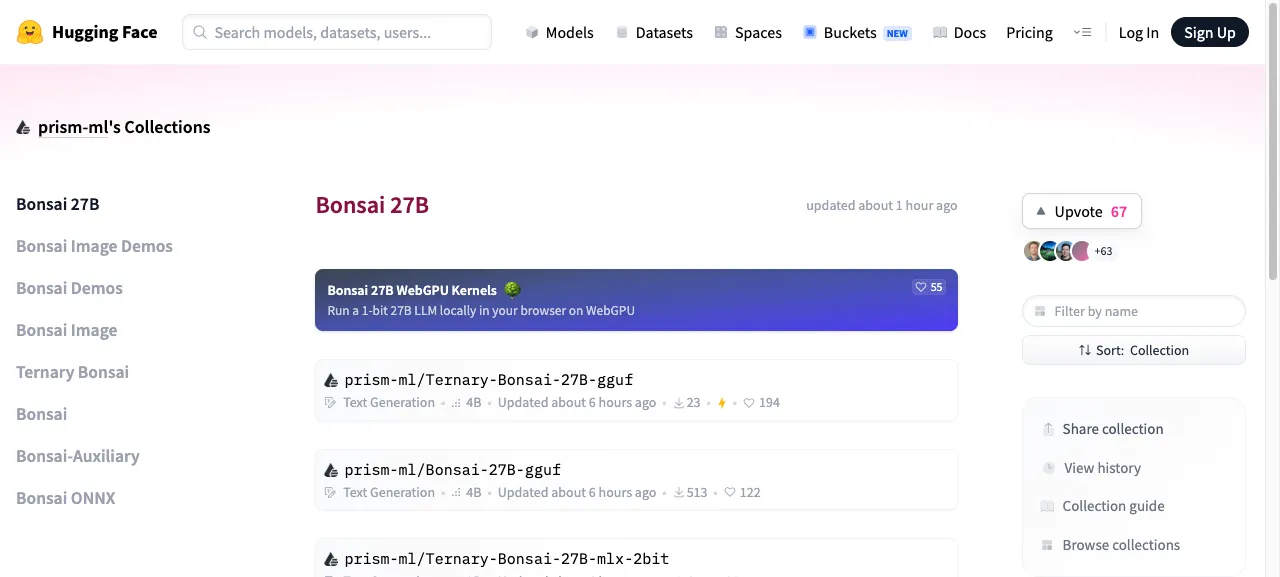
Os pesos em GGUF, MLX e ONNX estão disponíveis no Hugging Face e no GitHub sob licença Apache 2.0. Os principais repositórios são prism-ml/Bonsai-27B-gguf para 1 bit e prism-ml/Ternary-Bonsai-27B-gguf para a versão ternária, além das versões MLX de 2 bits e ONNX. Reserve aproximadamente 4GB de armazenamento livre e RAM para a versão de 1 bit, ou 6GB para a ternária. Há uma ressalva: a maturidade das ferramentas ainda não acompanha o lançamento. Os pesos carregam em vários runtimes, mas o suporte completo em aplicativos locais populares como LM Studio ainda não estava disponível no lançamento, então espere alguma configuração manual.
Por uma API hospedada
Se você prefere não administrar pesos, a Together.ai oferece a versão ternária por uma API padrão, com a janela completa de 262K de contexto, entrada de visão e modo JSON. Durante a promoção de lançamento, o preço de entrada foi listado como $0.00 por milhão de tokens. Confirme o valor atual antes de basear seu orçamento nisso, pois preços promocionais mudam.
Bonsai 27B vs Gemma 4 12B QAT
A comparação mais recorrente é com o Gemma 4 12B QAT, modelo do Google treinado com reconhecimento de quantização, que ocupa cerca de 7GB — apenas um pouco mais que a versão ternária do Bonsai.
Cada um se destaca em áreas diferentes. O Bonsai 27B supera claramente o Gemma nos benchmarks de matemática e código, graças à base de 27B. O Gemma costuma se sair melhor em visão e chamadas de ferramentas, e seus pesos ligeiramente maiores e menos comprimidos fazem dele uma opção mais estável de uso geral no celular. Para uma carga de trabalho local focada em raciocínio e código, o Bonsai é a escolha mais forte; se imagens ou chamadas de função são parte importante do uso, o Gemma 4 12B QAT é a opção mais segura.
Para quem o Bonsai 27B realmente serve
Use o Bonsai 27B se você busca assistência privada, offline e no dispositivo para raciocínio ou programação, e tem um aparelho da classe do iPhone 17 Pro ou um notebook competente. Ele também é um objeto de estudo interessante para quem acompanha quantização extrema: um modelo de 27B rodando em uma aba do navegador é um marco real, e a licença Apache 2.0 aberta facilita a experimentação. Ele se encaixa bem ao lado de outros modelos abertos e gratuitos que valem a pena rodar para programação quando você quer uma alternativa local.
Por enquanto, não o use em sistemas agentivos de produção que dependam de chamadas de ferramentas confiáveis, em tarefas críticas de visão ou em qualquer cenário no qual loops de raciocínio possam ter um custo alto. Nesses casos, um modelo menos comprimido — ou um modelo em precisão total por trás de uma API — continua sendo a aposta mais segura.
Perguntas frequentes
O Bonsai 27B é gratuito?
Os pesos são gratuitos sob a licença Apache 2.0, portanto você pode baixá-los e rodar o modelo sem custo. O acesso hospedado pela Together.ai tem sua própria precificação de API, que no lançamento estava listada em $0.00 por milhão de tokens de entrada. Confirme a tarifa atual.
O Bonsai 27B realmente roda em um celular?
Sim. A versão de 1 bit tem 3.9GB e roda em um iPhone 17 Pro a cerca de 11 tokens por segundo pelo aplicativo Locally AI, totalmente offline após o download.
O Bonsai 27B é tão bom quanto o Qwen3.6 27B completo?
É próximo, mas não idêntico. A versão ternária retém mais de 95% do desempenho em benchmarks da versão em precisão total, enquanto a de 1 bit preserva mais de 90%. A retenção é mais forte em matemática e código, e mais fraca em chamadas de ferramentas.
Qual arquivo do Bonsai 27B devo baixar?
Em um celular ou máquina com pouca memória, escolha a versão de 1 bit (prism-ml/Bonsai-27B-gguf, cerca de 3.9GB). Em desktop ou GPU com espaço de sobra, escolha a versão ternária (prism-ml/Ternary-Bonsai-27B-gguf, cerca de 5.9GB) para ganhar alguns pontos extras de precisão. Também existem variantes MLX de 2 bits e ONNX para Apple Silicon e runtimes multiplataforma.
O que é quantização ternária?
É uma técnica que armazena cada peso do modelo como um de três valores — -1, 0 ou +1 — em vez de um número em precisão total. Por isso, o modelo diminui tanto. Fatores de escala em FP16 ajudam os pesos reduzidos a manter aproximadamente a magnitude correta.
O Bonsai 27B aceita imagens?
Sim. Ele aceita imagens junto com texto como entrada e gera texto como saída, herdando a capacidade multimodal de sua base Qwen3.6 27B. Sob essa compressão, a qualidade de visão se sustenta menos do que a de matemática e código.